Se stai pensando di avviare una nuova applicazione digitale, con ogni probabilità dovrai raccogliere e archiviare dei dati. Dove e come archiviare quei dati è una delle decisioni più importanti che dovrai prendere, perché l’intero software dipenderà da quei dati per funzionare.
Tradizionalmente, i dati sono stati archiviati in tabelle con righe e colonne connesse tramite determinate relazioni (cioè colonne comuni). I database che archiviano dati relazionali sono detti database relazionali, o database SQL, poiché la maggior parte, se non tutti, si basa su SQL per ogni tipo di operazione.
Negli ultimi decenni, però, sono emersi nuovi sistemi di gestione di database per affrontare il rapido aumento del volume e della varietà di dati creati ogni secondo. I cosiddetti database NoSQL (Not only SQL) propongono nuovi schemi e strategie per raccogliere efficacemente i dati in base a specifici casi d’uso, pur facendo in parte affidamento su SQL.
In questo articolo analizzeremo due sistemi di gestione di database molto diffusi: PostgreSQL vs MongoDB. Il primo è uno dei database SQL più popolari, mentre il secondo è il database NoSQL più famoso.
Vedremo le caratteristiche e i punti di forza principali di entrambi, i casi d’uso più rilevanti e alcuni aspetti da tenere a mente nel caso in cui tu stia valutando di migrare i dati verso uno di questi database.
Se vuoi metterti alla prova e sperimentare ogni approccio, dai un’occhiata ai nostri corsi Creating PostgreSQL Databases e Introduction to MongoDB in Python.
TL;DR: PostgreSQL vs MongoDB
Scegliere il database giusto è fondamentale per qualsiasi applicazione digitale. PostgreSQL, un potente database relazionale basato su SQL, eccelle in scenari con dati strutturati che richiedono coerenza, join complessi e transazioni ACID. MongoDB, un flessibile database NoSQL a documenti che usa BSON, è ideale per gestire dati dinamici e non strutturati, offrendo maggiore scalabilità tramite sharding orizzontale. La scelta tra PostgreSQL e MongoDB dipende in ultima analisi dalla struttura dei dati del tuo progetto, dalle esigenze di scalabilità e dai requisiti di coerenza.
Architetture del modello dati: PostgreSQL vs MongoDB
Analizziamo le principali differenze tra PostgreSQL e MongoDB in termini di architettura del modello dati.
Strutture relazionali vs basate su documenti
I sistemi di gestione di database relazionali, come PostgreSQL, organizzano i dati in tabelle, dove ogni tabella è composta da righe e colonne. Queste tabelle possono essere collegate tramite chiavi, consentendo relazioni dati complesse tramite join SQL e query efficienti.
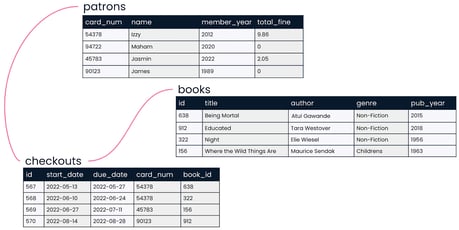
Database relazionale. Fonte: DataCamp
Grazie alla loro semplicità, all’efficienza unica e alla forte coerenza, i database relazionali hanno avuto un enorme successo e sono stati ampiamente adottati negli ultimi decenni.
Tuttavia, potrebbero non essere la scelta migliore quando lavori con dati non strutturati che non si adattano bene a un formato tabellare (ad esempio, post sui social media, dati da sensori) o quando la scalabilità è imprescindibile; cioè quando la tua applicazione deve scalare orizzontalmente su numerosi server.
È qui che entrano in scena i database NoSQL. A differenza delle loro controparti relazionali, i database NoSQL possono gestire dati non strutturati o semi-strutturati senza i vincoli di uno schema fisso.
In particolare, MongoDB è un cosiddetto database a documenti, un tipo di database NoSQL che archivia i dati in raccolte di documenti simili a JSON usando un formato chiamato BSON (Binary JSON). In parole semplici, i documenti sono simili a oggetti chiave-valore JSON, con funzionalità aggiuntive di archiviazione e manipolazione dei dati fornite da BSON.
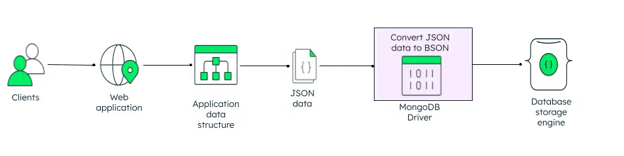
Come MongoDB archivia i dati in BSON. Fonte: DataCamp
La natura flessibile del BSON consente di creare schemi di documenti dinamici, la cui struttura e i cui dati possono variare al volo. Vedremo di più nella prossima sottosezione.
Pattern di evoluzione dello schema
I database relazionali come PostgreSQL forniscono schemi solidi che sono difficili da modificare una volta create le tabelle. È un’ottima caratteristica se i dati con cui lavori hanno una natura tabellare e arrivano sempre nella tua applicazione con lo stesso formato. Tuttavia, se tratti dati semi-strutturati o non strutturati il cui contenuto può variare da un elemento all’altro, come post sui social o dati da sensori, potresti aver bisogno di un certo livello di flessibilità per digerire i tuoi dati.
Al contrario di PostgreSQL, MongoDB adotta i cosiddetti design schema-less, che offrono un’eccezionale flessibilità nel gestire dati diversi e in evoluzione. Il design schema-less di MongoDB organizza i dati in documenti e collezioni:
- Documenti: sono l’unità di base dei dati, composti da coppie chiave-valore BSON. Possono contenere stringhe, numeri, date, array e persino altri documenti annidati. Questo consente modelli dati sofisticati che rappresentano relazioni complesse all’interno di un singolo documento, in linea con la struttura degli oggetti nella maggior parte dei linguaggi di programmazione.
- Collezioni: raggruppano documenti correlati, simili a una tabella, ma in modo più flessibile. Le collezioni non impongono uno schema, quindi i documenti possono avere strutture e campi diversi. Le collezioni esistono all’interno dei database MongoDB e ogni database può contenere più collezioni.
A differenza dei database relazionali tradizionali, dove aggiungere un nuovo campo richiede di modificare l’intera struttura della tabella, MongoDB consente ai documenti della stessa collezione di avere campi e strutture completamente diversi. Questo elimina la necessità di schemi rigidi e rende più semplice archiviare dati eterogenei senza imporre uniformità.
Linguaggi di query: PostgreSQL vs MongoDB
Qualunque sia il database che stai usando, PostgreSQL o MongoDB, dovrai imparare il linguaggio per comunicare e gestirlo. In PostgreSQL si usa SQL, un linguaggio di programmazione estremamente popolare, standardizzato e facile da usare. Puoi iniziare con SQL nel nostro corso Introduction to SQL.
Al contrario, MongoDB si affida principalmente al proprio linguaggio, il MongoDB Query Language (MQL), per interagire con il database. Tuttavia, è possibile usare anche altri linguaggi di programmazione popolari, come Python, C e Java, per connettersi e interagire con database MongoDB.
Vediamo le principali differenze tra SQL e MQL.
Capacità: SQL vs MQL
Uno dei maggiori vantaggi di PostgreSQL rispetto a MongoDB è l’uso di SQL. SQL (acronimo di “Structured Query Language”) è un linguaggio essenziale per creare e mantenere database relazionali.
È un linguaggio di programmazione semplice e specifico di dominio, utilizzato da quasi tutti i sistemi di database relazionali, come MySQL, SQL Server, SQLite e, naturalmente, PostgreSQL.
SQL è estremamente potente: ti permette di eseguire ogni tipo di operazione sui dati, dal recupero e aggregazione alla pulizia e alle operazioni di join. Tuttavia, con PostgreSQL le possibilità sono ancora maggiori, perché include funzionalità avanzate per analisi complesse, tra cui:
- Funzioni e procedure: PostgreSQL supporta la creazione di funzioni e procedure memorizzate, scrivibili in vari linguaggi di programmazione, ampliando la capacità del database di gestire operazioni complesse.
- Ricerca full-text: PostgreSQL offre solide funzionalità di ricerca full-text, abilitando ricerche efficienti sui dati testuali.
- Supporto JSON: L’ampio supporto ai tipi di dati JSON consente a PostgreSQL di gestire efficacemente dati semi-strutturati, colmando in parte il divario tra database relazionali e orientati ai documenti.
Di contro, sebbene MongoDB non si basi su SQL, dispone di potenti funzionalità di query, indicizzazione e aggregazione, oltre ad altre funzioni per inserire, aggiornare o eliminare informazioni nei database a documenti. Quindi, se conosci JSON o i dizionari di Python, non ti servirà molto per familiarizzare con la sintassi MQL.
MQL è progettato specificamente per gestire la natura dinamica dei documenti. Di conseguenza, è un linguaggio molto più flessibile rispetto a SQL. Inoltre, poiché i documenti possono includere altri documenti annidati, in MongoDB non c’è bisogno di ricorrere a join complessi e inefficienti, come spesso accade nei database relazionali.
Strategie di indicizzazione
Gli indici sono oggetti del database che migliorano la velocità delle operazioni di recupero dei dati. Servono come puntatori per individuare rapidamente le righe in una tabella, aumentando le prestazioni delle query.
PostgreSQL offre capacità di indicizzazione avanzate, supportando più tipi di indice, tra cui:
- Indice B-Tree: il tipo di indice predefinito e più usato
- Indice Hash: per ricerche di uguaglianza veloci
- Indice GIN: per indicizzare JSON, array e la ricerca full-text
- Indice GiST: per tipi di dati complessi come ricerche geometriche o fuzzy
- Indice BRIN: per grandi volumi di dati naturalmente ordinati (come log di serie temporali)
- Indice su espressione: indice basato su una funzione o espressione
- Indice parziale: indicizza solo un sottoinsieme di righe (utile per il filtraggio)
Anche MongoDB supporta l’indicizzazione per trovare documenti nelle collezioni senza dover eseguire la scansione completa. Tuttavia, le sue capacità sono più limitate e mancano della varietà e sofisticazione disponibili nei database relazionali come PostgreSQL. Tra queste:
- Indice a campo singolo: raccoglie e ordina i dati da un singolo campo in ciascun documento di una collezione.
- Indice composto: raccoglie e ordina i dati da due o più campi in ciascun documento.
- Indice multikey: indicizza dati archiviati in array.
- Indice testuale: supporta ricerche testuali su campi che contengono stringhe.
- Indice con hash: supporta lo sharding basato su hash. Indica l’hash del valore di un campo.
Usare gli indici nei tuoi database SQL e NoSQL è fondamentale per aumentare le prestazioni e ridurre i tempi di query, soprattutto su dataset di grandi dimensioni.
Ricorda però che aggiungere un indice può avere un impatto negativo sulle prestazioni delle operazioni di scrittura. Per tabelle o collezioni con un elevato rapporto scritture/letture, gli indici sono costosi perché ogni inserimento deve aggiornare anche gli indici.
Prestazioni e scalabilità in MongoDB vs PostgreSQL
MongoDB e PostgreSQL sono ottimi strumenti, ma non ha senso scegliere l’uno o l’altro in astratto, basandosi solo sulle proprietà. Dovresti sempre decidere in base alle specificità del tuo caso d’uso. Tenendo questo a mente, analizziamo le differenze di prestazioni e scalabilità tra MongoDB e PostgreSQL.
Elaborazione delle transazioni
Come altri popolari sistemi relazionali, PostgreSQL garantisce elevati livelli di integrità e qualità dei dati grazie al suo solido sistema di tipi e al supporto delle transazioni ACID (Atomicità, Coerenza, Isolamento, Durabilità).
Le transazioni ACID sono un insieme di proprietà che garantiscono l’elaborazione affidabile delle transazioni sul database. Assicurano che i dati restino accurati e sicuri anche in caso di errori, crash o accessi concorrenti. Queste proprietà sono vitali per mantenere la qualità dei dati in qualsiasi progetto.
Sebbene le transazioni ACID siano da tempo lo standard d’oro per garantire l’integrità dei dati nei database relazionali, i database NoSQL come MongoDB spesso privilegiano flessibilità e scalabilità rispetto alla rigorosa coerenza transazionale. Questo comporta un allentamento di alcune proprietà ACID tipiche dei database relazionali.
Per esempio, alcuni database MongoDB privilegiano la consistenza eventuale rispetto a quella immediata, il che significa che le modifiche potrebbero non essere riflesse istantaneamente su tutti i nodi. Il compromesso tra coerenza, disponibilità e prestazioni consente migliori performance e scalabilità, ma richiede un’attenta progettazione quando le applicazioni dipendono da una coerenza rigorosa dei dati.
Pattern di scalabilità
Scalare significa usare diverse tecniche per gestire l’aumento del volume di dati e del traffico. In parole semplici, possiamo farlo tramite scalabilità verticale e orizzontale. La prima consiste nel potenziare e aggiungere risorse allo stesso server per gestire il carico crescente. La seconda si ottiene aggiungendo più server o nodi a un sistema distribuito, aumentando così la capacità.
PostgreSQL si affida principalmente alla scalabilità verticale per aumentare la capacità. Tuttavia, a differenza di altri database SQL popolari, consente anche la scalabilità orizzontale tramite partizionamento, sebbene richieda configurazioni complesse. Puoi approfondire tutti gli aspetti tecnici del partizionamento in PostgreSQL nel nostro corso Improving Query Performance in PostgreSQL.
Al contrario, nei sistemi NoSQL come MongoDB, la strategia di riferimento per gestire la crescita di traffico e volume dei dati è la scalabilità orizzontale. MongoDB è progettato per sfruttare lo sharding, una tecnica che consiste nel dividere un database in parti più piccole e gestibili chiamate "shard" e distribuirle su più server, consentendo al sistema di gestire dataset molto grandi e alti volumi di traffico.
Dai un’occhiata al nostro articolo Sharding vs Partitioning per scoprire tutto su queste popolari tecniche di scalabilità.
MongoDB vs PostgreSQL: analisi dei casi d’uso
Ora che conosciamo le caratteristiche e i punti di forza chiave di PostgreSQL e MongoDB, è il momento di analizzare gli scenari in cui sono più utili.
Scenari ideali per PostgreSQL
PostgreSQL è un’ottima scelta quando il tuo progetto richiederà:
- Forte coerenza: garantire che tutti gli utenti vedano gli stessi dati simultaneamente.
- Query complesse: unire dati da più tabelle per ottenere insight.
- Analisi avanzate: se devi eseguire calcoli complessi o trasformazioni dei dati all’interno del database, l’estensibilità di PostgreSQL è preziosa.
- Scalabilità: per progetti destinati a crescere significativamente, la capacità di PostgreSQL di gestire grandi dataset tramite scalabilità verticale o partizionamento è un grande vantaggio.
- Conformità ACID: garantire un’elaborazione affidabile delle transazioni per applicazioni critiche.
Per fare alcuni esempi convincenti, PostgreSQL è un’idea solida per:
- Transazioni finanziarie: accuratezza e coerenza sono cruciali quando si trasferiscono denaro o si elaborano pagamenti.
- Sistemi di inventario: garantire che i livelli di stock siano aggiornati accuratamente è vitale per evitare sovravendite o discrepanze.
- Elaborazione degli ordini: per soddisfare i clienti nell’e-commerce, gli ordini devono essere elaborati correttamente e in modo coerente.
Implementazioni ottimali di MongoDB
MongoDB dà il meglio di sé quando è utile avere strutture dati flessibili che possano adattarsi dinamicamente a nuove informazioni e schemi, quando contano scalabilità e prestazioni e con dati non strutturati. Il design schema-less di MongoDB, unito alla scalabilità orizzontale, lo rende ideale per casi come:
- Feed dei social media: poiché gran parte dei dati in arrivo è non strutturata e imprevedibile, la coerenza dei dati è meno critica e sono accettabili incoerenze temporanee in post o like, purché il sistema resti reattivo.
- Content delivery network: la priorità è servire i contenuti con latenza minima rispetto alla coerenza.
Architetture ibride
Potrebbero esserci casi d’uso in cui è necessario combinare i punti di forza di MongoDB e PostgreSQL per ottenere una soluzione completa a requisiti dati eterogenei. Creare architetture ibride che combinano database SQL e NoSQL è possibile ed è un’ottima idea se devi unire forte coerenza nelle transazioni con un certo grado di flessibilità.
Per esempio, puoi usare MongoDB per scritture veloci nell’analisi in tempo reale e PostgreSQL per operazioni relazionali complesse e l’archiviazione di dati strutturati. Tuttavia, al momento non esiste un modo per “fondere” le funzionalità di entrambi. Userai semplicemente due database diversi in parallelo, aumentando la complessità del sistema: serve quindi un’analisi accurata prima di implementarli.
Considerazioni sulla migrazione
Se stai pianificando di migrare i dati da MongoDB a PostgreSQL o viceversa, dovrai considerare vari elementi:
Schemi del database
Se stai migrando da MongoDB a PostgreSQL, prima di trasferire i dati dovrai creare una tabella o più tabelle con uno schema predefinito, cioè un elenco di colonne con i relativi tipi di dato ed eventuali vincoli. Se vuoi spostare i tuoi dati su Mongo, dovrai definire come verranno incorporati nei documenti. Nonostante la natura flessibile dei documenti, un minimo di modellazione sarà essenziale per collocare i dati esistenti.
I dati che vuoi esportare potrebbero non avere il formato desiderato. In tal caso, prima della migrazione dovrai predisporre una sorta di pipeline per trasformarli nel formato corretto prima di inserirli nel database PostgreSQL o MongoDB.
Come migrare i dati
Esistono vari modi per eseguire una migrazione. Puoi farlo manualmente per passaggi di export/import di base, ma può essere un processo lungo, complesso e soggetto a errori, soprattutto se il database da migrare contiene molti dati. Ecco perché scegliere uno strumento ELT per svolgere il lavoro può essere una soluzione migliore. Ci sono molte soluzioni disponibili, sia per migrare da PostgreSQL a Mongo sia viceversa.
Ottimizzazione delle prestazioni
Considerare tecniche per aumentare le prestazioni durante la migrazione è cruciale, soprattutto nei processi più complessi. Ancora una volta, a seconda dell’origine e della destinazione, PostgreSQL e MongoDB offrono tecniche e strategie specifiche per velocizzare il processo, tra cui connection pooling, partizionamento, scelta della shard key e covered query.
Proteggere il tuo deployment del database è fondamentale per garantire integrità, disponibilità e conformità dei dati. Sia MongoDB che PostgreSQL offrono metodi diversi per mettere in sicurezza i database. In questa sezione trattiamo alcune delle tecniche più comuni.
Meccanismi di autenticazione
PostgreSQL offre un’ampia gamma di metodi di autenticazione, gestibili efficacemente tramite ruoli. I ruoli sono entità che possono possedere oggetti del database e avere privilegi. Possono essere usati per autenticazione, gestione dei permessi e definizione dei livelli di accesso degli utenti. In PostgreSQL, un ruolo può funzionare come utente o come gruppo di utenti.
Puoi creare ruoli anche in MongoDB per impedire accessi non autorizzati. Il controllo basato sui ruoli segue il principio del minimo privilegio per minimizzare i rischi. MongoDB supporta diversi meccanismi di autenticazione, con lo SCRAM (Salted Challenge Response Authentication Mechanism) come meccanismo predefinito per un’autenticazione sicura basata su password.
Pratiche di cifratura
MongoDB offre numerose pratiche di cifratura per proteggere i tuoi dati, tra cui:
- Cifratura TLS/SSL: usa TLS/SSL per cifrare i dati in transito, assicurando comunicazioni sicure tra client e database.
- Whitelist IP e VPN: limita l’accesso alle istanze MongoDB consentendo solo indirizzi IP fidati. Per maggiore sicurezza, usa VPN per creare tunnel sicuri verso i database di produzione.
- Cifratura a riposo: puoi abilitare la cifratura a riposo tramite il supporto nativo di MongoDB nel motore di archiviazione WiredTiger. Protegge i dati sensibili memorizzati su disco.
- Cifratura lato client a livello di campo: per requisiti di alta sicurezza, cifra specifici campi prima che siano inviati al database. In questo modo, neppure gli amministratori possono accedere a informazioni sensibili.
Anche PostgreSQL offre cifratura a vari livelli e fornisce flessibilità nel proteggere i dati da divulgazioni dovute a furto del server, amministratori malevoli e reti non sicure. Alcune opzioni includono:
- Cifratura delle password: le password degli utenti del database possono essere archiviate come hash, così l’amministratore non può determinarne il valore reale.
- Cifratura dei dati in rete: le connessioni SSL cifrano tutti i dati inviati in rete: password, query e dati restituiti.
- Cifratura delle partizioni dati: la cifratura dello storage può essere eseguita a livello di file system o di partizione.
- Autenticazione host SSL: sia il client che il server possono fornire certificati SSL reciproci.
Sia MongoDB che PostgreSQL sono strumenti molto popolari, con community in crescita ed ecosistemi floridi. Diamo un’occhiata.
Capacità di estensione
Le estensioni in PostgreSQL sono moduli aggiuntivi che ampliano le capacità del database. Sono come i pacchetti in Python o R. Negli ultimi anni è nato un ricco ecosistema di estensioni per potenziare PostgreSQL in ogni tipo di scenario, disciplina e caso d’uso. La maggior parte è disponibile nel PostgreSQL Extension Network.
Di contro, MongoDB offre un insieme più limitato di estensioni ed è per lo più orientato ad abilitare l’uso di MongoDB con altre tecnologie e framework, come IDE (es. Visual Studio Code) e sistemi cloud come Google Cloud. Tuttavia, possono essere disponibili pacchetti di terze parti per i vari linguaggi con cui normalmente gestisci MongoDB.
Trend di adozione
Sia PostgreSQL che MongoDB stanno vivendo un periodo d’oro, come mostrato nell’immagine seguente con i trend dei motori di database basati sui dati di DB-Engines.
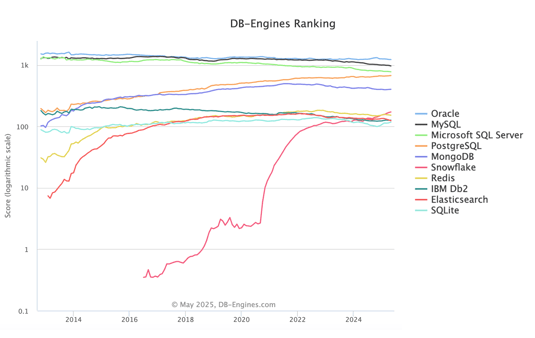
Fonte: db-engines
Sebbene i sistemi di gestione di database relazionali siano ancora dominanti (incluso PostgreSQL, al 4° posto), il grafico evidenzia anche un notevole cambiamento negli ultimi anni, con database NoSQL come MongoDB e Redis in forte crescita. Questa traiettoria riflette l’adozione crescente di soluzioni flessibili e scalabili per gestire dati non strutturati e supportare applicazioni ad alto traffico.
Tabella di confronto: PostgreSQL vs MongoDB
Ecco una tabella che riassume le differenze tra i database MongoDB e PostgreSQL:
|
Caratteristica
|
MongoDB
|
PostgreSQL
|
|
Struttura dei dati
|
Archivia i dati come documenti (ad es. JSON, BSON), consentendo strutture flessibili e gerarchiche.
|
Archivia i dati in tabelle con righe e colonne, seguendo uno schema predefinito.
|
|
Flessibilità dello schema
|
Schema-less: i documenti possono avere strutture variabili, con campi e tipi di dato diversi.
|
Schema fisso: richiede uno schema predefinito con colonne e tipi di dato specifici.
|
|
Linguaggio di query
|
Usa il MongoDB Query Language (MQL) o simili, basato su oggetti e più flessibile.
|
Usa SQL (Structured Query Language) per interrogare dati strutturati.
|
|
Join
|
Evita i join incorporando dati correlati all’interno dei documenti (denormalizzazione).
|
Supporta join complessi tra tabelle (normalizzazione).
|
|
Prestazioni
|
Letture e scritture più veloci per dati non strutturati o semi-strutturati. Evita l’overhead dei join.
|
Ottime prestazioni per dati strutturati, ma i join possono rallentare le query.
|
|
Scalabilità
|
Scalabilità orizzontale: può distribuire i dati su più server tramite sharding.
|
Tipicamente scalabilità verticale: si affida a hardware più potente, anche se esiste supporto alla scalabilità orizzontale (es. con partizioni).
|
|
Supporto alle transazioni
|
Supporta transazioni ACID multi-documento (da MongoDB 4.0 in poi), ma in origine era progettato per operazioni non transazionali.
|
Pieno supporto a transazioni conformi ad ACID, offrendo forte coerenza e affidabilità.
|
|
Casi d’uso
|
Ideale per dati non strutturati o semi-strutturati come profili utente, log, cataloghi e strutture dati flessibili.
|
Ideale per dati strutturati con relazioni chiare, come registri finanziari o sistemi ERP.
|
|
Relazioni tra dati
|
Supporta dati annidati (denormalizzazione), facilitando il recupero di informazioni correlate con una singola query.
|
I database relazionali si basano su chiavi esterne per stabilire relazioni tra tabelle (normalizzazione).
|
|
Indicizzazione
|
Supporta l’indicizzazione ma manca della varietà e sofisticazione tipiche dei database relazionali.
|
Capacità di indicizzazione avanzate, con supporto a molteplici tipi di indice (ad es. B-tree, hash) per ottimizzare le prestazioni.
|
|
Coerenza
|
Fornisce coerenza eventuale in configurazioni distribuite ma offre anche forte coerenza quando necessario (tramite transazioni ACID).
|
Garantisce forte coerenza nella maggior parte dei casi grazie alle transazioni ACID e all’integrità relazionale.
|
|
Scalare il volume dei dati
|
Scala facilmente per grandi quantità di dati aggiungendo server (sharding).
|
Può scalare verticalmente, ma la scalabilità orizzontale richiede configurazioni più complesse (es. partizionamento).
|
|
Integrità dei dati
|
L’integrità è gestita all’interno di ciascun documento, ma gestire le relazioni tra documenti può essere più impegnativo.
|
Solido supporto integrato all’integrità tramite chiavi primarie ed esterne, e vincoli come UNIQUE e NOT NULL.
|
|
Facilità per gli sviluppatori
|
Developer-friendly: modellazione dati flessibile, funziona bene con applicazioni moderne (ad es. JSON, API REST).
|
Modellazione più rigida ma ben compresa dagli sviluppatori che conoscono SQL e dati strutturati.
|
Conclusione
MongoDB e PostgreSQL sono due dei database più popolari. Rappresentano ottimi esempi rispettivamente di database NoSQL e SQL e, confrontandoli, possiamo fare chiarezza su differenze, punti di forza e casi d’uso in cui possono risultare utili.
C’è molto da imparare sui database SQL e NoSQL. Su DataCamp vogliamo aiutarti con corsi e tutorial completi e aggiornati. Dai un’occhiata ad alcuni dei nostri contenuti dedicati ai database:





Se stai pensando di avviare una nuova applicazione digitale, con ogni probabilità dovrai raccogliere e archiviare dei dati. Dove e come archiviare quei dati è una delle decisioni più importanti che dovrai prendere, perché l’intero software dipenderà da quei dati per funzionare.
Tradizionalmente, i dati sono stati archiviati in tabelle con righe e colonne connesse tramite determinate relazioni (cioè colonne comuni). I database che archiviano dati relazionali sono detti database relazionali, o database SQL, poiché la maggior parte, se non tutti, si basa su SQL per ogni tipo di operazione.
Negli ultimi decenni, però, sono emersi nuovi sistemi di gestione di database per affrontare il rapido aumento del volume e della varietà di dati creati ogni secondo. I cosiddetti database NoSQL (Not only SQL) propongono nuovi schemi e strategie per raccogliere efficacemente i dati in base a specifici casi d’uso, pur facendo in parte affidamento su SQL.
In questo articolo analizzeremo due sistemi di gestione di database molto diffusi: PostgreSQL vs MongoDB. Il primo è uno dei database SQL più popolari, mentre il secondo è il database NoSQL più famoso.
Vedremo le caratteristiche e i punti di forza principali di entrambi, i casi d’uso più rilevanti e alcuni aspetti da tenere a mente nel caso in cui tu stia valutando di migrare i dati verso uno di questi database.
Se vuoi metterti alla prova e sperimentare ogni approccio, dai un’occhiata ai nostri corsi Creating PostgreSQL Databases e Introduction to MongoDB in Python.
TL;DR: PostgreSQL vs MongoDB
Scegliere il database giusto è fondamentale per qualsiasi applicazione digitale. PostgreSQL, un potente database relazionale basato su SQL, eccelle in scenari con dati strutturati che richiedono coerenza, join complessi e transazioni ACID. MongoDB, un flessibile database NoSQL a documenti che usa BSON, è ideale per gestire dati dinamici e non strutturati, offrendo maggiore scalabilità tramite sharding orizzontale. La scelta tra PostgreSQL e MongoDB dipende in ultima analisi dalla struttura dei dati del tuo progetto, dalle esigenze di scalabilità e dai requisiti di coerenza.
Architetture del modello dati: PostgreSQL vs MongoDB
Analizziamo le principali differenze tra PostgreSQL e MongoDB in termini di architettura del modello dati.
Strutture relazionali vs basate su documenti
I sistemi di gestione di database relazionali, come PostgreSQL, organizzano i dati in tabelle, dove ogni tabella è composta da righe e colonne. Queste tabelle possono essere collegate tramite chiavi, consentendo relazioni dati complesse tramite join SQL e query efficienti.
Database relazionale. Fonte: DataCamp
Grazie alla loro semplicità, all’efficienza unica e alla forte coerenza, i database relazionali hanno avuto un enorme successo e sono stati ampiamente adottati negli ultimi decenni.
Tuttavia, potrebbero non essere la scelta migliore quando lavori con dati non strutturati che non si adattano bene a un formato tabellare (ad esempio, post sui social media, dati da sensori) o quando la scalabilità è imprescindibile; cioè quando la tua applicazione deve scalare orizzontalmente su numerosi server.
È qui che entrano in scena i database NoSQL. A differenza delle loro controparti relazionali, i database NoSQL possono gestire dati non strutturati o semi-strutturati senza i vincoli di uno schema fisso.
In particolare, MongoDB è un cosiddetto database a documenti, un tipo di database NoSQL che archivia i dati in raccolte di documenti simili a JSON usando un formato chiamato BSON (Binary JSON). In parole semplici, i documenti sono simili a oggetti chiave-valore JSON, con funzionalità aggiuntive di archiviazione e manipolazione dei dati fornite da BSON.
Come MongoDB archivia i dati in BSON. Fonte: DataCamp
La natura flessibile del BSON consente di creare schemi di documenti dinamici, la cui struttura e i cui dati possono variare al volo. Vedremo di più nella prossima sottosezione.
Pattern di evoluzione dello schema
I database relazionali come PostgreSQL forniscono schemi solidi che sono difficili da modificare una volta create le tabelle. È un’ottima caratteristica se i dati con cui lavori hanno una natura tabellare e arrivano sempre nella tua applicazione con lo stesso formato. Tuttavia, se tratti dati semi-strutturati o non strutturati il cui contenuto può variare da un elemento all’altro, come post sui social o dati da sensori, potresti aver bisogno di un certo livello di flessibilità per digerire i tuoi dati.
Al contrario di PostgreSQL, MongoDB adotta i cosiddetti design schema-less, che offrono un’eccezionale flessibilità nel gestire dati diversi e in evoluzione. Il design schema-less di MongoDB organizza i dati in documenti e collezioni:
A differenza dei database relazionali tradizionali, dove aggiungere un nuovo campo richiede di modificare l’intera struttura della tabella, MongoDB consente ai documenti della stessa collezione di avere campi e strutture completamente diversi. Questo elimina la necessità di schemi rigidi e rende più semplice archiviare dati eterogenei senza imporre uniformità.
Linguaggi di query: PostgreSQL vs MongoDB
Qualunque sia il database che stai usando, PostgreSQL o MongoDB, dovrai imparare il linguaggio per comunicare e gestirlo. In PostgreSQL si usa SQL, un linguaggio di programmazione estremamente popolare, standardizzato e facile da usare. Puoi iniziare con SQL nel nostro corso Introduction to SQL.
Al contrario, MongoDB si affida principalmente al proprio linguaggio, il MongoDB Query Language (MQL), per interagire con il database. Tuttavia, è possibile usare anche altri linguaggi di programmazione popolari, come Python, C e Java, per connettersi e interagire con database MongoDB.
Vediamo le principali differenze tra SQL e MQL.
Capacità: SQL vs MQL
Uno dei maggiori vantaggi di PostgreSQL rispetto a MongoDB è l’uso di SQL. SQL (acronimo di “Structured Query Language”) è un linguaggio essenziale per creare e mantenere database relazionali.
È un linguaggio di programmazione semplice e specifico di dominio, utilizzato da quasi tutti i sistemi di database relazionali, come MySQL, SQL Server, SQLite e, naturalmente, PostgreSQL.
SQL è estremamente potente: ti permette di eseguire ogni tipo di operazione sui dati, dal recupero e aggregazione alla pulizia e alle operazioni di join. Tuttavia, con PostgreSQL le possibilità sono ancora maggiori, perché include funzionalità avanzate per analisi complesse, tra cui:
Di contro, sebbene MongoDB non si basi su SQL, dispone di potenti funzionalità di query, indicizzazione e aggregazione, oltre ad altre funzioni per inserire, aggiornare o eliminare informazioni nei database a documenti. Quindi, se conosci JSON o i dizionari di Python, non ti servirà molto per familiarizzare con la sintassi MQL.
MQL è progettato specificamente per gestire la natura dinamica dei documenti. Di conseguenza, è un linguaggio molto più flessibile rispetto a SQL. Inoltre, poiché i documenti possono includere altri documenti annidati, in MongoDB non c’è bisogno di ricorrere a join complessi e inefficienti, come spesso accade nei database relazionali.
Strategie di indicizzazione
Gli indici sono oggetti del database che migliorano la velocità delle operazioni di recupero dei dati. Servono come puntatori per individuare rapidamente le righe in una tabella, aumentando le prestazioni delle query.
PostgreSQL offre capacità di indicizzazione avanzate, supportando più tipi di indice, tra cui:
Anche MongoDB supporta l’indicizzazione per trovare documenti nelle collezioni senza dover eseguire la scansione completa. Tuttavia, le sue capacità sono più limitate e mancano della varietà e sofisticazione disponibili nei database relazionali come PostgreSQL. Tra queste:
Usare gli indici nei tuoi database SQL e NoSQL è fondamentale per aumentare le prestazioni e ridurre i tempi di query, soprattutto su dataset di grandi dimensioni.
Ricorda però che aggiungere un indice può avere un impatto negativo sulle prestazioni delle operazioni di scrittura. Per tabelle o collezioni con un elevato rapporto scritture/letture, gli indici sono costosi perché ogni inserimento deve aggiornare anche gli indici.
Prestazioni e scalabilità in MongoDB vs PostgreSQL
MongoDB e PostgreSQL sono ottimi strumenti, ma non ha senso scegliere l’uno o l’altro in astratto, basandosi solo sulle proprietà. Dovresti sempre decidere in base alle specificità del tuo caso d’uso. Tenendo questo a mente, analizziamo le differenze di prestazioni e scalabilità tra MongoDB e PostgreSQL.
Elaborazione delle transazioni
Come altri popolari sistemi relazionali, PostgreSQL garantisce elevati livelli di integrità e qualità dei dati grazie al suo solido sistema di tipi e al supporto delle transazioni ACID (Atomicità, Coerenza, Isolamento, Durabilità).
Le transazioni ACID sono un insieme di proprietà che garantiscono l’elaborazione affidabile delle transazioni sul database. Assicurano che i dati restino accurati e sicuri anche in caso di errori, crash o accessi concorrenti. Queste proprietà sono vitali per mantenere la qualità dei dati in qualsiasi progetto.
Sebbene le transazioni ACID siano da tempo lo standard d’oro per garantire l’integrità dei dati nei database relazionali, i database NoSQL come MongoDB spesso privilegiano flessibilità e scalabilità rispetto alla rigorosa coerenza transazionale. Questo comporta un allentamento di alcune proprietà ACID tipiche dei database relazionali.
Per esempio, alcuni database MongoDB privilegiano la consistenza eventuale rispetto a quella immediata, il che significa che le modifiche potrebbero non essere riflesse istantaneamente su tutti i nodi. Il compromesso tra coerenza, disponibilità e prestazioni consente migliori performance e scalabilità, ma richiede un’attenta progettazione quando le applicazioni dipendono da una coerenza rigorosa dei dati.
Pattern di scalabilità
Scalare significa usare diverse tecniche per gestire l’aumento del volume di dati e del traffico. In parole semplici, possiamo farlo tramite scalabilità verticale e orizzontale. La prima consiste nel potenziare e aggiungere risorse allo stesso server per gestire il carico crescente. La seconda si ottiene aggiungendo più server o nodi a un sistema distribuito, aumentando così la capacità.
PostgreSQL si affida principalmente alla scalabilità verticale per aumentare la capacità. Tuttavia, a differenza di altri database SQL popolari, consente anche la scalabilità orizzontale tramite partizionamento, sebbene richieda configurazioni complesse. Puoi approfondire tutti gli aspetti tecnici del partizionamento in PostgreSQL nel nostro corso Improving Query Performance in PostgreSQL.
Al contrario, nei sistemi NoSQL come MongoDB, la strategia di riferimento per gestire la crescita di traffico e volume dei dati è la scalabilità orizzontale. MongoDB è progettato per sfruttare lo sharding, una tecnica che consiste nel dividere un database in parti più piccole e gestibili chiamate "shard" e distribuirle su più server, consentendo al sistema di gestire dataset molto grandi e alti volumi di traffico.
Dai un’occhiata al nostro articolo Sharding vs Partitioning per scoprire tutto su queste popolari tecniche di scalabilità.
MongoDB vs PostgreSQL: analisi dei casi d’uso
Ora che conosciamo le caratteristiche e i punti di forza chiave di PostgreSQL e MongoDB, è il momento di analizzare gli scenari in cui sono più utili.
Scenari ideali per PostgreSQL
PostgreSQL è un’ottima scelta quando il tuo progetto richiederà:
Per fare alcuni esempi convincenti, PostgreSQL è un’idea solida per:
Implementazioni ottimali di MongoDB
MongoDB dà il meglio di sé quando è utile avere strutture dati flessibili che possano adattarsi dinamicamente a nuove informazioni e schemi, quando contano scalabilità e prestazioni e con dati non strutturati. Il design schema-less di MongoDB, unito alla scalabilità orizzontale, lo rende ideale per casi come:
Architetture ibride
Potrebbero esserci casi d’uso in cui è necessario combinare i punti di forza di MongoDB e PostgreSQL per ottenere una soluzione completa a requisiti dati eterogenei. Creare architetture ibride che combinano database SQL e NoSQL è possibile ed è un’ottima idea se devi unire forte coerenza nelle transazioni con un certo grado di flessibilità.
Per esempio, puoi usare MongoDB per scritture veloci nell’analisi in tempo reale e PostgreSQL per operazioni relazionali complesse e l’archiviazione di dati strutturati. Tuttavia, al momento non esiste un modo per “fondere” le funzionalità di entrambi. Userai semplicemente due database diversi in parallelo, aumentando la complessità del sistema: serve quindi un’analisi accurata prima di implementarli.
Considerazioni sulla migrazione
Se stai pianificando di migrare i dati da MongoDB a PostgreSQL o viceversa, dovrai considerare vari elementi:
Schemi del database
Se stai migrando da MongoDB a PostgreSQL, prima di trasferire i dati dovrai creare una tabella o più tabelle con uno schema predefinito, cioè un elenco di colonne con i relativi tipi di dato ed eventuali vincoli. Se vuoi spostare i tuoi dati su Mongo, dovrai definire come verranno incorporati nei documenti. Nonostante la natura flessibile dei documenti, un minimo di modellazione sarà essenziale per collocare i dati esistenti.
Potenziali trasformazioni dei dati
I dati che vuoi esportare potrebbero non avere il formato desiderato. In tal caso, prima della migrazione dovrai predisporre una sorta di pipeline per trasformarli nel formato corretto prima di inserirli nel database PostgreSQL o MongoDB.
Come migrare i dati
Esistono vari modi per eseguire una migrazione. Puoi farlo manualmente per passaggi di export/import di base, ma può essere un processo lungo, complesso e soggetto a errori, soprattutto se il database da migrare contiene molti dati. Ecco perché scegliere uno strumento ELT per svolgere il lavoro può essere una soluzione migliore. Ci sono molte soluzioni disponibili, sia per migrare da PostgreSQL a Mongo sia viceversa.
Ottimizzazione delle prestazioni
Considerare tecniche per aumentare le prestazioni durante la migrazione è cruciale, soprattutto nei processi più complessi. Ancora una volta, a seconda dell’origine e della destinazione, PostgreSQL e MongoDB offrono tecniche e strategie specifiche per velocizzare il processo, tra cui connection pooling, partizionamento, scelta della shard key e covered query.
Sicurezza e conformità
Proteggere il tuo deployment del database è fondamentale per garantire integrità, disponibilità e conformità dei dati. Sia MongoDB che PostgreSQL offrono metodi diversi per mettere in sicurezza i database. In questa sezione trattiamo alcune delle tecniche più comuni.
Meccanismi di autenticazione
PostgreSQL offre un’ampia gamma di metodi di autenticazione, gestibili efficacemente tramite ruoli. I ruoli sono entità che possono possedere oggetti del database e avere privilegi. Possono essere usati per autenticazione, gestione dei permessi e definizione dei livelli di accesso degli utenti. In PostgreSQL, un ruolo può funzionare come utente o come gruppo di utenti.
Puoi creare ruoli anche in MongoDB per impedire accessi non autorizzati. Il controllo basato sui ruoli segue il principio del minimo privilegio per minimizzare i rischi. MongoDB supporta diversi meccanismi di autenticazione, con lo SCRAM (Salted Challenge Response Authentication Mechanism) come meccanismo predefinito per un’autenticazione sicura basata su password.
Pratiche di cifratura
MongoDB offre numerose pratiche di cifratura per proteggere i tuoi dati, tra cui:
Anche PostgreSQL offre cifratura a vari livelli e fornisce flessibilità nel proteggere i dati da divulgazioni dovute a furto del server, amministratori malevoli e reti non sicure. Alcune opzioni includono:
Community ed ecosistema
Sia MongoDB che PostgreSQL sono strumenti molto popolari, con community in crescita ed ecosistemi floridi. Diamo un’occhiata.
Capacità di estensione
Le estensioni in PostgreSQL sono moduli aggiuntivi che ampliano le capacità del database. Sono come i pacchetti in Python o R. Negli ultimi anni è nato un ricco ecosistema di estensioni per potenziare PostgreSQL in ogni tipo di scenario, disciplina e caso d’uso. La maggior parte è disponibile nel PostgreSQL Extension Network.
Di contro, MongoDB offre un insieme più limitato di estensioni ed è per lo più orientato ad abilitare l’uso di MongoDB con altre tecnologie e framework, come IDE (es. Visual Studio Code) e sistemi cloud come Google Cloud. Tuttavia, possono essere disponibili pacchetti di terze parti per i vari linguaggi con cui normalmente gestisci MongoDB.
Trend di adozione
Sia PostgreSQL che MongoDB stanno vivendo un periodo d’oro, come mostrato nell’immagine seguente con i trend dei motori di database basati sui dati di DB-Engines.
Fonte: db-engines
Sebbene i sistemi di gestione di database relazionali siano ancora dominanti (incluso PostgreSQL, al 4° posto), il grafico evidenzia anche un notevole cambiamento negli ultimi anni, con database NoSQL come MongoDB e Redis in forte crescita. Questa traiettoria riflette l’adozione crescente di soluzioni flessibili e scalabili per gestire dati non strutturati e supportare applicazioni ad alto traffico.
Tabella di confronto: PostgreSQL vs MongoDB
Ecco una tabella che riassume le differenze tra i database MongoDB e PostgreSQL:
Caratteristica
MongoDB
PostgreSQL
Struttura dei dati
Archivia i dati come documenti (ad es. JSON, BSON), consentendo strutture flessibili e gerarchiche.
Archivia i dati in tabelle con righe e colonne, seguendo uno schema predefinito.
Flessibilità dello schema
Schema-less: i documenti possono avere strutture variabili, con campi e tipi di dato diversi.
Schema fisso: richiede uno schema predefinito con colonne e tipi di dato specifici.
Linguaggio di query
Usa il MongoDB Query Language (MQL) o simili, basato su oggetti e più flessibile.
Usa SQL (Structured Query Language) per interrogare dati strutturati.
Join
Evita i join incorporando dati correlati all’interno dei documenti (denormalizzazione).
Supporta join complessi tra tabelle (normalizzazione).
Prestazioni
Letture e scritture più veloci per dati non strutturati o semi-strutturati. Evita l’overhead dei join.
Ottime prestazioni per dati strutturati, ma i join possono rallentare le query.
Scalabilità
Scalabilità orizzontale: può distribuire i dati su più server tramite sharding.
Tipicamente scalabilità verticale: si affida a hardware più potente, anche se esiste supporto alla scalabilità orizzontale (es. con partizioni).
Supporto alle transazioni
Supporta transazioni ACID multi-documento (da MongoDB 4.0 in poi), ma in origine era progettato per operazioni non transazionali.
Pieno supporto a transazioni conformi ad ACID, offrendo forte coerenza e affidabilità.
Casi d’uso
Ideale per dati non strutturati o semi-strutturati come profili utente, log, cataloghi e strutture dati flessibili.
Ideale per dati strutturati con relazioni chiare, come registri finanziari o sistemi ERP.
Relazioni tra dati
Supporta dati annidati (denormalizzazione), facilitando il recupero di informazioni correlate con una singola query.
I database relazionali si basano su chiavi esterne per stabilire relazioni tra tabelle (normalizzazione).
Indicizzazione
Supporta l’indicizzazione ma manca della varietà e sofisticazione tipiche dei database relazionali.
Capacità di indicizzazione avanzate, con supporto a molteplici tipi di indice (ad es. B-tree, hash) per ottimizzare le prestazioni.
Coerenza
Fornisce coerenza eventuale in configurazioni distribuite ma offre anche forte coerenza quando necessario (tramite transazioni ACID).
Garantisce forte coerenza nella maggior parte dei casi grazie alle transazioni ACID e all’integrità relazionale.
Scalare il volume dei dati
Scala facilmente per grandi quantità di dati aggiungendo server (sharding).
Può scalare verticalmente, ma la scalabilità orizzontale richiede configurazioni più complesse (es. partizionamento).
Integrità dei dati
L’integrità è gestita all’interno di ciascun documento, ma gestire le relazioni tra documenti può essere più impegnativo.
Solido supporto integrato all’integrità tramite chiavi primarie ed esterne, e vincoli come UNIQUE e NOT NULL.
Facilità per gli sviluppatori
Developer-friendly: modellazione dati flessibile, funziona bene con applicazioni moderne (ad es. JSON, API REST).
Modellazione più rigida ma ben compresa dagli sviluppatori che conoscono SQL e dati strutturati.
Conclusione
MongoDB e PostgreSQL sono due dei database più popolari. Rappresentano ottimi esempi rispettivamente di database NoSQL e SQL e, confrontandoli, possiamo fare chiarezza su differenze, punti di forza e casi d’uso in cui possono risultare utili.
C’è molto da imparare sui database SQL e NoSQL. Su DataCamp vogliamo aiutarti con corsi e tutorial completi e aggiornati. Dai un’occhiata ad alcuni dei nostri contenuti dedicati ai database: