Cursus
AI-ondersteund coderen voor developers
1 uur 30 min
10.7K
Op dezelfde dag als de lancering van GLM-5.3 Flash heeft Alibaba's Qwen-team de gewichten vrijgegeven van Qwen3.8-Flash-Next, een multimodaal mixture-of-experts (MoE) model dat tevens dient als een vroege preview van de architectuur achter de aankomende Qwen4-familie.
Dit spiegelt wat Qwen3-Next deed voor Qwen3.5: de architectuurwijzigingen vooraf uitbrengen, nog vóór de volledige modellijn, zodat de community ze als eerste kan uitpluizen.
Het grote verhaal hier is de kostprijs. Dankzij een zeer efficiënte nieuwe architectuur kostte Qwen3.8-Flash-Next ruwweg een negende van wat nodig was om zijn voorganger, Qwen3.7-Plus, te trainen. Maar daarbij wordt geen kracht ingeleverd; het verslaat zelfs zwaargewichten als Claude Opus 4.6 Max op grote codetesten zoals SWE-bench.
In dit artikel bespreek ik alles wat nieuw is in Qwen3.8-Flash-Next: de architectuur en functies, en een verkenning van de benchmarks. Wil je dieper duiken in hoe je het model lokaal downloadt en draait, lees dan onze Qwen3.8-Flash-Next-tutorial. Zoek je context bij andere Chinese modellen, bekijk dan onze gids over Qwen3.8-Max en onze tutorial over DeepSeek-V4-Flash-0731 lokaal draaien. Tip: bekijk ook de nieuwe release van Qwen3.8-Omni-Flash.
Qwen3.8-Flash-Next is een multimodaal MoE-model van Alibaba's Qwen-team, uitgebracht op 26 augustus 2026, gepositioneerd als een kostenefficiënt werkpaard in plaats van een topklasse vlaggenschip.
Het zit qua intelligentie onder de Max-klasse modellen, maar onderbiedt bijna alles in prijs — precies het doel van de "Flash"-lijn.
Het model ondersteunt native een contextvenster van 262.144 tokens, uitbreidbaar tot 1.000.000 tokens met YaRN (de [Yet another RoPE extensioN]-methode, een positionele encoderingstechniek die het contextvenster van een model oprekt, zodat het enorme tekstinvoer aankan met behoud van de oorspronkelijke performance).
Het verwerkt tekst, beeld en video via één API, wat een van de redenen is dat het in de release-overzichten van augustus 2026 werd bestempeld als een "overnight community darling".
Wat deze release voor praktijkgebruikers relevant maakt, is de benchmark-per-dollar-verhouding.
Qwen3.8-Flash-Next verslaat zijn eigen 27B-broertje op elke gepubliceerde benchmark, en presteert beter dan Claude Opus 4.6 Max op de meeste praktische codeer- en agent-evaluaties, terwijl het slechts 6B parameters per token activeert. Dit is een preview van de Qwen4-architectuur, dus de ontwerpkeuzes hier laten zien waar Alibaba naartoe gaat.
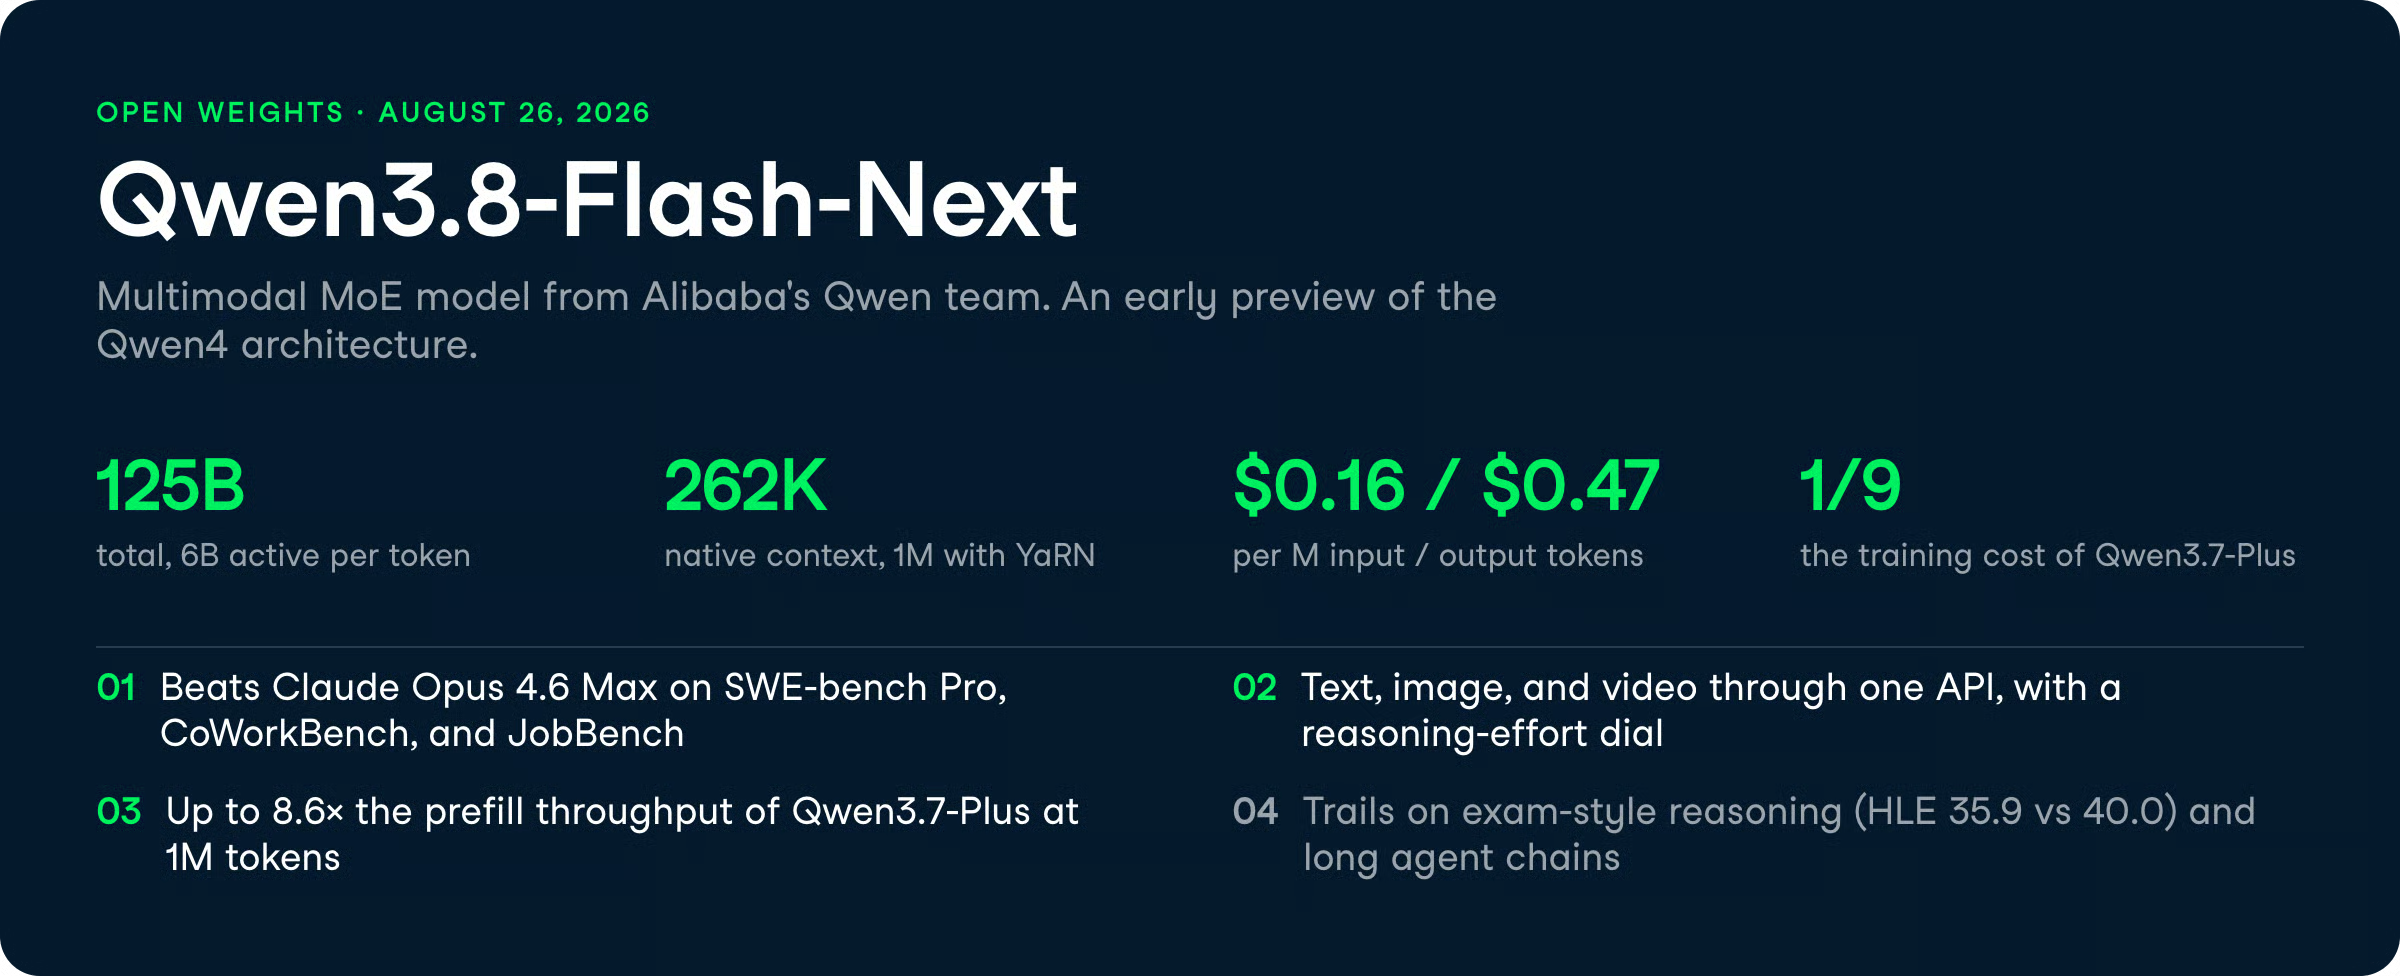
Qwen3.8-Flash-Next verbetert het model langs vier assen: attention, residual, embedding en optimalisatie.
Hieronder leg ik uit wat elke wijziging jou als gebruiker daadwerkelijk oplevert, in plaats van alleen wat het is.
De grootste praktische winst is snelheid bij lange input.
Qwen3.8-Flash-Next gebruikt een hybride attention-ontwerp, waarbij het het grootste deel van de contexthistorie comprimeert om ruimte te besparen, en een gerichte "Sparse Attention" inzet om alleen de meest relevante details op te halen wanneer nodig.
De versnellingen bij 1 miljoen tokens zijn enorm: tot 7,6x snellere promptverwerking (prefill) en 4,9x snellere generatie (decode). In een typische servingopzet met gecachte prefixes stijgt de algehele throughput met 8,6x vergeleken met Qwen3.7-Plus.
Voor iedereen die high-volume retrieval of repo-schaal codeeragents draait, is dat throughputverschil de feature.
Je betaalt voor compute, en dit ontwerp verlaagt de rekening precies bij de lange sequenties die vroeger berucht duur waren.
Qwen gebruikt een slimme truc genaamd N-gram Embedding om 51 miljard parameters zo goed als gratis toe te voegen. In plaats van slechts naar één token tegelijk te kijken, bekijkt het het huidige token plus zijn recente buren, waardoor het model een enorme "geheugen voor lokale patronen" krijgt.
Omdat het model vooraf weet wat het moet opzoeken, leven deze extra 51B parameters in het standaard werkgeheugen (RAM), niet op de GPU. Ze worden achter de schermen automatisch opgehaald, wat betekent dat ze nooit permanent GPU-geheugen bezet houden of de per-token compute vertragen.
Je krijgt de hersens van een veel groter model zonder de gebruikelijke VRAM-belasting te betalen.
Qwen3.8-Flash-Next verwerkt tekst, beeld en video via één interface, en de vision-capaciteiten presteren ver boven zijn prijsklasse.
Het verslaat Claude Opus 4.6 Max ruim op mobiele gebruikstests (84,5 vs 62,0 op AndroidWorld) en realistische visuele begripstaken (88,5 vs 73,9 op RealWorldQA).
Het is ook ijzersterk in visuele wiskunde, met scores tot 95,7 op MathVision (ruim voor op Opus' 65,5).
Als je workflow het parsen van screenshots, grafieken of app-UI's omvat, biedt Qwen een echt voordeel ten opzichte van Claude in deze prijsklasse.
De API geeft je een reasoning effort-knop met drie standen (hoog, midden en laag), waarmee je diep nadenken kunt inruilen voor lagere latency en goedkopere requests.
Het model bevat ook een module voor multi-tokenvoorspelling, wat in de praktijk betekent dat het meerdere stappen vooruit voorspelt om generatie te versnellen in echte workloads.
Het praktische gevolg is controle.
Je kunt de redeneerstand omlaag draaien voor hoog volume en kostenkritische traffic, en omhoog voor complexe agenttaken — allemaal met precies dezelfde model-ID.
Over de gepubliceerde cijfers heen leidt Qwen3.8-Flash-Next op de meeste codeer- en agent-benchmarks, terwijl het op enkele examenachtige redeneerevaluaties achterblijft.
Het verslaat zijn 27B-broertje overal, met de grootste verschillen bij agentwerk.
Alle vergelijkingen hieronder komen uit Qwens eigen releasetabel, tenzij anders vermeld.
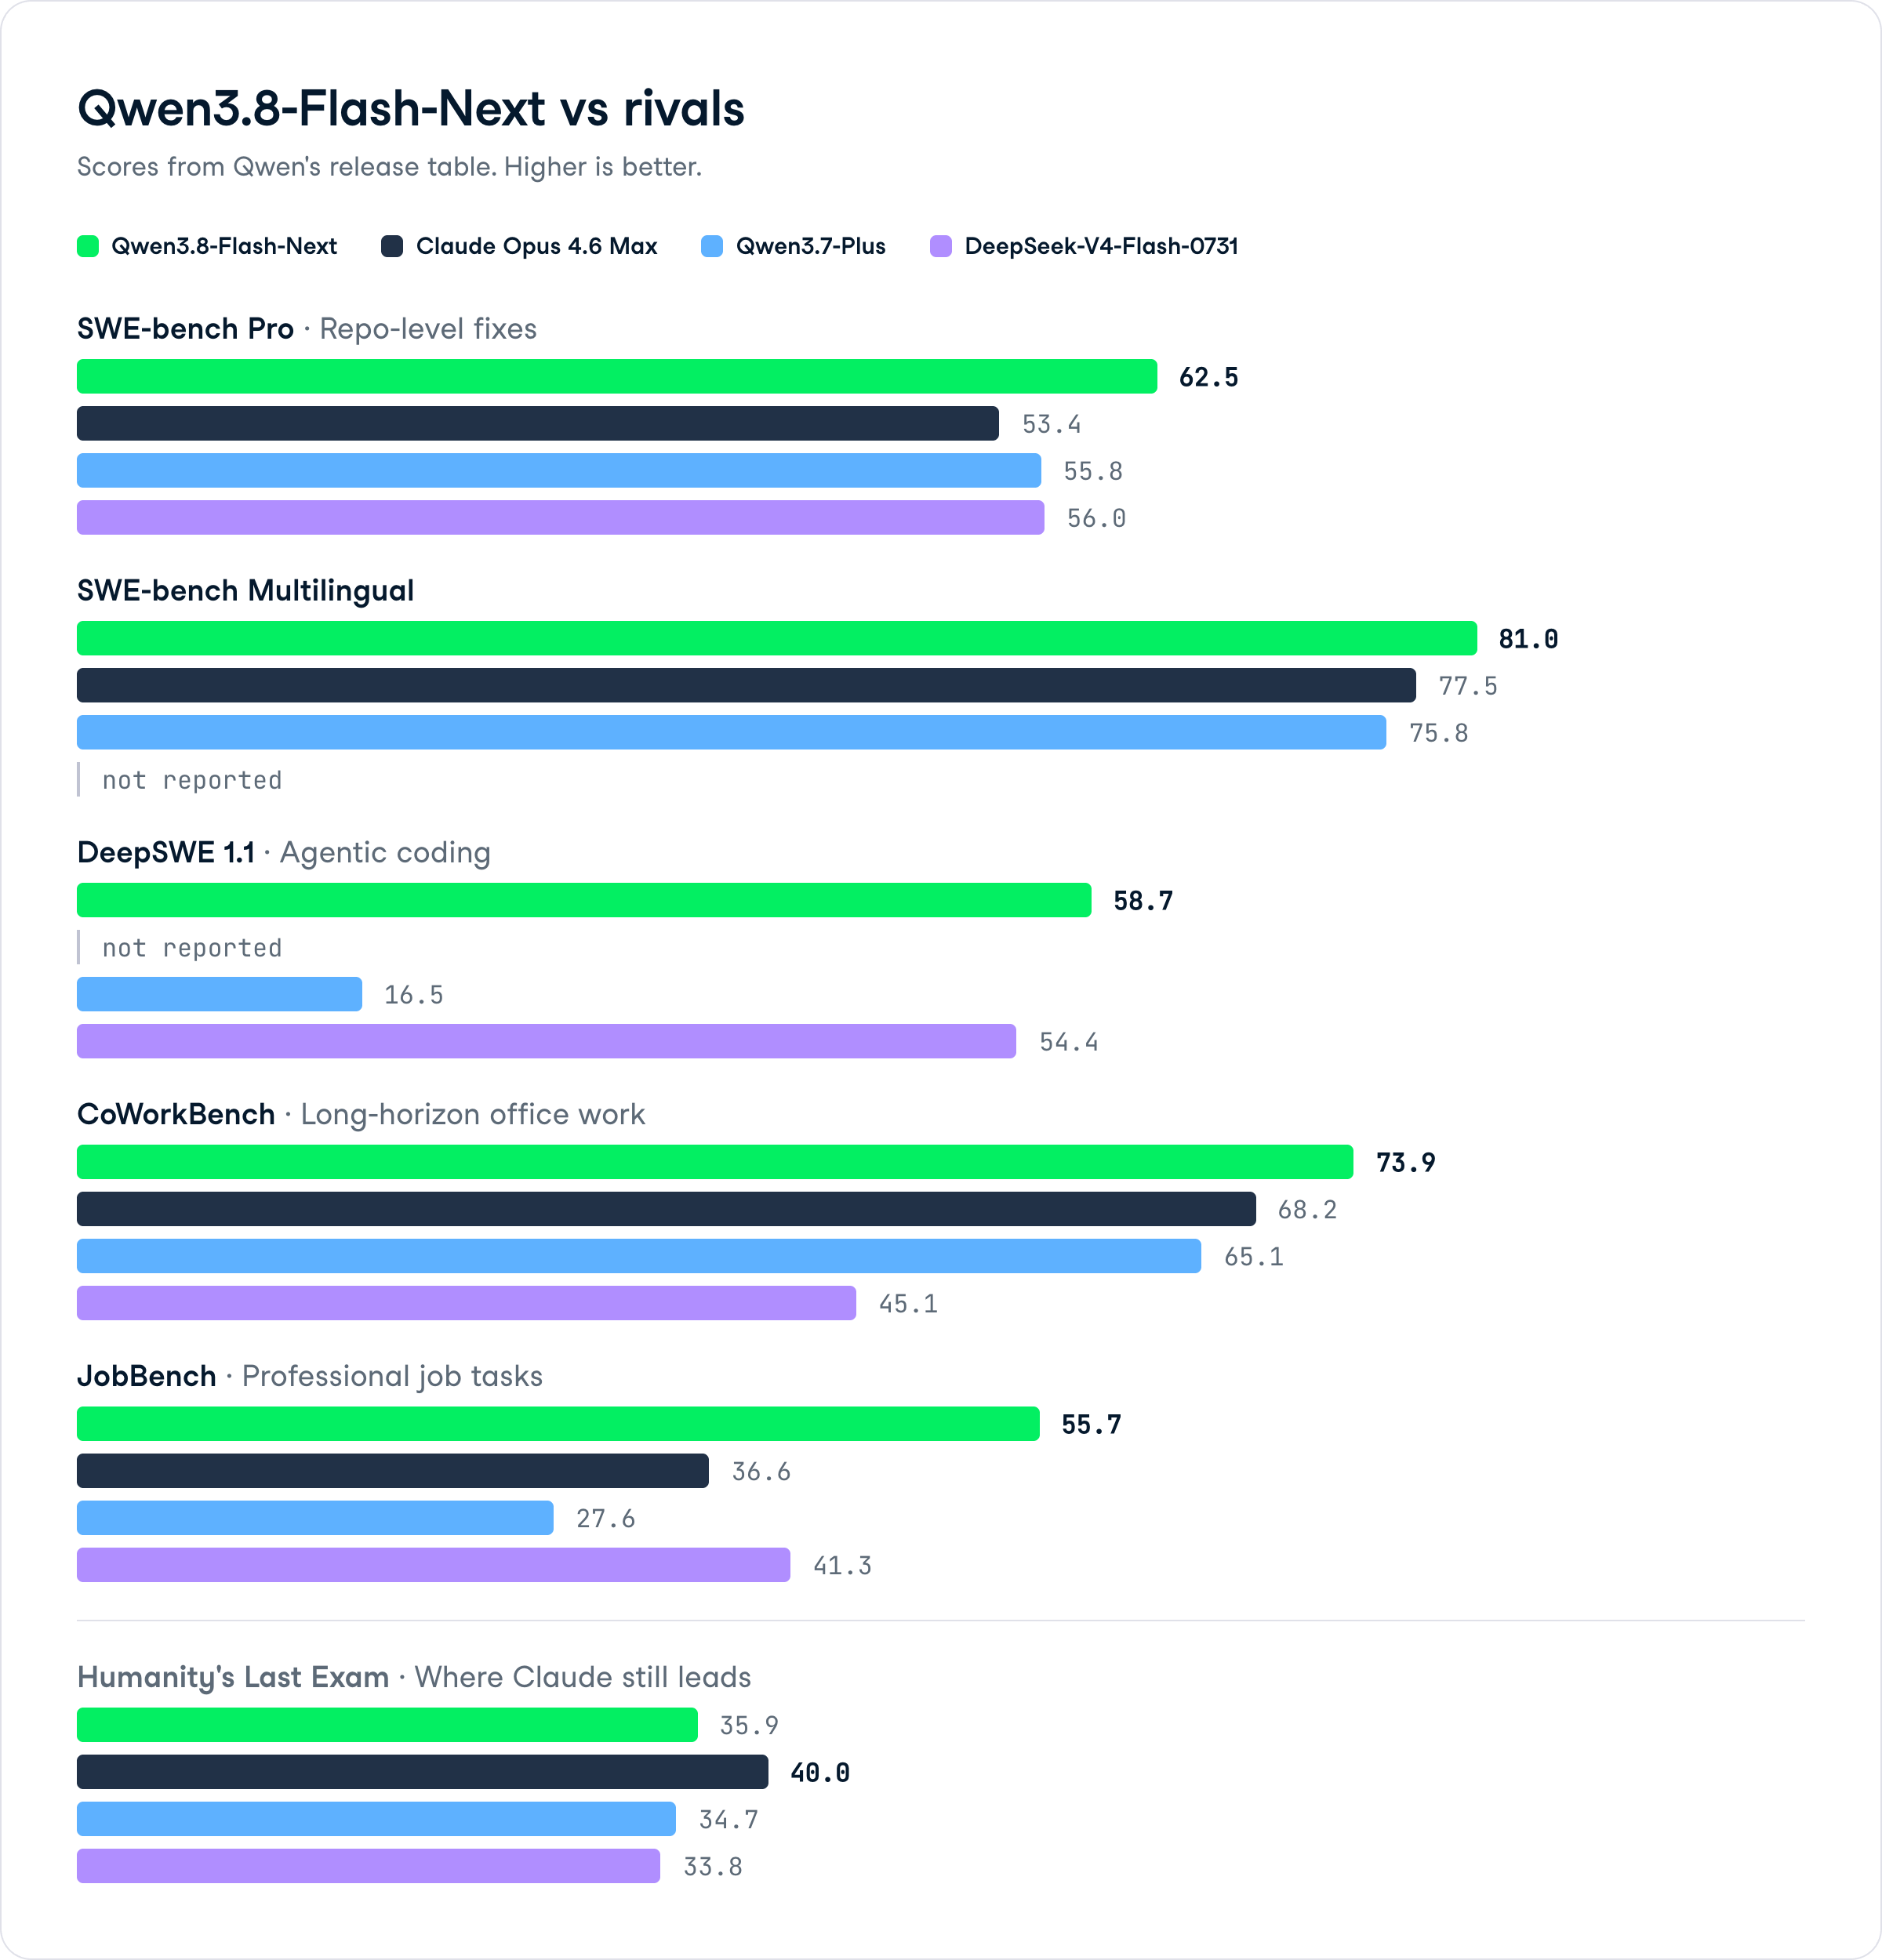
SWE-bench Pro meet echte softwarefixes op repolvl, en Qwen3.8-Flash-Next scoort 62,5, vóór Claude Opus 4.6 Max' 53,4 en Qwen3.7-Plus' 55,8.
Op SWE-bench Multilingual, dat fixes over talen heen test, behaalt het 81,0 tegenover Opus 4.6 Max' 77,5.
Dit zijn de cijfers die de release dragen.
Dat een 6B-actief model een Max-klasse Claude verslaat op repo-level engineering is de reden dat het zoveel aandacht trok.
DeepSWE 1.1 evalueert agentisch coderen via harnassen zoals Claude Code en mini-SWE-agent, en Qwen3.8-Flash-Next scoort 58,7 tegenover zijn 27B-broertje met 42,2 en Qwen3.7-Plus met 16,5.
DeepSeek-V4-Flash-0731 zit hier op 54,4.
Toen we DeepSeek-V4-Flash-0731 als codeeragent draaiden in onze tutorial, bouwde het een volledige aandelenanalyse-website uit één prompt in ongeveer 20 minuten, met chatgeneratie rond 33 tokens per seconde.
Het DeepSWE-verschil tussen de twee modellen suggereert dat Qwen3.8-Flash-Next zich in vergelijkbare agentische codeerlussen goed staande houdt.
Aan de agentkant zet het model sterke cijfers neer op verschillende evaluaties:
Het JobBench-verschil springt eruit.
Bij professionele workflowtaken scoort Qwen3.8-Flash-Next bijna 20 punten hoger dan een Max-klasse Claude, het soort resultaat dat het de moeite waard maakt om te testen voor enterprise-automatisering.
Op algemeen redeneren haalt Qwen3.8-Flash-Next 91,7 op GPQA Diamond (wetenschappelijk redeneren), net voor Claude Opus 4.6 Max' 91,3, en 91,9 op LiveCodeBench v6 (competitief coderen) tegenover Opus 4.6 Max' 88,8.
Het wint echter niet overal.
Op Humanity's Last Exam (HLE), dat multidisciplinair redeneren test, scoort het 35,9 tegenover Claude Opus 4.6 Max' 40,0. Op Agents' Last Exam Pass@1 klopt DeepSeek-V4-Flash-0731 het met 25,2 tegen 24,3.
Het patroon houdt stand over onafhankelijke trackers: Qwen3.8-Flash-Next leidt op praktisch coderen en agentwerk, terwijl Claude een voorsprong behoudt op enkele examenachtige redeneerbenchmarks.
Qwen3.8-Flash-Next-Base wint 8 van de 14 pretrain-benchmarks tegen de basismodellen van Qwen3.8-27B en het veel grotere Qwen3.7-Plus.
Het leidt op MMLU-Pro (73,23), SuperGPQA (51,36), BBH (90,87), GSM8K (93,29), EvalPlus (78,76), SWEBench-Pretrain (50,99), MGSM (89,33) en MMMLU (84,86).
Opvallend is dat het dit doet met 6B geactiveerde parameters tegenover Qwen3.7-Plus' 17B actief en 397B totaal, en binnen een punt blijft op MMLU, MMLU-Redux, GPQA, MATH en MultiPL-E.
De 51B N-gram embedding-parameters worden deterministisch aangesproken en komen nooit in het per-token matmul-budget, dus dit is echte efficiëntie en geen parametertruc.
Zo verhoudt het model zich tot Claude Opus 4.6 Max, zijn voorganger Qwen3.7-Plus, en DeepSeek-V4-Flash-0731 op de belangrijkste evaluaties.
| Benchmark | Qwen3.8-Flash-Next | Claude Opus 4.6 Max | Qwen3.7-Plus | DeepSeek-V4-Flash-0731 |
|---|---|---|---|---|
| SWE-bench Pro | 62.5 | 53.4 | 55.8 | 56.0 |
| SWE-bench Multilingual | 81.0 | 77.5 | 75.8 | -- |
| DeepSWE 1.1 | 58.7 | -- | 16.5 | 54.4 |
| CoWorkBench | 73.9 | 68.2 | 65.1 | 45.1 |
| JobBench | 55.7 | 36.6 | 27.6 | 41.3 |
| GPQA Diamond | 91.7 | 91.3 | 90.3 | 90.8 |
| LiveCodeBench v6 | 91.9 | 88.8 | 89.6 | 90.6 |
| HLE | 35.9 | 40.0 | 34.7 | 33.8 |
De Qwen3.8-Flash-Next-gewichten zijn nu beschikbaar als open-weight model op Hugging Face en ModelScope.
De productieversie, met standaard 1M context en ingebouwde tools, wordt als Qwen3.8-Flash aangeboden op QwenCloud onder de model-ID qwen3.8-flash.
Prijs is waar dit model het hardst concurreert:
Ter vergelijking: onze Qwen3.8-Max-coverage vermeldt dat model op $2,00 input en $6,00 output per miljoen tokens, dus Flash-Next is meer dan 10x goedkoper op input dan zijn eigen Max-broer.
QwenCloud ondersteunt OpenAI-compatibele Chat Completions- en Responses-API's plus een Anthropic-compatibele interface, waardoor het met minimale configwijzigingen in Claude Code, Codex en Qwen Code te gebruiken is.
Let op: bij de aankondiging stond de API als binnenkort beschikbaar; check QwenCloud voor de actuele status.
GLM-5.3-Flash is het andere budgetmodel dat op dezelfde dag werd gelanceerd en is de meest directe rivaal om naast elkaar te zetten.
| Qwen3.8-Flash-Next | GLM-5.3-Flash | |
|---|---|---|
| Architectuur | 125B totaal / 6B actief | 320B totaal / 18B actief |
| Native context | 262K (1M met YaRN) | 1M tokens |
| DeepSWE v1.1 | 58.7 | 63.4 |
| SWE-bench Pro | 62.5 | Niet gepubliceerd |
| Inputprijs | $0,16/1M | ~$0,075/1M (promo) |
| Multimodaal | Ja | Ja |
GLM-5.3-Flash leidt op DeepSWE v1.1 (63,4 vs 58,7) en scoort 84,3 op Terminal-Bench 2.1, een benchmark waar Qwen geen cijfers voor publiceert.
Het heeft ook een lagere inputprijs tijdens het promotievenster en een 1M-token contextvenster native, zonder YaRN nodig te hebben.
Qwen3.8-Flash-Next leidt op SWE-bench Pro (62,5), CoWorkBench (73,9) en JobBench (55,7), waar GLM geen equivalente cijfers publiceert. Qwen activeert ook aanzienlijk minder parameters per token (6B vs 18B), wat het aanzienlijk goedkoper maakt om zelf te hosten en sneller om op schaal te serven.
Samengevat: GLM heeft sterkere gepubliceerde cijfers op de benchmarks die ze direct delen. Qwen leidt op kantoor- en professionele workflowevaluaties, en is de betere keuze als je je eigen infrastructuur draait. Voor een volledige uitleg van GLM-5.3-Flash zie onze uitgebreide gids.
Qwen3.8-Flash-Next is Alibaba's duidelijke statement dat kostenefficiëntie het slagveld is.
Claude Opus 4.6 Max verslaan op SWE-bench Pro, CoWorkBench en JobBench met 6B actieve parameters, voor $0,16 per miljoen invoertokens, is een serieus aanbod voor iedereen die high-volume codeer- of agentworkloads draait.
Ik zou het zien als een sterke standaardkeuze voor toolgedreven en code-intensieve pipelines, met twee kanttekeningen.
Communityrapporten melden af en toe instabiliteit bij zeer lange agentketens en kwetsbaarheid wanneer tools niet-standaard JSON teruggeven, en het model is minder conservatief qua veiligheid dan de Claude-serie, dus het vereist zorgvuldige prompting bij grensgevallen.
De HLE- en Agents' Last Exam-resultaten laten ook zien dat dit niet het model is voor de allerzwaarste examenachtige redeneerklussen.
Als vroege preview van de Qwen4-architectuur zijn de GDN + QSA-hybride en N-gram Embedding-ontwerpen het volgen waard, want daarop wordt de volledige Qwen4-familie gebouwd.
Als Alibaba deze benchmark-per-dollar-verhouding op vlaggenschipniveau kan vasthouden, verandert het gesprek over frontier-prijzen.
Wil je agentische en codeerworkflows bouwen rond dit soort modellen, begin dan met onze AI Agent Fundamentals skill track om snel bij te raken met de kernconcepten.
Topcursussen op DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min