Cursus
AI-ondersteund coderen voor developers
1 uur 30 min
10.7K
Z.ai heeft GLM-5.3-Flash uitgebracht, het kosten-geoptimaliseerde zusje van de vlaggenschip GLM-5.3. Het model verscheen eerst onder een anonieme preview-codenaam en werd later publiekelijk onthuld als "Ox Alpha". Qwen3.8-Flash-Next lanceerde op dezelfde dag, waardoor het budgetsegment voor LLM’s meteen in beweging kwam.
Volg je de race tussen Chinese labs met open weights en de Westerse frontier? Dan is dit er een om te bekijken.
De hoofdclaim is simpel: bijna-frontier prestaties voor codering en agent-taken tegen een fractie van de kosten.
GLM-5.3-Flash scoort 84,3 op Terminal-Bench 2.1, waarmee het in de buurt komt van Claude Opus 4.8 (85,0) en GPT-5.6 Terra (87,4).
Het gebruikt een mixture-of-experts-ontwerp in een 320B-A18B-configuratie (320B totale parameters, 18B actief per token), ondersteunt een contextvenster van 1M tokens en is native multimodaal.
In dit artikel behandel ik alles wat nieuw is aan GLM-5.3-Flash, met de functies en de benchmarks. Wil je het model in actie zien? Bekijk dan onze GLM-5.3-Flash-tutorial, waarin we het met CrewAI gebruiken om een multi-agent financieel analystenteam te bouwen.
Wil je het vergelijken met het andere budgetmodel dat op dezelfde dag verscheen? Zie onze gids voor Qwen3.8-Flash-Next. En voor een vergelijkbaar MoE-model dat we lokaal draaiden, bekijk onze tutorial over DeepSeek-V4-Flash-0731 lokaal draaien.
GLM-5.3-Flash is Z.ai’s kosten-geoptimaliseerde model binnen de GLM-5.3-familie. Qua capaciteiten onder de volwaardige vlaggenschip GLM-5.3, maar qua prijs veel lager.
Artificial Analysis geeft het een intelligence index van 57, tegenover 60 voor GLM-5.3.
De ruil is snelheid en kosten: Flash draait voor ongeveer een tiende van de prijs van GLM-5.2, of circa een negende van GLM-5.3’s gemiddelde prijs, en is trager per token.
Het model verscheen eerst als anonieme preview voordat het werd benoemd, en de community koppelde er al snel de codenaam "Ox Alpha" aan.
Het publieke checkpoint is beschikbaar als zai-org/GLM-5.3-Flash op Hugging Face, met ondersteuning voor lange context (~1M tokens) en tool-calling en multimodale mogelijkheden die via het omliggende ecosysteem beschikbaar zijn.
De belangrijkste benchmark hier is Terminal-Bench 2.1, waar GLM-5.3-Flash 84,3 behaalt. Dat ligt boven de 82,7 die we zagen voor DeepSeek-V4-Flash-0731, en slechts 0,7 punten achter Claude Opus 4.8. Voor een model met een geschatte, gebruiksgewogen gemiddelde prijs rond $0,10 per 1M tokens is dat hét verhaal van deze release.
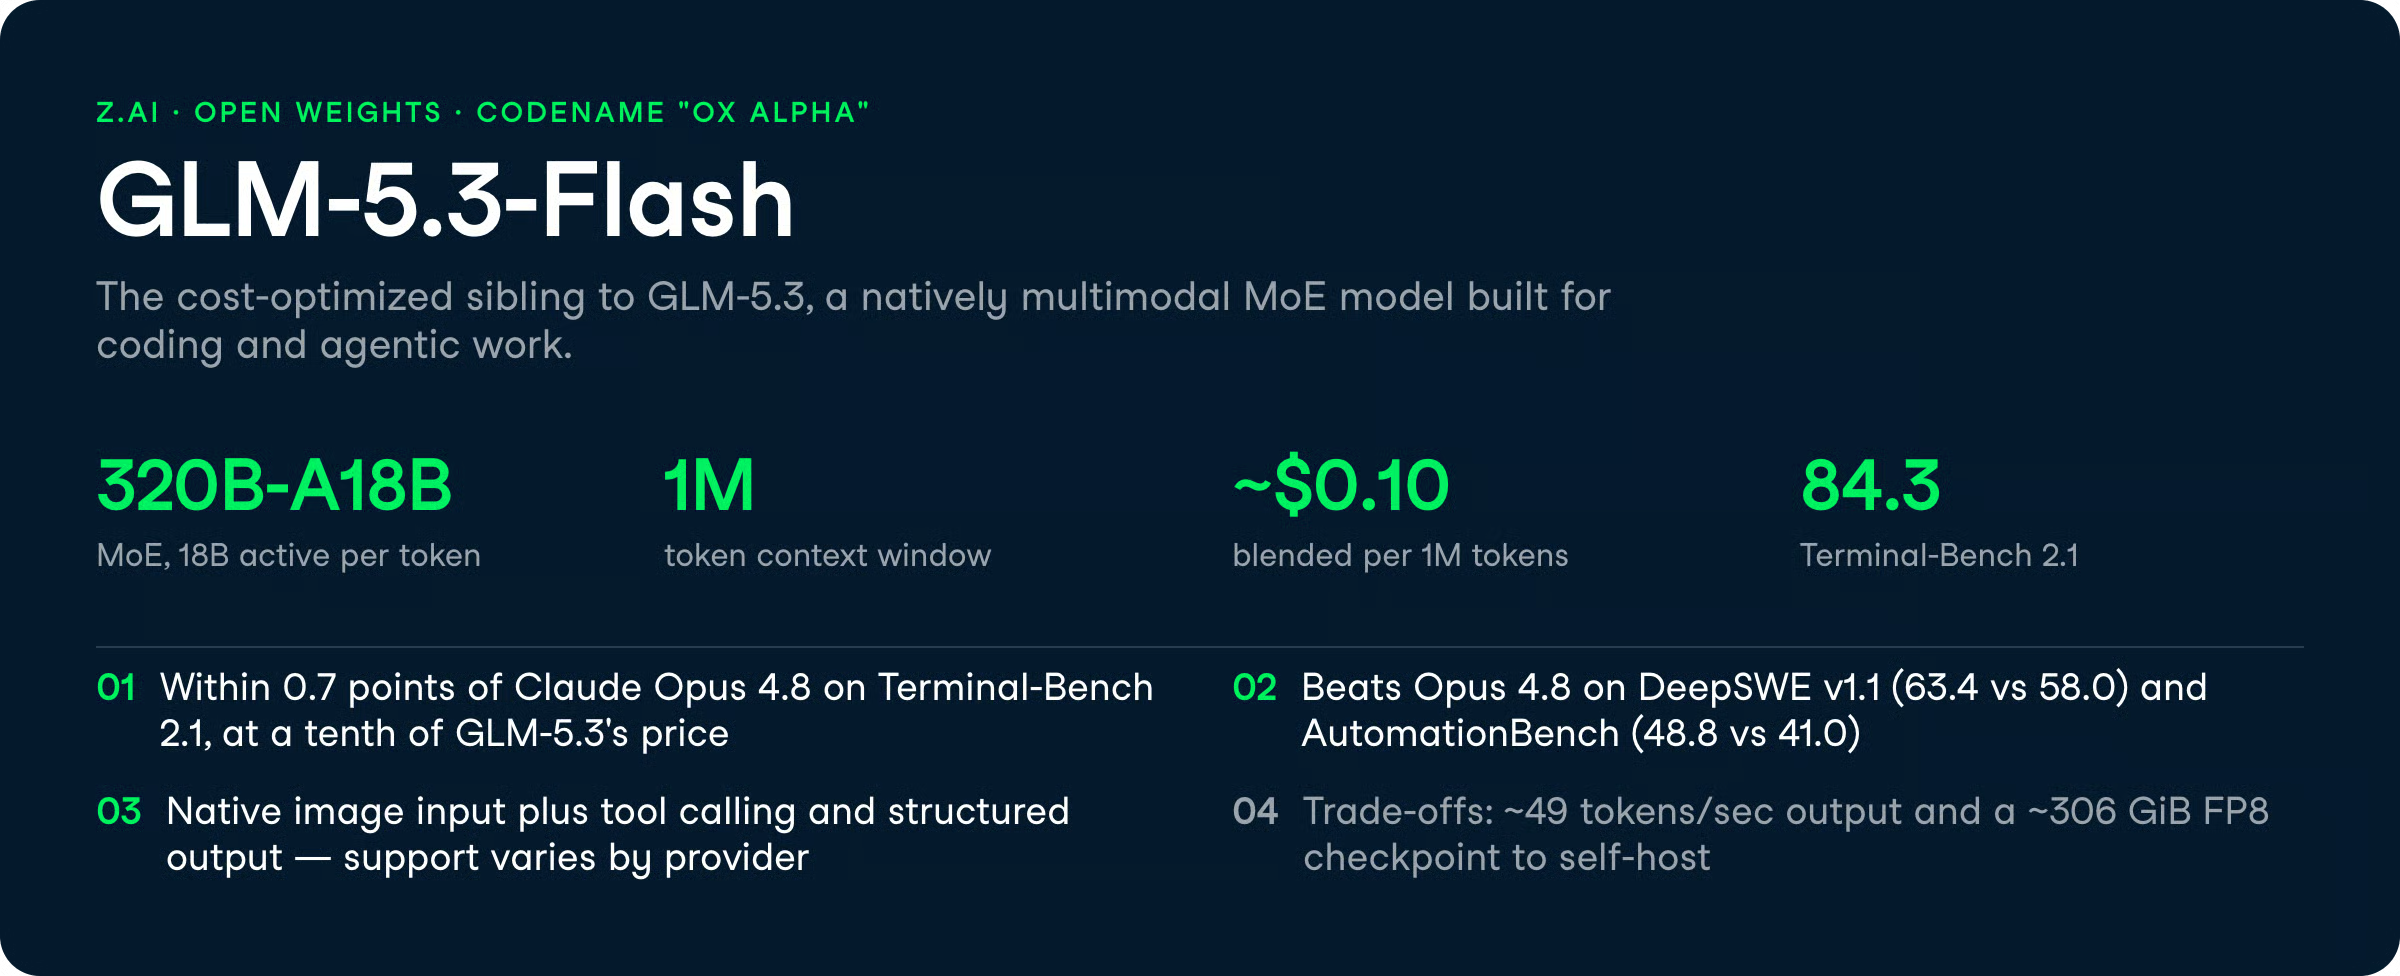
GLM-5.3-Flash is gebouwd voor developers die agent- en codeerprestaties willen zonder vlaggenschipprijzen.
Dit zijn de mogelijkheden die voor praktisch werk het meest tellen.
Je kunt codeeragenten en automatiseringsworkflows draaien tegen een prijsniveau dat grootschalig gebruik realistisch maakt.
GLM-5.3-Flash scoort 84,3 op Terminal-Bench 2.1 en 63,4 op DeepSWE v1.1, een forse sprong vanaf GLM-5.2’s 46,2 op dezelfde DeepSWE-evaluatie.
Voor practitioners is de aantrekkingskracht het draaien van codetaken die op Opus-klasse modellen duur zouden zijn.
Sommige vergelijkingen schetsen Flash als "sterk" voor codering en automation agents tegen aanzienlijk lagere kosten dan GLM-5.3, en de DeepSWE-sprong boven GLM-5.2 suggereert dat de codeerverbeteringen reëel zijn in plaats van benchmarkspecifiek.
Je kunt volledige codebases, lange documenten of agent-traces met meerdere bestanden in één aanvraag stoppen.
GLM-5.3-Flash ondersteunt een contextvenster van 1M tokens, net als GLM-5.3 en de 1M-vensters op GPT-5.6 Terra en Claude Sonnet 5.
Er zijn echter communitymeldingen van aandacht die "wegdrijft" op extreme lengtes voorbij grofweg 700K tokens, een beperking die het deelt met de meeste modellen met grote contextvensters.
Er wordt goede recall over honderden duizenden tokens gerapporteerd, maar ga niet uit van perfecte retrieval aan het einde van het venster.
Je kunt GLM-5.3-Flash integreren in agent-frameworks met function calls en afgedwongen JSON-schema’s. Het model scoort 78,4 op Toolathlon en 48,8 op AutomationBench, dat laatste een grote sprong vanaf GLM-5.2’s 26,2.
Let op één ding: de ondersteuning verschilt per provider.
Sommige gateways markeren gestructureerde output als niet-ondersteund, en systeem-prompthandling verschilt tussen gehoste providers, dus je moet mogelijk je toolschema en JSON-modus per endpoint aanpassen.
Je kunt afbeeldingen naast tekst meegeven voor grafieklezing, documentanalyse en visueel redeneren.
GLM-5.3-Flash scoort 89,4% op CharXiv-R, 80,5 op MMVU en 78,0 op Chartography, wat wijst op solide afhandeling van grafieken en visuele documenten.
De multimodale ondersteuning is native in plaats van achteraf toegevoegd, al hangt, net als bij tool-calling, het exacte oppervlak af van de provider die je gebruikt. Een kale Hugging Face-checkout laat mogelijk niet alles zien wat de gehoste API wel biedt.
GLM-5.3-Flash scoort 57 op de Artificial Analysis Intelligence Index v4.1.1 tegen $0,045 per taak (met korting). Z.ai zegt dat dit intelligentieniveau voorheen ongeveer tien keer zoveel kostte.
De evaluatie met zes benchmarks hieronder vergelijkt Flash met GLM-5.2, DeepSeek-V4-Vision-Exp, Claude Opus 4.8, GPT-5.6 Terra en Gemini 3.7 Flash.
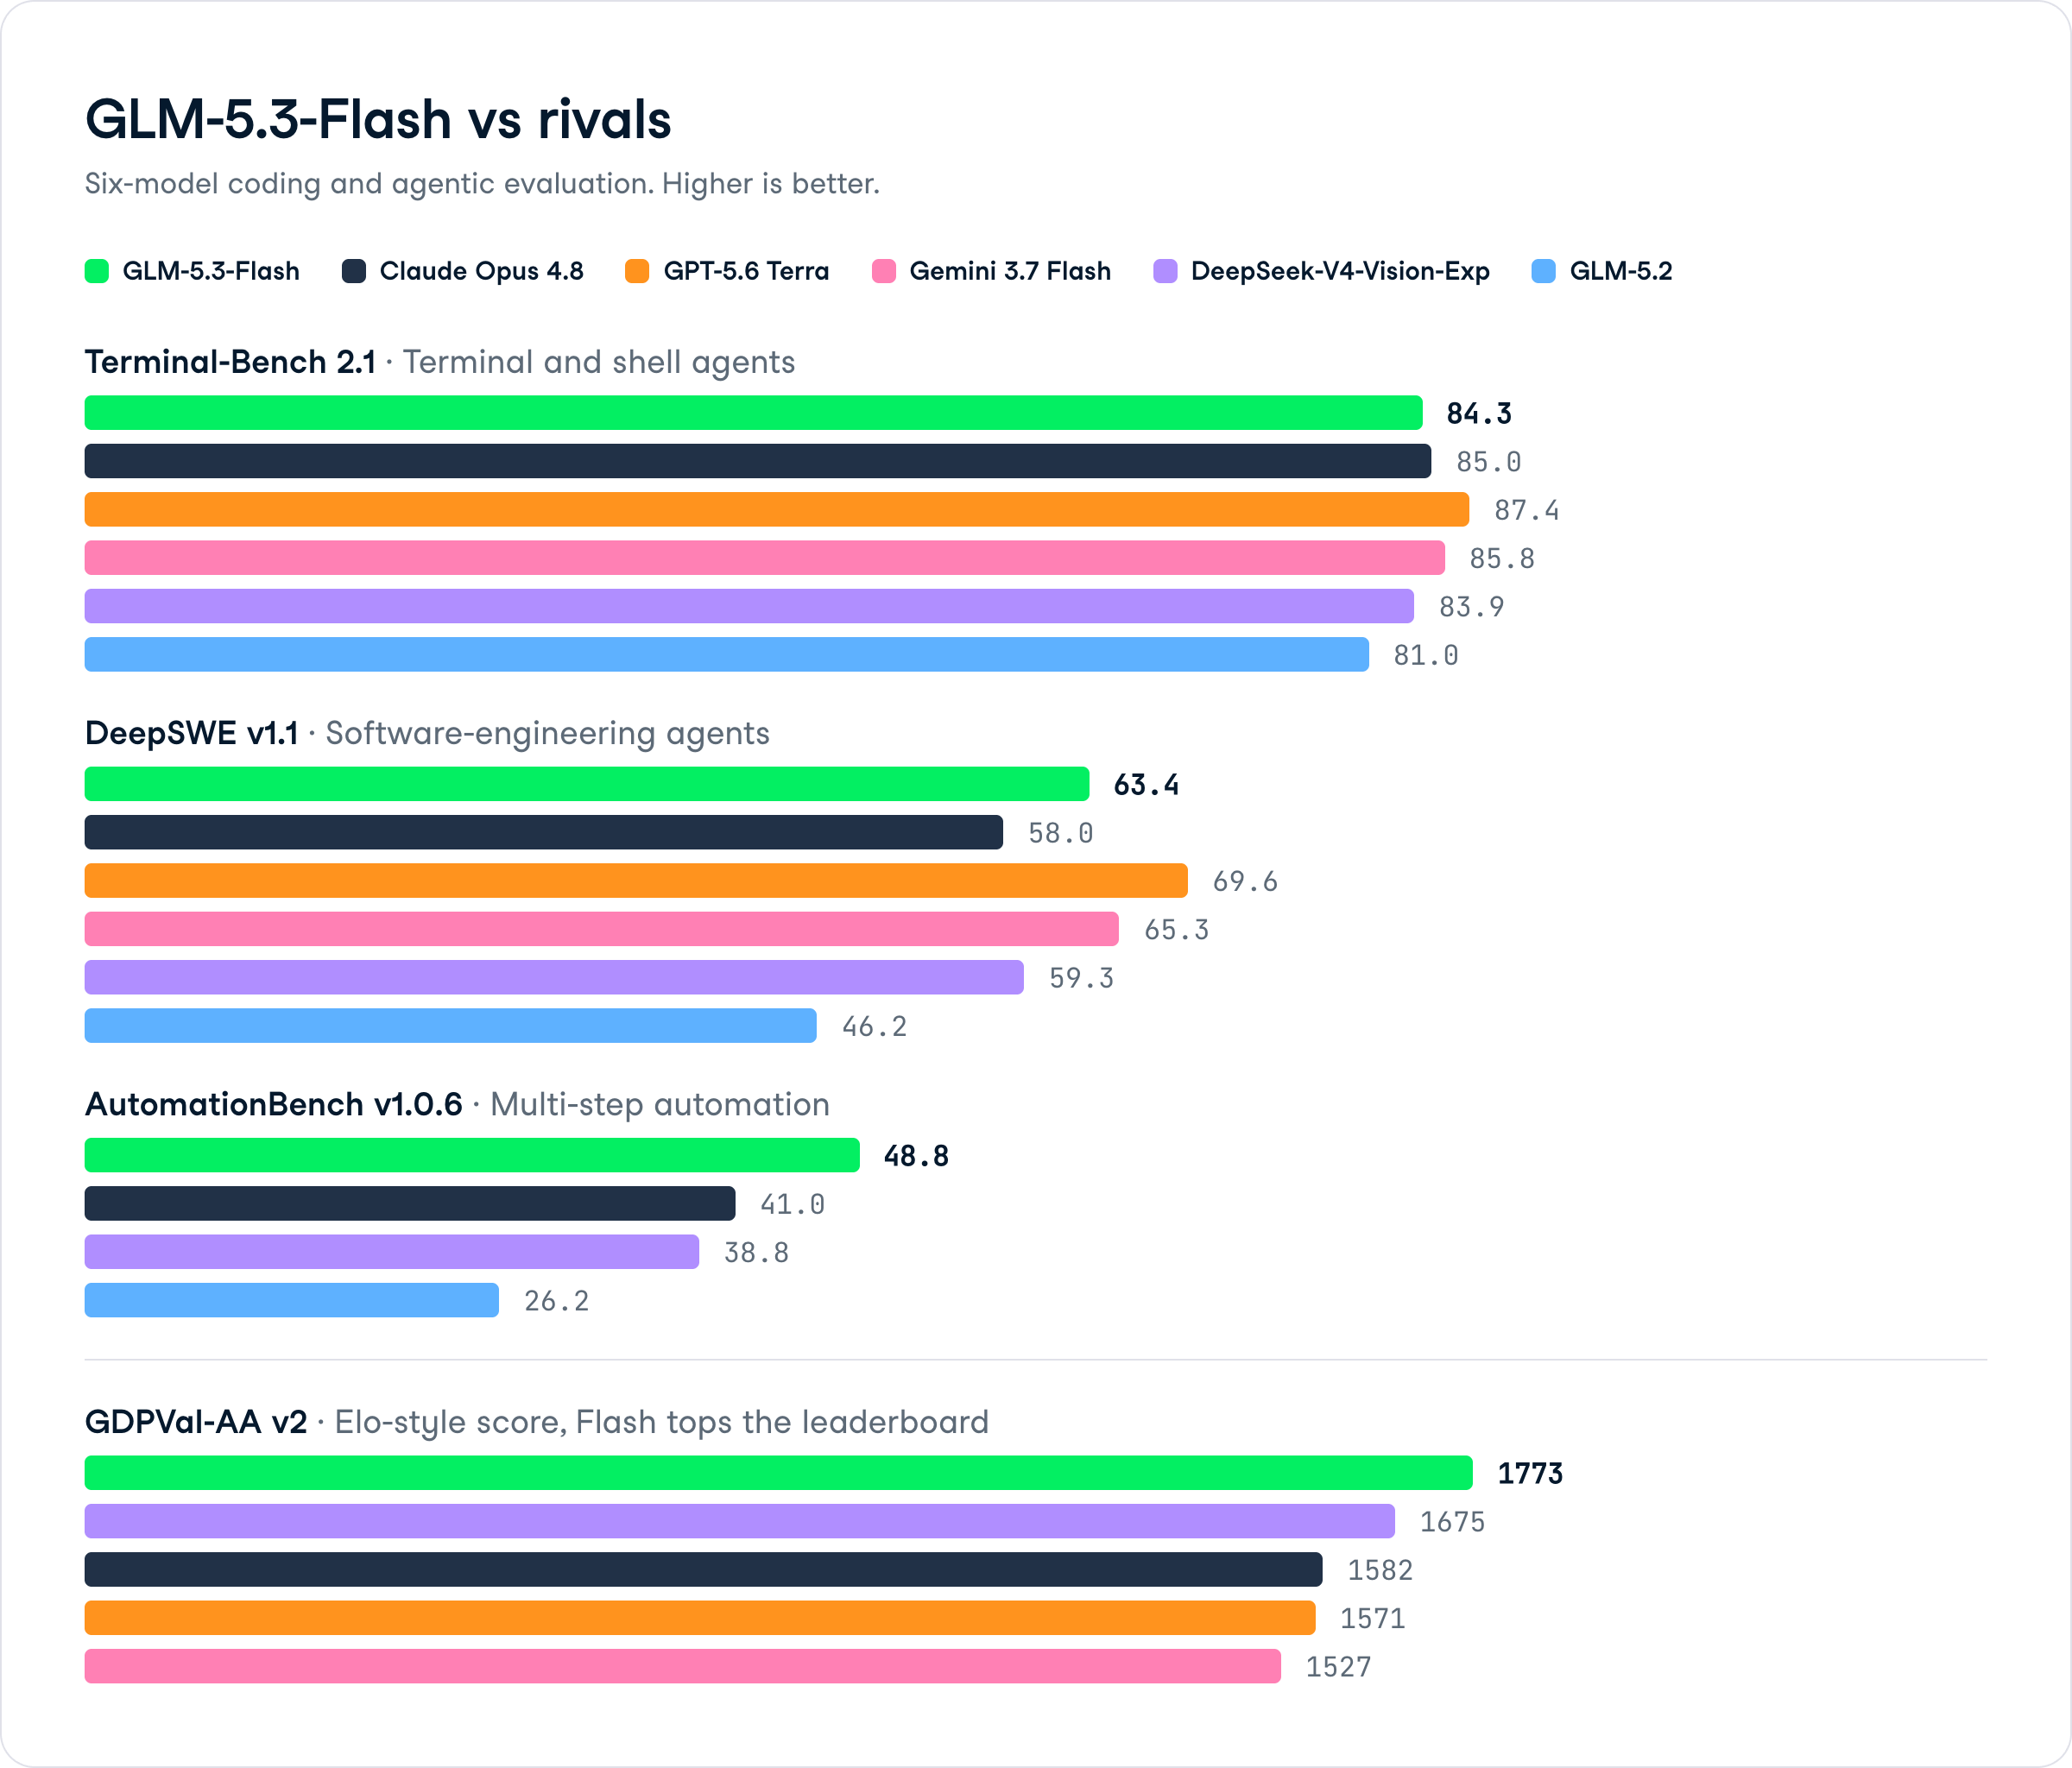
Op deze software-engineering agent-benchmark scoort GLM-5.3-Flash 63,4, vóór Claude Opus 4.8 (58,0) en DeepSeek-V4-Vision-Exp (59,3), en omhoog vanaf GLM-5.2’s 46,2.
Het blijft achter bij GPT-5.6 Terra (69,6) en Gemini 3.7 Flash (65,3), maar Claude verslaan tegen Flash-kosten is hier de praktische kop.
GLM-5.3-Flash scoort 48,8 op meerstaps automatiseringsworkflows, de grootste voorsprong op Claude Opus 4.8 (41,0) en DeepSeek-V4-Vision-Exp (38,8) van alle benchmarks in de set.
GLM-5.2 scoorde 26,2, dus dit is ook de scherpste generatie-op-generatieverbetering.
Op deze algemene ontwikkel- en programmeerevaluatie staat Flash bovenaan met 1773, vóór DeepSeek-V4-Vision-Exp (1675), Claude Opus 4.8 (1582), GPT-5.6 Terra (1571) en Gemini 3.7 Flash (1527).
Flash scoort 84,3 op terminal- en shell-agenttaken, net onder Claude Opus 4.8 (85,0) en Gemini 3.7 Flash (85,8), en achter GPT-5.6 Terra (87,4). Het is GLM-5.2 (81,0) en DeepSeek-V4-Vision-Exp (83,9) nipt de baas. Competitief, niet dominant.
GLM-5.3-Flash is beschikbaar via de API van Z.ai en via meerdere gateways van derden, waaronder Baseten, Deep Infra, Venice AI en Requesty.
Het publieke checkpoint zai-org/GLM-5.3-Flash staat op Hugging Face voor self-hosting.
Z.ai’s officiële basisprijslijst en de tijdelijke promotie zijn als volgt:
Apidog meldt een gebruiksgewogen gemiddelde prijs van ongeveer $0,10 per 1M tokens voor Flash, versus circa $0,90 voor GLM-5.3.
Gateways van derden hanteren andere prijzen: EmpirioLabs op $0,07 input / $0,25 output, Venice AI op $0,09 / $0,31 en Requesty op $0,14 / $0,45 met een promo van 55% korting tot 9 sep 2026.
De keerzijde zit in throughput en hardware.
Flash draait op ~49 tokens/sec tegenover ~86 voor GLM-5.3, en Artificial Analysis geeft een 2/4 voor snelheid.
Self-hosting is ook niet lichtgewicht: het FP8-checkpoint is ~306 GiB aan gewichten alleen al, vóór KV-cache en runtime, dus je hebt meerdere GPU’s met veel geheugen nodig (denk >4×80 GiB-klasse) in plaats van een enkele kaart.
De keuze draait om kosten versus intelligence index en throughput. De tabel hieronder vat de ruil samen.
| Attribuut | GLM-5.3-Flash | GLM-5.3 |
|---|---|---|
| Intelligence index (Artificial Analysis) | 57 | 60 |
| Gemiddelde prijs / 1M tokens | ~$0,10 | ~$0,90 |
| Uitvoersnelheid | ~49 tokens/sec | ~86 tokens/sec |
| Tijd tot eerste token | ~1,52 s | ~1,57 s |
| Terminal-Bench 2.1 | 84,3 | N.v.t. in notities |
| Contextvenster | 1M | 1M |
Kies Flash wanneer kosten per token de beperkende factor zijn en je werk om codering of agent-taken draait. Kies GLM-5.3 wanneer je de extra intelligence index en grofweg dubbele throughput nodig hebt.
Beide modellen lanceerden op 26 augustus 2026 en mikken op dezelfde budget-agentlaag. GLM-5.3-Flash is Qwen3.8-Flash-Next de baas op de ene benchmark die ze direct delen (DeepSWE v1.1: 63,4 vs 58,7), maar de modellen zijn voldoende anders gebouwd dat de keuze meer afhangt van je workload dan van een enkele score.
| GLM-5.3-Flash | Qwen3.8-Flash-Next | |
|---|---|---|
| Architectuur | 320B totaal / 18B actief | 125B totaal / 6B actief |
| Native context | 1M tokens | 262K (1M met YaRN) |
| DeepSWE v1.1 | 63,4 | 58,7 |
| Inputprijs | ~$0,075/1M (promo) | $0,16/1M |
| Multimodaal | Ja (native) | Ja (native) |
GLM-5.3-Flash activeert drie keer zoveel parameters per token, wat waarschijnlijk de voorsprong op DeepSWE en de Terminal-Bench 2.1-score (84,3) verklaart.
Qwen3.8-Flash-Next zet daar sterkere gerapporteerde scores tegenover op SWE-bench Pro (62,5) en kantoor- en agentbenchmarks zoals CoWorkBench (73,9) en JobBench (55,7), waar GLM geen vergelijkbare cijfers publiceert.
Qua prijs is GLM goedkoper tijdens het promotievenster. Qua parameterefficiëntie doet Qwen meer met een kleinere actieve footprint. Voor self-hosting is Qwens kleinere checkpoint aanzienlijk makkelijker lokaal te draaien.
Als je prioriteit ligt bij codeeragenten en ruwe agent-throughput, heeft GLM-5.3-Flash de sterkere cijfers waar de vergelijking direct is. Als je workflows kantoor-gericht, multimodaal zijn of baat hebben bij een kleiner self-hosted checkpoint, test dan eerst Qwen3.8-Flash-Next.
Zie onze volledige gids voor Qwen3.8-Flash-Next voor een complete uiteenzetting.
GLM-5.3-Flash laat zien dat Z.ai vol inzet op het budget-agentsegment: kom binnen één à twee punten van Opus 4.8 en GPT-5.6 Terra op code-evaluaties en onderbied ze vervolgens met een orde van grootte op prijs.
De 84,3 op Terminal-Bench 2.1 tegen ongeveer $0,10 gemiddeld per 1M tokens is de pitch, en die is sterk voor grootschalige codering en automatisering.
De beperkingen zitten in snelheid en infrastructuur.
Met ~49 tokens/sec is het niet het model voor latency-gevoelige streaming, en het ~306 GiB FP8-checkpoint maakt casual lokale deployment onwaarschijnlijk. Vroege preview-gebruikers op r/opencodeCLI meldden wachttijden en trage starts bij drukte, al zal GA dat waarschijnlijk verbeterd hebben.
Mijn indruk: als kosten per token je harde beperking zijn en je werk om codering of agent-taken draait, is GLM-5.3-Flash het waard om te testen tegen GPT-5.6 Terra en Claude Opus 4.8 voordat je je vastlegt.
Heb je de extra 3 punten intelligence index en snellere throughput nodig, dan is de volledige GLM-5.3 er niet voor niets. Het model landde ook op dezelfde dag als Qwen3.8-Flash-Next, dus het loont nu zeker om in de budgetlaag rond te kijken.
Wil je comfortabel leren werken met dit soort modellen? Dan raad ik onze AI Fundamentals skill track aan voor de basis, gevolgd door onze tutorial over een MoE Flash-model lokaal draaien voor het praktische deel.
Topcursussen op DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min