
Cursus
AI-ondersteund coderen voor developers
1 uur 30 min
10.5K
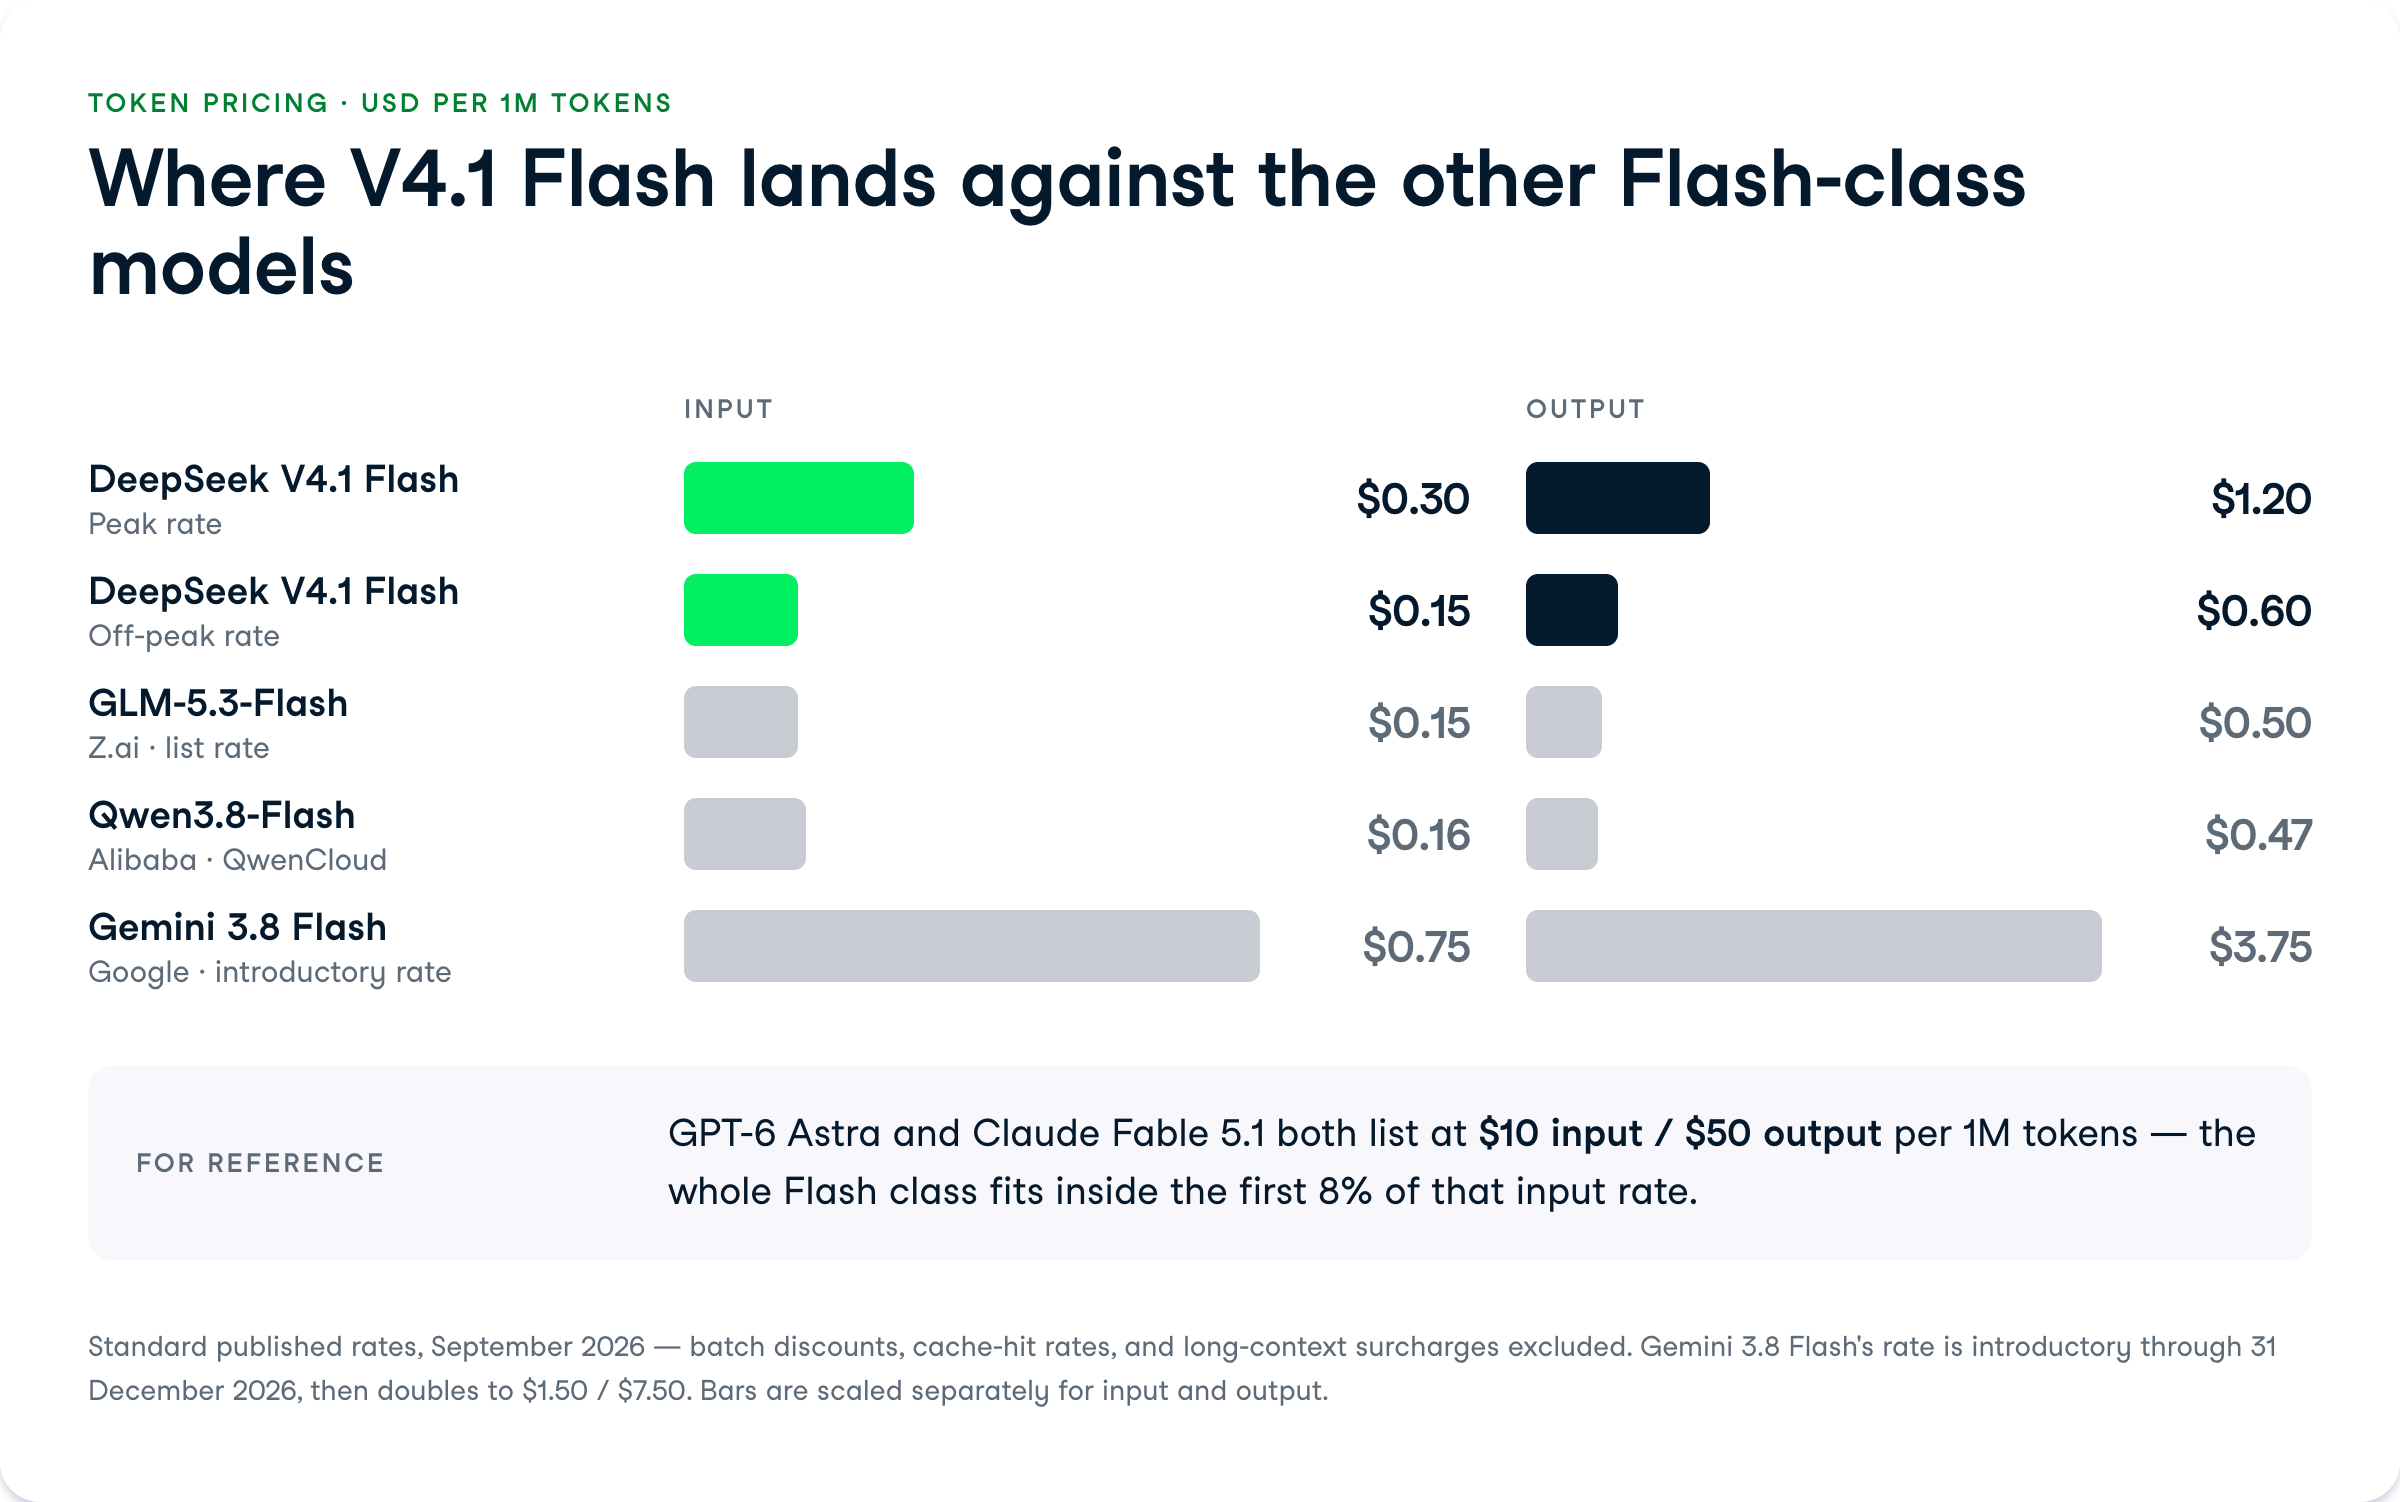
De frontier-modellenrace eind 2026 is vooral een prijzenslag geweest in plaats van pure capaciteit. Alleen al in september zagen we OpenAI's GPT-6 Astra en Anthropic's Claude Fable 5.1 beide op $10 per 1M inputtokens en $50 per 1M outputtokens, en geen van beide is beschikbaar in gratis tiers.
DeepSeek kiest ervoor om precies de andere kant op te gaan.
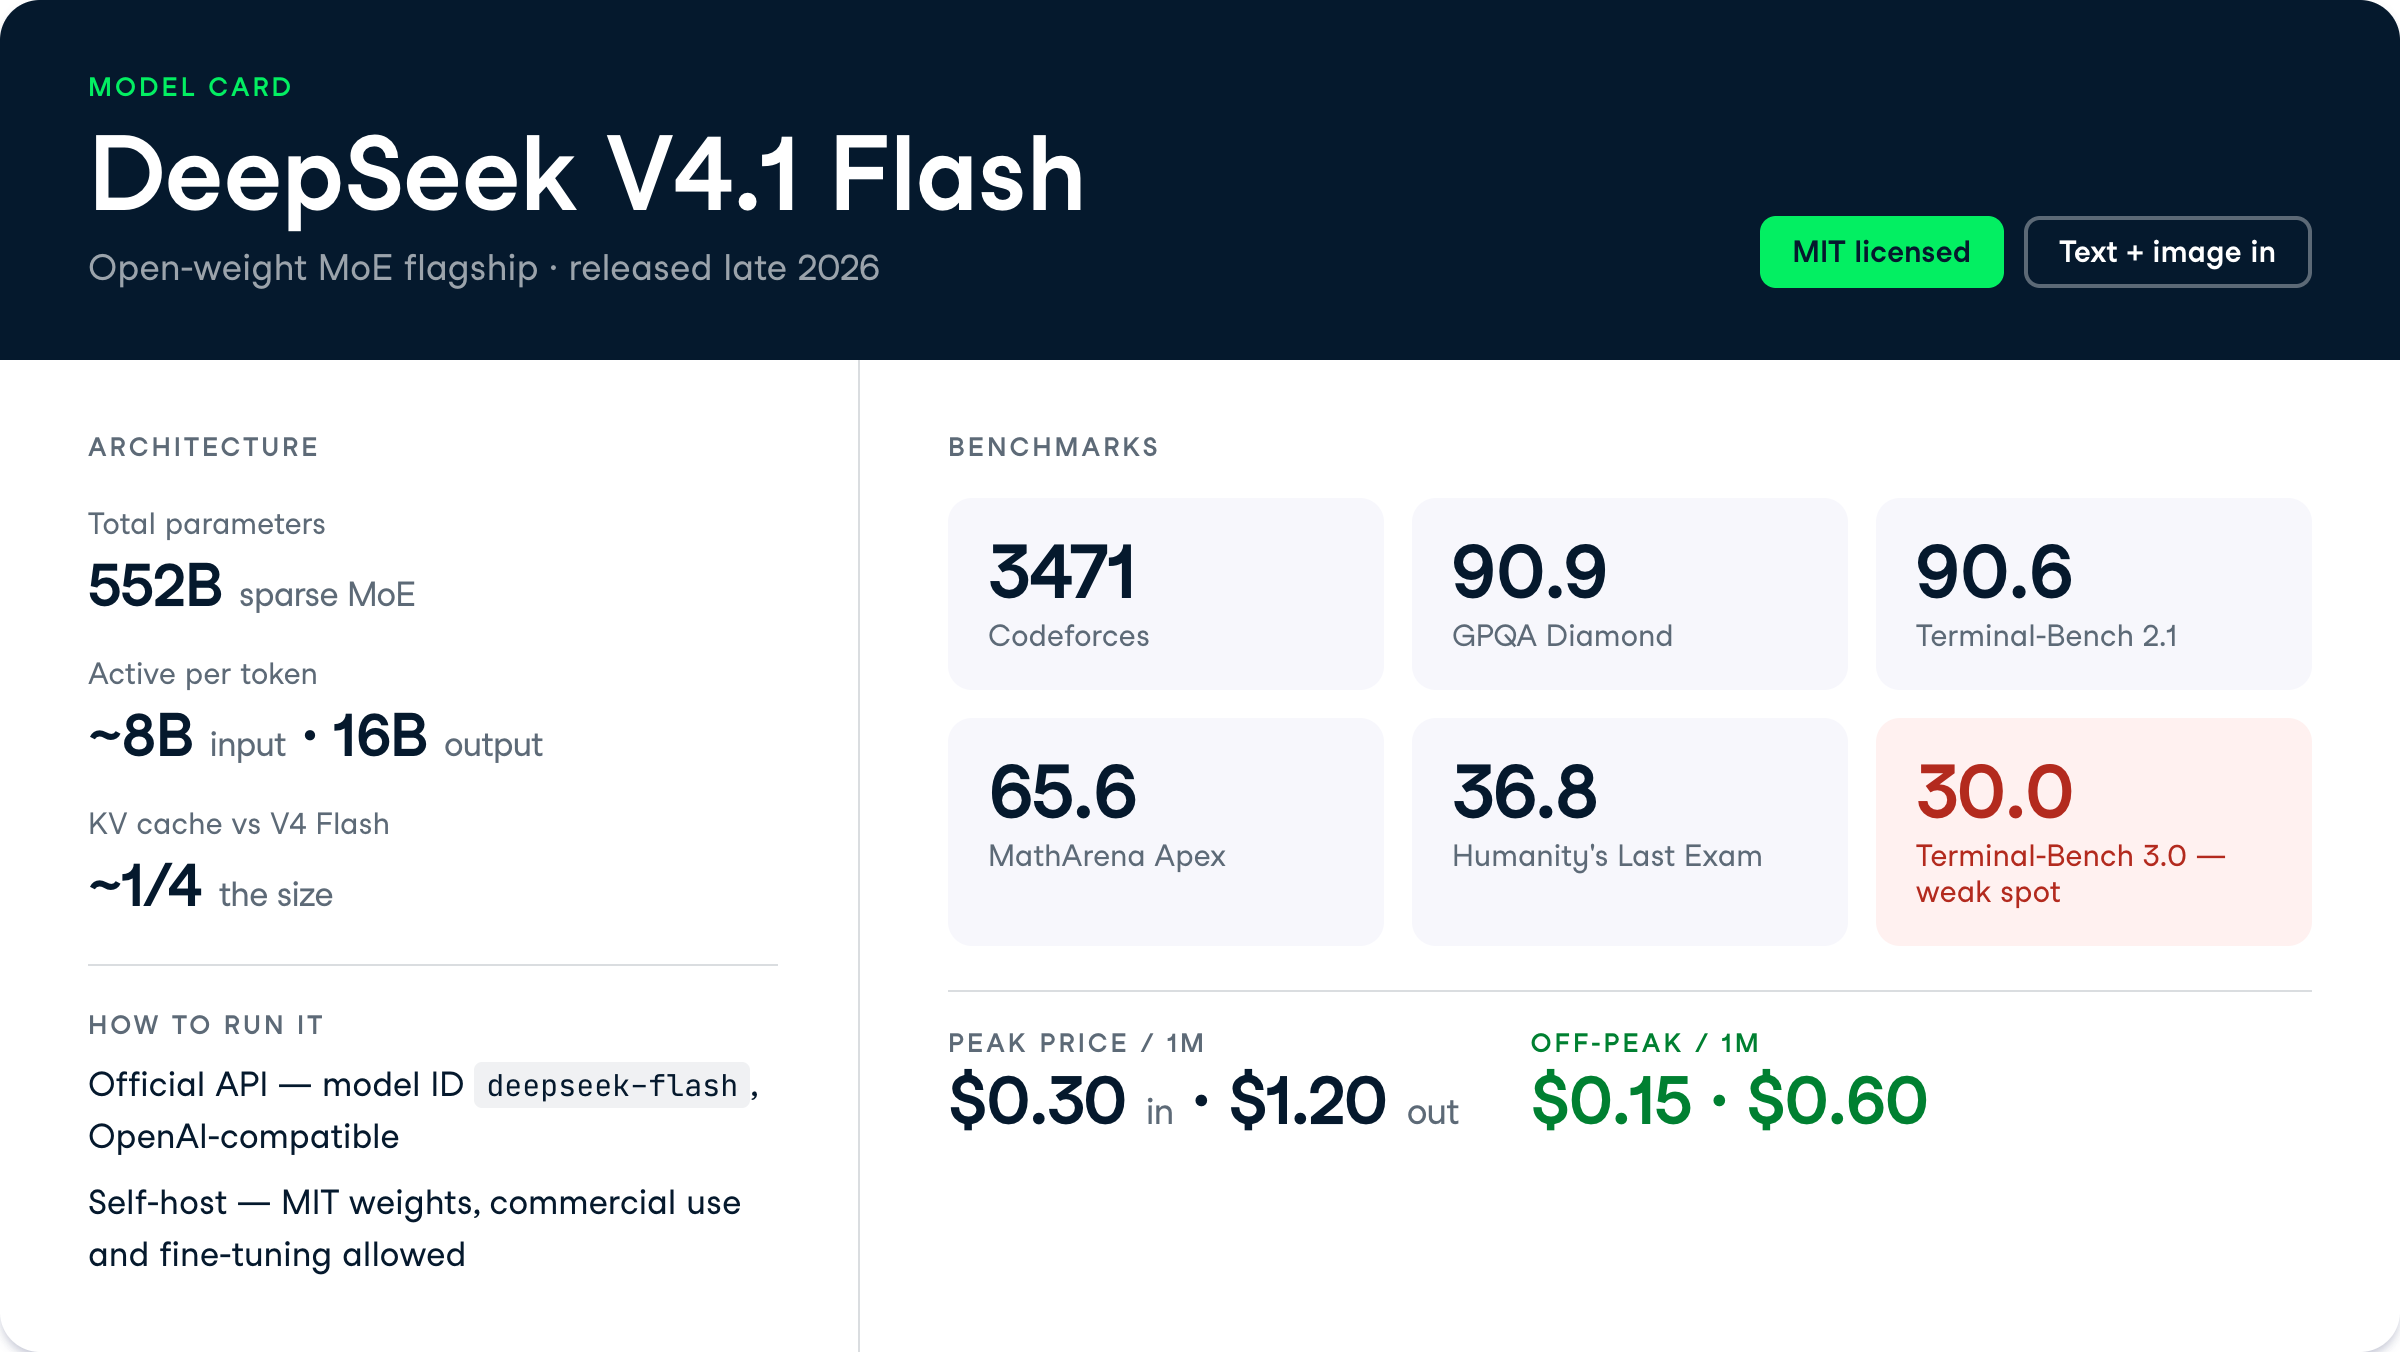
DeepSeek V4.1 Flash is een mixture-of-experts-model met 552 miljard parameters, dat ongeveer 8B parameters activeert voor input en 16B voor output, geleverd met open, MIT-gelicentieerde gewichten, en kost $0,30/$1,20 per 1M tokens op piekuren en $0,15/$0,60 buiten piekuren. Daarmee verslaat het andere vergelijkbare Flash-modellen, zoals Gemini 3.8 Flash en GLM-5.3-Flash.
In dit artikel bespreek ik alles wat nieuw is in DeepSeek V4.1 Flash, met een blik op de nieuwe functies en de benchmarks. Wil je het model in actie zien, lees dan onze DeepSeek V4.1 API-tutorial.
Wil je meer weten over de DeepSeek-familie, bekijk dan onze gids voor het draaien van DeepSeek-V4-Flash-0731 met Unsloth Studio en OpenCode, en onze vergelijking van DeepSeek v4.1 Flash vs Gemini 3.8 Flash.
DeepSeek V4.1 Flash is het nieuwste model in DeepSeeks Flash-lijn, gepositioneerd als de efficiënte, high-throughput laag in plaats van een onderzoekszwaargewicht.
Het is een sparse mixture-of-experts (MoE)-architectuur met in totaal 552B parameters, waarvan er per token slechts ongeveer 8B actief zijn bij input en 16B bij output. Die sparse activatie houdt de serveerkosten laag, terwijl het toch frontier-niveaus haalt op meerdere benchmarks.
De belangrijkste verandering ten opzichte van de vorige generatie is efficiëntie.
DeepSeek heeft de KV-cache verkleind tot ongeveer een kwart van de omvang van de vorige V4 Flash, wat het geheugengebruik verlaagt en het model toelaat langere contexten goedkoper te bedienen. Het bedrijf stelt ook dat V4.1 Flash de oudere V4 Pro 0813 voorbijstreeft op prestaties, kosten, snelheid en totale tijd, en V4 Pro wordt daarom uitgefaseerd.
Op benchmarkgebied springt vooral Terminal-Bench 2.1 met 90,6 in het oog. Toen we de eerdere DeepSeek-V4-Flash-0731 testten, scoorde die 82,7 op dezelfde benchmark, dus V4.1 Flash is een duidelijke stap vooruit voor agentic terminalwerk binnen dezelfde familie.
De functieset van V4.1 Flash draait om twee ideeën: goedkoop draaien en open blijven. Dit zijn de capaciteiten die het meest tellen voor een werkende data scientist of ML-engineer.
V4.1 Flash wordt geleverd met MIT-gelicentieerde gewichten, de meest permissieve veelvoorkomende licentie, die commercieel gebruik, herdistributie en fine-tuning zonder omzetdrempels toestaat.
Voor teams met privacy-eisen rond data betekent dit dat je het model volledig op je eigen hardware kunt draaien in plaats van verzoeken naar de DeepSeek API te sturen.
Het nadeel is dat de MIT-licentie de verantwoordelijkheid voor veiligheid, fine-tuning en inferentie-optimalisatie bij jou legt.
Toen we de eerdere V4-Flash-0731 lokaal draaiden, had die drie NVIDIA A100 80GB GPU's nodig bij Q8-kwantisatie, dus zelf hosten is alleen haalbaar als je echt GPU-geheugen over hebt.
V4.1 Flash accepteert afbeeldingen rechtstreeks als invoer, zonder aparte vision-adapter of preprocessing-stap. Zo kun je schermafbeeldingen, grafieken of documentenscans samen met tekst in hetzelfde verzoek meesturen, handig voor documentzware pijplijnen en UI-agentworkflows.
Native multimodale invoer in dit prijssegment is ongebruikelijk. Op de ZeroBench-main-evaluatie met tools scoort V4.1 Flash 49,0, wat een ruwe indicatie geeft van hoe het visuele input redeneert.
De KV-cache in V4.1 Flash is ongeveer een kwart van die in de vorige V4 Flash, wat de geheugenkosten voor het vasthouden van lange contexten in een serveersessie verlaagt.
Voor iedereen die always-on inferentie draait, betekent een kleinere KV-cache óf meer gelijktijdige sessies per GPU óf lagere geheugenoverhead per verzoek.
Gecombineerd met cache-hit input geprijsd op $0,006 per 1M tokens op piekuren, maakt dit contexthergebruik extreem goedkoop. Als je herhaaldelijk dezelfde systeemprompt of hetzelfde document meestuurt, kost het gecachete deel bijna niets.
DeepSeek hanteert een tweelaags prijssysteem waarbij buitenpiekprijzen op de helft van de piekprijzen liggen, met de bedoeling batch- en geplande workloads naar buitenpiekvensters te duwen. Dat maakt van $0,30/$1,20 $0,15/$0,60 per 1M tokens als je je jobs kunt timen.
De kanttekening is operationeel. Always-on workloads worden lastiger qua kostvoorspelling, en de korting verzilveren vereist taakplanningslogica die je zelf moet bouwen en onderhouden.
V4.1 Flash scoort het sterkst op agentic- en redeneerbenchmarks, waar het frontier-nabije scores haalt voor een fractie van de tokenkosten.
De scores zakken scherp op de zwaarste agentic-evaluaties, iets om te weten voordat je het richt op langetermijntaken.
V4.1 Flash scoort 90,6 op Terminal-Bench 2.1, dat meet hoe goed een model meerstapstaken in een terminalomgeving voltooit.
Ter vergelijking: DeepSeek-V4-Flash-0731 scoorde 82,7 op dezelfde benchmark in onze tests, en GPT-5.6 Terra haalde 87,4 in onze Terra vs. Sonnet 5-vergelijking.
Het beeld verandert bij zwaardere agentic-evaluaties.
V4.1 Flash zakt naar 30,0 op Terminal-Bench 3.0, dus het model kan standaard terminaltaken goed aan, maar heeft moeite met de veeleisendere agentic-suite. De Codeforces-rating van 3471 duidt op sterke competitive-programmingvaardigheden.
Op GPQA Diamond, een set wetenschappelijke vragen op masterniveau die bewust lastig zijn om uit het hoofd te beantwoorden, scoort V4.1 Flash 90,9.
Dat is sterk voor een model in dit prijssegment en plaatst het in de discussie met veel duurdere frontier-modellen.
Op Humanity's Last Exam (HLE), een bewust meedogenloze expertbenchmark, scoort V4.1 Flash 36,8, of 39,1 met de met-ster-configuratie.
Ter vergelijking: agentic-science-evaluaties zoals Terminal-Bench-Science 0,1 laten Claude Fable 5.1 op 52,6% zien tegen zwaardere rivalen, dus V4.1 Flash staat niet bovenaan de zwaarste expert-evals, maar het stelt ook niet teleur.
V4.1 Flash scoort 65,6 op MathArena Apex, een competitie-wiskundebenchmark die meerstaps symbolisch redeneren beloont.
Dit is een van de sterkere resultaten van het model en suggereert dat het een logische keuze is voor kwantitatieve en wiskunde-intensieve workloads.
Een score halverwege de 60 is relevant voor iedereen die tools bouwt die betrouwbare rekenkundige en algebraïsche redenering nodig hebben, omdat veel goedkopere modellen juist op deze taken instorten.
De keuze gaat hier minder over modelvarianten en meer over hoe je V4.1 Flash uitrolt, aangezien dezelfde gewichten op drie manieren draaien. Je beslissing komt neer op kostvoorspelbaarheid, dataprivacy en of je jobs kunt plannen.
DeepSeek hanteert ook een migratieperiode. Vanaf 12:00 Beijing Time op 14 september 2026, tot aan de toekomstige release van V4.1 Pro, worden verzoeken naar legacy-eindpunten doorgestuurd, wat bestaande gebruikers richting de V4.1-familie duwt. Zit je nog op V4 Pro 0813, dan wordt dat model uitgefaseerd, dus plan nu de overstap naar V4.1 Flash.
| Use case | Aanbevolen pad | Waarom |
|---|---|---|
| Grootvolume, always-on codeagent | Officiële API, piekprijzen | $0,30/$1,20 per 1M ligt al ver onder frontier-rivalen; geen planningsoverhead |
| Grote batch redeneer- of rekentaken | Officiële API, buiten piek | Buiten piek halveert het tarief naar $0,15/$0,60 per 1M als je de run kunt plannen |
| Gevoelige of propriëtaire data | Self-host MIT-gewichten | Houdt inferentie op je eigen hardware; vereist echt GPU-geheugen |
| Veel contexthergebruik | API met promptcaching | Cache-hit input op $0,006 per 1M maakt herhaalde context vrijwel gratis |
V4.1 Flash is een van de goedkoopste capabele modellen, zeker buiten piekuren. Zo zitten de tokenprijzen in elkaar.
| Tarief | Piek | Buiten piek |
|---|---|---|
| Input per 1M tokens | $0,30 | $0,15 |
| Output per 1M tokens | $1,20 | $0,60 |
| Cache-hit input per 1M tokens | $0,006 | Niet gepubliceerd |
Buitenpiekprijzen zijn vastgesteld op de helft van de piekprijzen, en het schema is ontworpen om batch- en geplande workloads naar buitenpiekvensters te duwen.
Om het piektarief in context te plaatsen: GPT-6 Astra en Claude Fable 5.1 rekenen beide $10 per 1M input en $50 per 1M output, dus V4.1 Flash is ongeveer 30x goedkoper op input en 40x goedkoper op output tijdens piekuren.
Het uit te faseren model, V4 Pro 0813, kost $0,435 per 1M input en $0,87 per 1M output met een context van 1M tokens.
Omdat DeepSeek stelt dat V4.1 Flash V4 Pro voorbijstreeft op prestaties, kosten en snelheid, is er weinig reden om bij het oudere model te blijven.
V4.1 Flash is beschikbaar via de officiële DeepSeek API, en de MIT-gelicentieerde gewichten zijn gepubliceerd voor self-hosting.
Vanaf 14 september 2026 worden verzoeken naar legacy-eindpunten doorgestuurd naar de V4.1-familie totdat V4.1 Pro beschikbaar is.
V4.1 Flash is zowel een API-model als een open-weight release, dus je kunt het op twee manieren gebruiken.
Op de API staat het model-ID vaak als deepseek-flash vermeld, en het eindpunt is OpenAI-compatibel, wat betekent dat de meeste bestaande OpenAI-clientcode werkt met alleen een wijziging van de basis-URL.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_DEEPSEEK_KEY",
    base_url="https://api.deepseek.com",
)
response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "Refactor this function..."}],
)
print(response.choices.message.content)
Voor self-hosting staan de MIT-gelicentieerde gewichten commercieel gebruik, herdistributie en fine-tuning zonder omzetdrempels toe.
Toen we de eerdere V4-Flash-0731 lokaal met Unsloth Studio draaiden, had die drie NVIDIA A100 80GB GPU's nodig bij Q8-kwantisatie, dus reserveer vergelijkbare hardware voor de full-precision-setup.
Voor een volledige lokale walkthrough, zie onze tutorial over het draaien van DeepSeek-V4-Flash met Unsloth Studio en OpenCode, die de GPU-distributie en inferentie-setup in detail behandelt.
V4.1 Flash is DeepSeek dat een statement maakt over prijs en openheid, terwijl de rest van de frontier richting $10/$50 per 1M tokens klimt en toegang achter betaalde tiers zet.
Een 552B MoE-model met MIT-gewichten, native afbeeldingsinvoer, 90,9 op GPQA Diamond en piekprijzen die 30x onder GPT-6 Astra liggen, is een serieus aanbod voor grootschalige workloads.
Ik zou ernaar overstappen voor codeagents en batch redeneertaken, vooral als je buiten piekuren kunt plannen.
De minpunten worden duidelijk bij een score van 30,0 op Terminal-Bench 3.0, wat laat zien dat het wankelt op de zwaarste agentic-taken, en piek/buitenpiek-facturatie voegt planningswerk toe dat je zelf moet dragen.
Wil je agent-workflows bouwen rond dit soort modellen, dan is onze AI Agent Fundamentals skill track een goed startpunt.
Topcursussen op DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

