
Last chance! 50% off DataCamp Premium
Sale ends in
Scala is een krachtige taal die functioneel en objectgeoriënteerd programmeren combineert. De taal wordt veel gebruikt voor big data-verwerking en webapps dankzij de beknopte syntaxis, schaalbaarheid en performancevoordelen.
Omdat Scala-expertise steeds meer gevraagd wordt in de datawereld, biedt dit artikel een complete gids met Scala-sollicitatievragen. We behandelen uiteenlopende onderwerpen: van basisconcepten tot geavanceerde technieken en vragen voor data engineering.
Laten we beginnen met een aantal fundamentele Scala-vragen die je begrip van de kernconcepten en voordelen van deze krachtige taal peilen.
Ben je nieuw met de taal? Begin dan met onze cursus Introduction to Scala om een stevige basis op te bouwen voordat je met sollicitatievragen aan de slag gaat.
De naam Scala is afgeleid van het woord scalable. Scala is een statisch getypeerde programmeertaal die objectgeoriënteerde en functionele paradigma’s combineert. De taal is beknopt, expressief en ontworpen om veel van Java’s tekortkomingen aan te pakken. Scala draait op de Java Virtual Machine (JVM), waardoor je Java-bibliotheken en -frameworks naadloos kunt gebruiken.
Waar Java strikt objectgeoriënteerd is, ondersteunt Scala zowel objectgeoriënteerd als functioneel programmeren. Scala biedt ook geavanceerde features zoals onveranderlijkheid (immutability), hogere-orde functies, pattern matching en meer—alles met een beknopte syntaxis.
Kom je uit de Java-wereld? Bekijk dan de cursus Introduction to Java om de basis op te frissen. Wil je OO-principes in Java en Scala vergelijken? Probeer de cursus Introduction to OOP in Java.
Scala heeft krachtige features die de taal laten opvallen en populair maken onder programmeurs. Enkele daarvan:
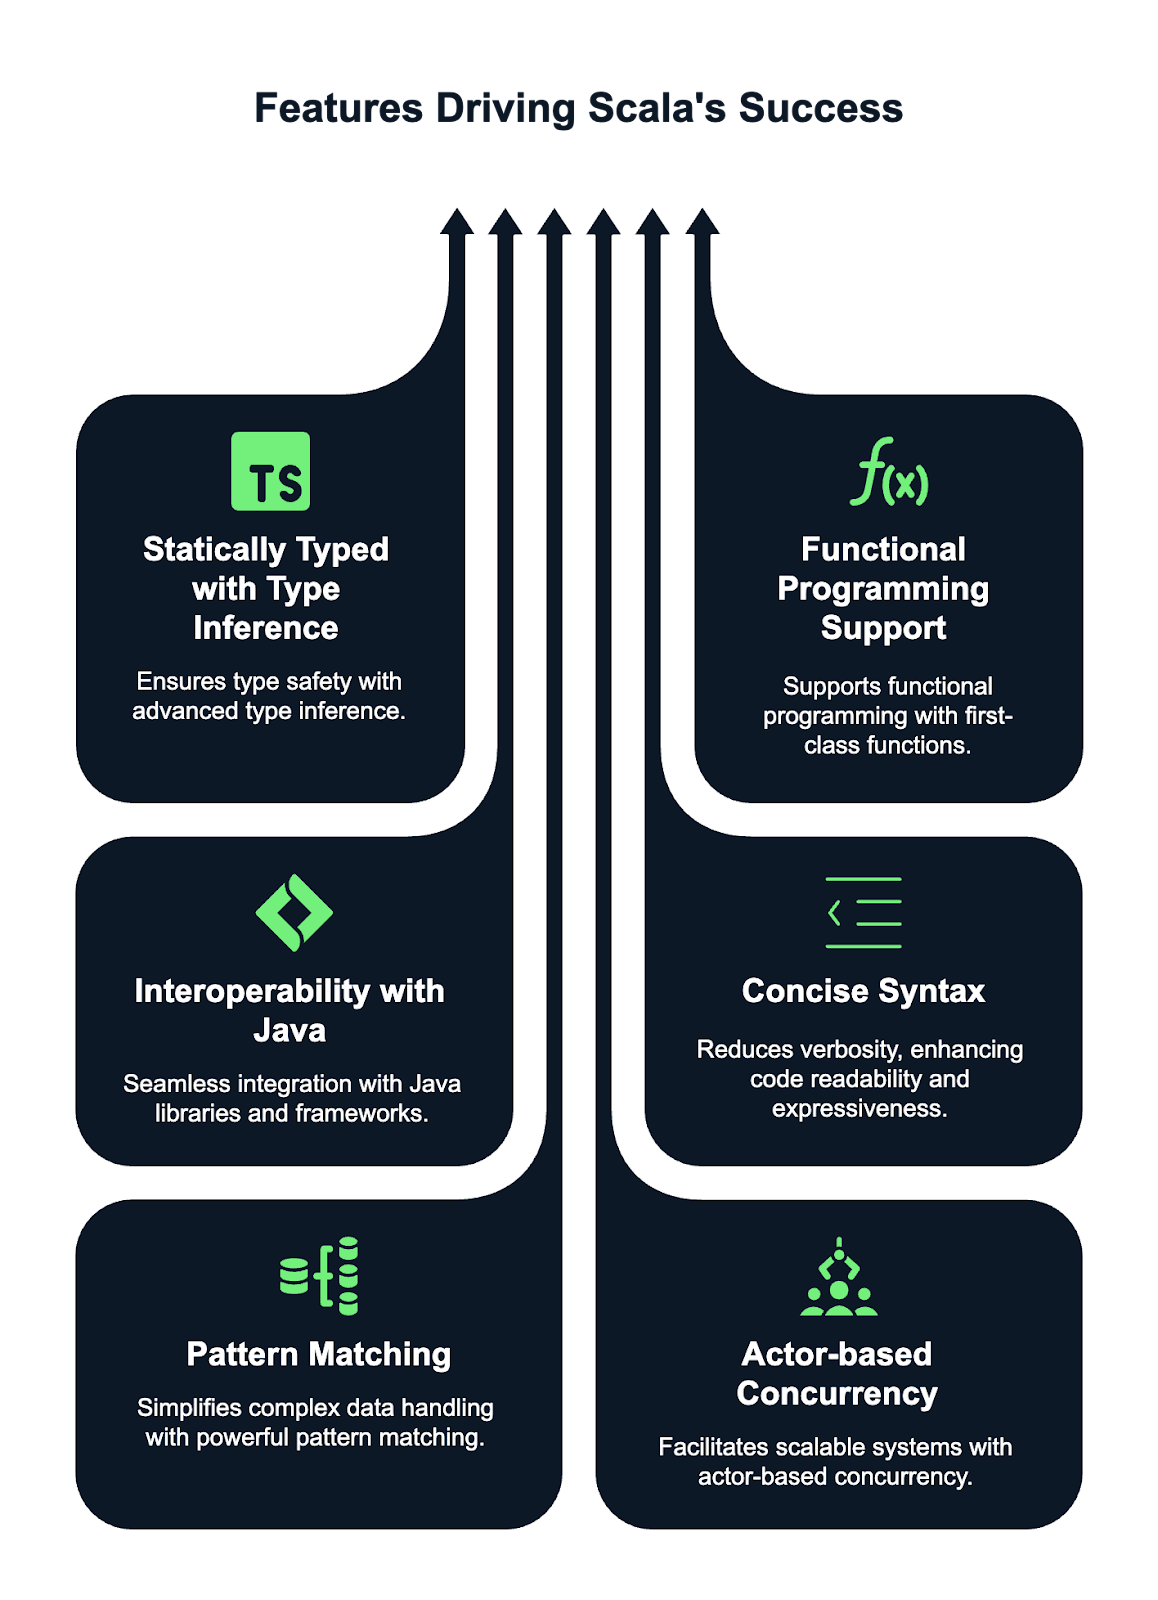
Een case class in Scala is een speciale klasse, geoptimaliseerd voor gebruik met onveranderlijke datastructuren. Er worden automatisch implementaties aangemaakt voor methoden zoals toString, equals en hashCode. Case classes zijn ook geschikt voor pattern matching, wat ze erg handig maakt voor dataverwerking in functionele stijl.
Je gebruikt case classes meestal om dataobjecten te representeren die na creatie niet zouden moeten veranderen. Hieronder een voorbeeld:
case class Person(name: String, age: Int)
val person1 = Person("John", 30)In Scala wordt immutability aangemoedigd, vooral voor functioneel programmeren. Je declareert een onveranderlijke variabele met val in tegenstelling tot var, dat veranderlijk is. Eenmaal toegewezen kan een val niet meer worden aangepast. Immutability zorgt voor veiliger en voorspelbaarder code, met minder kans op onbedoelde neveneffecten. Zie het voorbeeld hieronder:
val name = "Alice"

// Proberen te wijzigen resulteert in een compile-time error
name = "Bob" // Error: reassignment to valEen companion object is een object met dezelfde naam als een klasse en staat in hetzelfde bestand. Het belangrijkste doel is methoden en functies te bieden die nauw bij de klasse horen, maar niet aan een instantie ervan zijn gekoppeld.
Het companion object kan factory-methoden of andere utilityfuncties bevatten, zoals in het voorbeeld hieronder:
class Person(val name: String, val age: Int)
object Person {
  def apply(name: String, age: Int): Person = new Person(name, age)
}
De apply-methode in het Person-companion object laat me een Person maken zonder het sleutelwoord new te gebruiken, zoals hieronder:
val p = Person("John", 25)In Scala gebruik je de keywords var, val en lazy val om variabelen te definiëren. Ze verschillen in mutabiliteit, initialisatie en het moment van evaluatie.
Een var is veranderlijk: de waarde kan worden gewijzigd na initialisatie. Je kunt een var opnieuw toewijzen:
var x = 10
x = 20  // Reassignable
Een val daarentegen is een onveranderlijke referentie: eenmaal toegewezen kun je niet her-toewijzen, maar het object waarnaar verwezen wordt kan nog wel veranderlijk zijn
val y = 10
// y = 20  // Error: reassignment to val
Een lazy val is een speciaal type val dat pas geëvalueerd wordt wanneer het voor het eerst wordt benaderd: dat heet lazy evaluation. Dit kan prestaties verbeteren wanneer de berekening duur of resource-intensief is.
lazy val z = {
  println("Computing z")
  42
}
Wil je dieper in variabeledeclaraties en best practices duiken? Bekijk deze tutorial Variables in Scala.
Een hogere-orde functie is een functie die één of meer functies als parameter accepteert of een functie als resultaat teruggeeft. Hierdoor kun je functies als first-class waarden behandelen, wat meer flexibiliteit en abstractie mogelijk maakt.
Hogere-orde functies maken het mogelijk om gedrag door te geven en aan te passen, wat code modularer, herbruikbaarder en expressiever maakt.
Hieronder een voorbeeld van een hogere-orde functie die een andere functie als argument accepteert:
// Define a higher-order function that takes a function as a parameter
def applyFunction(f: Int => Int, x: Int): Int = f(x)

// Call the higher-order function with a function that multiplies the input by 2
val result = applyFunction(x => x * 2, 5)  // 10
In dit geval is applyFunction een hogere-orde functie die een functie f ontvangt (vermenigvuldigt met 2) en die toepast op 5.
In Scala is String onveranderlijk; aanpassingen creëren nieuwe objecten, wat inefficiënt kan zijn bij herhaaldelijke wijzigingen. Geschikt voor sporadische stringbewerkingen.
Daarentegen is StringBuilder veranderlijk: je kunt ter plekke aanpassen zonder nieuwe objecten te maken. Dit is efficiënter bij frequente stringmanipulaties zoals appenden of wijzigen van inhoud.
Gebruik String wanneer immutability de voorkeur heeft en performance niet kritisch is, en kies StringBuilder als je betere performance nodig hebt bij meerdere stringwijzigingen.
De annotatie @tailrec markeert een methode als tail-recursief, wat betekent dat de recursieve oproep de laatste operatie in de methode is. De Scala-compiler kan de methode dan optimaliseren om stack overflow te voorkomen door de recursie om te zetten naar een lus. Is de methode niet tail-recursief, dan geeft de compiler een foutmelding.
Een voorbeeld:
@tailrec
def factorial(n: Int, accumulator: Int = 1): Int = {
  if (n <= 0) accumulator
  else factorial(n - 1, n * accumulator)
}Nu we de basis hebben gehad, gaan we door met vragen op gemiddeld niveau die je helpen beter te begrijpen hoe de taal werkt.
In Scala zijn map, flatMap en foreach higher-order functies voor collecties, elk met een ander doel.
map transformeert elk element en retourneert een nieuwe collectie van dezelfde grootte met de getransformeerde elementen. flatMap transformeert ook elk element, maar vlakt de resulterende structuur af. Handig wanneer de transformatie zelf collecties oplevert. foreach wordt gebruikt voor side-effects; het past een functie toe op elk element zonder iets te retourneren, bijvoorbeeld om te printen of externe state bij te werken.Pattern matching in Scala is een krachtige feature waarmee je waarden tegen patronen kunt matchen, wat code expressiever en compacter maakt. Het lijkt op switch- of case-statements in andere talen, maar is flexibeler en werkt met allerlei types zoals integers, strings, lists en zelfs complexe datastructuren. Je gebruikt het met match-expressies die de waarde van een expressie tegen meerdere patronen vergelijken.
Enkele use-cases voor pattern matching:
Some of None in Option voor een compacte aanpak van ontbrekende waarden.Hier een voorbeeld:
// Define a variable x with value 3
val x = 3

// Pattern matching on the value of x
x match {
  // If 'x' is equal to 1, print "One"
  case 1 => println("One")
    // If 'x' is equal to 2, print "Two"
  case 2 => println("Two")
  // If 'x' doesn't match any of the above cases, print "Other"
  case _ => println("Other")
}In Scala is Option een containertype dat een waarde representeert die wel of niet kan bestaan, en helpt zo null-waarden en null pointer exceptions te vermijden. Het heeft twee subtypes: Some en None.
Some wikkelt een geldige waarde in en geeft de aanwezigheid van een waarde aan, terwijl None de afwezigheid van een waarde aangeeft. Hierdoor kun je expliciet omgaan met ontbrekende waarden—veiliger en functioneler.
Option wordt vaak gebruikt in methoden die mogelijk geen resultaat opleveren, waardoor foutgevoelige null-checks overbodig worden.
Bekijk de code hieronder:
// Function that returns an Option
def findFirstEvenNumber(list: List[Int]): Option[Int] = {
  list.find(_ % 2 == 0)  // Returns Some(number) if an even number is found, otherwise None
}

// Example usage:
val numbers = List(1, 3, 5, 7, 8)
val result = findFirstEvenNumber(numbers)
result match {
  case Some(number) => println(s"Found an even number: $number")  // Output: Found an even number: 8
  case None => println("No even number found")
}Scala biedt een rijke set aan collecties, onderverdeeld in veranderlijke (mutable) en onveranderlijke (immutable) typen.
List, Set, Map en Vector kun je na creatie niet wijzigen, wat de functionele stijl bevordert.ArrayBuffer, HashSet en HashMap kun je wel aanpassen. Collecties zijn zeer flexibel met ondersteuning voor bewerkingen zoals filteren, mappen en folden. De standaardbibliotheek bevat ook gespecialiseerde collecties als Queue, Stack en SortedSet voor efficiënte datamanipulatie. Onveranderlijke collecties hebben de voorkeur voor thread-safety en functionele zuiverheid.
Impliciete parameters zijn waarden die de compiler automatisch doorgeeft aan een methode of constructor, zonder dat je ze expliciet specificeert. Ze zijn gemarkeerd met het keyword implicit en worden vaak gebruikt voor dependency injection, configuratie of contextdoorvoer.
// Define a function that takes an implicit parameter 'name' of type String
def greet(implicit name: String) = s"Hello, $name"

// Define an implicit value 'myName' of type String in the scope
implicit val myName = "Alice"

// Call the greet function without explicitly passing 'name'
// The compiler automatically uses the implicit value 'myName'
println(greet) // Output: "Hello, Alice"In Scala lijken traits op interfaces in Java, maar ze kunnen meer. Een trait is een herbruikbare component die je kunt mixen in classes of andere traits. Je kunt er zowel abstracte als concrete methoden in definiëren. Traits kunnen ook state bijhouden, in tegenstelling tot Java-interfaces die alleen methodesignatures definiëren.
Scala ondersteunt het mixen van meerdere traits in één klasse (meervoudige overerving), terwijl Java meerdere interfaces toestaat maar slechts één klasse kan erven, wat de flexibiliteit beperkt.
Een voorbeeld:
trait Logger {
  def log(message: String): Unit = println(s"Log: $message")
}De Scala REPL is een interactieve shell waarin je Scala-code direct kunt schrijven en evalueren. Het werkt in vier stappen:
Dit maakt snel experimenteren en testen mogelijk—een krachtig hulpmiddel om te leren, debuggen en prototypen. Je kunt variabelen en functies definiëren en libraries interactief verkennen.
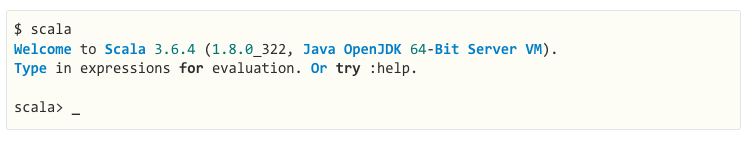
Figuur: de Scala REPL is een commandline-interpreter die je als speelveld kunt gebruiken om Scala-code te testen. Bron: Scala docs
Voor wie een senior rol zoekt of zijn diepgaande kennis van Scala wil tonen: laten we geavanceerde vragen verkennen over asynchrone berekeningen en concurrency, én over complexe structuren en conversies.
Deze vragen toetsen je expertise in functioneel programmeren, concurrency en schaalbaar systeemontwerp.
In Scala hebben Future en Await beide betrekking op asynchrone berekeningen, maar met verschillende doelen.
Future representeert een berekening die uiteindelijk voltooid wordt met een resultaat of een exceptie. Andere taken kunnen doorgaan terwijl je op het resultaat wacht. Await blokkeert de huidige thread totdat het resultaat van een Future beschikbaar is. Dit dwingt een thread te wachten op voltooiing van de Future, nuttig wanneer je in een niet-asynchrone context moet synchroniseren.Hier enkele voorbeelden van het gebruik:
import scala.concurrent.Future
import scala.concurrent.ExecutionContext.Implicits.global
import scala.concurrent.Await
import scala.concurrent.duration._

val futureValue = Future { 42 } // A Future that computes the value 42 asynchronously.
val result = Await.result(futureValue, 2.seconds) // Blocks the thread for up to 2 seconds, waiting for the result of the Future.Scala ondersteunt concurrency met zowel low-level mechanismen zoals threads als high-level abstracties zoals Futures en Promises voor asynchroon programmeren.
De standaardbibliotheek bevat scala.concurrent.Future voor niet-blokkerende berekeningen en ExecutionContext voor threadbeheer.
Voor geavanceerdere concurrency wordt Akka veel gebruikt. Het biedt tools om zeer gelijktijdige, gedistribueerde systemen te bouwen met het Actor-model. Daarnaast bieden Cats Effect en ZIO functionele benaderingen met veilige, composeerbare abstracties voor side-effects, asynchrone taken en resourcebeheer.
Monads zijn een ontwerppatroon om berekeningen gestructureerd af te handelen, vooral bij side-effects zoals asynchrone operaties of ontbrekende waarden. Een monad wikkelt een waarde in en laat transformaties toe terwijl de structuur behouden blijft. In Scala zijn Option en Future voorbeelden van monads.
val result = Some(5).flatMap(x => Some(x * 2))Het Akka-framework in Scala vereenvoudigt de bouw van gedistribueerde, gelijktijdige en fouttolerante systemen. Het gebruikt het Actor model, waarbij elke actor een lichtgewicht, onafhankelijke eenheid is die asynchroon communiceert via berichten.
Akka abstraheert low-level details van concurrency, zodat je je kunt richten op de businesslogica. Het ondersteunt gedistribueerde systemen door actors op verschillende nodes te laten draaien. Met de Cluster-module faciliteert Akka naadloze communicatie, loadbalancing en veerkracht—ideaal voor schaalbare, hoog-beschikbare systemen.
Impliciete conversies maken automatische transformatie van het ene type naar het andere mogelijk. Ze worden gedefinieerd met het keyword implicit en maken operaties tussen normaal niet-compatibele types mogelijk. De compiler past impliciete conversies toe wanneer nodig, waardoor boilerplate vermindert.
Hiermee kun je bijvoorbeeld een String automatisch naar een Int converteren bij rekenkundige operaties:
implicit def intToString(x: Int): String = x.toString
val str: String = 42 // Implicitly converted to “42”Type-variantie beschrijft hoe subtypes van een generiek type zich tot elkaar verhouden. Dit wordt gestuurd via covariantie (+), contravariantie (-) en invariantie (=).
List[+A] betekent dat een List van type A gebruikt kan worden waar een List van een supertype van A verwacht wordt. Voorbeeld: List[Dog] kan worden gebruikt als List[Animal] als Dog Animal uitbreidt.Function1[-A, +B] accepteert een supertype van A en retourneert een subtype van B. Voorbeeld: Function1[Animal, Dog] kan worden gebruikt als Function1[Dog, Dog].List[A] is invariant: List[Dog] en List[Animal] zijn niet uitwisselbaar.Solliciteer je op een data engineering-rol? Reken dan op vragen die je vermogen toetsen om Scala-applicaties in productie te ontwerpen, optimaliseren en troubleshooten. Laten we enkele typische vragen doornemen.
Om een custom annotatie te definiëren, maak je een klasse die scala.annotation.Annotation uitbreidt. Deze klasse kan constructorparameters hebben om metadata op te slaan. Je past annotaties toe op classes, methoden of velden met het @-symbool.
Een handige eigenschap is dat custom annotaties runtime toegankelijk zijn via reflectie om hun metadata op te halen, meestal met getAnnotations of vergelijkbare methoden.
import scala.annotation.StaticAnnotation
class MyAnnotation extends StaticAnnotation
@MyAnnotation class MyClassScala is de native taal voor Apache Spark en biedt naadloze integratie en hoge performance.
Je gebruikt het om gedistribueerde dataverwerkingsjobs te schrijven met Sparks kernfeatures zoals RDD’s (Resilient Distributed Datasets), DataFrames en Datasets. Met Scala kun je grote datasets maken en manipuleren, transformaties toepassen en complexe operaties efficiënt uitvoeren over een cluster.
De Scala-API van Spark biedt een beknopte, expressieve syntaxis voor big data-taken—van batchverwerking tot machine learning-pijplijnen—zodat je grootschalige data-analyse en -verwerking parallel kunt uitvoeren.
Wil je PySpark vanaf nul leren—deze complete gids voor PySpark is een prima startpunt.
In Spark zijn RDD’s (Resilient Distributed Datasets) de low-level abstractie: gedistribueerde data waar je parallel bewerkingen op uitvoert. DataFrames zijn high-level abstracties bovenop RDD’s voor gestructureerde data met geoptimaliseerde uitvoering via Sparks Catalyst-optimizer.
Datasets combineren het beste van RDD’s en DataFrames: de typeveiligheid van RDD’s met de optimalisaties van DataFrames. Datasets zijn sterk getypeerd; DataFrames zijn ongetypeerd, wat efficiëntere transformaties en acties mogelijk maakt.
Een basis Spark-job in Scala omvat het volgende:
SparkSession initialiseren.Hier een voorbeeld:
// Import the SparkSession class which is the entry point for Spark SQL
import org.apache.spark.sql.SparkSession

// Create a SparkSession.
val spark = SparkSession.builder.appName("MySparkApp").getOrCreate()

// Read the input text file as a DataFrame.
val data = spark.read.text("data.txt")

// Perform the transformation on the text file
val wordCount = textFile.flatMap(_.split(" ")).groupByKey(identity).count()
wordCount.show()Transformaties in Spark definiëren een nieuwe RDD, DataFrame of Dataset, zoals map(), filter() of groupBy(). Ze worden lui geëvalueerd (lazy), wat betekent dat ze pas uitgevoerd worden wanneer er een actie wordt getriggerd.
Acties starten de uitvoering, zoals collect(), count() of save(). Transformaties worden lui toegepast; acties zorgen ervoor dat Spark de DAG van operaties uitvoert, waarna een resultaat wordt geretourneerd of data wordt weggeschreven.
Lazy evaluation in Spark betekent dat transformaties niet direct worden uitgevoerd. In plaats daarvan bouwt Spark een uitvoeringsplan (DAG) en voert de berekeningen pas uit wanneer een actie wordt aangeroepen. Zo kan Spark de uitvoering optimaliseren door datashuffling te minimaliseren, operaties te combineren en filters eerder toe te passen in de pipeline.
Optimaliseren van Spark-jobs omvat strategieën zoals datashuffling minimaliseren, tussentijdse resultaten cachen en geschikte partitionering gebruiken.
Enkele strategieën die ik aanbeveel:
groupBy).Veelvoorkomende uitdagingen zijn geheugen- en performancebeheer voor grote datasets, omgaan met data skew en efficiënt omgaan met fouten in gedistribueerde omgevingen.
Spark-jobs debuggen kan lastig zijn door de complexiteit van gedistribueerde systemen en lazy evaluation. Daarnaast vereist het optimaliseren van jobs vaak fijnmazige configuratie en begrip van het onderliggende uitvoeringsplan om bottlenecks te vermijden en overhead te verminderen.
Ook inconsistentie in dataformaten, datakwaliteitsproblemen en de complexiteit van schaalbare code schrijven en onderhouden zijn uitdagend in big data-scenario’s.
In dit artikel hebben we een breed scala aan Scala-sollicitatievragen behandeld: van basis en gemiddeld tot geavanceerd. We bespraken de kernconcepten en voordelen van Scala en doken in complexere optimalisaties, afhandeling en conversies—de belangrijkste thema’s waar potentiële werkgevers naar kunnen vragen.
Wil je je voorbereiding versterken? Oefen dan met onze cursus Introduction to Scala of haal je kennis snel op! Bereid je je voor op een gecombineerde Java-Scala-rol? Mis dan ook onze gids met Java-sollicitatievragen niet voor een compleet perspectief.
Leer meer over Scala en data engineering met deze cursussen!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min


