
कोर्स
Introduction to Scala
3 घंटा
27.1K
Scala एक शक्तिशाली भाषा है जो फंक्शनल और ऑब्जेक्ट-ओरिएंटेड प्रोग्रामिंग को मिलाती है। इसकी संक्षिप्त सिंटैक्स, स्केलेबिलिटी, और प्रदर्शन लाभों के कारण यह बिग डेटा प्रोसेसिंग और वेब ऐप्स में व्यापक रूप से उपयोग की जाती है।
जैसे-जैसे डेटा इंडस्ट्री में Scala विशेषज्ञता की मांग बढ़ रही है, यह लेख Scala इंटरव्यू प्रश्नों पर एक व्यापक मार्गदर्शिका प्रदान करेगा, जिसमें बुनियादी अवधारणाओं से लेकर उन्नत तकनीकों और डेटा इंजीनियरिंग प्रश्नों तक विभिन्न विषय शामिल हैं।
आइए कुछ बुनियादी Scala इंटरव्यू प्रश्नों से शुरू करें जो इस शक्तिशाली भाषा की मुख्य अवधारणाओं और फायदों की आपकी समझ का आकलन करते हैं।
यदि आप भाषा में नए हैं, तो इंट्रो Introduction to Scala कोर्स से शुरुआत करें ताकि इंटरव्यू प्रश्नों से पहले एक मजबूत नींव बन सके।
Scala नाम scalable शब्द से आया है। Scala एक स्टैटिकली टाइप्ड प्रोग्रामिंग भाषा है जो ऑब्जेक्ट-ओरिएंटेड और फंक्शनल प्रोग्रामिंग पैराडाइम्स को जोड़ती है। यह संक्षिप्त, अभिव्यंजक है और Java की कई कमियों को दूर करने के लिए डिज़ाइन की गई है। उदाहरण के लिए, Scala Java वर्चुअल मशीन (JVM) पर चलता है, जिसका मतलब है कि आप Java लाइब्रेरीज़ और फ्रेमवर्क्स को आसानी से उपयोग कर सकते हैं।
जहाँ Java सख्ती से ऑब्जेक्ट-ओरिएंटेड है, वहीं Scala ऑब्जेक्ट-ओरिएंटेड और फंक्शनल दोनों प्रोग्रामिंग की अनुमति देता है। Scala इम्यूटेबिलिटी, हाईअर-ऑर्डर फंक्शंस, पैटर्न मैचिंग जैसी उन्नत सुविधाएँ भी प्रदान करता है, वह भी संक्षिप्त सिंटैक्स के साथ।
यदि आप Java पृष्ठभूमि से आते हैं, तो फिर Introduction to Java कोर्स देखें ताकि बुनियाद दोहराई जा सके। Java और Scala में ऑब्जेक्ट-ओरिएंटेड सिद्धांतों की तुलना करने के लिए, Introduction to OOP in Java कोर्स आज़माएँ।
Scala में कुछ शक्तिशाली विशेषताएँ हैं जो इसे अलग और प्रोग्रामर के बीच लोकप्रिय बनाती हैं। इनमें से कुछ इस प्रकार हैं:
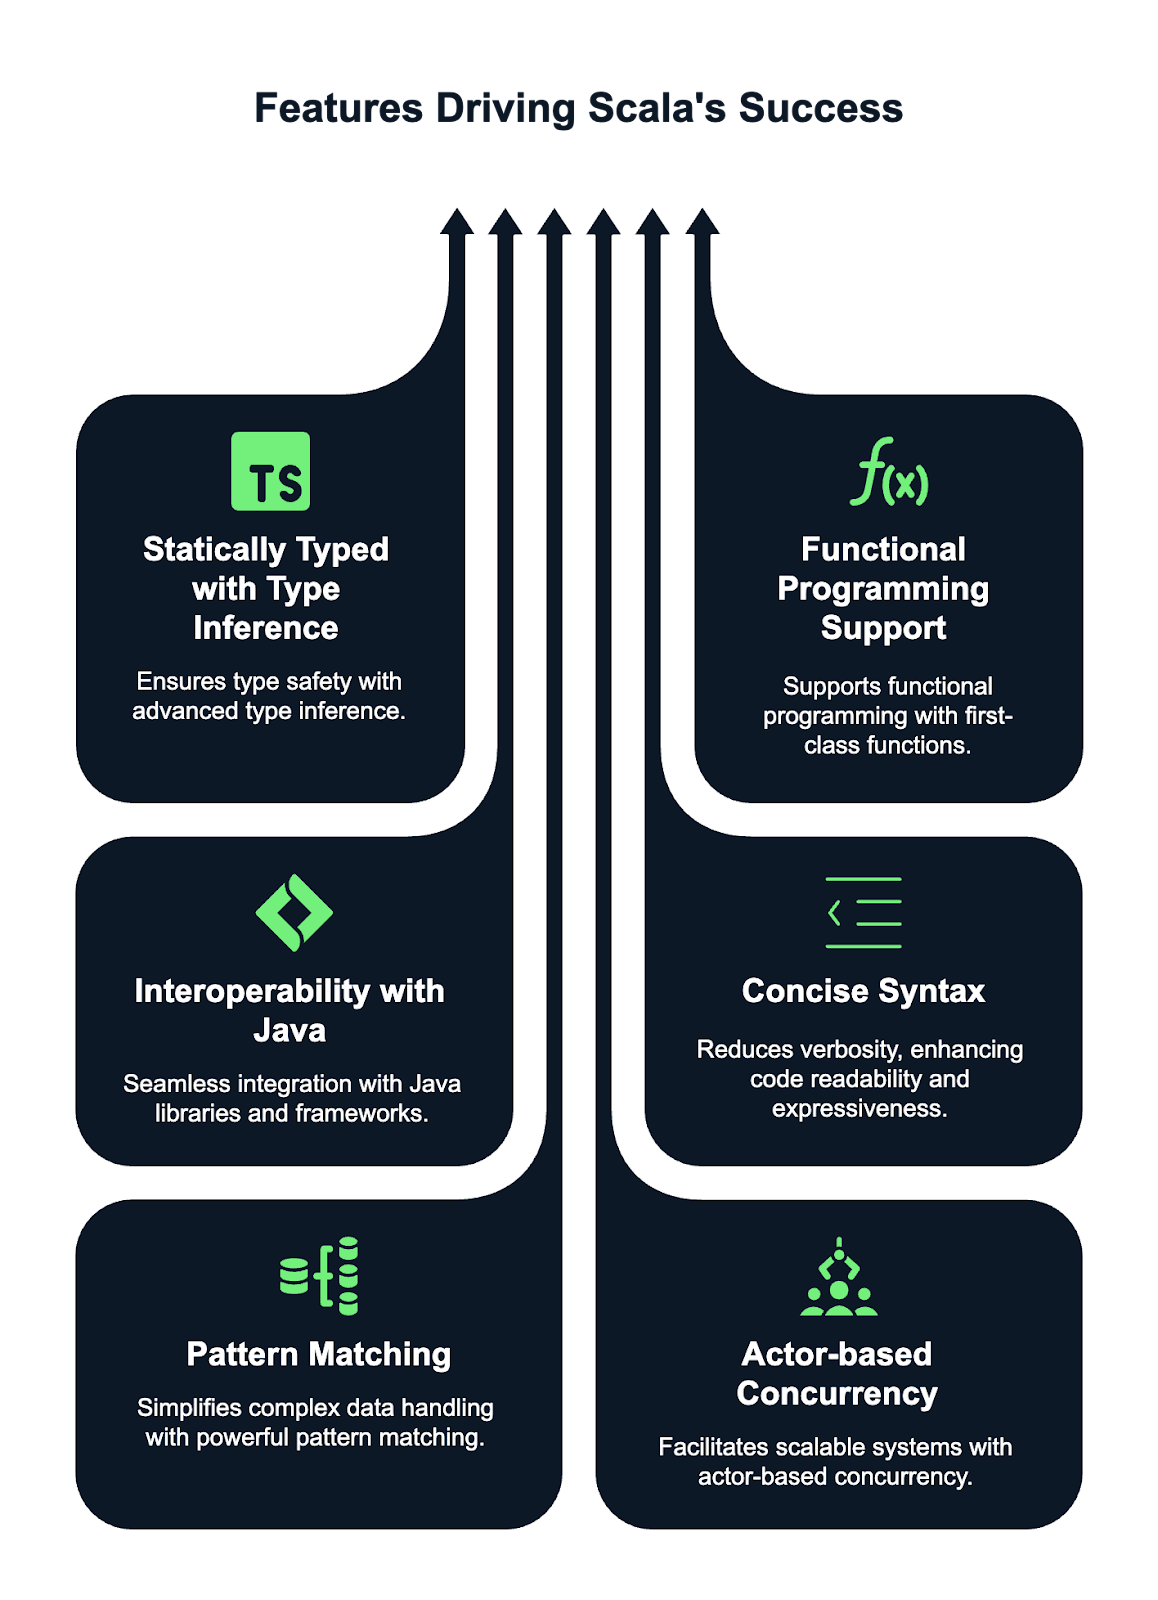
Scala में case class एक विशेष क्लास है जिसे इम्यूटेबल डेटा स्ट्रक्चर्स के साथ उपयोग के लिए ऑप्टिमाइज़ किया गया है। यह स्वतः ही toString, equals, और hashCode जैसे मेथड्स के इम्प्लीमेंटेशन प्रदान करता है। Case classes पैटर्न-मैचेबल भी होती हैं, जिससे वे फंक्शनल स्टाइल में डेटा संभालने के लिए बेहद उपयोगी बनती हैं।
आमतौर पर case classes का उपयोग ऐसे डेटा ऑब्जेक्ट्स को दर्शाने के लिए किया जाता है जिन्हें बनने के बाद बदलना नहीं चाहिए। नीचे एक उदाहरण दिया है:
case class Person(name: String, age: Int)
val person1 = Person("John", 30)
Scala में, खासकर फंक्शनल प्रोग्रामिंग के लिए, इम्यूटेबिलिटी को प्रोत्साहित किया जाता है। आप var (जो म्यूटेबल होता है) के बजाय val के साथ एक इम्यूटेबल वैरिएबल डिक्लेयर कर सकते हैं। एक बार जब आप किसी val को वैल्यू असाइन कर देते हैं, तो उसे बदला नहीं जा सकता। इम्यूटेबिलिटी सुरक्षित और अधिक पूर्वानुमेय कोड की ओर ले जाती है, क्योंकि अनचाहे साइड इफेक्ट्स की संभावना कम हो जाती है। नीचे उदाहरण देखें:
val name = "Alice"

// इसे बदलने की कोशिश करने पर कंपाइल-टाइम एरर होगा
name = "Bob" // Error: reassignment to valCompanion object वह ऑब्जेक्ट होता है जिसका नाम किसी क्लास के समान होता है और जिसे उसी फ़ाइल में परिभाषित किया जाता है। Companion object का मुख्य उद्देश्य ऐसे मेथड्स और फंक्शंस प्रदान करना है जो क्लास से घनिष्ठ रूप से संबंधित हों लेकिन उसके किसी इंस्टेंस से बंधे न हों।
Companion object में फ़ैक्टरी मेथड्स या अन्य यूटिलिटी फंक्शंस हो सकते हैं, जैसे कि मैंने नीचे दिए उदाहरण में लिखा है:
class Person(val name: String, val age: Int)
object Person {
  def apply(name: String, age: Int): Person = new Person(name, age)
}
Person के companion object में मौजूद apply मेथड मुझे बिना new कीवर्ड का उपयोग किए Person बनाने देता है, जैसा कि नीचे दिखाया है:
val p = Person("John", 25)Scala में var, val, और lazy val कीवर्ड्स का उपयोग वैरिएबल्स को परिभाषित करने के लिए किया जाता है, लेकिन वे म्यूटेबिलिटी, इनिशियलाइज़ेशन और इवैल्युएशन टाइमिंग के मामले में अलग होते हैं।
var एक म्यूटेबल वैरिएबल है, यानी इनिशियलाइज़ होने के बाद इसकी वैल्यू बदली जा सकती है। आप किसी var को नई वैल्यू रीअसाइन कर सकते हैं:
var x = 10
x = 20  // Reassignable
दूसरी ओर, val एक इम्यूटेबल रेफरेंस है, यानी एक बार वैल्यू असाइन हो जाने पर इसे रीअसाइन नहीं किया जा सकता, लेकिन जिस ऑब्जेक्ट को यह संदर्भित करता है, वह फिर भी म्यूटेबल हो सकता है
val y = 10
// y = 20  // Error: reassignment to val
lazy val एक विशेष प्रकार का val है जिसे पहली बार एक्सेस किए जाने तक इवैल्युएट नहीं किया जाता, जिसे lazy evaluation कहा जाता है। यह महँगे या संसाधन-गहन कंप्यूटेशंस के साथ काम करते समय प्रदर्शन अनुकूलन के लिए सहायक हो सकता है।
lazy val z = {
  println("Computing z")
  42
}
Scala में वैरिएबल घोषणाओं और सर्वोत्तम प्रथाओं पर गहरी नज़र के लिए, इस Variables in Scala ट्यूटोरियल को देखें।
Scala में higher-order function वह फ़ंक्शन है जो या तो एक या अधिक फंक्शंस को पैरामीटर के रूप में लेता है या एक फ़ंक्शन को परिणाम के रूप में रिटर्न करता है। यह अवधारणा फंक्शंस को फर्स्ट-क्लास वैल्यूज़ की तरह ट्रीट करने देती है, जिससे आपके कोड में अधिक लचीलापन और एब्स्ट्रैक्शन संभव होता है।
हाईअर-ऑर्डर फंक्शंस व्यवहारों को पास और कस्टमाइज़ करने में सक्षम बनाते हैं, जिससे कोड अधिक मॉड्यूलर, पुन: प्रयोज्य और अभिव्यंजक बनता है।
नीचे, मैंने एक उदाहरण दिया है जिसमें एक higher-order function दूसरे फ़ंक्शन को आर्गुमेंट के रूप में स्वीकार करता है:
// एक higher-order function परिभाषित करें जो एक फ़ंक्शन को पैरामीटर के रूप में लेता है
def applyFunction(f: Int => Int, x: Int): Int = f(x)

// higher-order function को ऐसे फ़ंक्शन के साथ कॉल करें जो इनपुट को 2 से गुणा करता है
val result = applyFunction(x => x * 2, 5)  // 10
इस मामले में, applyFunction एक higher-order function है जो फ़ंक्शन f लेता है, जो 2 से गुणा करता है, और उसे 5 पर लागू करता है।
Scala में String इम्यूटेबल है, यानी संशोधन नए ऑब्जेक्ट्स बनाते हैं, जो बार-बार बदलाव के लिए अल्प-प्रभावी हो सकते हैं। यह कम आवृत्ति वाले स्ट्रिंग ऑपरेशन्स के लिए उपयुक्त है।
इसके विपरीत, StringBuilder म्यूटेबल है, जो बिना नए ऑब्जेक्ट्स बनाए इन-प्लेस संशोधन की अनुमति देता है। इससे जोड़ने या सामग्री संशोधित करने जैसी बार-बार की जाने वाली स्ट्रिंग maniपुलेशन के लिए यह अधिक कुशल बनता है।
मैं String का उपयोग तब सुझाता/सुझाती हूँ जब इम्यूटेबिलिटी वांछनीय हो और प्रदर्शन महत्वपूर्ण न हो, और कई स्ट्रिंग संशोधनों वाले परिदृश्यों में बेहतर प्रदर्शन की आवश्यकता होने पर StringBuilder चुनने की सलाह देता/देती हूँ।
@tailrec एनोटेशन का उपयोग किसी मेथड को टेल-रिकर्सिव के रूप में चिह्नित करने के लिए किया जाता है, यानी मेथड में आखिरी ऑपरेशन रिकर्सिव कॉल हो। इससे Scala कंपाइलर मेथड को इस तरह ऑप्टिमाइज़ कर सकता है कि स्टैक ओवरफ्लो एरर्स से बचा जा सके, क्योंकि वह रिकर्शन को लूप में बदल देता है। यदि मेथड टेल-रिकर्सिव नहीं है, तो कंपाइलर एरर देगा।
आइए एक उदाहरण देखें:
@tailrec
def factorial(n: Int, accumulator: Int = 1): Int = {
  if (n <= 0) accumulator
  else factorial(n - 1, n * accumulator)
}बुनियाद कवर करने के बाद, अब कुछ इंटरमीडिएट-लेवल Scala इंटरव्यू प्रश्नों पर चलते हैं जो आपको भाषा के काम करने के तरीके को और बेहतर समझने में मदद करेंगे।
Scala में map, flatMap, और foreach कलेक्शंस पर इस्तेमाल होने वाले higher-order functions हैं, लेकिन उनके उद्देश्य अलग हैं।
map किसी कलेक्शन के प्रत्येक एलिमेंट को ट्रांसफॉर्म करता है और ट्रांसफ़ॉर्म किए गए एलिमेंट्स के साथ समान आकार का नया कलेक्शन लौटाता है। flatMap भी प्रत्येक एलिमेंट को ट्रांसफॉर्म करता है लेकिन प्राप्त संरचना को फ्लैटन कर देता है, जो तब उपयोगी होता है जब ट्रांसफॉर्मेशन स्वयं कलेक्शंस देता है। foreach साइड-इफेक्ट्स के लिए उपयोग किया जाता है—यह प्रत्येक एलिमेंट पर एक फ़ंक्शन लागू करता है लेकिन कुछ रिटर्न नहीं करता; आम तौर पर प्रिंटिंग या बाहरी स्टेट अपडेट करने के लिए प्रयोग होता है।Scala में पैटर्न मैचिंग एक शक्तिशाली सुविधा है जो आपको वैल्यूज़ को पैटर्न्स के खिलाफ मैच करने देती है, जिससे कोड अधिक अभिव्यंजक और संक्षिप्त बनता है। यह अन्य भाषाओं के switch या case स्टेटमेंट्स के समान है, लेकिन अधिक लचीला है और इंटीजर, स्ट्रिंग, लिस्ट्स और यहाँ तक कि जटिल डेटा स्ट्रक्चर्स जैसे विभिन्न प्रकारों के साथ उपयोग किया जा सकता है। इसे match एक्सप्रेशंस के साथ उपयोग किया जा सकता है, जो किसी अभिव्यक्ति के मान की कई पैटर्न्स के साथ तुलना करते हैं।
पैटर्न मैचिंग के कुछ उपयोग मामले:
Option में Some या None वैल्यूज़ की जाँच करना, जिससे नल योग्य वैल्यूज़ को संक्षिप्त रूप से संभाला जा सके।यहाँ एक उदाहरण दिया है:
// वैरिएबल x को मान 3 के साथ परिभाषित करें
val x = 3

// x के मान पर पैटर्न मैचिंग
x match {
  // यदि 'x' 1 के बराबर है, तो "One" प्रिंट करें
  case 1 => println("One")
    // यदि 'x' 2 के बराबर है, तो "Two" प्रिंट करें
  case 2 => println("Two")
  // यदि 'x' ऊपर के किसी भी केस से मेल नहीं खाता, तो "Other" प्रिंट करें
  case _ => println("Other")
}
Scala में Option एक कंटेनर टाइप है जिसका उपयोग किसी ऐसी वैल्यू को दर्शाने के लिए किया जाता है जो मौजूद भी हो सकती है और नहीं भी, जिससे null वैल्यूज़ और null pointer exceptions से बचने में मदद मिलती है। इसके दो सबटाइप्स हैं: Some और None।
Some किसी वैध वैल्यू को रैप करता है, यानी वैल्यू मौजूद है; जबकि None वैल्यू के अभाव को दर्शाता है। इससे डेवलपर्स उन मामलों को स्पष्ट रूप से हैंडल कर सकते हैं जहाँ वैल्यू गायब हो सकती है, और अधिक सुरक्षित तथा फंक्शनल कोड को बढ़ावा मिलता है।
Option का उपयोग अक्सर ऐसे मेथड्स में होता है जो परिणाम लौटाने में विफल हो सकते हैं, जिससे त्रुटि-प्रवण null जाँचों की आवश्यकता कम होती है।
नीचे दिया कोड देखें:
// एक फ़ंक्शन जो Option लौटाता है
def findFirstEvenNumber(list: List[Int]): Option[Int] = {
  list.find(_ % 2 == 0)  // यदि कोई सम संख्या मिलती है तो Some(number) लौटाता है, अन्यथा None
}

// उदाहरण उपयोग:
val numbers = List(1, 3, 5, 7, 8)
val result = findFirstEvenNumber(numbers)
result match {
  case Some(number) => println(s"Found an even number: $number")  // Output: Found an even number: 8
  case None => println("No even number found")
}
Scala समृद्ध कलेक्शन सेट प्रदान करता है, जिन्हें म्यूटेबल और इम्यूटेबल प्रकारों में श्रेणीबद्ध किया गया है।
List, Set, Map, और Vector, बनने के बाद बदले नहीं जा सकते, जिससे फंक्शनल प्रोग्रामिंग प्रथाएँ बढ़ती हैं।ArrayBuffer, HashSet, और HashMap, संशोधनों की अनुमति देते हैं। कलेक्शंस अत्यंत लचीले हैं और फ़िल्टरिंग, मैपिंग और फोल्डिंग जैसी विभिन्न ऑपरेशन्स का समर्थन करते हैं। स्टैंडर्ड लाइब्रेरी Queue, Stack, और SortedSet जैसी विशेष कलेक्शंस भी प्रदान करती है, जो विभिन्न डेटा maniपुलेशन आवश्यकताओं को कुशलतापूर्वक पूरा करती हैं। थ्रेड सेफ्टी और फंक्शनल पवित्रता के लिए इम्यूटेबल कलेक्शंस को प्राथमिकता दी जाती है।
Scala में implicit parameters वे वैल्यूज़ हैं जिन्हें कंपाइलर किसी मेथड या कन्स्ट्रक्टर को बिना स्पष्ट रूप से बताए स्वतः पास कर देता है। उन्हें implicit कीवर्ड से चिह्नित किया जाता है और आमतौर पर डिपेंडेंसी इंजेक्शन, कॉन्फ़िगरेशन या कॉन्टेक्स्ट पासिंग जैसी चीज़ों के लिए उपयोग किया जाता है।
// एक फ़ंक्शन परिभाषित करें जो String प्रकार के implicit पैरामीटर 'name' को लेता है
def greet(implicit name: String) = s"Hello, $name"

// स्कोप में String प्रकार का एक implicit मान 'myName' परिभाषित करें
implicit val myName = "Alice"

// greet फ़ंक्शन को बिना 'name' को स्पष्ट रूप से पास किए कॉल करें
// कंपाइलर स्वतः implicit मान 'myName' का उपयोग करेगा
println(greet)  // Output: "Hello, Alice"
Scala में traits Java के interfaces के समान होते हैं लेकिन अतिरिक्त क्षमताओं के साथ। Trait एक पुन: प्रयोज्य कंपोनेंट है जिसे क्लासेस या अन्य traits में मिक्स किया जा सकता है। यह आपको एब्स्ट्रैक्ट और कंक्रीट दोनों मेथड्स परिभाषित करने देता है। Traits स्टेट भी बनाए रख सकते हैं, जबकि Java interfaces केवल मेथड सिग्नेचर्स परिभाषित कर सकते हैं।
Scala एक ही क्लास में कई traits मिक्स करने का समर्थन करता है, जिससे मल्टीपल इनहेरिटेंस संभव होता है; जबकि Java में कई interfaces इम्प्लीमेंट किए जा सकते हैं लेकिन केवल एक क्लास को एक्सटेंड किया जा सकता है, जिससे इनहेरिटेंस की लचीलापन सीमित होती है।
यहाँ एक उदाहरण है:
trait Logger {
  def log(message: String): Unit = println(s"Log: $message")
}
Scala REPL एक इंटरैक्टिव शेल है जो आपको वास्तविक समय में Scala कोड लिखने और इवैल्युएट करने देता है। यह चार चरणों में काम करता है:
यह प्रक्रिया Scala कोड के त्वरित प्रयोग और परीक्षण को सक्षम बनाती है, जिससे यह सीखने, डिबगिंग और प्रोटोटाइपिंग के लिए एक शक्तिशाली टूल बनता है। आप वैरिएबल्स और फंक्शंस परिभाषित कर सकते हैं और लाइब्रेरीज़ को इंटरैक्टिव रूप से एक्सप्लोर कर सकते हैं।
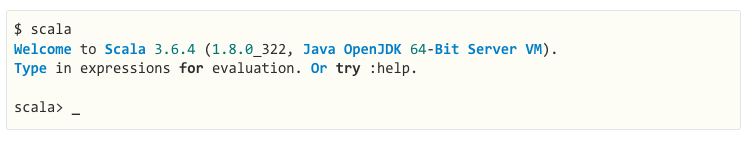
चित्र: Scala REPL एक कमांड-लाइन इंटरप्रेटर है जिसका उपयोग आप अपने Scala कोड को प्लेग्राउंड क्षेत्र की तरह परीक्षण करने के लिए कर सकते हैं। स्रोत: Scala docs
जो लोग सीनियर भूमिकाएँ तलाश रहे हैं या Scala की गहरी समझ प्रदर्शित करना चाहते हैं, उनके लिए आइए कुछ उन्नत इंटरव्यू प्रश्नों का अन्वेषण करें जो असिंक्रोनस कंप्यूटेशंस और कंकरेन्सी को संभालने, साथ ही जटिल संरचनाओं और कन्वर्ज़न्स में उतरते हैं।
ये प्रश्न फंक्शनल प्रोग्रामिंग, कंकरेन्सी और स्केलेबल सिस्टम डिज़ाइन में आपकी विशेषज्ञता का आकलन करेंगे।
Scala में Future और Await दोनों असिंक्रोनस कंप्यूटेशंस को संभालने से संबंधित हैं लेकिन उनके उद्देश्य अलग हैं।
Future एक ऐसी गणना का प्रतिनिधित्व करता है जो अंततः किसी परिणाम या अपवाद के साथ पूर्ण होगी। यह कंप्यूटेशन के परिणाम की प्रतीक्षा करते समय अन्य कार्यों को जारी रहने देता है। Await का उपयोग वर्तमान थ्रेड को तब तक ब्लॉक करने के लिए किया जाता है जब तक कि Future का परिणाम उपलब्ध न हो जाए। यह किसी नॉन-असिंक्रोनस संदर्भ में परिणाम की प्रतीक्षा करने और समन्वय करने की आवश्यकता होने पर उपयोग किया जाता है।मैं यहाँ इन कार्यात्मकताओं का उपयोग कैसे करें, उसके कुछ उदाहरण दिखाता/दिखाती हूँ:
import scala.concurrent.Future
import scala.concurrent.ExecutionContext.Implicits.global
import scala.concurrent.Await
import scala.concurrent.duration._

val futureValue = Future { 42 } // एक Future जो 42 का मान असिंक्रोनस रूप से compute करता है।
val result = Await.result(futureValue, 2.seconds) // थ्रेड को अधिकतम 2 सेकंड तक ब्लॉक करता है, Future के परिणाम की प्रतीक्षा करते हुए।
Scala थ्रेड्स जैसे लो-लेवल तंत्र और असिंक्रोनस प्रोग्रामिंग के लिए Futures और Promises जैसी हाई-लेवल एब्स्ट्रैक्शंस दोनों का उपयोग करके कंकरेन्सी को हैंडल करता है।
स्टैंडर्ड लाइब्रेरी में scala.concurrent.Future शामिल है, जो नॉन-ब्लॉकिंग कंप्यूटेशंस की अनुमति देता है, और थ्रेड एक्ज़ीक्यूशन प्रबंधन के लिए ExecutionContext उपलब्ध है।
अधिक उन्नत कंकरेन्सी के लिए, Akka व्यापक रूप से उपयोग किया जाता है, जो Actor मॉडल का उपयोग करके अत्यधिक समवर्ती, वितरित सिस्टम बनाने के टूल्स प्रदान करता है। इसके अलावा, Cats Effect और ZIO जैसी लाइब्रेरीज़ कंकरेन्सी को संभालने के लिए फंक्शनल प्रोग्रामिंग दृष्टिकोण प्रदान करती हैं, जो साइड इफेक्ट्स, असिंक्रोनस टास्क्स और रिसोर्स मैनेजमेंट के लिए सुरक्षित, संयोज्य एब्स्ट्रैक्शंस देती हैं।
Monads एक डिज़ाइन पैटर्न हैं जो कंप्यूटेशंस को संरचित तरीके से संभालते हैं, खासकर असिंक्रोनस ऑपरेशन्स या नल योग्य वैल्यूज़ जैसे साइड इफेक्ट्स से निपटते समय। Monad वैल्यू को रैप करने और स्ट्रक्चर को बनाए रखते हुए ट्रांसफ़ॉर्मेशन लागू करने का तरीका प्रदान करता है। Scala में Option और Future monads के उदाहरण हैं।
val result = Some(5).flatMap(x => Some(x * 2))Scala में Akka फ्रेमवर्क वितरित, समवर्ती और फॉल्ट-टॉलरेंट सिस्टम बनाने को सरल बनाने के लिए डिज़ाइन किया गया है। यह Actor model का उपयोग करता है, जहाँ प्रत्येक एक्टर एक हल्का, स्वतंत्र यूनिट होता है जो असिंक्रोनस रूप से मैसेज पासिंग के माध्यम से संचार करता है।
Akka लो-लेवल कंकरेन्सी विवरणों को एब्स्ट्रैक्ट कर देता है, जिससे डेवलपर्स बिज़नेस लॉजिक पर ध्यान केंद्रित कर सकते हैं। यह एक्टर्स को अलग-अलग नोड्स पर चलाने की अनुमति देकर वितरित सिस्टम का समर्थन करता है। Akka का Cluster मॉड्यूल सहज संचार, लोड बैलेंसिंग और रेजिलिएंस को सक्षम करता है, जो इसे स्केलेबल, उच्च उपलब्धता वाले सिस्टम्स के लिए आदर्श बनाता है।
Scala में implicit conversions एक टाइप को दूसरे टाइप में स्वतः ट्रांसफ़ॉर्म करने की अनुमति देती हैं। इन्हें implicit कीवर्ड का उपयोग करके परिभाषित किया जाता है और उन टाइप्स के बीच ऑपरेशन्स सक्षम करने के लिए उपयोग किया जाता है जो सामान्यतः संगत नहीं होते। कंपाइलर आवश्यकता पड़ने पर implicit conversions लागू करता है, जिससे बॉयलरप्लेट कोड कम होता है।
उदाहरण के तौर पर, मैं दिखाता/दिखाती हूँ कि किसी अंकगणितीय ऑपरेशन के दौरान String को Int में स्वचालित रूप से कैसे कन्वर्ट किया जा सकता है:
implicit def intToString(x: Int): String = x.toString
val str: String = 42  // Implicitly converted to “42”
Scala में टाइप वैरियंस बताता है कि किसी जेनेरिक टाइप के सबटाइप्स एक-दूसरे से कैसे संबंधित होते हैं। इसे covariant (+), contravariant (-) और invariant (=) टाइप पैरामीटर्स के माध्यम से नियंत्रित किया जाता है।
List[+A] का अर्थ है कि A प्रकार की List वहाँ उपयोग की जा सकती है जहाँ A के किसी सुपरटाइप की List अपेक्षित है। उदाहरण: यदि Dog Animal को एक्सटेंड करता है, तो List[Dog] को List[Animal] के रूप में उपयोग किया जा सकता है।Function1[-A, +B] दर्शाता है कि Function1 A के सुपरटाइप को स्वीकार कर सकता है और B के सबटाइप को रिटर्न कर सकता है। उदाहरण: Function1[Animal, Dog] को Function1[Dog, Dog] के रूप में उपयोग किया जा सकता है।List[A] invariant है, यानी List[Dog] और List[Animal] परस्पर विनिमेय नहीं हैं।यदि आप डेटा इंजीनियरिंग की भूमिका के लिए इंटरव्यू दे रहे हैं, तो ऐसे प्रश्नों की अपेक्षा करें जो प्रोडक्शन वातावरण में Scala एप्लीकेशन्स को डिजाइन, ऑप्टिमाइज़ और ट्रबलशूट करने की आपकी क्षमता का आकलन करें। आइए कुछ सामान्य इंटरव्यू प्रश्नों पर गौर करें जिनका आप सामना कर सकते हैं।
Scala में कस्टम एनोटेशन परिभाषित करने के लिए, आपको एक ऐसा क्लास बनाना होता है जो scala.annotation.Annotation को एक्सटेंड करता है। यह क्लास मेटाडेटा स्टोर करने के लिए कन्स्ट्रक्टर पैरामीटर्स लेता है। इसके बाद एनोटेशन्स को क्लासेज़, मेथड्स या फ़ील्ड्स पर @symbol के साथ लागू किया जाता है।
मुझे एनोटेशन्स की एक उपयोगी विशेषता यह लगी कि कस्टम एनोटेशन्स को रनटाइम पर रिफ्लेक्शन के माध्यम से उनके मेटाडेटा प्राप्त करने के लिए एक्सेस किया जा सकता है, आमतौर पर getAnnotations या समान मेथड्स के ज़रिये।
import scala.annotation.StaticAnnotation
class MyAnnotation extends StaticAnnotation
@MyAnnotation class MyClassScala Apache Spark की नेटिव भाषा है, जो सहज एकीकरण और उच्च प्रदर्शन प्रदान करती है।
इसे वितरित डेटा प्रोसेसिंग जॉब्स लिखने के लिए उपयोग किया जाता है, Spark की मुख्य विशेषताओं जैसे RDDs (Resilient Distributed Datasets), DataFrames और Datasets का लाभ उठाते हुए। Scala के साथ, आप बड़े डेटासेट्स बना और maniपुलेट कर सकते हैं, ट्रांसफ़ॉर्मेशन्स लागू कर सकते हैं और क्लस्टर में जटिल ऑपरेशन्स को कुशलतापूर्वक निष्पादित कर सकते हैं।
Spark का Scala API बैच प्रोसेसिंग से लेकर मशीन लर्निंग पाइपलाइन्स तक बिग डेटा कार्यों को संभालने के लिए संक्षिप्त और अभिव्यंजक सिंटैक्स प्रदान करता है, जिससे बड़े पैमाने पर डेटा विश्लेषण और प्रोसेसिंग समानांतर में संभव होती है।
आप PySpark को शुरू से सीखने में भी रुचि ले सकते हैं—यह complete guide to PySpark शुरू करने के लिए बेहतरीन स्थान है।
Spark में RDDs (Resilient Distributed Datasets) लो-लेवल एब्स्ट्रैक्शन हैं, जो वितरित डेटा का प्रतिनिधित्व करते हैं जिन पर समानांतर में ऑपरेशन किया जा सकता है। DataFrames RDDs के ऊपर बनाए गए हाई-लेवल एब्स्ट्रैक्शंस हैं, जो Spark के Catalyst ऑप्टिमाइज़र का उपयोग करके स्ट्रक्चर्ड डेटा हैंडलिंग और ऑप्टिमाइज़्ड एक्ज़ीक्यूशन प्रदान करते हैं।
Datasets RDDs और DataFrames दोनों के सर्वश्रेष्ठ गुणों को मिलाते हैं—RDDs की टाइप-सेफ्टी और DataFrames के ऑप्टिमाइज़ेशन्स। Datasets स्ट्रॉन्गली-टाइप्ड होते हैं, जबकि DataFrames अनटाइप्ड होते हैं, जिससे Spark में अधिक कुशल ट्रांसफ़ॉर्मेशन्स और एक्शंस संभव होते हैं।
एक बेसिक Spark जॉब में शामिल होते हैं:
SparkSession इनिशियलाइज़ करना।यहाँ एक उदाहरण देख सकते हैं:
// Spark SQL के लिए एंट्री पॉइंट SparkSession क्लास इम्पोर्ट करें
import org.apache.spark.sql.SparkSession

// एक SparkSession बनाएँ।
val spark = SparkSession.builder.appName("MySparkApp").getOrCreate()

// इनपुट टेक्स्ट फ़ाइल को DataFrame के रूप में पढ़ें।
val data = spark.read.text("data.txt")

// टेक्स्ट फ़ाइल पर ट्रांसफ़ॉर्मेशन करें
val wordCount = textFile.flatMap(_.split(" ")).groupByKey(identity).count()
wordCount.show()
Spark में ट्रांसफ़ॉर्मेशन्स वे ऑपरेशन्स हैं जो एक नया RDD, DataFrame या Dataset परिभाषित करते हैं, जैसे map(), filter(), या groupBy()। ये lazily evaluated होते हैं, यानी कोई एक्शन ट्रिगर होने तक निष्पादित नहीं होते।
एक्शंस वे ऑपरेशन्स हैं जो एक्ज़ीक्यूशन को ट्रिगर करते हैं, जैसे collect(), count(), या save()। ट्रांसफ़ॉर्मेशन्स डेटा पर lazily लागू होते हैं, जबकि एक्शंस Spark को ऑपरेशन्स के DAG को एक्सिक्यूट करने और परिणाम लौटाने या डेटा को परसिस्ट करने के लिए बाध्य करते हैं।
Spark में lazy evaluation का मतलब है कि ट्रांसफ़ॉर्मेशन्स तुरंत निष्पादित नहीं होते। इसके बजाय, Spark एक एक्ज़ीक्यूशन प्लान (DAG) बनाता है और केवल तब कंप्यूटेशन चलाता है जब कोई एक्शन कॉल किया जाता है। यह Spark को एक्ज़ीक्यूशन को ऑप्टिमाइज़ करने देता है—डेटा शफलिंग को कम करके, ऑपरेशन्स को संयोजित करके और प्रोसेसिंग पाइपलाइन में पहले ही फ़िल्टर्स लागू करके।
Spark जॉब्स को ऑप्टिमाइज़ करना कई रणनीतियों को शामिल करता है, जैसे डेटा शफलिंग को न्यूनतम करना, इंटरमीडिएट परिणामों को कैश करना और उपयुक्त पार्टिशनिंग का उपयोग करना।
कुछ रणनीतियाँ जिनकी मैं सलाह देता/देती हूँ:
groupBy)।बिग डेटा प्रोजेक्ट्स के लिए Scala में सामान्य चुनौतियों में बड़े डेटासेट्स के लिए मेमोरी और प्रदर्शन का प्रबंधन, डेटा स्क्यू को संभालना और वितरित वातावरण में फॉल्ट्स से कुशलतापूर्वक निपटना शामिल है।
Spark जॉब्स को डिबग करना वितरित सिस्टम्स और lazy evaluation की जटिलता के कारण मुश्किल हो सकता है। इसके अलावा, बॉटलनेक्स से बचने और ओवरहेड कम करने के लिए Spark जॉब्स को ऑप्टिमाइज़ करना अक्सर कॉन्फ़िगरेशन के सूक्ष्म समायोजन और अंतर्निहित एक्ज़ीक्यूशन प्लान की समझ की आवश्यकता होती है।
साथ ही, असंगत डेटा फॉर्मैट्स, डेटा गुणवत्ता संबंधी समस्याएँ और स्केलेबल कोड लिखने व बनाए रखने की जटिलता भी बिग डेटा परिदृश्यों में चुनौतीपूर्ण हो सकती हैं।
इस लेख में, हमने बेसिक, इंटरमीडिएट और एडवांस्ड विषयों में फैले विभिन्न Scala इंटरव्यू प्रश्नों को कवर किया। Scala की मुख्य अवधारणाओं और फायदों को समझने से लेकर अधिक जटिल ऑप्टिमाइज़ेशन्स, हैंडलिंग और कन्वर्ज़न्स में गहराई तक जाने तक, हमने उन प्रमुख क्षेत्रों का अन्वेषण किया जिनके बारे में संभावित नियोक्ता पूछ सकते हैं।
अपनी तैयारी पुख्ता करने के लिए, हमारे Introduction to Scala कोर्स के साथ अभ्यास शुरू करें या एक त्वरित रिफ्रेशर लें! डुअल Java-Scala भूमिका के लिए तैयारी कर रहे हैं? पूरा दृष्टिकोण पाने के लिए हमारा Java इंटरव्यू प्रश्न गाइड न चूकें।
इन कोर्सेज़ के साथ Scala और डेटा इंजीनियरिंग के बारे में और जानें!
कोर्स
कोर्स
कोर्स