
Corso
Introduction to Scala
3 ore
27.1K
Scala è un linguaggio potente che unisce programmazione funzionale e orientata agli oggetti. È ampiamente usato nell’elaborazione di big data e nelle app web, grazie alla sua sintassi concisa, alla scalabilità e ai vantaggi in termini di prestazioni.
Con la crescente richiesta di competenze in Scala nel settore dei dati, questo articolo offre una guida completa alle domande da colloquio su Scala, coprendo vari argomenti dai concetti di base alle tecniche avanzate e alle domande per data engineering.
Cominciamo esplorando alcune domande fondamentali su Scala che valutano la tua comprensione dei concetti chiave e dei vantaggi di questo potente linguaggio.
Se sei alle prime armi con il linguaggio, inizia con il nostro corso Introduction to Scala per costruire solide basi prima di affrontare le domande da colloquio.
Il nome Scala deriva dalla parola scalable. Scala è un linguaggio di programmazione staticamente tipizzato che combina i paradigmi orientato agli oggetti e funzionale. È conciso, espressivo e progettato per risolvere molte carenze di Java. Ad esempio, Scala gira sulla Java Virtual Machine (JVM), il che significa che puoi usare senza problemi librerie e framework Java.
Mentre Java è rigorosamente orientato agli oggetti, Scala consente sia la programmazione orientata agli oggetti che quella funzionale. Scala offre anche funzionalità avanzate come l’immutabilità, le funzioni di ordine superiore, il pattern matching e altro ancora, il tutto con una sintassi concisa.
Se provieni dal mondo Java, dai un’occhiata al corso Introduction to Java per ripassare le basi. Per confrontare i principi OOP in Java e Scala, prova il corso Introduction to OOP in Java.
Scala ha alcune caratteristiche potenti che lo rendono unico e popolare tra i programmatori. Ecco alcune di queste:
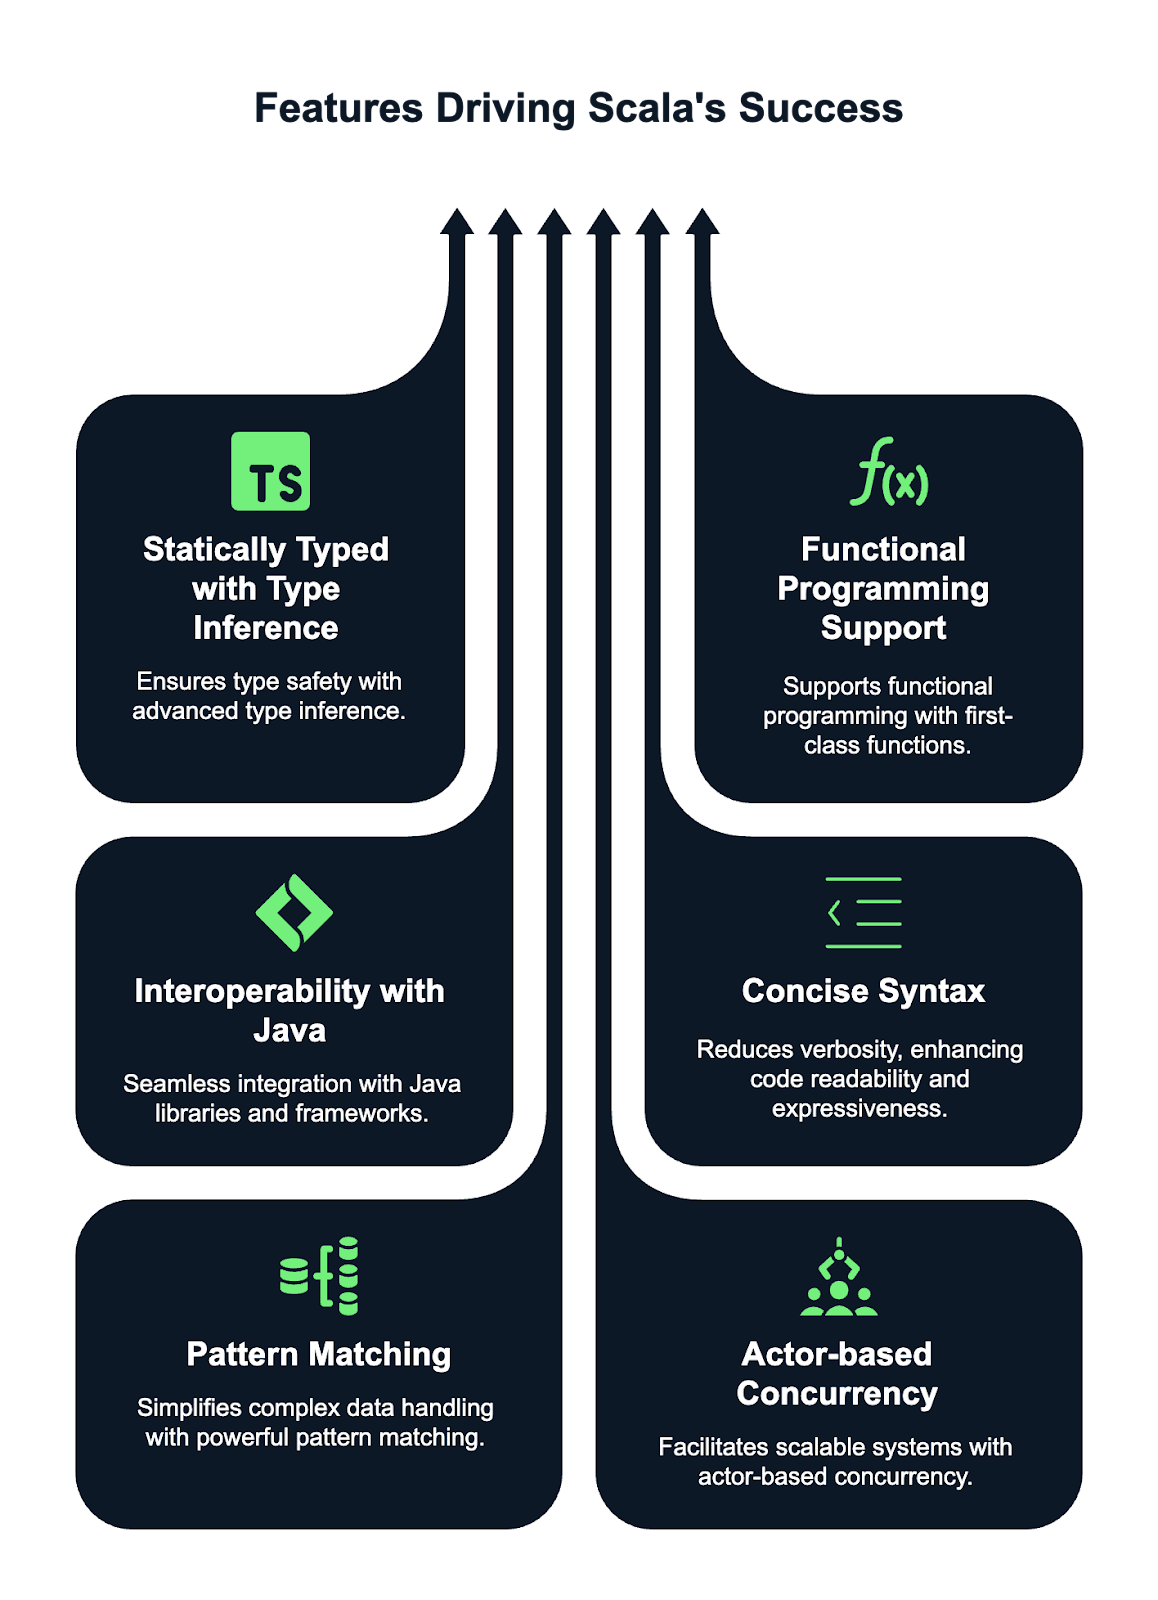
Una case class in Scala è una classe speciale ottimizzata per l’uso con strutture dati immutabili. Fornisce automaticamente le implementazioni di metodi come toString, equals e hashCode. Le case class supportano anche il pattern matching, risultando estremamente utili per gestire i dati in stile funzionale.
In genere, usi le case class per rappresentare oggetti dati che non dovrebbero cambiare dopo la creazione. Ecco un esempio qui sotto:
case class Person(name: String, age: Int)
val person1 = Person("John", 30)In Scala, l’immutabilità è incoraggiata, soprattutto nella programmazione funzionale. Puoi dichiarare una variabile immutabile usando val, a differenza di var, che è mutabile. Una volta assegnato un valore a val, non può essere cambiato. L’immutabilità porta a codice più sicuro e prevedibile, con meno spazio per effetti collaterali indesiderati. Guarda l’esempio qui sotto:
val name = "Alice"

// Provare a cambiarlo causerà un errore in compilazione
name = "Bob" // Errore: reassignment to valUn companion object è un oggetto che condivide lo stesso nome di una classe ed è definito nello stesso file. Lo scopo principale di un companion object è fornire metodi e funzioni strettamente legati alla classe ma non associati a un’istanza di essa.
Il companion object può contenere factory method o altre utility, come nell’esempio qui sotto:
class Person(val name: String, val age: Int)
object Person {
  def apply(name: String, age: Int): Person = new Person(name, age)
}
Il metodo apply nel companion object di Person permette di creare un Person senza usare la keyword new, come mostrato sotto:
val p = Person("John", 25)In Scala, le keyword var, val e lazy val vengono usate per definire variabili, ma differiscono per mutabilità, inizializzazione e momento di valutazione.
Un var è una variabile mutabile, cioè il suo valore può essere cambiato dopo l’inizializzazione. Puoi riassegnare un nuovo valore a un var:
var x = 10
x = 20  // Riassegnabile
Un val, invece, è un riferimento immutabile: una volta assegnato un valore, non può essere riassegnato, ma l’oggetto a cui si riferisce può comunque essere mutabile
val y = 10
// y = 20  // Errore: reassignment to val
Un lazy val è un tipo speciale di val che non viene valutato finché non viene accesso per la prima volta, il che si chiama lazy evaluation. Questo può essere utile per ottimizzare le prestazioni quando si lavora con computazioni costose o che richiedono molte risorse.
lazy val z = {
  println("Computing z")
  42
}
Per un approfondimento sulle dichiarazioni di variabili e le best practice in Scala, dai un’occhiata a questo tutorial sulle variabili in Scala.
In Scala, una funzione di ordine superiore è una funzione che accetta una o più funzioni come parametri o restituisce una funzione come risultato. Questo concetto permette di trattare le funzioni come valori di prima classe, offrendo maggiore flessibilità e astrazione nel codice.
Le funzioni di ordine superiore consentono di passare e personalizzare comportamenti, rendendo il codice più modulare, riutilizzabile ed espressivo.
Qui sotto trovi un esempio di funzione di ordine superiore che accetta un’altra funzione come argomento:
// Definisci una funzione di ordine superiore che prende una funzione come parametro
def applyFunction(f: Int => Int, x: Int): Int = f(x)

// Chiama la funzione di ordine superiore con una funzione che moltiplica l'input per 2
val result = applyFunction(x => x * 2, 5)  // 10
In questo caso, applyFunction è una funzione di ordine superiore che prende una funzione f, che moltiplica per 2, e la applica a 5.
In Scala, String è immutabile, quindi le modifiche creano nuovi oggetti, il che può essere inefficiente per cambiamenti ripetuti. È adatto per operazioni su stringhe poco frequenti.
Al contrario, StringBuilder è mutabile e permette modifiche in-place senza creare nuovi oggetti. Questo lo rende più efficiente per manipolazioni frequenti, come aggiunte o modifiche del contenuto.
Ti consiglio di usare String quando preferisci l’immutabilità e le prestazioni non sono critiche, e di optare per StringBuilder quando ti serve più performance in scenari con molte modifiche alle stringhe.
L’annotazione @tailrec si usa per indicare che un metodo è tail-recursive, cioè che la chiamata ricorsiva è l’ultima operazione del metodo. Questo permette al compilatore Scala di ottimizzare il metodo per evitare errori di stack overflow trasformando la ricorsione in un ciclo. Se il metodo non è tail-recursive, il compilatore lancerà un errore.
Vediamo un esempio:
@tailrec
def factorial(n: Int, accumulator: Int = 1): Int = {
  if (n <= 0) accumulator
  else factorial(n - 1, n * accumulator)
}Dopo aver coperto le basi, passiamo ad alcune domande di livello intermedio su Scala che ti aiutano a capire meglio come funziona il linguaggio.
In Scala, map, flatMap e foreach sono funzioni di ordine superiore usate sulle collezioni, ma hanno scopi diversi.
map trasforma ogni elemento di una collezione e restituisce una nuova collezione della stessa dimensione con gli elementi trasformati. flatMap trasforma anch’esso ogni elemento ma appiattisce la struttura risultante, risultando utile quando la trasformazione restituisce a sua volta collezioni. foreach si usa per effetti collaterali, applicando una funzione a ogni elemento senza restituire nulla; è comune per operazioni come la stampa o l’aggiornamento di stati esterni.Il pattern matching in Scala è una funzionalità potente che consente di confrontare valori con pattern, rendendo il codice più espressivo e conciso. È simile alle istruzioni switch o case di altri linguaggi, ma è più flessibile e può essere usato con vari tipi, come interi, stringhe, liste e persino strutture dati complesse. Si usa con le espressioni match, che confrontano il valore di un’espressione con più pattern.
Alcuni casi d’uso del pattern matching includono:
Some o None in Option, per una gestione concisa dei valori nullabili.Ecco un esempio:
// Definisci una variabile x con valore 3
val x = 3

// Pattern matching sul valore di x
x match {
  // Se 'x' è uguale a 1, stampa "One"
  case 1 => println("One")
    // Se 'x' è uguale a 2, stampa "Two"
  case 2 => println("Two")
  // Se 'x' non corrisponde ai casi precedenti, stampa "Other"
  case _ => println("Other")
}In Scala, Option è un tipo contenitore usato per rappresentare un valore che può esistere o meno, aiutando a evitare i valori null e le null pointer exception. Ha due sottotipi: Some e None.
Some incapsula un valore valido, indicando la presenza di un valore, mentre None indica l’assenza di un valore. Questo consente di gestire esplicitamente i casi in cui un valore potrebbe mancare, promuovendo codice più sicuro e funzionale.
Option si usa spesso in metodi che potrebbero non restituire un risultato, riducendo la necessità di controlli null soggetti a errori.
Guarda il codice qui sotto:
// Funzione che restituisce un'Option
def findFirstEvenNumber(list: List[Int]): Option[Int] = {
  list.find(_ % 2 == 0)  // Restituisce Some(number) se trova un numero pari, altrimenti None
}

// Esempio d'uso:
val numbers = List(1, 3, 5, 7, 8)
val result = findFirstEvenNumber(numbers)
result match {
  case Some(number) => println(s"Found an even number: $number")  // Output: Found an even number: 8
  case None => println("No even number found")
}Scala offre un ricco set di collezioni, suddivise in tipi mutabili e immutabili.
List, Set, Map e Vector, non possono essere modificate dopo la creazione, favorendo pratiche di programmazione funzionale.ArrayBuffer, HashSet e HashMap, consentono modifiche. Le collezioni sono molto flessibili e supportano varie operazioni come filtering, mapping e folding. La libreria standard offre anche collezioni specializzate come Queue, Stack e SortedSet, per esigenze diverse di manipolazione dati in modo efficiente. Le collezioni immutabili sono preferite per la sicurezza nei thread e la purezza funzionale.
In Scala, i parametri impliciti sono valori che il compilatore passa automaticamente a un metodo o a un costruttore senza specificarli esplicitamente. Si contrassegnano con la keyword implicit e si usano tipicamente per dependency injection, configurazioni o passaggio di contesto.
// Definisci una funzione che accetta un parametro implicito 'name' di tipo String
def greet(implicit name: String) = s"Hello, $name"

// Definisci un valore implicito 'myName' di tipo String nello scope
implicit val myName = "Alice"

// Chiama la funzione greet senza passare esplicitamente 'name'
// Il compilatore usa automaticamente il valore implicito 'myName'
println(greet) // Output: "Hello, Alice"In Scala, i trait sono simili alle interface in Java ma con capacità aggiuntive. Un trait è un componente riutilizzabile che può essere mixato in classi o altri trait. Consente di definire sia metodi astratti che metodi concreti. I trait possono anche mantenere stato, a differenza delle interfacce Java, che possono definire solo le firme dei metodi.
Scala permette di mixare più trait in una singola classe, abilitando un’ereditarietà multipla; Java consente di implementare più interfacce ma una sola classe, limitando la flessibilità dell’ereditarietà.
Ecco un esempio:
trait Logger {
  def log(message: String): Unit = println(s"Log: $message")
}La REPL di Scala è una shell interattiva che ti consente di scrivere e valutare codice Scala in tempo reale. Funziona in quattro passaggi:
Questo processo consente sperimentazione e test rapidi del codice Scala, rendendolo uno strumento potente per apprendimento, debugging e prototipazione. Puoi definire variabili e funzioni ed esplorare le librerie in modo interattivo.
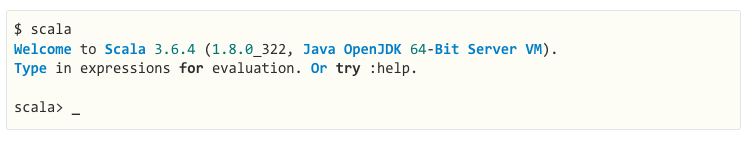
Figura: la REPL di Scala è un interprete da riga di comando che puoi usare come area di gioco per testare il tuo codice Scala. Fonte: Scala docs
Per chi cerca ruoli più senior o vuole dimostrare una comprensione più profonda di Scala, esploriamo alcune domande avanzate che approfondiscono la gestione di computazioni asincrone e concorrenza, oltre a strutture e conversioni complesse.
Queste domande valuteranno la tua esperienza in programmazione funzionale, concorrenza e progettazione di sistemi scalabili.
In Scala, Future e Await sono entrambi legati alla gestione delle computazioni asincrone ma hanno scopi diversi.
Future rappresenta una computazione che sarà eventualmente completata con un risultato o un’eccezione. Consente ad altri task di proseguire mentre si attende il risultato della computazione. Await si usa per bloccare il thread corrente finché il risultato di un Future non è disponibile. Forza un thread ad attendere il completamento di un Future. Si usa spesso quando devi sincronizzare e aspettare il risultato in un contesto non asincrono.Ecco alcuni esempi di come usare queste funzionalità:
import scala.concurrent.Future
import scala.concurrent.ExecutionContext.Implicits.global
import scala.concurrent.Await
import scala.concurrent.duration._

val futureValue = Future { 42 } // Un Future che calcola il valore 42 in modo asincrono.
val result = Await.result(futureValue, 2.seconds) // Blocca il thread fino a 2 secondi in attesa del risultato del Future.Scala gestisce la concorrenza sia con meccanismi di basso livello come i thread, sia con astrazioni di alto livello come Future e Promise per la programmazione asincrona.
La libreria standard include scala.concurrent.Future, che consente computazioni non bloccanti, e ExecutionContext per gestire i thread di esecuzione.
Per una concorrenza più avanzata, Akka è ampiamente usato: offre strumenti per costruire sistemi altamente concorrenti e distribuiti usando il modello ad attori. Inoltre, librerie come Cats Effect e ZIO offrono approcci funzionali alla gestione della concorrenza, fornendo astrazioni sicure e componibili per gestire effetti collaterali, task asincroni e risorse.
Le monadi sono un pattern progettuale usato per gestire le computazioni in modo strutturato, soprattutto quando si hanno effetti collaterali come operazioni asincrone o valori nullabili. Una monade fornisce un modo per incapsulare un valore e applicare trasformazioni mantenendo la struttura. In Scala, Option e Future sono esempi di monadi.
val result = Some(5).flatMap(x => Some(x * 2))Il framework Akka in Scala è progettato per semplificare la costruzione di sistemi distribuiti, concorrenti e tolleranti ai guasti. Usa il modello ad attori, in cui ogni attore è un’unità leggera e indipendente che comunica in modo asincrono tramite passaggio di messaggi.
Akka astrae i dettagli di basso livello della concorrenza, consentendo agli sviluppatori di concentrarsi sulla logica di business. Supporta sistemi distribuiti permettendo agli attori di girare su nodi diversi. Il modulo Cluster di Akka facilita comunicazione, bilanciamento del carico e resilienza, rendendolo ideale per sistemi scalabili e altamente disponibili.
In Scala, le conversioni implicite permettono la trasformazione automatica di un tipo in un altro. Si definiscono con la keyword implicit e si usano per abilitare operazioni tra tipi altrimenti non compatibili. Il compilatore applica conversioni implicite quando necessario, riducendo il boilerplate.
Ad esempio, ecco come convertire automaticamente una String in un Int quando si eseguono operazioni aritmetiche:
implicit def intToString(x: Int): String = x.toString
val str: String = 42 // Convertito implicitamente in “42”In Scala, la varianza dei tipi indica come i sottotipi di un tipo generico si relazionano tra loro. Si controlla usando parametri di tipo covarianti (+), controvarianti (-) e invarianti (=).
List[+A] significa che una List di tipo A può essere usata ovunque sia attesa una List di un supertipo di A. Esempio: List[Dog] può essere usata come List[Animal] se Dog estende Animal.Function1[-A, +B] significa che una Function1 può accettare un supertipo di A e restituire un sottotipo di B. Esempio: Function1[Animal, Dog] può essere usata come Function1[Dog, Dog].List[A] è invariante, quindi List[Dog] e List[Animal] non sono intercambiabili.Se stai sostenendo un colloquio per un ruolo di data engineering, aspettati domande che valutino la tua capacità di progettare, ottimizzare e risolvere problemi nelle applicazioni Scala in produzione. Vediamo alcune tipiche domande da colloquio che potresti incontrare.
Per definire un’annotazione personalizzata in Scala, devi creare una classe che estende scala.annotation.Annotation. Questa classe accetta parametri di costruttore per memorizzare metadati. Le annotazioni vengono poi applicate a classi, metodi o campi con il @simbolo.
Una caratteristica utile delle annotazioni è che quelle personalizzate possono essere accessibili a runtime tramite reflection per recuperarne i metadati, tipicamente con getAnnotations o metodi simili.
import scala.annotation.StaticAnnotation
class MyAnnotation extends StaticAnnotation
@MyAnnotation class MyClassScala è il linguaggio nativo di Apache Spark, fornendo integrazione fluida e alte prestazioni.
Si usa per scrivere job distribuiti di elaborazione dati, sfruttando le funzionalità core di Spark come RDD (Resilient Distributed Datasets), DataFrame e Dataset. Con Scala puoi creare e manipolare grandi dataset, applicare trasformazioni ed eseguire operazioni complesse in modo efficiente su un cluster.
L’API Scala di Spark offre una sintassi concisa ed espressiva per gestire attività di big data, dall’elaborazione batch ai pipeline di machine learning, consentendo analisi e processamenti su larga scala in parallelo.
Potrebbe interessarti anche imparare PySpark dalle basi—questa guida completa a PySpark è un ottimo punto di partenza.
In Spark, gli RDD (Resilient Distributed Datasets) sono l’astrazione di basso livello, rappresentano dati distribuiti su cui operare in parallelo. I DataFrame sono astrazioni di livello superiore costruite sopra gli RDD, offrono gestione di dati strutturati con esecuzione ottimizzata tramite il Catalyst optimizer di Spark.
I Dataset combinano il meglio di RDD e DataFrame, offrendo la sicurezza dei tipi degli RDD e le ottimizzazioni dei DataFrame. I Dataset sono fortemente tipizzati, mentre i DataFrame sono non tipizzati, consentendo trasformazioni e azioni più efficienti in Spark.
Un job Spark di base in Scala prevede:
SparkSession.Ecco un esempio:
// Importa la classe SparkSession che è il punto di ingresso per Spark SQL
import org.apache.spark.sql.SparkSession

// Crea una SparkSession.
val spark = SparkSession.builder.appName("MySparkApp").getOrCreate()

// Leggi il file di testo di input come DataFrame.
val data = spark.read.text("data.txt")

// Esegui la trasformazione sul file di testo
val wordCount = textFile.flatMap(_.split(" ")).groupByKey(identity).count()
wordCount.show()Le trasformazioni in Spark sono operazioni che definiscono un nuovo RDD, DataFrame o Dataset, come map(), filter() o groupBy(). Sono valutate in modo lazy, cioè non vengono eseguite finché non viene attivata un’azione.
Le azioni sono operazioni che attivano l’esecuzione, come collect(), count() o save(). Le trasformazioni si applicano ai dati in modo lazy, mentre le azioni forzano Spark ad eseguire il DAG delle operazioni e a restituire un risultato o a persistere i dati.
La lazy evaluation in Spark significa che le trasformazioni non vengono eseguite immediatamente. Spark costruisce invece un piano di esecuzione (DAG) ed esegue le computazioni solo quando viene chiamata un’azione. Questo consente a Spark di ottimizzare l’esecuzione minimizzando gli shuffle dei dati, combinando operazioni e applicando filtri il prima possibile nella pipeline di elaborazione.
L’ottimizzazione dei job Spark prevede varie strategie, come minimizzare gli shuffle dei dati, mettere in cache i risultati intermedi e usare un partizionamento appropriato.
Alcune strategie che consiglio per ottimizzare i job Spark sono:
groupBy).Le sfide comuni con Scala nei progetti di big data includono la gestione della memoria e delle prestazioni per grandi dataset, la gestione dello skew dei dati e il trattamento efficiente dei guasti in ambienti distribuiti.
Il debugging dei job Spark può essere complicato per via della complessità dei sistemi distribuiti e della lazy evaluation. Inoltre, ottimizzare i job Spark per evitare colli di bottiglia e ridurre gli overhead spesso richiede un fine tuning delle configurazioni e la comprensione del piano di esecuzione sottostante.
Inoltre, la gestione di formati dati incoerenti, problemi di qualità dei dati e la complessità nello scrivere e mantenere codice scalabile possono risultare difficili in scenari di big data.
In questo articolo abbiamo coperto un’ampia gamma di domande da colloquio su Scala, dai temi di base a quelli intermedi e avanzati. Dalla comprensione dei concetti fondamentali e dei vantaggi di Scala fino alle ottimizzazioni e alle gestioni più complesse, abbiamo esplorato le aree chiave su cui i potenziali datori di lavoro potrebbero interrogarti.
Per consolidare la tua preparazione, inizia a fare pratica con il nostro corso Introduction to Scala o fai un rapido ripasso! Ti stai preparando per un ruolo ibrido Java-Scala? Non perderti la nostra guida alle domande da colloquio su Java per una prospettiva completa.
Approfondisci Scala e il data engineering con questi corsi!
Corso
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min



