
Kursus
Introduction to Scala
3 jam
27.1K
Scala adalah bahasa yang kuat yang memadukan pemrograman fungsional dan berorientasi objek. Bahasa ini banyak digunakan dalam pemrosesan big data dan aplikasi web karena sintaksnya yang ringkas, skalabilitas, dan keunggulan performa.
Seiring meningkatnya kebutuhan akan keahlian Scala di industri data, artikel ini akan memberikan panduan komprehensif tentang pertanyaan wawancara Scala, mencakup berbagai topik dari konsep dasar hingga teknik lanjutan dan pertanyaan data engineering.
Mari mulai dengan menelusuri beberapa pertanyaan wawancara Scala mendasar yang menilai pemahaman Anda tentang konsep inti dan keunggulan bahasa yang kuat ini.
Jika Anda baru dengan bahasa ini, mulailah dengan kors Introduction to Scala untuk membangun fondasi yang kuat sebelum menghadapi pertanyaan wawancara.
Nama Scala berasal dari kata scalable. Scala adalah bahasa pemrograman statis yang mengombinasikan paradigma pemrograman berorientasi objek dan fungsional. Bahasa ini ringkas, ekspresif, dan dirancang untuk mengatasi banyak kekurangan Java. Misalnya, Scala berjalan di Java Virtual Machine (JVM), yang berarti Anda dapat menggunakan pustaka dan framework Java dengan mulus.
Sementara Java sepenuhnya berorientasi objek, Scala memungkinkan pemrograman berorientasi objek sekaligus fungsional. Scala juga menyediakan fitur-fitur lanjut seperti imutabilitas, fungsi orde tinggi, pattern matching, dan lainnya, semuanya dengan sintaks yang ringkas.
Jika Anda berasal dari latar belakang Java, lihat kurs Introduction to Java untuk meninjau kembali dasar-dasarnya. Untuk membandingkan prinsip berorientasi objek di Java dan Scala, coba kursus Introduction to OOP in Java.
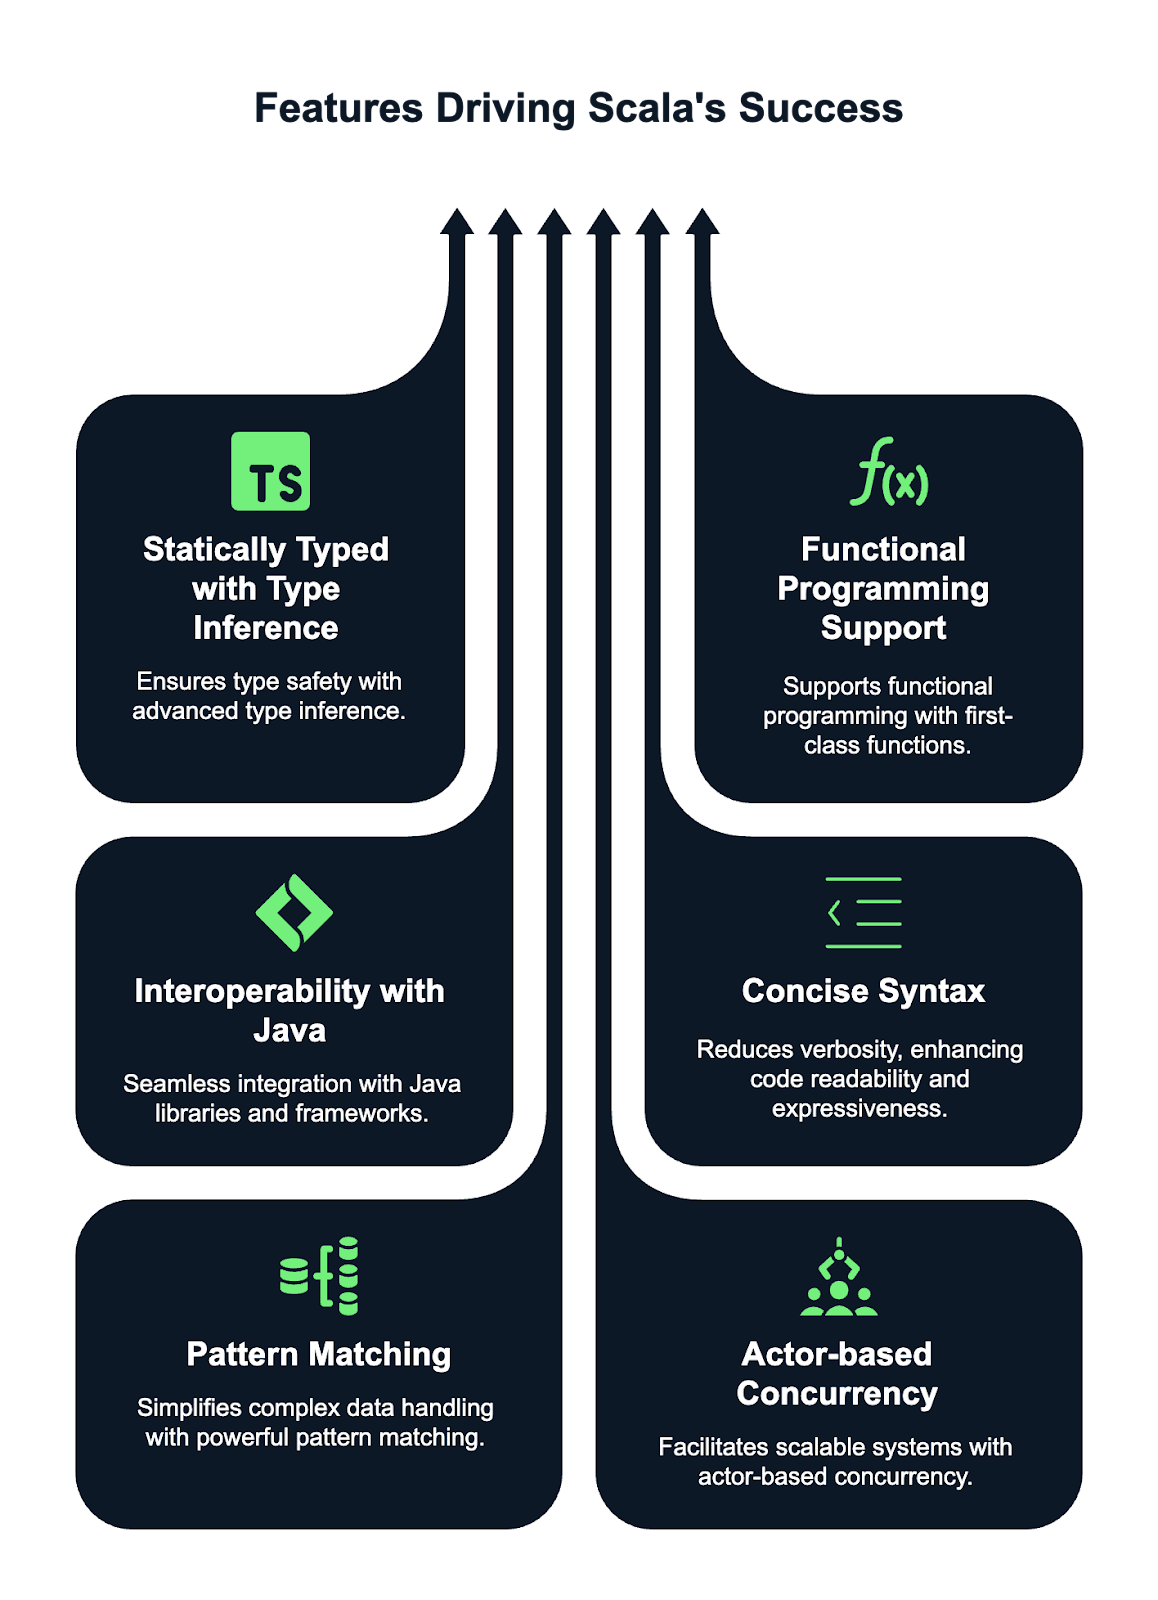
Scala memiliki beberapa fitur kuat yang membuatnya menonjol dan populer di kalangan programmer. Berikut beberapa di antaranya:
Case class di Scala adalah kelas khusus yang dioptimalkan untuk digunakan dengan struktur data immutable. Kelas ini secara otomatis menyediakan implementasi untuk metode seperti toString, equals, dan hashCode. Case class juga dapat digunakan dalam pattern matching, sehingga sangat berguna untuk menangani data dalam gaya fungsional.
Anda biasanya menggunakan case class untuk merepresentasikan objek data yang tidak boleh berubah setelah dibuat. Berikut saya tinggalkan contohnya:
case class Person(name: String, age: Int)
val person1 = Person("John", 30)Di Scala, imutabilitas sangat dianjurkan, terutama untuk pemrograman fungsional. Anda dapat mendeklarasikan variabel immutable menggunakan val berbeda dengan var yang mutable. Setelah Anda menetapkan nilai ke val, nilainya tidak dapat diubah. Imutabilitas menghasilkan kode yang lebih aman dan lebih dapat diprediksi, karena lebih sedikit ruang untuk efek samping yang tidak diinginkan. Lihat contoh saya di bawah ini:
val name = "Alice"

// Mencoba mengubahnya akan menghasilkan error saat kompilasi
name = "Bob" // Error: reassignment to valCompanion object adalah objek yang memiliki nama yang sama dengan sebuah kelas dan didefinisikan dalam berkas yang sama. Tujuan utama companion object adalah menyediakan metode dan fungsi yang terkait erat dengan kelas tetapi tidak terikat pada instansnya.
Companion object dapat menampung method pabrik atau fungsi utilitas lainnya, seperti contoh yang saya tulis di bawah:
class Person(val name: String, val age: Int)
object Person {
  def apply(name: String, age: Int): Person = new Person(name, age)
}
Metode apply pada companion object Person memungkinkan saya membuat Person tanpa menggunakan keyword new, seperti yang saya tunjukkan di bawah:
val p = Person("John", 25)Di Scala, keyword var, val, dan lazy val digunakan untuk mendefinisikan variabel, tetapi berbeda dalam hal mutabilitas, inisialisasi, dan waktu evaluasi.
var adalah variabel mutable, artinya nilainya dapat diubah setelah diinisialisasi. Anda dapat menetapkan ulang nilai baru ke var:
var x = 10
x = 20  // Dapat diubah
Di sisi lain, val adalah referensi immutable, artinya setelah diberi nilai, tidak dapat ditetapkan ulang, tetapi objek yang dirujuknya masih dapat mutable
val y = 10
// y = 20  // Error: reassignment to val
lazy val adalah jenis khusus dari val yang tidak dievaluasi sampai diakses untuk pertama kali, yang disebut lazy evaluation. Ini dapat membantu untuk optimalisasi performa saat bekerja dengan komputasi yang mahal atau intensif sumber daya.
lazy val z = {
  println("Computing z")
  42
}
Untuk melihat lebih dalam deklarasi variabel dan praktik terbaik di Scala, lihat tutorial Variables in Scala ini.
Di Scala, fungsi orde tinggi adalah fungsi yang menerima satu atau lebih fungsi sebagai parameter atau mengembalikan fungsi sebagai hasil. Konsep ini memungkinkan fungsi diperlakukan sebagai nilai kelas satu, sehingga meningkatkan fleksibilitas dan abstraksi dalam kode Anda.
Fungsi orde tinggi memungkinkan perilaku untuk diteruskan dan disesuaikan, membuat kode lebih modular, dapat digunakan kembali, dan ekspresif.
Di bawah ini, saya tinggalkan contoh fungsi orde tinggi yang menerima fungsi lain sebagai argumen:
// Mendefinisikan fungsi orde tinggi yang menerima fungsi sebagai parameter
def applyFunction(f: Int => Int, x: Int): Int = f(x)

// Memanggil fungsi orde tinggi dengan fungsi yang mengalikan input dengan 2
val result = applyFunction(x => x * 2, 5)  // 10
Dalam kasus ini, applyFunction adalah fungsi orde tinggi yang menerima fungsi f, yang mengalikan dengan 2, dan menerapkannya pada 5.
Di Scala, String bersifat immutable, artinya modifikasi akan membuat objek baru, yang bisa tidak efisien untuk perubahan berulang. Ini cocok untuk operasi string yang jarang dilakukan.
Sebaliknya, StringBuilder bersifat mutable, memungkinkan modifikasi di tempat tanpa membuat objek baru. Ini membuatnya lebih efisien untuk manipulasi string yang sering seperti menambahkan atau mengubah konten.
Saya merekomendasikan menggunakan String ketika imutabilitas diutamakan dan performa tidak krusial, serta memilih StringBuilder saat Anda memerlukan performa lebih baik dalam skenario yang melibatkan banyak modifikasi string.
Anotasi @tailrec digunakan untuk menandai metode sebagai tail-recursive, yang berarti pemanggilan rekursif adalah operasi terakhir dalam metode tersebut. Ini memungkinkan kompiler Scala untuk mengoptimalkan metode guna menghindari error stack overflow dengan mengubah rekursi menjadi loop. Jika metode tidak tail-recursive, kompiler akan melempar error.
Mari lihat contohnya:
@tailrec
def factorial(n: Int, accumulator: Int = 1): Int = {
  if (n <= 0) accumulator
  else factorial(n - 1, n * accumulator)
}Setelah membahas dasar-dasarnya, mari beralih ke beberapa pertanyaan wawancara Scala tingkat menengah yang membantu Anda memahami lebih lanjut cara kerja bahasa ini.
Di Scala, map, flatMap, dan foreach adalah fungsi orde tinggi yang digunakan pada koleksi, tetapi memiliki tujuan yang berbeda.
map mentransformasikan setiap elemen koleksi dan mengembalikan koleksi baru dengan ukuran yang sama berisi elemen yang telah ditransformasikan. flatMap juga mentransformasikan setiap elemen tetapi meratakan struktur hasilnya, yang berguna ketika transformasi itu sendiri menghasilkan koleksi. foreach digunakan untuk efek samping, menerapkan fungsi ke setiap elemen tanpa mengembalikan apa pun, umum digunakan untuk operasi seperti mencetak atau memperbarui state eksternal.Pattern matching di Scala adalah fitur kuat yang memungkinkan Anda mencocokkan nilai terhadap pola, membuat kode lebih ekspresif dan ringkas. Ini mirip dengan pernyataan switch atau case di bahasa lain, tetapi lebih fleksibel dan dapat digunakan dengan berbagai tipe, seperti integer, string, list, dan bahkan struktur data kompleks. Fitur ini digunakan dengan ekspresi match, yang membandingkan nilai suatu ekspresi terhadap beberapa pola.
Beberapa kasus penggunaan pattern matching meliputi:
Some atau None dalam Option, memungkinkan penanganan nilai nullable yang ringkas.Berikut saya tinggalkan contohnya:
// Mendefinisikan variabel x dengan nilai 3
val x = 3

// Pattern matching pada nilai x
x match {
  // Jika 'x' sama dengan 1, cetak "One"
  case 1 => println("One")
    // Jika 'x' sama dengan 2, cetak "Two"
  case 2 => println("Two")
  // Jika 'x' tidak cocok dengan kasus di atas, cetak "Other"
  case _ => println("Other")
}Di Scala, Option adalah tipe kontainer yang digunakan untuk merepresentasikan nilai yang mungkin ada atau tidak ada, membantu menghindari nilai null dan null pointer exception. Tipe ini memiliki dua subtipe: Some dan None.
Some membungkus nilai valid, menunjukkan adanya nilai, sedangkan None menandakan ketiadaan nilai. Ini memungkinkan developer secara eksplisit menangani kasus ketika nilai mungkin hilang, mendorong kode yang lebih aman dan fungsional.
Option sering digunakan pada metode yang mungkin gagal mengembalikan hasil, mengurangi kebutuhan akan pemeriksaan null yang rawan kesalahan.
Lihat kode di bawah ini:
// Fungsi yang mengembalikan Option
def findFirstEvenNumber(list: List[Int]): Option[Int] = {
  list.find(_ % 2 == 0)  // Mengembalikan Some(number) jika ditemukan angka genap, jika tidak maka None
}

// Contoh penggunaan:
val numbers = List(1, 3, 5, 7, 8)
val result = findFirstEvenNumber(numbers)
result match {
  case Some(number) => println(s"Found an even number: $number")  // Output: Found an even number: 8
  case None => println("No even number found")
}Scala menyediakan himpunan koleksi yang kaya yang dikategorikan menjadi tipe mutable dan immutable.
List, Set, Map, dan Vector, tidak dapat dimodifikasi setelah dibuat, mendorong praktik pemrograman fungsional.ArrayBuffer, HashSet, dan HashMap, memungkinkan modifikasi. Koleksi sangat fleksibel, mendukung berbagai operasi seperti filtering, mapping, dan folding. Pustaka standar juga menawarkan koleksi khusus seperti Queue, Stack, dan SortedSet, yang memenuhi berbagai kebutuhan manipulasi data secara efisien. Koleksi immutable lebih disukai untuk keamanan thread dan kemurnian fungsional.
Di Scala, parameter implicit adalah nilai yang diteruskan kompiler secara otomatis ke metode atau konstruktor tanpa menyebutkannya secara eksplisit. Nilai ini ditandai dengan keyword implicit dan biasanya digunakan untuk hal-hal seperti dependency injection, konfigurasi, atau penyampaian konteks.
// Mendefinisikan fungsi yang menerima parameter implicit 'name' bertipe String
def greet(implicit name: String) = s"Hello, $name"

// Mendefinisikan nilai implicit 'myName' bertipe String dalam cakupan
implicit val myName = "Alice"

// Memanggil fungsi greet tanpa secara eksplisit meneruskan 'name'
// Kompiler secara otomatis menggunakan nilai implicit 'myName'
println(greet) // Output: "Hello, Alice"Di Scala, traits mirip dengan interfaces di Java tetapi dengan kemampuan tambahan. Trait adalah komponen yang dapat digunakan kembali yang dapat dicampurkan (mixed in) ke dalam kelas atau trait lain. Trait memungkinkan Anda mendefinisikan metode abstrak dan metode konkret. Trait juga dapat menyimpan state, tidak seperti interface Java yang hanya dapat mendefinisikan tanda tangan metode.
Scala mendukung penggabungan banyak trait ke dalam satu kelas, memungkinkan multiple inheritance, sementara Java mengizinkan implementasi banyak interface tetapi hanya satu kelas, membatasi fleksibilitas pewarisan.
Berikut contoh:
trait Logger {
  def log(message: String): Unit = println(s"Log: $message")
}Scala REPL adalah shell interaktif yang memungkinkan Anda menulis dan mengevaluasi kode Scala secara real time. REPL bekerja dalam empat langkah:
Proses ini memungkinkan eksperimen dan pengujian kode Scala secara cepat, menjadikannya alat yang kuat untuk belajar, debugging, dan membuat prototipe di Scala. Anda dapat mendefinisikan variabel dan fungsi, serta menjelajah pustaka secara interaktif.
Gambar: Scala REPL adalah interpreter baris perintah yang dapat Anda gunakan untuk menguji kode Scala sebagai area bermain. Sumber: Scala docs
Bagi mereka yang mencari peran yang lebih senior atau ingin menunjukkan pemahaman Scala yang lebih mendalam, mari telusuri beberapa pertanyaan lanjutan yang membahas penanganan komputasi asinkron dan konkurensi, serta struktur dan konversi yang kompleks.
Pertanyaan-pertanyaan ini akan menilai keahlian Anda dalam pemrograman fungsional, konkurensi, dan desain sistem yang skalabel.
Di Scala, Future dan Await sama-sama terkait dengan penanganan komputasi asinkron tetapi memiliki tujuan yang berbeda.
Future merepresentasikan komputasi yang pada akhirnya akan selesai dengan hasil atau exception. Ini memungkinkan tugas lain terus berjalan sambil menunggu hasil komputasi. Await digunakan untuk memblokir thread saat ini hingga hasil Future tersedia. Ini memaksa thread menunggu penyelesaian Future. Sering digunakan ketika Anda perlu menyinkronkan dan menunggu hasil dalam konteks non-asinkron.Berikut saya tunjukkan beberapa contoh cara menggunakan fungsionalitas ini:
import scala.concurrent.Future
import scala.concurrent.ExecutionContext.Implicits.global
import scala.concurrent.Await
import scala.concurrent.duration._

val futureValue = Future { 42 } // Future yang menghitung nilai 42 secara asinkron.
val result = Await.result(futureValue, 2.seconds) // Memblokir thread hingga 2 detik, menunggu hasil Future.Scala menangani konkurensi menggunakan mekanisme tingkat rendah seperti thread dan abstraksi tingkat tinggi seperti Futures dan Promises untuk pemrograman asinkron.
Pustaka standar mencakup scala.concurrent.Future, yang memungkinkan komputasi non-blocking, dan ExecutionContext untuk mengelola thread eksekusi.
Untuk konkurensi yang lebih lanjut, Akka banyak digunakan, menyediakan alat untuk membangun sistem yang sangat konkuren dan terdistribusi menggunakan model Aktor. Selain itu, pustaka seperti Cats Effect dan ZIO menawarkan pendekatan pemrograman fungsional untuk menangani konkurensi, menyediakan abstraksi yang aman dan dapat dikomposisi untuk mengelola efek samping, tugas asinkron, dan sumber daya.
Monad adalah pola desain yang digunakan untuk menangani komputasi secara terstruktur, terutama saat berhadapan dengan efek samping seperti operasi asinkron atau nilai nullable. Monad menyediakan cara untuk membungkus nilai dan menerapkan transformasi sambil mempertahankan strukturnya. Di Scala, Option dan Future adalah contoh monad.
val result = Some(5).flatMap(x => Some(x * 2))Framework Akka di Scala dirancang untuk menyederhanakan pembangunan sistem yang terdistribusi, konkuren, dan toleran kesalahan. Akka menggunakan model Aktor, di mana setiap aktor adalah unit ringan dan independen yang berkomunikasi secara asinkron melalui pengiriman pesan.
Akka mengabstraksi detail konkurensi tingkat rendah, memungkinkan developer fokus pada logika bisnis. Akka mendukung sistem terdistribusi dengan memungkinkan aktor berjalan di node yang berbeda. Modul Cluster Akka memfasilitasi komunikasi yang mulus, load balancing, dan ketahanan, sehingga ideal untuk sistem yang skalabel dan sangat tersedia.
Di Scala, implicit conversion memungkinkan transformasi otomatis dari satu tipe ke tipe lain. Konversi ini didefinisikan menggunakan keyword implicit dan digunakan untuk memungkinkan operasi antar tipe yang biasanya tidak kompatibel. Kompiler menerapkan implicit conversion bila diperlukan, mengurangi kode boilerplate.
Sebagai contoh, saya tunjukkan cara mengonversi String ke Int secara otomatis saat melakukan operasi aritmetika:
implicit def intToString(x: Int): String = x.toString
val str: String = 42 // Secara implisit dikonversi menjadi “42”Di Scala, varians tipe mengacu pada bagaimana subtipe dari tipe generik saling berhubungan. Ini dikendalikan menggunakan parameter tipe kovarian (+), kontravarian (-), dan invarians (=).
List[+A] berarti List bertipe A dapat digunakan di mana pun List dari supertipe A diharapkan. Contoh: List[Dog] dapat digunakan sebagai List[Animal] jika Dog menurunkan Animal.Function1[-A, +B] berarti Function1 dapat menerima supertipe dari A dan mengembalikan subtipe dari B. Contoh: Function1[Animal, Dog] dapat digunakan sebagai Function1[Dog, Dog].List[A] adalah invarian, artinya List[Dog] dan List[Animal] tidak dapat dipertukarkan.Jika Anda mengikuti wawancara untuk peran data engineering, harapkan pertanyaan yang menilai kemampuan Anda mendesain, mengoptimalkan, dan memecahkan masalah aplikasi Scala di lingkungan produksi. Mari telusuri beberapa pertanyaan wawancara khas yang mungkin Anda temui.
Untuk mendefinisikan anotasi kustom di Scala, Anda perlu membuat kelas yang menurunkan scala.annotation.Annotation. Kelas ini menerima parameter konstruktor untuk menyimpan metadata. Anotasi kemudian diterapkan pada kelas, metode, atau field dengan @symbol.
Satu fitur anotasi yang saya anggap berguna adalah anotasi kustom dapat diakses saat runtime menggunakan refleksi untuk mengambil metadatanya, biasanya melalui getAnnotations atau metode serupa.
import scala.annotation.StaticAnnotation
class MyAnnotation extends StaticAnnotation
@MyAnnotation class MyClassScala adalah bahasa native untuk Apache Spark, menyediakan integrasi yang mulus dan performa tinggi.
Bahasa ini digunakan untuk menulis job pemrosesan data terdistribusi, memanfaatkan fitur inti Spark seperti RDD (Resilient Distributed Datasets), DataFrame, dan Dataset. Dengan Scala, Anda dapat membuat dan memanipulasi set data besar, menerapkan transformasi, dan mengeksekusi operasi kompleks secara efisien di seluruh klaster.
API Scala Spark menawarkan sintaks yang ringkas dan ekspresif untuk menangani tugas big data, mulai dari pemrosesan batch hingga pipeline machine learning, memungkinkan analisis dan pemrosesan data skala besar secara paralel.
Anda mungkin juga tertarik mempelajari PySpark dari awal— panduan lengkap PySpark ini adalah tempat yang tepat untuk memulai.
Di Spark, RDD (Resilient Distributed Datasets) adalah abstraksi tingkat rendah, merepresentasikan data terdistribusi yang dapat dioperasikan secara paralel. DataFrame adalah abstraksi tingkat lebih tinggi yang dibangun di atas RDD, menawarkan penanganan data terstruktur dengan eksekusi yang dioptimalkan menggunakan optimizer Catalyst Spark.
Dataset menggabungkan keunggulan RDD dan DataFrame, menawarkan type-safety seperti RDD sekaligus menyediakan optimasi seperti DataFrame. Dataset strongly-typed, sementara DataFrame untyped, sehingga memungkinkan transformasi dan action yang lebih efisien di Spark.
Job Spark dasar dalam Scala melibatkan:
SparkSession.Berikut contohnya:
// Impor kelas SparkSession yang merupakan entry point untuk Spark SQL
import org.apache.spark.sql.SparkSession

// Membuat SparkSession.
val spark = SparkSession.builder.appName("MySparkApp").getOrCreate()

// Membaca berkas teks input sebagai DataFrame.
val data = spark.read.text("data.txt")

// Melakukan transformasi pada berkas teks
val wordCount = textFile.flatMap(_.split(" ")).groupByKey(identity).count()
wordCount.show()Transformasi di Spark adalah operasi yang mendefinisikan RDD, DataFrame, atau Dataset baru, seperti map(), filter(), atau groupBy(). Transformasi dievaluasi secara malas (lazy), artinya tidak dieksekusi sampai sebuah action dipicu.
Action adalah operasi yang memicu eksekusi, seperti collect(), count(), atau save(). Transformasi diterapkan ke data secara lazy, sementara action memaksa Spark menjalankan DAG operasi dan mengembalikan hasil atau menyimpan data.
Lazy evaluation di Spark berarti transformasi tidak dieksekusi segera. Sebagai gantinya, Spark membangun rencana eksekusi (DAG) dan hanya menjalankan komputasi ketika sebuah action dipanggil. Ini memungkinkan Spark mengoptimalkan eksekusi dengan meminimalkan data shuffling, menggabungkan operasi, dan menerapkan filter lebih awal dalam pipeline pemrosesan.
Mengoptimalkan job Spark melibatkan beberapa strategi, seperti meminimalkan data shuffling, melakukan caching hasil antara, dan menggunakan partisi yang sesuai.
Beberapa strategi yang saya rekomendasikan untuk mengoptimalkan job Spark adalah:
groupBy).Tantangan umum dalam Scala untuk proyek big data meliputi pengelolaan memori dan performa untuk dataset besar, menangani data skew, dan secara efisien menangani kesalahan di lingkungan terdistribusi.
Debugging job Spark bisa jadi rumit karena kompleksitas sistem terdistribusi dan lazy evaluation. Selain itu, mengoptimalkan job Spark untuk menghindari bottleneck dan mengurangi overhead sering kali memerlukan penyesuaian konfigurasi yang cermat dan pemahaman tentang rencana eksekusi yang mendasari.
Selain itu, menangani format data yang tidak konsisten, masalah kualitas data, dan kompleksitas penulisan serta pemeliharaan kode yang skalabel bisa menjadi tantangan dalam skenario big data.
Dalam artikel ini, kami telah membahas beragam pertanyaan wawancara Scala yang mencakup topik dasar, menengah, dan lanjutan. Mulai dari memahami konsep inti dan keunggulan Scala hingga menyelami optimalisasi, penanganan, dan konversi yang lebih kompleks, kami telah mengeksplorasi area kunci yang mungkin ditanyakan oleh calon pemberi kerja.
Untuk memantapkan persiapan Anda, mulai berlatih dengan kursus Introduction to Scala kami atau lakukan penyegaran singkat! Sedang bersiap untuk peran gabungan Java-Scala? Jangan lewatkan panduan pertanyaan wawancara Java kami untuk perspektif yang lengkap.
Pelajari lebih lanjut tentang Scala dan data engineering dengan kursus-kursus ini!
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt




