

Cursus
Databaseontwerp
4 uur
131.8K
Oefen en volg je voortgang.
Ga Verder Met GoogleIn onze data-gedreven wereld staan we voor een grote uitdaging: hoe slaan we data efficiënt op, beheren we die en halen we er betekenisvolle inzichten uit? Databases bieden een oplossing: gestructureerde opslagplaatsen om informatie te organiseren en toegankelijk te maken.
Toch zijn er, om te voldoen aan de specifieke eisen van verschillende datastructuren en use-cases, uiteenlopende soorten databases ontstaan.
In dit artikel bekijken we de vier belangrijkste typen die je in de datawereld tegenkomt: relationele databases, NoSQL-databases, clouddatabases en vectordatabases.
Wil je meer leren over databaseontwerp? Bekijk dan deze cursus over Database Design.
Databases zijn onmisbare hulpmiddelen in de digitale wereld. Het zijn georganiseerde verzamelingen data die opslag, opvraging, beheer en bewerking van informatie mogelijk maken.
In de kern zijn databases ontworpen om data in een gestructureerd formaat vast te houden, zodat gebruikers en applicaties informatie efficiënt kunnen benaderen en bijwerken wanneer dat nodig is.
Het belang van databases strekt zich uit over vrijwel alle domeinen, maar is vooral cruciaal in data science. Data science-projecten draaien vaak om het analyseren van grote hoeveelheden data om inzichten te verkrijgen, voorspellingen te doen of besluitvorming te ondersteunen.
Zonder databases zou het beheren van deze data—zeker naarmate die in omvang en complexiteit toeneemt—log en foutgevoelig zijn. Databases bieden een systematische manier om data op te slaan en waarborgen de integriteit, veiligheid en toegankelijkheid ervan.
Denk bijvoorbeeld aan een retailbedrijf dat verkoop, klantinteracties, voorraad en leveranciersinformatie bijhoudt. Een database vormt de ruggengraat van de bedrijfsvoering, waardoor het bedrijf trends kan analyseren, vraag kan voorspellen, voorraden kan optimaliseren en de klantervaring kan verbeteren.
Zonder database zou het bedrijf moeite hebben om de enorme hoeveelheid data die dagelijks wordt gegenereerd te verwerken, laat staan deze data te gebruiken voor gefundeerde zakelijke beslissingen.
De verschillende soorten databases weerspiegelen de uiteenlopende behoeften van use-cases en de complexiteit van de data die ze verwerken. Ze zijn ontwikkeld om prestaties te optimaliseren, functionaliteit te verbeteren en specifieke toepassingen te ondersteunen.
Die variëteit is niet alleen een gevolg van technologische overvloed, maar ook een noodzaak om in te spelen op de unieke uitdagingen en vereisten die in verschillende use-cases ontstaan. De behoefte aan verschillende databasetypen komt voort uit verschillen in datastructuren, toegangspatronen, schaalbaarheidseisen en consistentievereisten.
Zo vertrouwen traditionele bedrijfsapplicaties vaak op gestructureerde data die goed in tabellen met vooraf gedefinieerde schema's past, waardoor relationele databases een logische keuze zijn.
Maar met de opkomst van big data, sociale netwerken en realtime-analyse werden de beperkingen van relationele databases duidelijk bij het verwerken van ongestructureerde data, horizontaal schalen of omgaan met sterk verbonden data.
Dit leidde tot de opkomst van NoSQL-databases, ontworpen om flexibiliteit, schaalbaarheid en prestatievoordelen te bieden voor bepaalde soorten data die niet in het rigide stramien van traditionele databases passen. Wil je meer weten over hoe SQL- en NoSQL-databases zich tot elkaar verhouden? Lees dan deze tutorial over SQL vs NoSQL Databases.
Evenzo maakte de opkomst van IoT en tijdkritische toepassingen de ontwikkeling noodzakelijk van tijdreeksdatabases, geoptimaliseerd voor het efficiënt verwerken van temporele data. Leer meer in deze uitgebreide blog over time series databases.
Clouddatabases zijn ook in opkomst, omdat ze schaalbaarheid en toegankelijkheid bieden door data op externe servers te hosten.
Daarnaast zijn vectordatabases ontwikkeld voor de specifieke behoeften van machinelearning-toepassingen, met efficiënte opslag en bevraging van hoog-dimensionale vectoren.
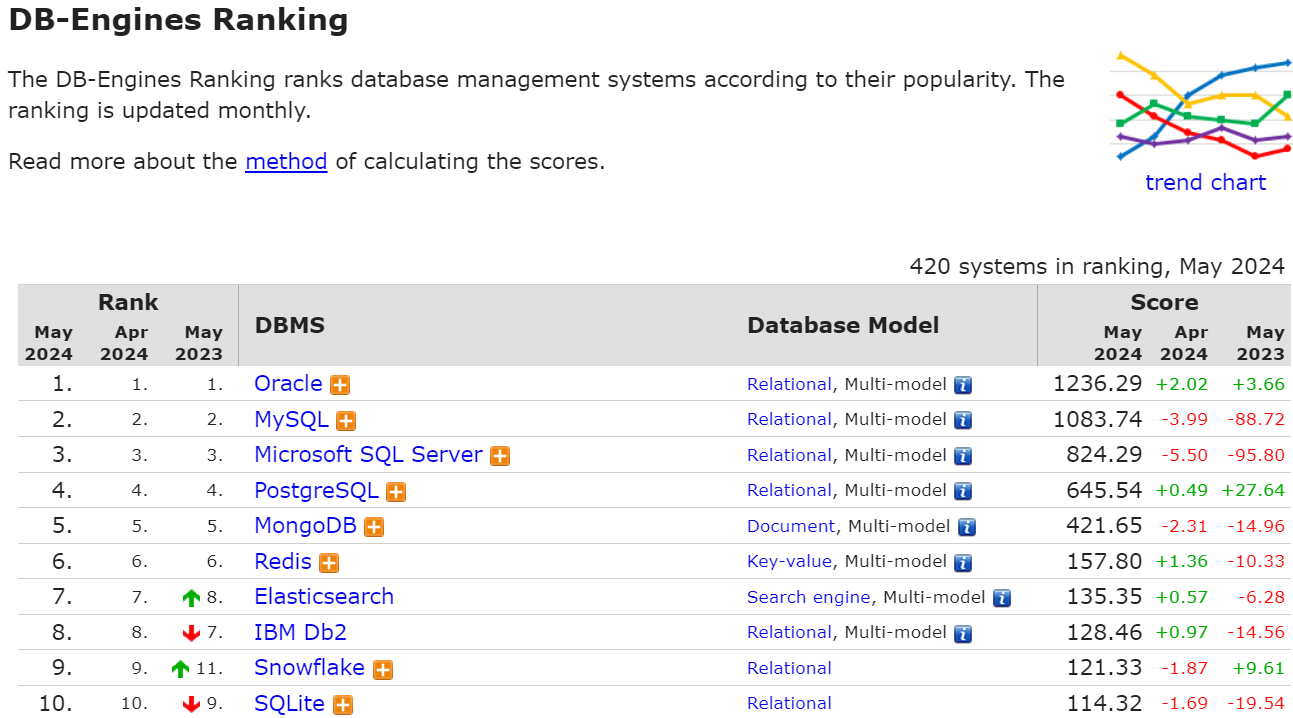
De DB-Engines Ranking van mei 2024 vermeldt de populairste databasebeheersystemen (DBMS). Deze ranglijst wordt maandelijks bijgewerkt en omvat 420 systemen. In mei 2024 zijn de top vier databases allemaal relationeel: Oracle, MySQL, Microsoft SQL en PostgreSQL.
Bron: db-engines
Opvallend is dat NoSQL-databases zoals MongoDB en Redis ook sterke posities innemen in de ranglijst. Dit weerspiegelt de groeiende vraag naar flexibele en schaalbare oplossingen die ongestructureerde data en high-traffic-applicaties aankunnen. Deze NoSQL-systemen laten een aanzienlijke jaar-op-jaar groei zien, wat wijst op een verschuiving naar meer diverse databasearchitecturen.
De ranglijst laat ook de stijgende populariteit zien van cloudgebaseerde databases zoals Snowflake, dat een volledig beheerde, schaalbare datawarehouse-oplossing biedt. Elasticsearch, een krachtige zoek- en analyticsplatform, is eveneens gestegen in de ranglijsten, wat het belang van zoek- en analysecapaciteiten in moderne datamanagement onderstreept.
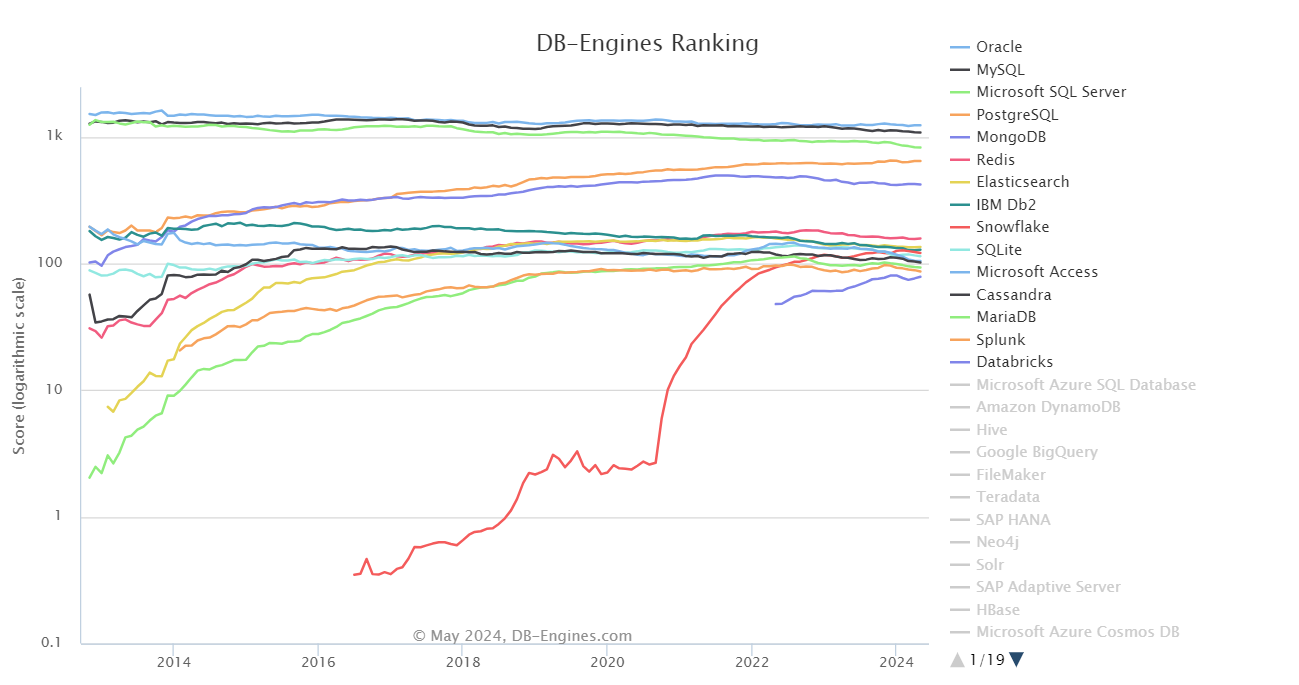
Laten we nu kijken naar de lijngrafiek hieronder, die het dynamische landschap van databasepopulariteit van 2014 tot 2024 laat zien.
Bron: db-engines
Een belangrijke conclusie is de blijvende dominantie van relationele databasebeheersystemen (RDBMS) zoals Oracle, MySQL, Microsoft SQL Server en PostgreSQL. Zij behielden het hele decennium consequent hun topposities, wat hun belang aantoont bij het verwerken van gestructureerde data en het ondersteunen van complexe queries in uiteenlopende toepassingen.
De grafiek laat echter ook een verschuiving zien in recente jaren. Terwijl RDBMS-systemen geleidelijk iets in populariteit dalen, hebben NoSQL-databases zoals MongoDB en Redis een sterke groei doorgemaakt. Deze stijgende lijn weerspiegelt de toenemende adoptie van flexibele en schaalbare oplossingen voor ongestructureerde data en drukbezochte applicaties.
Een andere interessante trend is de opkomst van cloudgebaseerde databases. Databricks, een cloudplatform voor data-engineering en machine learning, is enorm in populariteit toegenomen en laat de groeiende vraag zien naar cloudoplossingen die schaalbaarheid, gebruiksgemak en krachtige analytics bieden.
Evenzo heeft Snowflake, een volledig beheerd cloud data warehouse, sterke groei laten zien, wat de aantrekkingskracht van de schaalbare en gebruiksvriendelijke architectuur benadrukt.
Relationele databases slaan data op in tabellen met rijen en kolommen. Elke rij staat voor een uniek record, en elke kolom voor een specifiek attribuut van dat record.
Je kunt ze zien als zorgvuldig georganiseerde spreadsheets, waarin data wordt opgeslagen in tabellen met rijen (records) en kolommen (attributen). Elke rij vertegenwoordigt een aparte entiteit, zoals een klant of een product, terwijl elke kolom een specifiek kenmerk vastlegt, zoals naam, adres of prijs.
De echte kracht van relationele databases zit in het koppelen van deze tabellen via relaties. Deze relaties, gelegd met foreign keys, stellen ons in staat data uit verschillende tabellen te verbinden en zo een samenhangend geheel te vormen.
In een CRM-systeem kan bijvoorbeeld een klantentabel gekoppeld zijn aan een bestellingentabel, zodat je de aankoopgeschiedenis van een klant kunt bijhouden.
Om met relationele databases te werken, gebruiken we Structured Query Language (SQL). Deze krachtige taal maakt het mogelijk om data te bevragen, in te voegen, te updaten en te verwijderen, en ook om complexe bewerkingen uit te voeren zoals het joinen van data uit meerdere tabellen. Door de gestructureerde aard van SQL wordt dataintegriteit en consistentie gewaarborgd via de ACID-eigenschappen:
Wil je meer leren over SQL? Bekijk dan deze skill track met zeven cursussen: SQL Fundamentals.
Relationele databases zijn ideaal wanneer je behoefte hebt aan:
Maar ze zijn mogelijk minder geschikt voor:
Enkele populaire RDBMS-opties zijn:
Wil je leren hoe je relationele databases met Python gebruikt? Bekijk dan deze gratis cursus: Introduction to Databases in Python.
NoSQL-databases, kort voor "not only SQL", zijn uitgegroeid tot een krachtig alternatief voor relationele databases, vooral in situaties waarin flexibiliteit, schaalbaarheid en hoge performance doorslaggevend zijn.
In tegenstelling tot relationele varianten kunnen NoSQL-databases ongestructureerde of semi-gestructureerde data aan zonder de beperkingen van een vast schema. Je kunt data opslaan in verschillende formaten, zoals JSON-documenten, key-value-paren of graafstructuren, zonder vooraf een rigide structuur te hoeven definiëren.
Deze databases bieden vaak mogelijkheden om uit te schalen over meerdere servers en clusters, waardoor ze geschikt zijn voor gedistribueerde data-omgevingen.
In tegenstelling tot relationele databases, die Structured Query Language (SQL) gebruiken, hebben NoSQL-databases geen universele querytaal. Elk type NoSQL-database heeft doorgaans een eigen querytaal of API die is afgestemd op het specifieke datamodel en de structuur.
Hoewel NoSQL-databases prioriteit geven aan flexibiliteit en schaalbaarheid, laten ze vaak enkele ACID-eigenschappen van relationele databases los. Zo geven sommige NoSQL-systemen de voorkeur aan eventual consistency boven onmiddellijke consistentie, wat betekent dat wijzigingen niet direct op alle nodes zichtbaar zijn. Deze trade-off levert betere performance en schaalbaarheid op, maar vraagt om zorgvuldige afweging bij het ontwerpen van applicaties die strikte dataconsistentie vereisen.
Wil je leren hoe je NoSQL-databases bevraagt? Bekijk dan deze cursus: Introduction to NoSQL.
NoSQL-databases zijn vooral geschikt wanneer:
Veelvoorkomende use-cases zijn:
Hoewel ze aanzienlijke voordelen bieden, zijn NoSQL-databases misschien minder geschikt voor applicaties die sterke transactiegaranties of complexe relationele queries vereisen. Veel organisaties kiezen voor een hybride aanpak en gebruiken zowel relationele als NoSQL-databases om de respectieve sterke punten te benutten.
Enkele van de populairste NoSQL-databases zijn:
Wil je meer leren over de vier belangrijkste NoSQL-databases? Bekijk dan deze cursus: NoSQL Concepts.
Clouddatabases hebben databeheer vernieuwd door gebruik te maken van de enorme middelen en schaalbaarheid van cloudplatforms. Deze databases draaien op externe servers en zijn via internet toegankelijk, waardoor organisaties niet hoeven te investeren in en te zorgen voor eigen hardware en infrastructuur.
Clouddatabases werken met een pay-as-you-go-model, waarbij je alleen betaalt voor de resources die je daadwerkelijk gebruikt. Dit elimineert de initiële kosten en het doorlopende onderhoud van traditionele on-premises databases. Cloudproviders verzorgen de onderliggende infrastructuur, inclusief servers, opslag en netwerk, terwijl jij je kunt richten op het bouwen en beheren van je applicaties.
Wil je meer leren over cloud computing? Bekijk dan deze cursus: Understanding Cloud Computing.
Het bevragen van clouddatabases gebeurt doorgaans met dezelfde tools en talen als bij on-premises databases. Voor relationele databases in de cloud gebruik je SQL om met data te werken. NoSQL-databases in de cloud hebben meestal hun eigen querytalen of API's, vergelijkbaar met hun on-premises tegenhangers.
Cloudproviders bieden vaak extra tools en services om databasebeheer en -bevraging te vereenvoudigen. Denk aan webconsoles, commandline-tools en SDK's voor diverse programmeertalen.
Clouddatabases zijn een uitstekende keuze wanneer:
De grote cloudproviders bieden een reeks databaseservices, elk met eigen sterke punten en specialisaties:
Meer leren over clouddatabases? Bekijk deze cursus: AWS Cloud Technology and Services.
Vectordatabases zijn opgekomen als een gespecialiseerd hulpmiddel voor de specifieke eisen van toepassingen in kunstmatige intelligentie en machine learning.
Vectordatabases zijn ontworpen om vector-embeddings op te slaan, te indexeren en te beheren: hoog-dimensionale datarepresentaties die vaak in machinelearningmodellen worden gebruikt. Dit maakt efficiënte gelijkeniszoektochten mogelijk, waarbij de database snel vectoren kan vinden die "dicht bij" een gegeven queryvector liggen op basis van afstandsmaatstaven zoals cosinussimilariteit of Euclidische afstand.
Deze eigenschappen maken ze geschikt voor toepassingen zoals beeldherkenning, aanbevelingssystemen en natural language processing. Ze gebruiken indexstructuren die het ophalen van vergelijkbare vectoren optimaliseren op basis van afstandsmaatstaven.
Wil je meer leren over vectordatabases? Lees dan dit artikel: An Introduction to Vector Databases for Machine Learning.
Het bevragen van een vectordatabase bestaat meestal uit de volgende stappen:
Verschillende vectordatabases bieden uiteenlopende queryopties en parameters, zoals het aantal dichtstbijzijnde buren dat moet worden geretourneerd of het instellen van een afstandsdrempel. Sommige databases ondersteunen ook filtering op basis van metadata of het combineren van vectorsearch met traditionele scalare filtering.
Vectordatabases zijn vooral geschikt wanneer:
Wil je meer weten over populaire databases? Lees dan dit artikel: Top 5 Best Vector Databases.
Hoewel relationele, NoSQL-, cloud- en vectordatabases veel use-cases dekken, bestaan er nog diverse andere databasetypen, elk afgestemd op specifieke datamodellen en toegangspatronen. Laten we kort enkele van deze gespecialiseerde oplossingen verkennen.
Tijdreeksdatabases zijn geoptimaliseerd voor het opslaan en analyseren van data met tijdstempels, zoals sensorwaarden, aandelenkoersen of serverlogs. Ze blinken uit in het verwerken van hoge invoersnelheden en het efficiënt bevragen van datapunten op basis van tijdsintervallen. Populaire opties zijn InfluxDB, TimescaleDB en Prometheus.
Objectgeoriënteerde databases (OODB's) slaan data op als objecten, vergelijkbaar met objectgeoriënteerd programmeren. Dit kan het modelleren van complexe datastructuren en relaties vereenvoudigen. OODB's kennen echter geen brede adoptie door uitdagingen rond standaardisatie en query-optimalisatie. Populaire opties zijn ObjectDB en Versant Object Database.
Graafdatabases blinken uit in het representeren en bevragen van relaties tussen entiteiten. Ze slaan data op als nodes (entiteiten) en edges (relaties), en zijn daarmee zeer geschikt voor sociale netwerken, aanbevelingssystemen, fraudedetectie en knowledge graphs. Populaire opties zijn Neo4j, Amazon Neptune en JanusGraph.
Hiërarchische databases organiseren data in een boomstructuur, met ouder-kindrelaties tussen records. Deze structuur is geschikt voor sommige gespecialiseerde toepassingen, maar kan inflexibel zijn voor complexe datamodellen. Hoewel historisch belangrijk, komen hiërarchische databases in moderne applicaties minder vaak voor.
Netwerkdatabases lijken op hiërarchische databases, maar staan complexere relaties tussen records toe. Ze bieden flexibiliteit, maar kunnen lastiger te beheren en te bevragen zijn. In de meeste toepassingen zijn netwerkdatabases grotendeels vervangen door relationele en graafdatabases.
In dit overzicht hebben we het diverse landschap van databases verkend, waarbij elk type is afgestemd op specifieke data-uitdagingen. Van gestructureerde data in relationele databases tot de flexibiliteit van NoSQL, de schaalbaarheid van cloudoplossingen en de gespecialiseerde mogelijkheden van vectordatabases: we hebben gezien hoe deze tools de moderne datawereld ondersteunen.
De juiste database kiezen is een cruciale beslissing die afhangt van het begrijpen van de unieke sterke punten en trade-offs van elk type. Door je specifieke behoeften en beperkingen zorgvuldig te beoordelen, kun je de database selecteren die jouw data-gedreven applicaties en initiatieven het beste ondersteunt.
Wil je dieper in databases duiken? Probeer dan deze skill track met vier cursussen: SQL for Database Administrators.
Leer meer over databases!
Cursus
Leerpad
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

