
Kurs
Datenbankdesign
4 Std.
129.9K
In der heutigen datengetriebenen Welt stehen wir vor einer zentralen Herausforderung: Wie speichern, verwalten und gewinnen wir aus Daten effizient aussagekräftige Erkenntnisse? Datenbanken liefern die Antwort. Sie bieten strukturierte Ablagen, um Informationen zu organisieren und zugänglich zu machen.
Um den unterschiedlichen Anforderungen verschiedener Datenstrukturen und Anwendungsfälle gerecht zu werden, haben sich verschiedene Datenbanktypen entwickelt.
In diesem Artikel schauen wir uns die vier Haupttypen an, die dir in der Data-Science-Praxis begegnen: relationale Datenbanken, NoSQL-Datenbanken, Cloud-Datenbanken und Vektordatenbanken.
Wenn du mehr über Datenbankdesign lernen möchtest, schau dir diesen Kurs zu Database Design an.
Datenbanken sind unverzichtbare Werkzeuge der digitalen Welt. Sie sind organisierte Datensammlungen, die das Speichern, Abrufen, Verwalten und Verändern von Informationen erleichtern.
Im Kern sind Datenbanken darauf ausgelegt, Daten in einem strukturierten Format zu halten, sodass Nutzende und Anwendungen Informationen effizient abrufen und bei Bedarf aktualisieren können.
Ihre Bedeutung reicht in nahezu alle Bereiche, ist aber besonders in der Data Science kritisch. Data-Science-Projekte analysieren oft große Datenmengen, um Erkenntnisse zu gewinnen, Prognosen zu erstellen oder Entscheidungen zu untermauern.
Ohne Datenbanken wäre das Management dieser Daten — insbesondere bei wachsender Größe und Komplexität — mühsam und fehleranfällig. Datenbanken bieten eine systematische Art der Datenspeicherung und sorgen für Integrität, Sicherheit und Verfügbarkeit.
Stell dir etwa ein Handelsunternehmen vor, das Verkäufe, Kundeninteraktionen, Bestände und Lieferantendaten nachverfolgt. Eine Datenbank ist das Rückgrat der gesamten Operation: Sie ermöglicht Trendanalysen, Absatzprognosen, Bestandsoptimierung und bessere Kundenerlebnisse.
Ohne Datenbank hätte das Unternehmen große Mühe, die täglich anfallenden Datenmengen zu bewältigen und daraus fundierte Geschäftsentscheidungen abzuleiten.
Die verschiedenen Datenbanktypen spiegeln die unterschiedlichen Anforderungen von Use Cases und die Komplexität der verarbeiteten Daten wider. Sie werden entwickelt, um Leistung zu optimieren, Funktionen zu erweitern und spezifische Einsatzszenarien abzudecken.
Diese Vielfalt ist nicht nur technischer Überfluss, sondern notwendig, um die jeweils speziellen Herausforderungen und Anforderungen verschiedener Anwendungsfälle zu adressieren. Der Bedarf an unterschiedlichen Datenbanken ergibt sich aus Unterschieden bei Datenstrukturen, Zugriffsmustern, Skalierungsanforderungen und Konsistenzmodellen.
Klassische Geschäftsanwendungen arbeiten oft mit stark strukturierten Daten, die sich gut in Tabellen mit vordefinierten Schemata abbilden lassen — ein ideales Feld für relationale Datenbanken.
Mit dem Aufkommen von Big Data, sozialen Netzwerken und Echtzeitanalysen traten jedoch die Grenzen relationaler Systeme zutage, etwa beim Umgang mit unstrukturierten Daten, beim horizontalen Skalieren oder bei hochgradig vernetzten Daten.
So entstanden NoSQL-Datenbanken, die Flexibilität, Skalierbarkeit und Performance für Datentypen bieten, die nicht in das starre Korsett traditioneller Strukturen passen. Wenn du wissen willst, wie sich SQL und NoSQL unterscheiden, lies dieses Tutorial: SQL vs NoSQL Databases.
Ähnlich führten IoT und zeitkritische Anwendungen zur Entwicklung von Zeitreihendatenbanken, die auf zeitbezogene Daten optimiert sind. Mehr dazu im umfassenden Blog zu Time Series Databases.
Cloud-Datenbanken haben ebenfalls an Bedeutung gewonnen. Sie werden auf entfernten Servern betrieben und bieten dadurch Skalierbarkeit und einfache Zugänglichkeit.
Außerdem sind Vektordatenbanken entstanden, die speziell auf die Anforderungen von Machine-Learning-Anwendungen zugeschnitten sind und hochdimensionale Vektoren effizient speichern und abfragen.
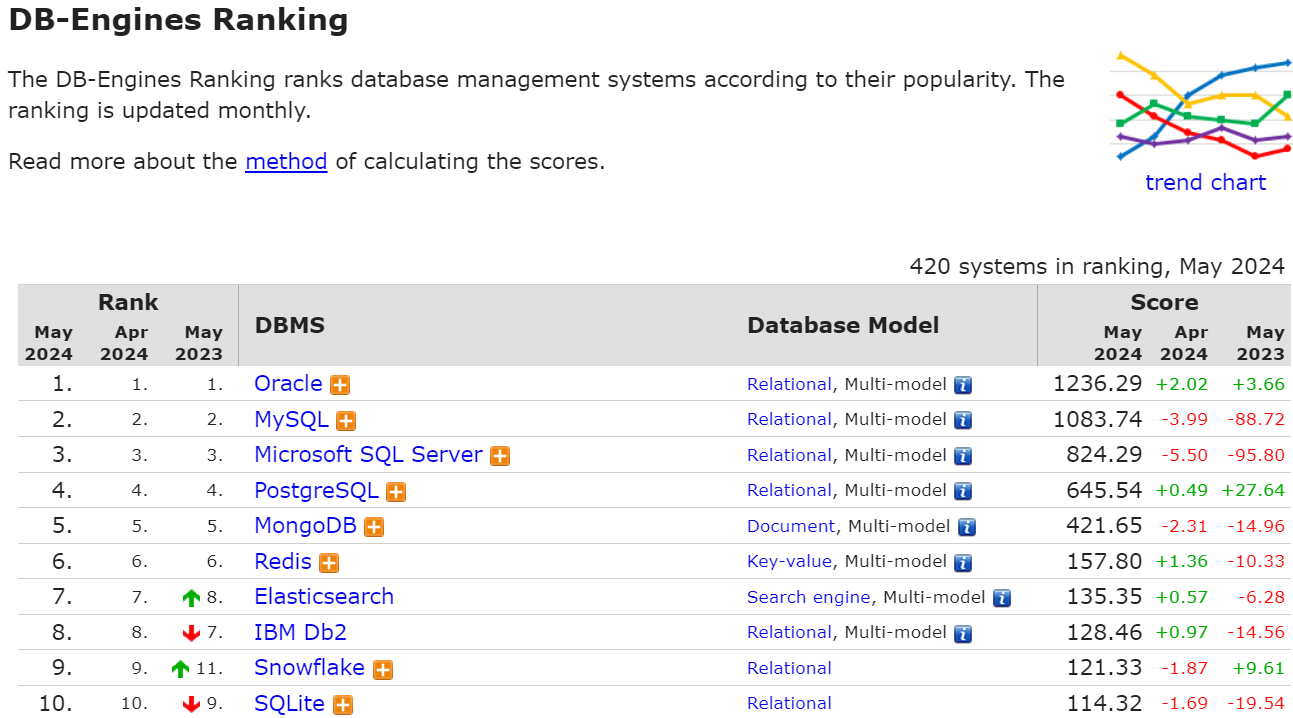
Das DB-Engines-Ranking für Mai 2024 listet die beliebtesten Datenbankmanagementsysteme (DBMS). Die Rangliste wird monatlich aktualisiert und umfasst 420 Systeme. Im Mai 2024 sind die vier führenden Systeme allesamt relational: Oracle, MySQL, Microsoft SQL und PostgreSQL.
Quelle: db-engines
Bemerkenswert ist, dass NoSQL-Datenbanken wie MongoDB und Redis ebenfalls starke Platzierungen halten. Das spiegelt die wachsende Nachfrage nach flexiblen, skalierbaren Lösungen wider, die unstrukturierte Daten und stark frequentierte Anwendungen bewältigen. Diese NoSQL-Systeme verzeichnen deutliche Jahreszuwächse — ein Hinweis auf vielfältigere Datenbankarchitekturen.
Das Ranking zeigt zudem den Aufstieg cloudbasierter Datenbanken wie Snowflake, das ein vollständig verwaltetes, skalierbares Data-Warehouse bietet. Auch Elasticsearch, eine leistungsstarke Such- und Analyseplattform, klettert in der Rangliste und unterstreicht die Bedeutung von Suche und Analytics im modernen Datenmanagement.
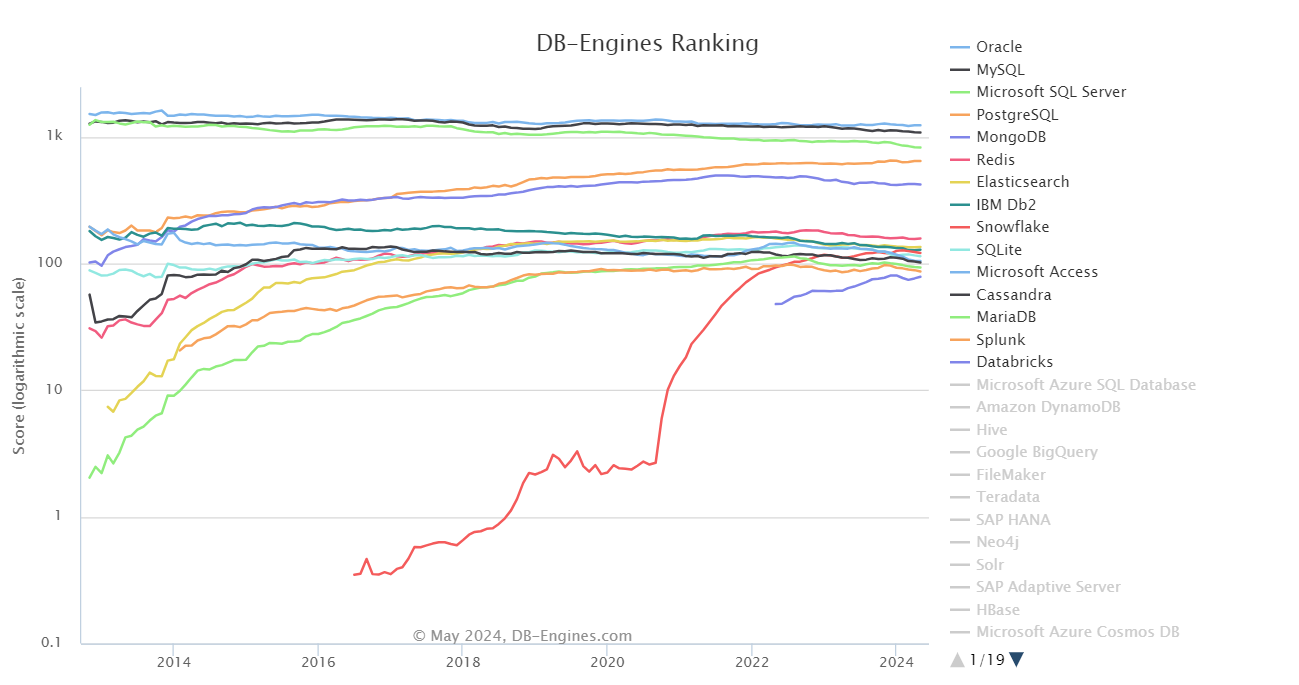
Schauen wir uns nun das Liniendiagramm unten an. Es zeigt die dynamische Entwicklung der Datenbank-Popularität von 2014 bis 2024.
Quelle: db-engines
Ein zentrales Fazit ist die anhaltende Dominanz relationaler Datenbankmanagementsysteme (RDBMS) wie Oracle, MySQL, Microsoft SQL Server und PostgreSQL. Sie behaupten seit Jahren die Spitzenplätze — ein Zeichen ihrer Stärke beim Umgang mit strukturierten Daten und komplexen Abfragen in vielfältigen Anwendungen.
Gleichzeitig zeigt die Kurve einen bemerkenswerten Wandel: Während RDBMS leicht an Popularität verlieren, legen NoSQL-Datenbanken wie MongoDB und Redis deutlich zu. Diese Entwicklung spiegelt die zunehmende Verbreitung flexibler, skalierbarer Lösungen für unstrukturierte Daten und hohes Traffic-Aufkommen wider.
Ebenfalls auffällig ist der Aufstieg cloudbasierter Plattformen. Databricks, eine Cloud-Plattform für Data Engineering und Machine Learning, gewinnt stark an Popularität und verdeutlicht die Nachfrage nach Cloud-Lösungen mit Skalierbarkeit, einfacher Bedienung und starken Analytics-Funktionen.
Auch Snowflake, ein vollständig verwaltetes Cloud-Data-Warehouse, wächst erheblich — die skalierbare, einfach nutzbare Architektur überzeugt.
Relationale Datenbanken speichern Daten in Tabellen mit Zeilen und Spalten. Jede Zeile steht für einen eindeutigen Datensatz, jede Spalte für ein bestimmtes Attribut dieses Datensatzes.
Du kannst sie dir wie akribisch organisierte Tabellenkalkulationen vorstellen: Tabellen bestehen aus Zeilen (Datensätze) und Spalten (Attribute). Jede Zeile repräsentiert eine Entität wie Kundin oder Produkt, jede Spalte eine Eigenschaft wie Name, Adresse oder Preis.
Ihre eigentliche Stärke liegt darin, Tabellen über Beziehungen zu verknüpfen. Diese Beziehungen werden über Fremdschlüssel hergestellt und verbinden Daten aus unterschiedlichen Tabellen zu einem konsistenten Gesamtbild.
In einem CRM-System kann zum Beispiel eine Kundentabelle mit einer Auftragstabelle verknüpft sein, um die Kaufhistorie eines Kunden nachzuverfolgen.
Zur Interaktion mit relationalen Datenbanken nutzen wir SQL (Structured Query Language). Diese mächtige Sprache ermöglicht Abfragen, Einfügen, Aktualisieren und Löschen von Daten sowie komplexe Operationen wie das Joinen mehrerer Tabellen. Die strukturierte Natur von SQL sichert Datenintegrität und -konsistenz über die ACID-Eigenschaften:
Wenn du mehr über SQL lernen möchtest, probiere diesen siebenteiligen Lernpfad: SQL Fundamentals.
Relationale Datenbanken sind ideal, wenn du brauchst:
Weniger geeignet sind sie für:
Zu den populären RDBMS zählen:
Wenn du lernen willst, wie du relationale Datenbanken mit Python nutzt, probiere diesen kostenlosen Kurs: Introduction to Databases in Python.
NoSQL ("not only SQL") hat sich als starke Alternative zu relationalen Datenbanken etabliert — besonders wenn Flexibilität, Skalierbarkeit und hohe Performance im Vordergrund stehen.
Im Gegensatz zu relationalen Systemen verarbeiten NoSQL-Datenbanken unstrukturierte oder semi-strukturierte Daten ohne starres Schema. Daten lassen sich in unterschiedlichen Formaten speichern, etwa als JSON-Dokumente, Key-Value-Paare oder Graphstrukturen — ohne das Schema vorab festzuzurren.
Häufig bieten sie Funktionen für das Skalieren über mehrere Server und Cluster und eignen sich damit für verteilte Datenumgebungen.
Anders als relationale Systeme mit SQL besitzen NoSQL-Datenbanken keine universelle Abfragesprache. Stattdessen hat jeder NoSQL-Typ eigene Sprachen oder APIs, die auf das jeweilige Datenmodell zugeschnitten sind.
NoSQL priorisiert Flexibilität und Skalierung und lockert dafür oft einige ACID-Eigenschaften. Manche Systeme setzen etwa auf eventual consistency statt sofortiger Konsistenz — Änderungen sind nicht auf allen Knoten unmittelbar sichtbar. Dieser Trade-off verbessert Leistung und Skalierbarkeit, erfordert aber durchdachtes Design, wenn strenge Konsistenz gefragt ist.
Wenn du lernen möchtest, wie man NoSQL abfragt, schau dir den Kurs Introduction to NoSQL an.
NoSQL spielt seine Stärken aus, wenn:
Typische Einsatzfelder:
Trotz ihrer Vorteile sind NoSQL-Datenbanken nicht ideal, wenn strikte Transaktionssicherheit oder komplexe relationale Abfragen nötig sind. Viele Unternehmen setzen daher auf hybride Architekturen und kombinieren relationale und NoSQL-Systeme.
Zu den bekanntesten NoSQL-Datenbanken gehören:
Wenn du mehr über die vier großen NoSQL-Typen wissen willst, sieh dir diesen Kurs an: NoSQL Concepts.
Cloud-Datenbanken haben das Datenmanagement durch die Ressourcen und Skalierbarkeit von Cloud-Plattformen revolutioniert. Sie laufen auf entfernten Servern und werden über das Internet genutzt — Unternehmen sparen so Investitionen und Betrieb eigener Hardware und Infrastruktur.
Cloud-Datenbanken folgen meist einem Pay-as-you-go-Modell: Du zahlst nur für Ressourcen, die du tatsächlich nutzt. Das senkt Anschaffungs- und Wartungskosten im Vergleich zu On-Premises-Lösungen. Der Cloud-Anbieter betreibt die Infrastruktur — Server, Storage, Netzwerk —, während du dich auf deine Anwendungen konzentrierst.
Wenn du Cloud Computing verstehen willst, starte mit diesem Kurs: Understanding Cloud Computing.
Die Abfrage von Cloud-Datenbanken erfolgt meist mit denselben Tools und Sprachen wie On-Premises. Für relationale Systeme nutzt du SQL; NoSQL-Services bieten, wie ihre On-Premises-Pendants, eigene Abfragesprachen oder APIs.
Cloud-Anbieter stellen zusätzlich Tools und Services bereit, die Betrieb und Abfragen vereinfachen — etwa Web-Konsolen, CLIs und SDKs für verschiedene Programmiersprachen.
Cloud-Datenbanken sind die richtige Wahl, wenn:
Die führenden Cloud-Anbieter decken ein breites Spektrum ab, jeweils mit eigenen Stärken:
Mehr zu Cloud-Datenbanken erfährst du in diesem Kurs: AWS Cloud Technology and Services.
Vektordatenbanken sind auf die besonderen Anforderungen von Künstlicher Intelligenz und Machine Learning zugeschnitten.
Sie speichern, indexieren und verwalten Vektorembeddings — hochdimensionale Repräsentationen, wie sie ML-Modelle verwenden. So ermöglichen sie effiziente Ähnlichkeitssuchen: Die Datenbank findet schnell Vektoren, die einem Abfragevektor nahe sind, gemessen mit Metriken wie Kosinus- oder euklidischer Distanz.
Damit eignen sie sich für Bilderkennung, Empfehlungssysteme und Natural Language Processing. Spezialisierte Indexstrukturen optimieren das Auffinden ähnlicher Vektoren anhand von Distanzmaßen.
Wenn du mehr über Vektordatenbanken lernen willst, lies diesen Artikel: An Introduction to Vector Databases for Machine Learning.
Eine typische Abfrage umfasst folgende Schritte:
Je nach System gibt es verschiedene Optionen, etwa die Anzahl der Nachbarn oder eine Distanzschwelle. Manche Datenbanken unterstützen Metadaten-Filter oder kombinieren Vektorsuche mit klassischen Filtern.
Besonders geeignet, wenn:
Wenn du wissen willst, welche Lösungen besonders verbreitet sind, lies diesen Artikel: Top 5 Best Vector Databases.
Neben relationalen, NoSQL-, Cloud- und Vektordatenbanken gibt es weitere Typen, die für spezielle Datenmodelle und Zugriffsmuster entwickelt wurden. Hier ein kurzer Überblick.
Zeitreihendatenbanken sind auf zeitgestempelte Daten wie Sensormessungen, Aktienkurse oder Server-Logs optimiert. Sie glänzen bei hoher Schreibrate und effizienten Abfragen über Zeiträume. Beliebte Optionen sind InfluxDB, TimescaleDB und Prometheus.
Objektorientierte Datenbanken (OODBs) speichern Daten als Objekte — analog zur objektorientierten Programmierung. Das vereinfacht die Abbildung komplexer Strukturen und Beziehungen. Wegen Standardisierungs- und Query-Herausforderungen sind OODBs jedoch weniger verbreitet. Bekannte Lösungen: ObjectDB und Versant Object Database.
Graphdatenbanken sind stark darin, Beziehungen zwischen Entitäten abzubilden und abzufragen. Daten werden als Knoten (Entitäten) und Kanten (Beziehungen) gespeichert. Ideal für soziale Netzwerke, Empfehlungssysteme, Betrugserkennung und Knowledge Graphs. Beliebte Optionen: Neo4j, Amazon Neptune, JanusGraph.
Hierarchische Datenbanken organisieren Daten baumartig mit Eltern-Kind-Beziehungen. Das passt für spezielle Anwendungen, ist aber bei komplexen Modellen unflexibel. Historisch bedeutsam, heute jedoch seltener.
Netzwerkdatenbanken ähneln hierarchischen Systemen, erlauben aber komplexere Beziehungen. Sie sind flexibel, jedoch in Verwaltung und Abfrage anspruchsvoller. In vielen Szenarien wurden sie durch relationale und Graphdatenbanken abgelöst.
In diesem Überblick hast du die vielfältige Welt der Datenbanken kennengelernt — von strukturierten Daten in relationalen Systemen über die Flexibilität von NoSQL und die Skalierbarkeit von Cloud-Lösungen bis zu den Spezialfähigkeiten von Vektordatenbanken. All diese Bausteine tragen das moderne Datenmanagement.
Die Wahl der passenden Datenbank ist eine zentrale Entscheidung. Sie hängt davon ab, die Stärken und Trade-offs der einzelnen Typen zu verstehen. Analysiere deine Anforderungen und Rahmenbedingungen sorgfältig — so findest du die Datenbank, die deine datengetriebenen Anwendungen am besten voranbringt.
Wenn du tiefer einsteigen willst, probiere diesen vierteiligen Lernpfad: SQL for Database Administrators.
Erfahre mehr über Datenbanken!
Kurs
Lernpfad
Kurs