

Khóa học
Thiết kế cơ sở dữ liệu
4 giờ
131.8K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleTrong thế giới vận hành bằng dữ liệu ngày nay, chúng ta đối mặt với một thách thức lớn: làm thế nào để lưu trữ, quản lý và rút ra những hiểu biết có ý nghĩa từ dữ liệu một cách hiệu quả? Cơ sở dữ liệu mang đến giải pháp, cung cấp kho lưu trữ có cấu trúc để tổ chức và truy cập thông tin.
Tuy nhiên, để đáp ứng những yêu cầu đặc thù của nhiều cấu trúc dữ liệu và trường hợp sử dụng, các loại cơ sở dữ liệu khác nhau đã ra đời.
Trong bài viết này, chúng ta sẽ khám phá bốn loại chính mà bạn sẽ gặp trong lĩnh vực khoa học dữ liệu: cơ sở dữ liệu quan hệ, cơ sở dữ liệu NoSQL, cơ sở dữ liệu đám mây và cơ sở dữ liệu vector.
Nếu bạn muốn tìm hiểu về thiết kế cơ sở dữ liệu, hãy xem khóa học Database Design.
Cơ sở dữ liệu là công cụ thiết yếu trong thế giới số. Chúng là tập hợp dữ liệu được tổ chức nhằm hỗ trợ lưu trữ, truy xuất, quản lý và thao tác với thông tin.
Cốt lõi của cơ sở dữ liệu là lưu dữ liệu theo định dạng có cấu trúc, cho phép người dùng và ứng dụng truy cập, cập nhật thông tin một cách hiệu quả khi cần.
Tầm quan trọng của cơ sở dữ liệu trải rộng trên hầu hết mọi lĩnh vực nhưng đặc biệt then chốt trong khoa học dữ liệu. Các dự án khoa học dữ liệu thường liên quan đến việc phân tích khối lượng lớn dữ liệu để rút ra insight, đưa ra dự đoán hoặc hỗ trợ ra quyết định.
Nếu không có cơ sở dữ liệu, việc quản lý dữ liệu—đặc biệt khi nó tăng về kích thước và độ phức tạp—sẽ cồng kềnh và dễ sai sót. Cơ sở dữ liệu cung cấp cách thức có hệ thống để lưu trữ dữ liệu và đảm bảo tính toàn vẹn, bảo mật, cũng như khả năng truy cập.
Hãy xem xét, chẳng hạn, một công ty bán lẻ theo dõi doanh số, tương tác khách hàng, hàng tồn kho và thông tin nhà cung cấp. Cơ sở dữ liệu đóng vai trò xương sống cho hoạt động của công ty, giúp họ phân tích xu hướng, dự báo nhu cầu, tối ưu mức tồn kho và nâng cao trải nghiệm khách hàng.
Không có cơ sở dữ liệu, công ty sẽ chật vật xử lý lượng dữ liệu khổng lồ phát sinh mỗi ngày, chứ chưa nói đến việc sử dụng dữ liệu đó để đưa ra quyết định kinh doanh có cơ sở.
Những loại cơ sở dữ liệu khác nhau phản ánh nhu cầu đa dạng của các trường hợp sử dụng và sự phức tạp của dữ liệu mà chúng xử lý. Các loại cơ sở dữ liệu khác nhau được phát triển để tối ưu hiệu năng, tăng cường chức năng và phục vụ các kịch bản cụ thể.
Sự đa dạng này không chỉ là do công nghệ phong phú mà còn là nhu cầu tất yếu nhằm giải quyết các thách thức và yêu cầu riêng biệt nảy sinh trong từng trường hợp sử dụng. Nhu cầu về các loại cơ sở dữ liệu khác nhau bắt nguồn từ khác biệt về cấu trúc dữ liệu, mẫu truy cập, yêu cầu mở rộng và yêu cầu về tính nhất quán.
Chẳng hạn, các ứng dụng kinh doanh truyền thống thường dựa vào dữ liệu có cấu trúc phù hợp với các bảng có lược đồ định sẵn, khiến cơ sở dữ liệu quan hệ trở thành lựa chọn lý tưởng.
Tuy nhiên, với sự trỗi dậy của dữ liệu lớn, mạng xã hội và phân tích theo thời gian thực, những hạn chế của cơ sở dữ liệu quan hệ trong việc xử lý dữ liệu phi cấu trúc, mở rộng theo chiều ngang hoặc quản lý dữ liệu có liên kết chặt chẽ đã bộc lộ rõ.
Điều này dẫn đến sự xuất hiện của cơ sở dữ liệu NoSQL, được thiết kế để mang lại tính linh hoạt, khả năng mở rộng và lợi thế về hiệu năng cho các loại dữ liệu không tuân theo cấu trúc cứng nhắc của cơ sở dữ liệu truyền thống. Nếu bạn muốn tìm hiểu thêm về cách so sánh giữa cơ sở dữ liệu SQL và NoSQL, hãy xem bài hướng dẫn SQL vs NoSQL Databases.
Tương tự, sự ra đời của IoT và các ứng dụng nhạy thời gian đòi hỏi phát triển cơ sở dữ liệu chuỗi thời gian được tối ưu để xử lý dữ liệu theo thời gian một cách hiệu quả. Tìm hiểu thêm trong bài blog tổng hợp về time series databases.
Cơ sở dữ liệu đám mây cũng ngày càng nổi bật, cung cấp khả năng mở rộng và khả năng truy cập bằng cách lưu trữ dữ liệu trên các máy chủ từ xa.
Ngoài ra, cơ sở dữ liệu vector đã xuất hiện để đáp ứng nhu cầu cụ thể của các ứng dụng máy học, lưu trữ và truy vấn các vector có số chiều lớn một cách hiệu quả.
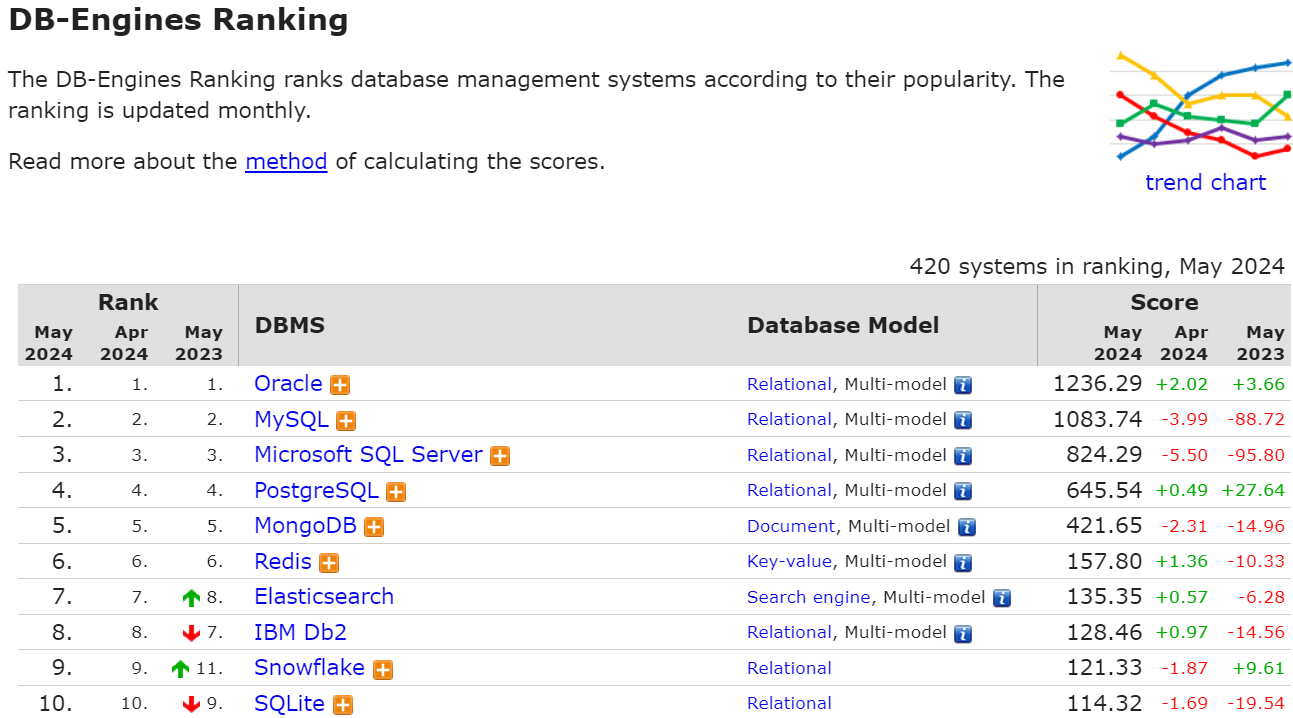
Bảng xếp hạng DB-Engines cho tháng 5/2024 liệt kê các hệ quản trị cơ sở dữ liệu (DBMS) hàng đầu dựa trên mức độ phổ biến. Bảng xếp hạng này được cập nhật hàng tháng và bao gồm 420 hệ thống. Tính đến tháng 5/2024, bốn cơ sở dữ liệu đứng đầu đều là cơ sở dữ liệu quan hệ: Oracle, MySQL, Microsoft SQL và PostgreSQL.
Nguồn: db-engines
Đáng chú ý là các cơ sở dữ liệu NoSQL như MongoDB và Redis cũng giữ vị trí mạnh trong bảng xếp hạng, phản ánh nhu cầu ngày càng tăng đối với các giải pháp linh hoạt và có khả năng mở rộng, có thể xử lý dữ liệu phi cấu trúc và các ứng dụng lưu lượng cao. Các hệ thống NoSQL này ghi nhận mức tăng trưởng đáng kể theo năm, cho thấy sự dịch chuyển hướng tới kiến trúc cơ sở dữ liệu đa dạng hơn.
Bảng xếp hạng cũng cho thấy mức độ phổ biến tăng của các cơ sở dữ liệu dựa trên đám mây như Snowflake, cung cấp giải pháp kho dữ liệu được quản lý hoàn toàn và có thể mở rộng. Elasticsearch, một công cụ tìm kiếm và nền tảng phân tích mạnh mẽ, cũng đã tăng hạng, nhấn mạnh tầm quan trọng của khả năng tìm kiếm và phân tích trong quản trị dữ liệu hiện đại.
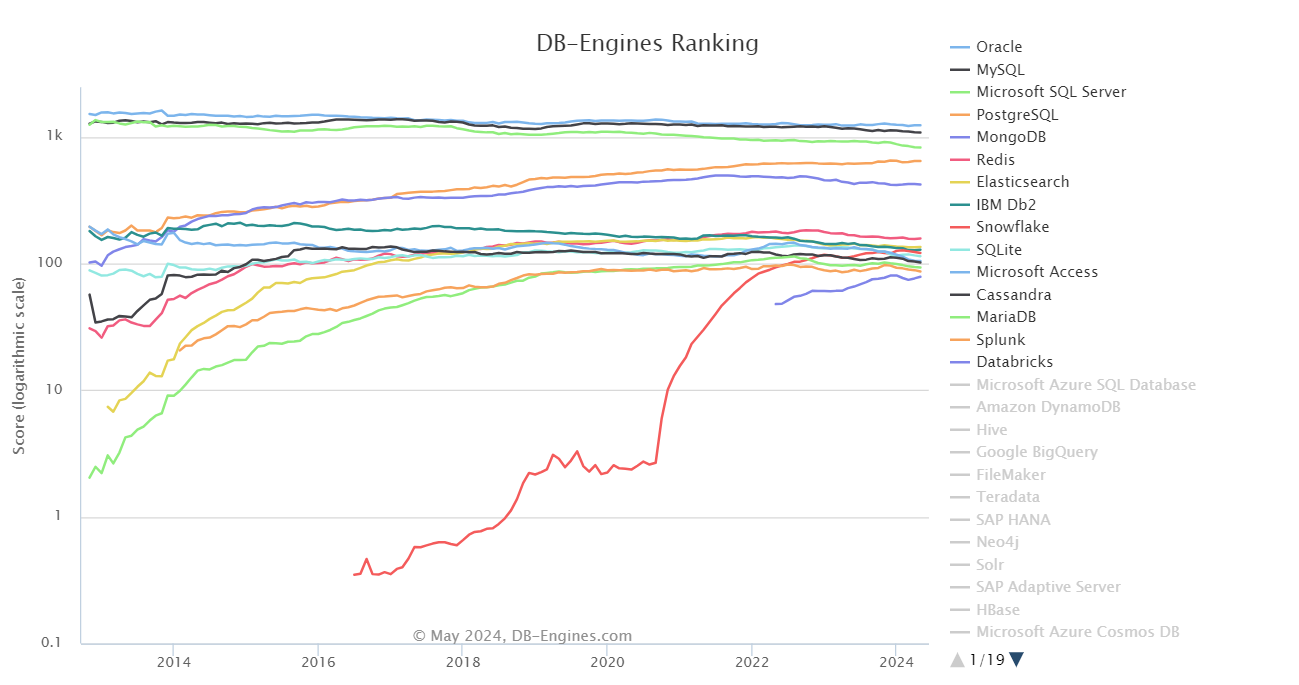
Hãy cùng xem biểu đồ đường dưới đây, minh họa bức tranh động về mức độ phổ biến của cơ sở dữ liệu từ năm 2014 đến 2024.
Nguồn: db-engines
Điểm rút ra chính là sự thống trị bền bỉ của các hệ quản trị cơ sở dữ liệu quan hệ (RDBMS) như Oracle, MySQL, Microsoft SQL Server và PostgreSQL. Chúng liên tục duy trì vị trí hàng đầu suốt thập kỷ, nhấn mạnh tầm quan trọng của chúng trong xử lý dữ liệu có cấu trúc và hỗ trợ các truy vấn phức tạp trên nhiều ứng dụng.
Tuy vậy, biểu đồ cũng cho thấy một sự dịch chuyển đáng chú ý trong những năm gần đây. Dù các hệ RDBMS có xu hướng giảm dần về mức độ phổ biến, cơ sở dữ liệu NoSQL như MongoDB và Redis lại tăng trưởng mạnh. Quỹ đạo đi lên này phản ánh việc ngày càng áp dụng các giải pháp linh hoạt và có khả năng mở rộng để quản lý dữ liệu phi cấu trúc và đáp ứng các ứng dụng lưu lượng cao.
Một xu hướng thú vị khác là sự trỗi dậy của các cơ sở dữ liệu dựa trên đám mây. Databricks, một nền tảng kỹ thuật dữ liệu và máy học trên đám mây, đã tăng vọt về mức độ phổ biến, cho thấy nhu cầu ngày càng lớn đối với các giải pháp đám mây mang lại khả năng mở rộng, dễ sử dụng và năng lực phân tích mạnh.
Tương tự, Snowflake, một kho dữ liệu đám mây được quản lý hoàn toàn, cũng ghi nhận tăng trưởng đáng kể, làm nổi bật sức hấp dẫn của kiến trúc có thể mở rộng và dễ sử dụng của nó.
Cơ sở dữ liệu quan hệ lưu trữ dữ liệu trong các bảng được cấu trúc theo hàng và cột. Mỗi hàng đại diện cho một bản ghi duy nhất, và mỗi cột biểu thị một thuộc tính cụ thể của bản ghi đó.
Hãy hình dung chúng như các bảng tính được tổ chức tỉ mỉ, nơi dữ liệu được lưu trong các bảng gồm hàng (bản ghi) và cột (thuộc tính). Mỗi hàng biểu diễn một thực thể riêng biệt, như khách hàng hoặc sản phẩm, trong khi mỗi cột nắm bắt một đặc trưng cụ thể, như tên, địa chỉ hoặc giá.
Sức mạnh thực sự của cơ sở dữ liệu quan hệ nằm ở khả năng liên kết các bảng này với nhau thông qua quan hệ. Những quan hệ này, được thiết lập bằng khóa ngoại, cho phép chúng ta kết nối dữ liệu từ các bảng khác nhau, tạo nên một cái nhìn thống nhất về thông tin.
Ví dụ, trong hệ thống quản trị quan hệ khách hàng (CRM), bảng khách hàng có thể được liên kết với bảng đơn hàng, giúp chúng ta theo dõi lịch sử mua sắm của một khách hàng.
Để tương tác với cơ sở dữ liệu quan hệ, chúng ta sử dụng Structured Query Language (SQL). Ngôn ngữ mạnh mẽ này cho phép truy vấn, chèn, cập nhật, xóa dữ liệu, cũng như thực hiện các thao tác phức tạp như nối dữ liệu từ nhiều bảng. Tính có cấu trúc của SQL đảm bảo tính toàn vẹn và nhất quán dữ liệu thông qua các thuộc tính ACID:
Nếu bạn muốn tìm hiểu thêm về SQL, hãy xem lộ trình gồm bảy khóa học SQL Fundamentals.
Cơ sở dữ liệu quan hệ rất phù hợp khi chúng ta cần:
Tuy nhiên, chúng có thể không phải lựa chọn tốt nhất cho:
Một số lựa chọn RDBMS phổ biến gồm:
Nếu bạn muốn học cách sử dụng cơ sở dữ liệu quan hệ trong Python, hãy xem khóa học miễn phí Introduction to Databases in Python.
Cơ sở dữ liệu NoSQL, viết tắt của "not only SQL", đã xuất hiện như một lựa chọn mạnh mẽ thay thế cơ sở dữ liệu quan hệ, đặc biệt trong các kịch bản ưu tiên tính linh hoạt, khả năng mở rộng và hiệu năng cao.
Khác với hệ quan hệ, cơ sở dữ liệu NoSQL có thể xử lý dữ liệu phi cấu trúc hoặc bán cấu trúc mà không bị ràng buộc bởi lược đồ cố định. Điều này có nghĩa là chúng ta có thể lưu dữ liệu ở nhiều định dạng, như tài liệu JSON, cặp khóa-giá trị hoặc cấu trúc đồ thị, mà không cần xác định cấu trúc cứng nhắc từ trước.
Những cơ sở dữ liệu này thường hỗ trợ tính năng mở rộng ngang trên nhiều máy chủ và cụm, khiến chúng phù hợp với môi trường dữ liệu phân tán.
Không giống cơ sở dữ liệu quan hệ dùng Structured Query Language (SQL), cơ sở dữ liệu NoSQL không có một ngôn ngữ truy vấn chung. Thay vào đó, mỗi loại cơ sở dữ liệu NoSQL thường có ngôn ngữ truy vấn hoặc API riêng, phù hợp với mô hình và cấu trúc dữ liệu của nó.
Trong khi cơ sở dữ liệu NoSQL ưu tiên tính linh hoạt và khả năng mở rộng, chúng thường nới lỏng một số thuộc tính ACID có ở cơ sở dữ liệu quan hệ. Ví dụ, một số cơ sở dữ liệu NoSQL ưu tiên tính nhất quán cuối cùng thay vì nhất quán tức thời, nghĩa là thay đổi có thể không được phản ánh ngay lập tức trên tất cả nút. Sự đánh đổi này giúp cải thiện hiệu năng và khả năng mở rộng nhưng đòi hỏi cân nhắc kỹ khi thiết kế các ứng dụng cần tính nhất quán dữ liệu nghiêm ngặt.
Nếu bạn muốn học cách truy vấn cơ sở dữ liệu NoSQL, hãy xem khóa học Introduction to NoSQL.
Cơ sở dữ liệu NoSQL đặc biệt phù hợp cho các kịch bản:
Các trường hợp sử dụng phổ biến gồm:
Mặc dù mang lại nhiều lợi thế, cơ sở dữ liệu NoSQL có thể không lý tưởng cho các ứng dụng yêu cầu đảm bảo giao dịch mạnh hoặc truy vấn quan hệ phức tạp. Nhiều tổ chức áp dụng cách tiếp cận lai, sử dụng cả cơ sở dữ liệu quan hệ và NoSQL để tận dụng thế mạnh riêng của từng loại.
Một số cơ sở dữ liệu NoSQL phổ biến nhất gồm:
Nếu bạn muốn tìm hiểu thêm về bốn cơ sở dữ liệu NoSQL chủ đạo, hãy xem khóa học NoSQL Concepts.
Cơ sở dữ liệu đám mây đã cách mạng hóa quản trị dữ liệu bằng cách tận dụng nguồn lực dồi dào và khả năng mở rộng của các nền tảng điện toán đám mây. Các cơ sở dữ liệu này nằm trên các máy chủ từ xa và được truy cập qua internet, loại bỏ nhu cầu tổ chức phải đầu tư và vận hành phần cứng, hạ tầng của riêng mình.
Cơ sở dữ liệu đám mây hoạt động theo mô hình trả theo mức dùng, trong đó chúng ta chỉ trả tiền cho tài nguyên thực sự sử dụng. Điều này loại bỏ chi phí đầu tư ban đầu và chi phí bảo trì liên tục gắn với cơ sở dữ liệu đặt tại chỗ truyền thống. Nhà cung cấp đám mây xử lý hạ tầng bên dưới, bao gồm máy chủ, lưu trữ và mạng, trong khi bạn tập trung xây dựng và quản lý ứng dụng.
Nếu bạn muốn tìm hiểu về điện toán đám mây, hãy xem khóa học Understanding Cloud Computing.
Việc truy vấn cơ sở dữ liệu đám mây thường sử dụng cùng công cụ và ngôn ngữ như với cơ sở dữ liệu tại chỗ. Với cơ sở dữ liệu quan hệ trên đám mây, chúng ta sẽ dùng SQL để tương tác với dữ liệu. Cơ sở dữ liệu NoSQL trên đám mây thường có ngôn ngữ truy vấn hoặc API riêng, tương tự như bản triển khai tại chỗ của chúng.
Nhà cung cấp đám mây thường cung cấp thêm công cụ và dịch vụ để đơn giản hóa quản trị cơ sở dữ liệu và truy vấn. Chúng có thể bao gồm bảng điều khiển trên web, giao diện dòng lệnh và SDK cho nhiều ngôn ngữ lập trình.
Cơ sở dữ liệu đám mây là lựa chọn tuyệt vời khi:
Các nhà cung cấp đám mây hàng đầu cung cấp nhiều dịch vụ cơ sở dữ liệu, mỗi dịch vụ có thế mạnh và chuyên môn riêng:
Bạn có thể tìm hiểu thêm về cơ sở dữ liệu đám mây trong khóa học AWS Cloud Technology and Services.
Cơ sở dữ liệu vector đã xuất hiện như một công cụ chuyên biệt để xử lý các nhu cầu độc đáo của ứng dụng trí tuệ nhân tạo và máy học.
Cơ sở dữ liệu vector được thiết kế để lưu trữ, lập chỉ mục và quản lý vector embedding, là các biểu diễn dữ liệu có số chiều lớn thường dùng trong mô hình máy học. Điều này cho phép tìm kiếm tương đồng hiệu quả, nơi cơ sở dữ liệu có thể nhanh chóng xác định các vector "gần" với vector truy vấn dựa trên các thước đo khoảng cách như độ tương đồng cosine hoặc khoảng cách Euclid.
Những đặc điểm này khiến chúng phù hợp với các ứng dụng như nhận dạng hình ảnh, hệ thống gợi ý và xử lý ngôn ngữ tự nhiên. Chúng sử dụng cấu trúc lập chỉ mục tối ưu cho việc truy xuất các vector tương tự dựa trên thước đo khoảng cách.
Nếu bạn muốn tìm hiểu thêm về cơ sở dữ liệu vector, bạn có thể đọc bài viết: An Introduction to Vector Databases for Machine Learning.
Truy vấn một cơ sở dữ liệu vector thường bao gồm các bước sau:
Các cơ sở dữ liệu vector khác nhau có thể cung cấp các tùy chọn và tham số truy vấn đa dạng, như chỉ định số lượng láng giềng gần nhất cần trả về hoặc đặt ngưỡng khoảng cách. Một số hệ còn hỗ trợ lọc theo siêu dữ liệu hoặc kết hợp tìm kiếm vector với lọc theo giá trị truyền thống.
Cơ sở dữ liệu vector đặc biệt phù hợp khi:
Nếu bạn muốn tìm hiểu thêm về các cơ sở dữ liệu phổ biến, hãy xem bài viết Top 5 Best Vector Databases.
Mặc dù cơ sở dữ liệu quan hệ, NoSQL, đám mây và vector bao phủ nhiều trường hợp sử dụng, vẫn tồn tại một số loại cơ sở dữ liệu khác, mỗi loại được điều chỉnh cho các mô hình dữ liệu và mẫu truy cập cụ thể. Hãy cùng điểm qua nhanh một số giải pháp chuyên biệt này.
Cơ sở dữ liệu chuỗi thời gian được tối ưu để lưu trữ và phân tích dữ liệu có dấu thời gian, như số đo cảm biến, giá cổ phiếu hoặc nhật ký máy chủ. Chúng vượt trội trong việc tiếp nhận dữ liệu khối lượng lớn và truy vấn hiệu quả các điểm dữ liệu theo dải thời gian. Các lựa chọn phổ biến gồm InfluxDB, TimescaleDB và Prometheus.
Cơ sở dữ liệu hướng đối tượng (OODB) lưu trữ dữ liệu dưới dạng đối tượng, tương tự lập trình hướng đối tượng. Điều này có thể đơn giản hóa việc mô hình hóa cấu trúc dữ liệu và quan hệ phức tạp. Tuy nhiên, OODB không được chấp nhận rộng rãi do thách thức về tiêu chuẩn hóa và tối ưu truy vấn. Các lựa chọn phổ biến gồm ObjectDB và Versant Object Database.
Cơ sở dữ liệu đồ thị xuất sắc trong biểu diễn và truy vấn các mối quan hệ giữa thực thể. Chúng lưu trữ dữ liệu dưới dạng nút (thực thể) và cạnh (quan hệ), phù hợp với mạng xã hội, công cụ gợi ý, hệ thống phát hiện gian lận và đồ thị tri thức. Các lựa chọn phổ biến gồm Neo4j, Amazon Neptune và JanusGraph.
Cơ sở dữ liệu phân cấp tổ chức dữ liệu theo cấu trúc dạng cây, với quan hệ cha-con giữa các bản ghi. Cấu trúc này phù hợp cho một số ứng dụng chuyên biệt nhưng có thể thiếu linh hoạt với mô hình dữ liệu phức tạp. Dù có ý nghĩa lịch sử, cơ sở dữ liệu phân cấp ít phổ biến hơn trong các ứng dụng hiện đại.
Cơ sở dữ liệu mạng tương tự cơ sở dữ liệu phân cấp nhưng cho phép quan hệ phức tạp hơn giữa các bản ghi. Dù mang lại tính linh hoạt, chúng cũng có thể khó quản lý và truy vấn hơn. Trong hầu hết ứng dụng, cơ sở dữ liệu mạng phần lớn đã được thay thế bởi cơ sở dữ liệu quan hệ và đồ thị.
Trong phần tổng quan này, chúng ta đã khám phá bức tranh đa dạng của các cơ sở dữ liệu, mỗi loại được điều chỉnh để giải quyết những thách thức dữ liệu cụ thể. Từ dữ liệu có cấu trúc trong cơ sở dữ liệu quan hệ đến sự linh hoạt của NoSQL, khả năng mở rộng của giải pháp đám mây và năng lực chuyên biệt của cơ sở dữ liệu vector, chúng ta đã thấy cách những công cụ này làm nền tảng cho quản trị dữ liệu hiện đại.
Việc chọn đúng cơ sở dữ liệu là một quyết định quan trọng, phụ thuộc vào việc hiểu rõ điểm mạnh và đánh đổi của từng loại. Bằng cách đánh giá cẩn thận nhu cầu và ràng buộc cụ thể của bạn, bạn có thể chọn cơ sở dữ liệu phù hợp nhất để thúc đẩy các ứng dụng và sáng kiến dựa trên dữ liệu.
Nếu bạn muốn đi sâu hơn về cơ sở dữ liệu, bạn có thể thử lộ trình bốn khóa học SQL for Database Administrators.
Tìm hiểu thêm về cơ sở dữ liệu!
Khóa học
Lộ trình
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
