Cursus
AI-toepassingen bouwen met Pinecone
3 uur
12.2K
In de kern is een vectordatabase een speciaal ontworpen systeem voor het opslaan en ophalen van vectorgegevens. In deze context verwijst een vector naar een geordende set numerieke waarden die van alles kunnen representeren, van ruimtelijke coördinaten tot kenmerk-atributen. In machine learning- en data science-toepassingen worden vectors vaak gebruikt om de kenmerken van objecten te representeren. De vectordatabase kan deze featurevectors efficiënt opslaan en ophalen.
Afbeelding door Gary Alway
Vector-embedding is het proces waarbij objecten, zoals woorden, zinnen of entiteiten, worden gerepresenteerd als vectors in een continue vectorruimte. Deze techniek wordt vaak gebruikt om hoog-dimensionale en categorische data om te zetten in continue vectors met lagere dimensie, die effectiever door machine learning-algoritmen kunnen worden gebruikt. Vector-embeddings zijn vooral populair in natural language processing (NLP), waar ze worden gebruikt om woorden of zinsdelen te representeren.
Het achterliggende idee van vector-embedding is om semantische relaties tussen objecten vast te leggen. In de context van woord-embeddings worden bijvoorbeeld woorden met vergelijkbare betekenissen gerepresenteerd door vectors die dichter bij elkaar liggen in de vectorruimte. Dit stelt machine learning-modellen in staat om de contextuele en semantische relaties tussen woorden beter te begrijpen.
Voortbouwend op het concept van vector-embeddings benutten Large Language Models (LLM’s) deze numerieke representaties om complexe taken op het gebied van taalbegrip en -generatie aan te pakken.
Een concreet voorbeeld: de onderliggende architectuur van het model voor chat GTP maakt gebruik van vectors. Het model verwerkt invoer, zoals tekst, door die om te zetten in numerieke vectors.
Deze vectors leggen de semantische en contextuele informatie van de invoer vast, waardoor het model samenhangende en contextueel relevante antwoorden kan begrijpen en genereren. De Transformer-architectuur, waarop GPT-3.5 is gebaseerd, gebruikt self-attention-mechanismen om het belang van verschillende woorden in een reeks te wegen, wat het vermogen van het model om relaties en context vast te leggen verder versterkt.
“Self-attention” verwijst naar het vermogen van het model om verschillende woorden binnen de invoersequentie een uiteenlopende mate van belang toe te kennen.
Kortom, het GPT-3.5-model werkt met gevectoriseerde representaties van taal om uiteenlopende taken voor taalbegrip en -generatie uit te voeren. Deze vectorgebaseerde benadering is een sleutelfactor in het succes van het model bij een breed scala aan taaltoepassingen.
PG Vector is een open-source vector similarity search voor Postgres. Laten we meteen aan de slag gaan en met Docker een database maken. Maak een bestand met de naam docker-compose.yml en voer vervolgens op de commandoregel de volgende opdracht uit: docker-compose up -d
services:
 db:
   hostname: db
   image: ankane/pgvector
   ports:
     - 5432:5432
   restart: always
   environment:
     - POSTGRES_DB=vectordb
     - POSTGRES_USER=testuser
     - POSTGRES_PASSWORD=testpwd
     - POSTGRES_HOST_AUTH_METHOD=trust
De volgende stap is het maken van een tabel. In dit voorbeeld gaan we DataCamp-leerbronnen catalogiseren, waaronder courses, blogs, tutorials, podcasts, cheat sheets, code alongs en certifications.
CREATE TABLE resource (
   id serial CONSTRAINT "PK_resource" PRIMARY KEY,
   name varchar NOT NULL,
   content text NOT NULL,
   slug varchar NOT NULL,
   type varchar NOT NULL,
   embedding vector,
   CONSTRAINT "UQ_resource" UNIQUE (name, type)
);
De embedding-kolom wordt gegenereerd op basis van een als string opgeslagen JSON-object dat de resource-attributen { name, content, slug, type } representeert. Om deze vector-embedding te maken, gebruiken we een embeddingmodel.
Een van de beschikbare modellen op AWS Bedrock is amazon.titan-embed-text-v1. Het configureren van Bedrock valt buiten de scope van dit artikel; het is slechts een voorbeeld van één van de vele embeddingmodellen die vergelijkbare resultaten kunnen leveren. Het primaire doel is om tekstuele invoer te nemen, een embeddingmodel te gebruiken om vector-embeddings te genereren en die vervolgens op te slaan in de embedding-kolom.
// typescript
const client = new BedrockRuntimeClient({ region: process.env.AWS_REGION });
const response = await client.send(
 new InvokeModelCommand({
   modelId: "amazon.titan-embed-text-v1",
   contentType: "application/json",
   accept: "application/json",
   body: JSON.stringify({
     inputText: JSON.stringify(resource),
   }),
 })
);

const { embedding } = JSON.parse(new TextDecoder().decode(response.body));
# python
client = boto3.client("bedrock-runtime", region_name=region)
response = client.invoke_endpoint(
EndpointName="amazon.titan-embed-text-v1",
ContentType="application/json",
Accept="application/json",
Body=json.dumps({"inputText": json.dumps(resource)})
)
embedding = json.loads(response["Body"].read().decode("utf-8"))["embedding"]Doordat we data samen met de bijbehorende vector-embeddings kunnen opslaan, ontsluiten we de kracht van vectordatabases. Zo kunnen we in natuurlijke taal-achtige bevragingen met onze database communiceren en moeiteloos betekenisvolle resultaten ophalen.
Formuleer gewoon elke vraag die je aan je data wilt “stellen” en pas dezelfde embedding toe op die tekst. Zo ziet de SQL-query eruit:
SELECT
  name,
  content,
  type,
  slug,
  1 - (embedding <=> $1) AS similarity
FROM
  resource
WHERE
  1 - (embedding <=> $1) > $2
ORDER BY
  similarity DESC;
Deze query gebruikt een cosine similarity-zoekactie. Parameter $1 staat voor het embedding-resultaat van de tekst van je invoervraag, terwijl parameter $2, de drempel voor overeenkomst, een variabele is waarbij experimenteren loont. De optimale waarde hangt af van factoren zoals de grootte van je dataset en de gewenste relevantie van resultaten, wat de granulariteit van de opgehaalde informatie bepaalt.
Met al deze componenten op hun plek wordt het bouwen van een chatachtige UI eenvoudig. De details van de implementatie daarvan vallen buiten de scope van dit artikel, maar hier zijn enkele voorbeelden met mijn DataCamp-dataset, die uit meer dan 600 records bestaat:
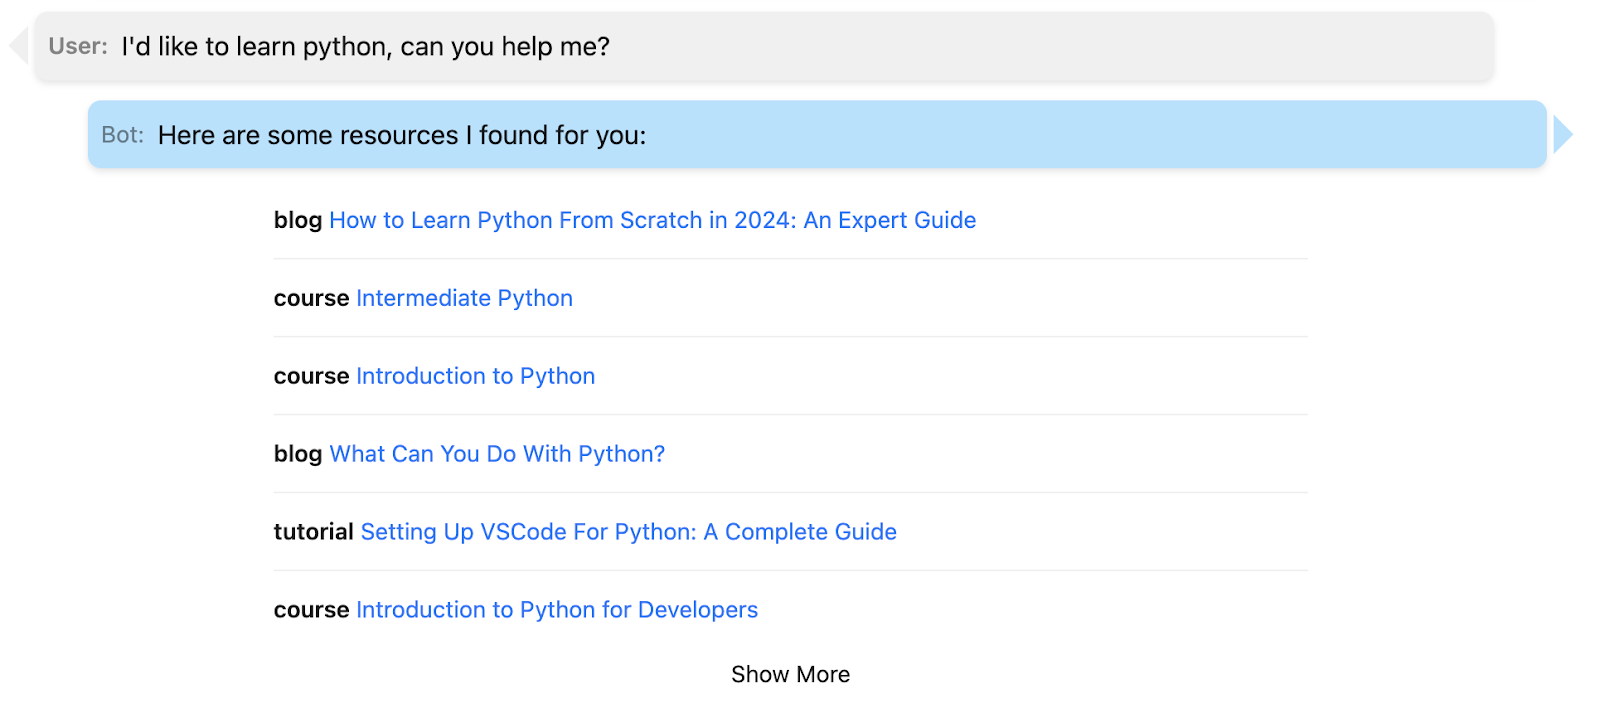
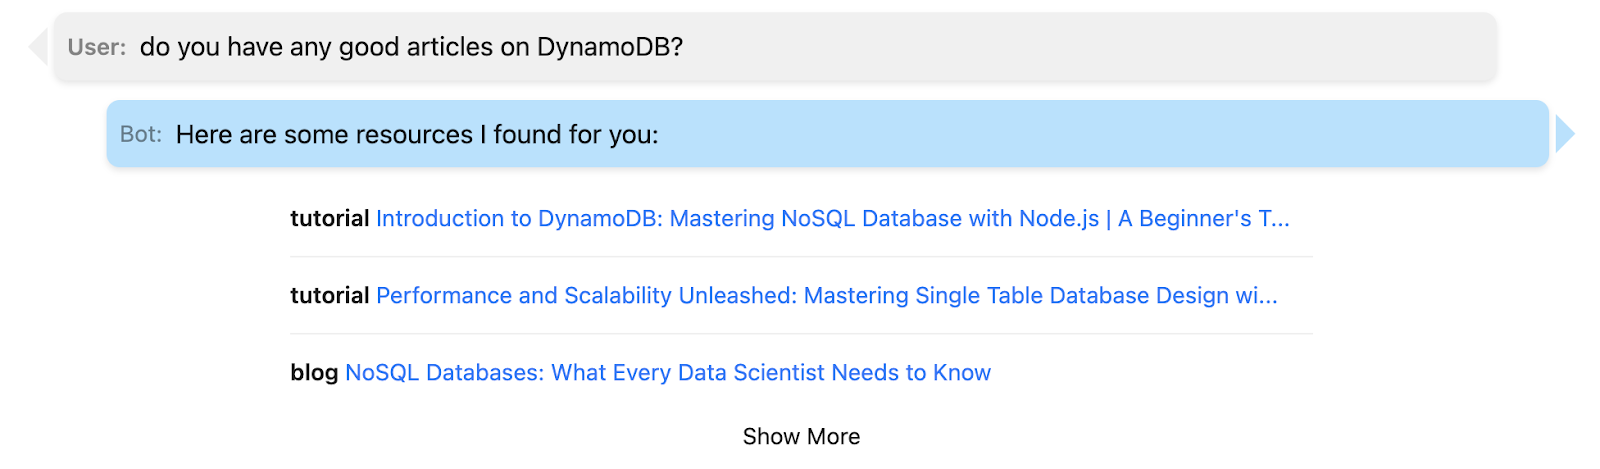
In dit artikel hebben we de krachtige wereld van vectordatabases verkend en PG Vector ingezet om onze mogelijkheden voor dataopslag en -opvraging te verbeteren. Als je aan je reis met vector-embeddings begint, valt er nog veel meer te ontdekken en te leren. Wil je dieper duiken in PG Vector? Bekijk dan hun readme, met meer details en links naar clients voor je favoriete programmeertaal.
Een logische vervolgstap op het begrijpen van vector-embeddings is Retrieval Augmented Generation (RAG). Dit is het proces waarbij contextuele data wordt geïnjecteerd in large language models (LLM’s). Zo geeft RAG het model kennis buiten de trainingsdata, wat leidt tot beter onderbouwde en contextueel relevantere antwoorden.
Je vindt op DataCamp ook allerlei bronnen die andere aspecten van vectordatabases behandelen, waaronder:
Happy coding, en moge je vectorgebaseerde projecten zowel inzichtelijk als lonend zijn!
Zet vandaag je vectorreis voort!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

