

Corso
Progettazione di database
4 ore
131.8K
Pratica and corso your progress.
Continua Con GoogleNel mondo odierno guidato dai dati, affrontiamo una sfida importante: come memorizzare, gestire ed estrarre in modo efficiente informazioni significative dai dati? I database offrono una soluzione, fornendo archivi strutturati per organizzare e accedere alle informazioni.
Tuttavia, per rispondere ai requisiti specifici di varie strutture di dati e casi d'uso, sono emersi diversi tipi di database.
In questo articolo esploreremo i quattro tipi principali che incontrerai nel mondo della data science: database relazionali, database NoSQL, database cloud e database vettoriali.
Se vuoi imparare il design dei database, dai un'occhiata a questo corso su Database Design.
I database sono strumenti essenziali nel mondo digitale. Sono collezioni organizzate di dati che facilitano l'archiviazione, il recupero, la gestione e la manipolazione delle informazioni.
Alla base, i database sono progettati per contenere dati in un formato strutturato, consentendo a utenti e applicazioni di accedere e aggiornare le informazioni in modo efficiente secondo necessità.
L'importanza dei database si estende a quasi tutti i campi, ma è particolarmente cruciale nella data science. I progetti di data science spesso implicano l'analisi di grandi volumi di dati per ricavare insight, fare previsioni o supportare il processo decisionale.
Senza database, gestire questi dati—soprattutto man mano che crescono in dimensioni e complessità—sarebbe macchinoso e soggetto a errori. I database forniscono un modo sistematico per archiviare i dati e garantirne integrità, sicurezza e accessibilità.
Considera, ad esempio, un'azienda retail che traccia vendite, interazioni con i clienti, inventario e informazioni sui fornitori. Un database funge da spina dorsale delle operazioni dell'azienda, permettendo di analizzare trend, prevedere la domanda, ottimizzare i livelli di inventario e migliorare le esperienze dei clienti.
Senza un database, l'azienda faticherebbe a gestire le enormi quantità di dati generate quotidianamente, per non parlare dell'utilizzo di questi dati per prendere decisioni informate.
I diversi tipi di database riflettono le esigenze variegate dei casi d'uso e la complessità dei dati che gestiscono. Tipi differenti sono sviluppati per ottimizzare le prestazioni, migliorare la funzionalità e soddisfare casi d'uso specifici.
Questa varietà non è solo una questione di abbondanza tecnologica, ma anche una necessità per affrontare sfide e requisiti unici che sorgono in contesti diversi. Il bisogno di diversi tipi di database deriva dalle differenze nelle strutture dei dati, nei pattern di accesso, nelle richieste di scalabilità e nei requisiti di consistenza.
Per esempio, le applicazioni business tradizionali spesso si basano su dati strutturati che si adattano bene a tabelle con schemi predefiniti, rendendo i database relazionali una scelta ideale.
Tuttavia, con l'ascesa del big data, dei social network e delle analytics in tempo reale, sono emersi i limiti dei database relazionali nella gestione di dati non strutturati, nello scaling orizzontale o nel trattamento di dati altamente connessi.
Questo ha portato all'emergere dei database NoSQL, progettati per offrire flessibilità, scalabilità e vantaggi prestazionali per determinati tipi di dati che non si conformano alla struttura rigida dei database tradizionali. Se vuoi approfondire il confronto tra database SQL e NoSQL, dai un'occhiata a questo tutorial su SQL vs NoSQL Databases.
Allo stesso modo, l'avvento dell'IoT e delle applicazioni time-sensitive ha reso necessaria la creazione di database a serie temporali ottimizzati per gestire in modo efficiente i dati temporali. Scopri di più in questo blog approfondito sui time series databases.
I database cloud hanno inoltre guadagnato importanza, offrendo scalabilità e accessibilità grazie all'hosting dei dati su server remoti.
Inoltre, sono emersi i database vettoriali per rispondere alle esigenze specifiche delle applicazioni di machine learning, memorizzando e interrogando in modo efficiente vettori ad alta dimensionalità.
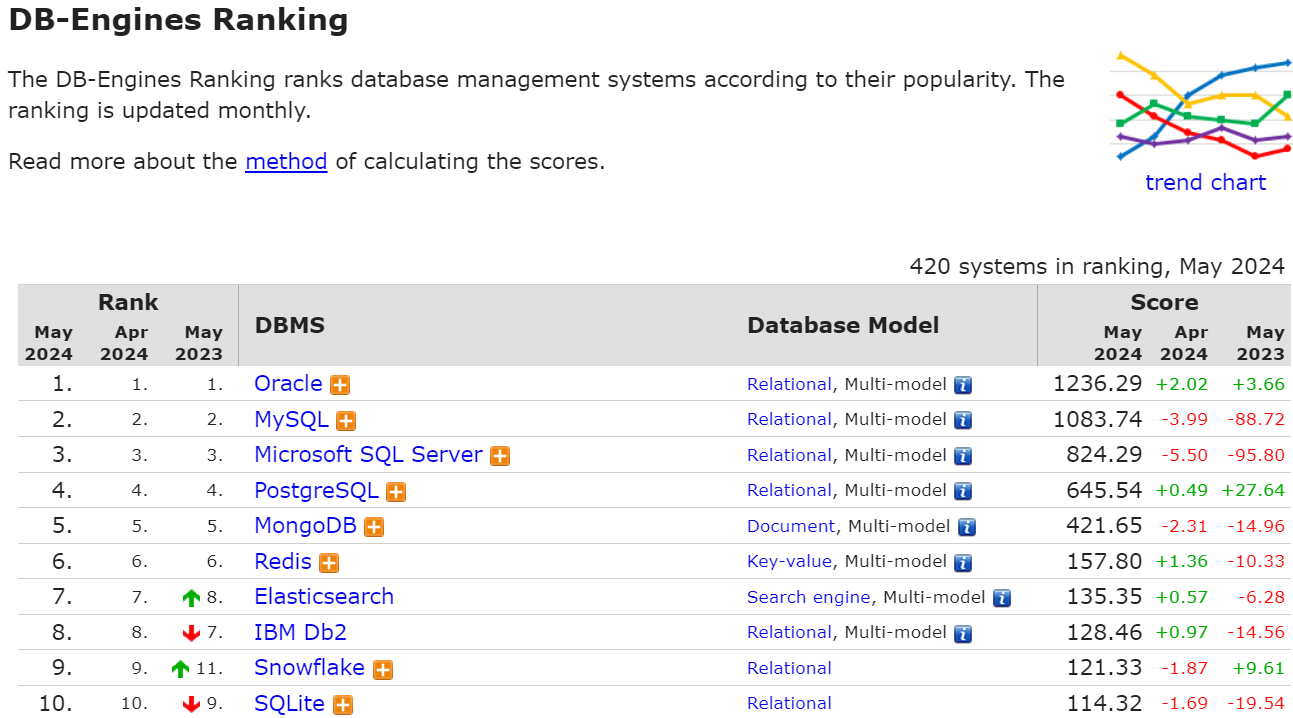
Il DB-Engines Ranking di maggio 2024 elenca i principali sistemi di gestione di database (DBMS) in base alla loro popolarità. Questa classifica è aggiornata mensilmente e include 420 sistemi. A maggio 2024, i primi quattro database sono tutti relazionali: Oracle, MySQL, Microsoft SQL e PostgreSQL.
Fonte: db-engines
Vale la pena notare che anche i database NoSQL come MongoDB e Redis occupano posizioni solide in classifica, riflettendo la crescente domanda di soluzioni flessibili e scalabili in grado di gestire dati non strutturati e applicazioni ad alto traffico. Questi sistemi NoSQL hanno registrato una crescita significativa anno su anno, indicando uno spostamento verso architetture di database più diversificate.
La classifica rivela anche la crescente popolarità dei database basati su cloud come Snowflake, che offre un data warehouse completamente gestito e scalabile. Anche Elasticsearch, un potente motore di ricerca e piattaforma di analytics, è salito in classifica, sottolineando l'importanza delle capacità di ricerca e analisi nella gestione dei dati moderna.
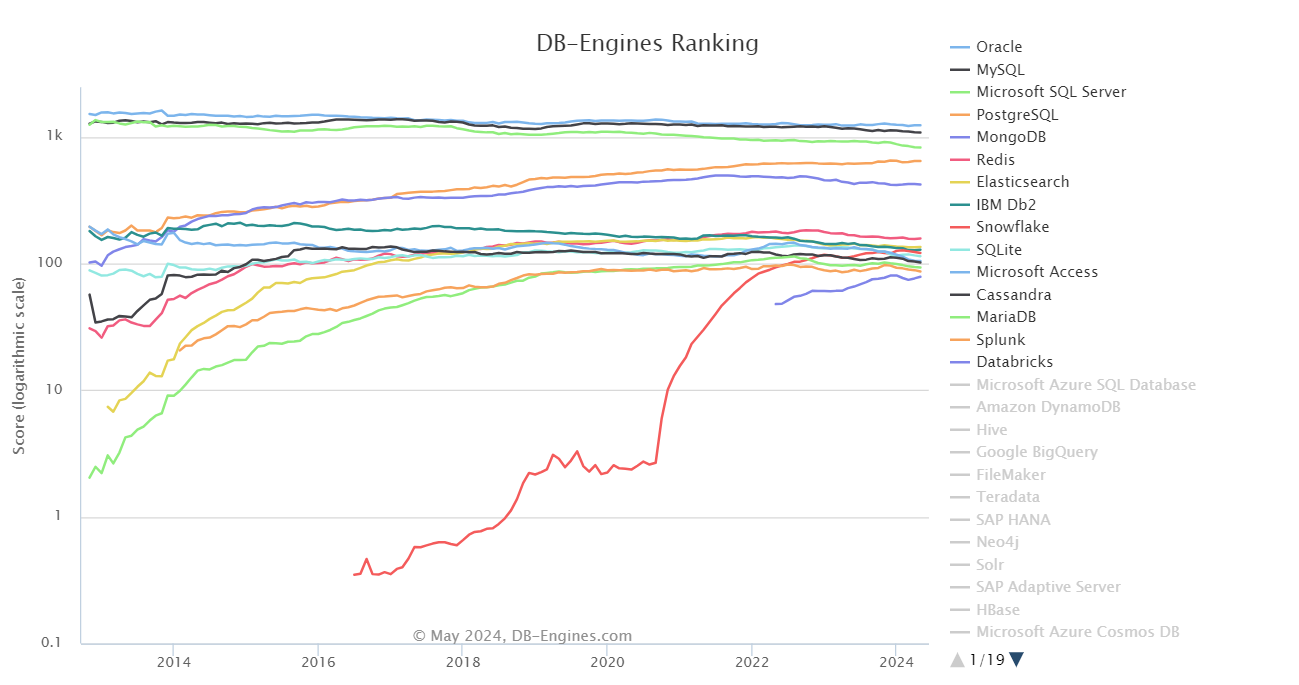
Osserviamo ora il grafico a linee qui sotto, che illustra il panorama dinamico della popolarità dei database dal 2014 al 2024.
Fonte: db-engines
Un punto chiave è la perdurante dominanza dei sistemi di gestione di database relazionali (RDBMS) come Oracle, MySQL, Microsoft SQL Server e PostgreSQL. Hanno mantenuto costantemente le prime posizioni per tutto il decennio, evidenziando la loro importanza nella gestione dei dati strutturati e nel supporto di query complesse in varie applicazioni.
Tuttavia, il grafico evidenzia anche un cambiamento notevole negli ultimi anni. Mentre i sistemi RDBMS hanno visto un graduale calo di popolarità, i database NoSQL come MongoDB e Redis hanno registrato una crescita significativa. Questa traiettoria ascendente riflette l'adozione crescente di soluzioni flessibili e scalabili per gestire dati non strutturati e supportare applicazioni ad alto traffico.
Un altro trend interessante è l'ascesa dei database basati su cloud. Databricks, una piattaforma cloud per data engineering e machine learning, ha visto un'impennata di popolarità, a testimonianza della crescente domanda di soluzioni cloud che offrano scalabilità, semplicità d'uso e potenti capacità analitiche.
Allo stesso modo, Snowflake, un cloud data warehouse completamente gestito, ha registrato una crescita significativa, evidenziando l'attrattiva della sua architettura scalabile e facile da usare.
I database relazionali memorizzano i dati in tabelle strutturate in righe e colonne. Ogni riga rappresenta un record univoco e ogni colonna un attributo specifico di quel record.
Immaginali come fogli di calcolo meticolosamente organizzati, in cui i dati sono archiviati in tabelle composte da righe (record) e colonne (attributi). Ogni riga rappresenta un'entità distinta, come un cliente o un prodotto, mentre ogni colonna cattura una caratteristica specifica, come un nome, un indirizzo o un prezzo.
La vera forza dei database relazionali risiede nella loro capacità di collegare tra loro queste tabelle usando le relazioni. Queste relazioni, stabilite tramite chiavi esterne, ci consentono di connettere dati provenienti da tabelle diverse, creando una visione unificata delle informazioni.
Per esempio, in un sistema di gestione delle relazioni con i clienti (CRM), una tabella dei clienti potrebbe essere collegata a una tabella degli ordini, consentendoci di tracciare la cronologia degli acquisti di un cliente.
Per interagire con i database relazionali, utilizziamo il linguaggio SQL (Structured Query Language). Questo potente linguaggio ci permette di interrogare, inserire, aggiornare ed eliminare dati, oltre a eseguire operazioni complesse come il join dei dati da più tabelle. La natura strutturata di SQL garantisce integrità e coerenza dei dati attraverso le proprietà ACID:
Se vuoi saperne di più su SQL, dai un'occhiata a questo percorso di sette corsi su SQL Fundamentals.
I database relazionali sono ottimi quando serve:
Tuttavia, potrebbero non essere la scelta migliore per:
Alcune opzioni RDBMS diffuse includono:
Se vuoi imparare a usare i database relazionali in Python, dai un'occhiata a questo corso gratuito su Introduction to Databases in Python.
I database NoSQL, acronimo di "not only SQL", sono emersi come una potente alternativa ai database relazionali, soprattutto negli scenari in cui flessibilità, scalabilità e alte prestazioni sono fondamentali.
A differenza dei loro omologhi relazionali, i database NoSQL possono gestire dati non strutturati o semi-strutturati senza i vincoli di uno schema fisso. Ciò significa che possiamo archiviare dati in vari formati, come documenti JSON, coppie chiave-valore o strutture a grafo, senza dover definire a priori una struttura rigida.
Questi database offrono spesso funzionalità per scalare su più server e cluster, rendendoli adatti ad ambienti di dati distribuiti.
A differenza dei database relazionali, che usano SQL (Structured Query Language), i database NoSQL non hanno un linguaggio di query universale. Ogni tipo di database NoSQL ha in genere il proprio linguaggio di query o API, adattato al suo specifico modello e struttura dei dati.
Sebbene i database NoSQL privilegino flessibilità e scalabilità, spesso allentano alcune proprietà ACID presenti nei database relazionali. Per esempio, alcuni database NoSQL privilegiano la consistenza eventuale rispetto a quella immediata, il che significa che le modifiche potrebbero non essere riflesse istantaneamente su tutti i nodi. Questo compromesso consente migliori prestazioni e scalabilità, ma richiede attenzione nella progettazione di applicazioni che dipendono da una forte coerenza dei dati.
Se vuoi imparare a interrogare i database NoSQL, prova questo corso di Introduction to NoSQL.
I database NoSQL sono particolarmente adatti agli scenari in cui:
Casi d'uso comuni includono:
Pur offrendo vantaggi significativi, i database NoSQL potrebbero non essere ideali per applicazioni che richiedono forti garanzie transazionali o query relazionali complesse. Molte organizzazioni adottano un approccio ibrido, utilizzando sia database relazionali sia NoSQL per sfruttarne i rispettivi punti di forza.
Tra i database NoSQL più diffusi troviamo:
Se vuoi saperne di più sui quattro principali database NoSQL, dai un'occhiata a questo corso su NoSQL Concepts.
I database cloud hanno rivoluzionato la gestione dei dati sfruttando le vaste risorse e la scalabilità delle piattaforme di cloud computing. Risiedono su server remoti e sono accessibili via internet, eliminando la necessità per le organizzazioni di investire e mantenere hardware e infrastrutture proprie.
I database cloud operano con un modello pay-as-you-go, in cui paghiamo solo per le risorse effettivamente utilizzate. Questo elimina i costi iniziali e le spese di manutenzione ricorrenti tipici dei database on-premise tradizionali. I provider cloud gestiscono l'infrastruttura sottostante, inclusi server, storage e rete, mentre tu ti concentri sulla creazione e gestione delle applicazioni.
Se vuoi imparare il cloud computing, dai un'occhiata a questo corso su Understanding Cloud Computing.
Interrogare i database cloud in genere comporta l'uso degli stessi strumenti e linguaggi che useremmo con i database on-premise. Per i database relazionali nel cloud, useremmo SQL per interagire con i dati. I database NoSQL nel cloud hanno in genere i propri linguaggi di query o API, analoghi ai corrispettivi on-premise.
I provider cloud offrono spesso strumenti e servizi aggiuntivi per semplificare la gestione e l'interrogazione dei database. Questi possono includere console web, interfacce a riga di comando e SDK per vari linguaggi di programmazione.
I database cloud sono un'ottima scelta quando:
I principali provider cloud offrono una gamma di servizi di database, ciascuno con i propri punti di forza e specializzazioni:
Puoi approfondire i database cloud in questo corso su AWS Cloud Technology and Services.
I database vettoriali sono emersi come strumento specializzato per gestire le esigenze uniche delle applicazioni di intelligenza artificiale e machine learning.
I database vettoriali sono progettati per archiviare, indicizzare e gestire le embedding vettoriali, rappresentazioni di dati ad alta dimensionalità spesso utilizzate nei modelli di machine learning. Ciò abilita la similarity search efficiente, in cui il database può identificare rapidamente i vettori "vicini" a un vettore di query dato, sulla base di metriche di distanza come la similarità del coseno o la distanza euclidea.
Queste caratteristiche li rendono adatti ad applicazioni come il riconoscimento di immagini, i sistemi di raccomandazione e l'elaborazione del linguaggio naturale. Utilizzano strutture di indicizzazione che ottimizzano il recupero di vettori simili in base alle metriche di distanza.
Se vuoi saperne di più sui database vettoriali, puoi leggere questo articolo: An Introduction to Vector Databases for Machine Learning.
Interrogare un database vettoriale in genere comporta i seguenti passaggi:
Diversi database vettoriali possono offrire varie opzioni e parametri di query, come specificare il numero di nearest neighbors da restituire o impostare una soglia di distanza. Alcuni database supportano anche il filtering basato su metadati o la combinazione della ricerca vettoriale con filtri scalari tradizionali.
I database vettoriali sono particolarmente adatti agli scenari in cui:
Se vuoi saperne di più sui database più popolari, dai un'occhiata a questo articolo sui Top 5 Best Vector Databases.
Sebbene i database relazionali, NoSQL, cloud e vettoriali coprano un'ampia gamma di casi d'uso, esistono altri tipi di database, ciascuno pensato per specifici modelli di dati e pattern di accesso. Esploriamo brevemente alcune di queste soluzioni specializzate.
I database a serie temporali sono ottimizzati per archiviare e analizzare dati con time stamp, come letture di sensori, prezzi azionari o log di server. Eccellono nella gestione di un'elevata ingestione di dati e nell'interrogazione efficiente di punti dati in base a intervalli temporali. Opzioni popolari includono InfluxDB, TimescaleDB e Prometheus.
I database orientati agli oggetti (OODB) memorizzano i dati come oggetti, in modo simile alla programmazione orientata agli oggetti. Questo può semplificare la modellazione di strutture dati e relazioni complesse. Tuttavia, gli OODB non hanno avuto un'adozione diffusa a causa di sfide legate a standardizzazione e ottimizzazione delle query. Opzioni popolari includono ObjectDB e Versant Object Database.
I database a grafo eccellono nel rappresentare e interrogare le relazioni tra entità. Memorizzano i dati come nodi (entità) e archi (relazioni), risultando adatti per social network, motori di raccomandazione, sistemi di rilevamento frodi e knowledge graph. Opzioni popolari includono Neo4j, Amazon Neptune e JanusGraph.
I database gerarchici organizzano i dati in una struttura ad albero, con relazioni padre-figlio tra i record. Questa struttura è adatta per alcune applicazioni specializzate ma può risultare rigida per modelli di dati complessi. Pur storicamente significativi, i database gerarchici sono meno comuni nelle applicazioni moderne.
I database a rete sono simili a quelli gerarchici, ma consentono relazioni più complesse tra i record. Pur offrendo flessibilità, possono essere più impegnativi da gestire e interrogare. Nella maggior parte delle applicazioni, i database a rete sono stati ampiamente sostituiti da database relazionali e a grafo.
In questa panoramica abbiamo esplorato il variegato panorama dei database, ciascun tipo pensato per affrontare sfide specifiche sui dati. Dai dati strutturati nei database relazionali alla flessibilità dei NoSQL, alla scalabilità delle soluzioni cloud e alle capacità specializzate dei database vettoriali, abbiamo visto come questi strumenti siano alla base della gestione dei dati moderna.
Scegliere il database giusto è una decisione cruciale, che dipende dalla comprensione dei punti di forza e dei compromessi di ciascun tipo. Valutando con attenzione le tue esigenze e i tuoi vincoli, potrai selezionare il database che meglio supporta le tue applicazioni e iniziative data-driven.
Se vuoi approfondire i database, puoi provare questo percorso di quattro corsi su SQL for Database Administrators.
Scopri di più sui database!
Corso
Programma
Pratica and corso your progress.
Continua Con Googleblog
Tim Lu
12 min
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min



