700+ courses, half price
Cursusbeschrijving
Ontdek de voordelen van R, Spark en sparklyr
R is vooral geoptimaliseerd om je te helpen snel en overzichtelijk code te schrijven voor data-analyse. Apache Spark is ontworpen om enorme datasets razendsnel te analyseren. Met het sparklyr-pakket kun je dplyr R-code schrijven die draait op een Spark-cluster, zodat je het beste van beide werelden krijgt. In deze cursus van 4 uur leer je hoe je Spark DataFrames bewerkt met zowel de dplyr-interface als de native interface van Spark, en maak je kennis met machine learning-technieken.Laad data in Spark en bewerk Spark DataFrames
Je begint deze Spark-cursus met het ontdekken hoe Spark en R goed samenwerken en oefent met het laden van data, zodat je klaar bent voor het opschonen, transformeren en analyseren ervan. Je gebruikt Spark-frames en dplyr-syntax om je data te bewerken door rijen te filteren en te ordenen, en kolommen te muteren en samen te vatten.Duik in Big Data-analyse met Spark MLib
Deze cursus helpt je om je vaardigheden en zelfvertrouwen te vergroten in het analyseren van enorme datasets. De laatste hoofdstukken laten je kennismaken met de data-transformatiefuncties voor machine learning in Spark en geven je de kans om de machine learning-routines van sparklyr in de praktijk te brengen. Je gaat voorspellingen doen met behulp van gradient boosted trees en random forests.Vereisten
Lesprogramma
Cursusoverzicht
1
Light My Fire: Aan de slag met Spark met dplyr-syntax
Hierin leer je hoe Spark en R elkaar aanvullen, hoe je data naar en van Spark verplaatst, en hoe je Spark-dataframes manipuleert met dplyr-syntax.
- Aan de slag50 XP
- Voor elkaar gemaakt50 XP
- Hier zijn draken50 XP
- Het patroon: verbinden–werken–verbreken100 XP
- Gegevens naar Spark kopiëren100 XP
- Big data, tiny tibble100 XP
- De structuur van tibbles verkennen100 XP
- Kolommen selecteren100 XP
- Rijen filteren100 XP
- Rijen sorteren100 XP
- Kolommen muteren100 XP
- Kolommen samenvatten100 XP
2
Tools of the Trade: Geavanceerd dplyr-gebruik
Hierin leer je meer over het gebruik van de
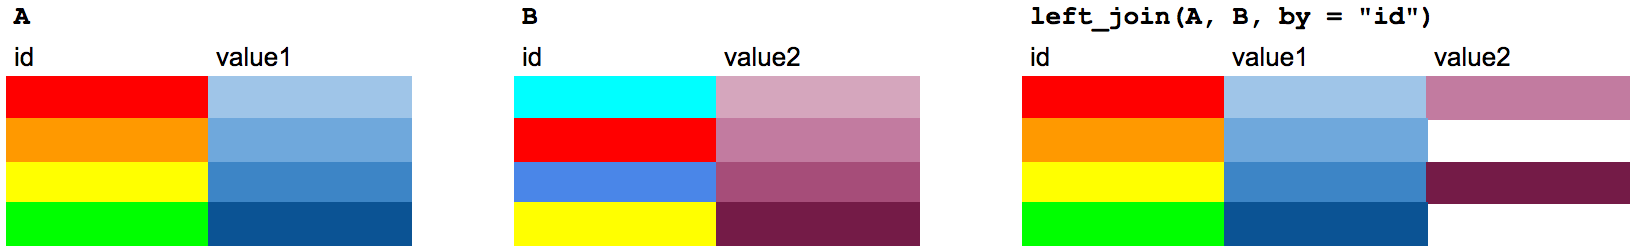
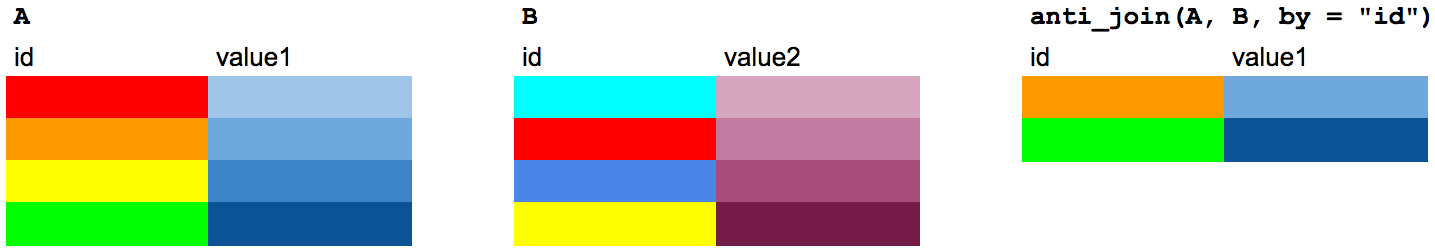
dplyr-interface met Spark, waaronder geavanceerde veldselectie, het berekenen van groepsgewijze statistieken en het joinen van dataframes.3
Going Native: De native interface gebruiken om Spark DataFrames te manipuleren
Hierin leer je over Sparks datatransformaties voor Machine Learning en de functionaliteit voor het manipuleren van native DataFrames.
4
Case Study: Learning to be a Machine: Machine Learning-modellen draaien op Spark
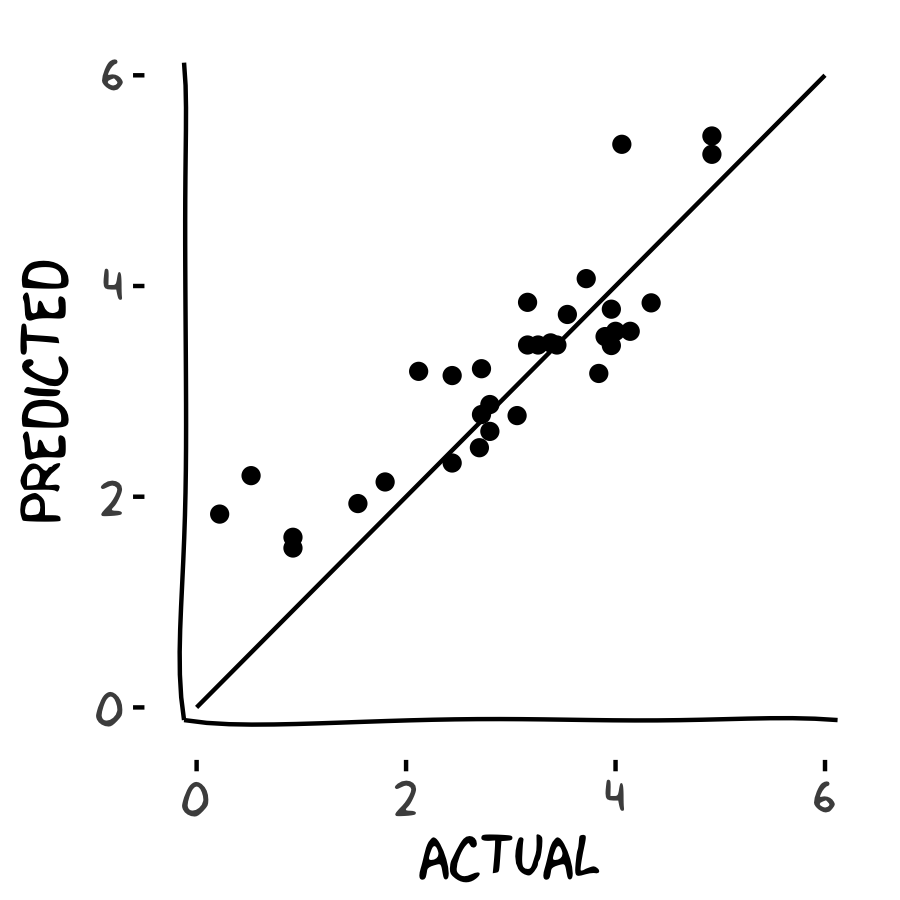
Een casus waarin je leert werken met de Machine Learning-routines van
sparklyr door te voorspellen in welk jaar een nummer is uitgebracht.R
Introductie tot Spark met sparklyr in R
Cursus
voltooid