

Lezen bij weinig licht en obstructies
Deze afbeelding is een Braziliaans barmenu gefotografeerd bij weinig licht. Drie glazen panelen tonen drankjes in gouden tekst, maar hanglampen blokkeren delen van het linker paneel, het rechter paneel is amper zichtbaar aan de rand van het kader en glasreflecties liggen over het oppervlak.
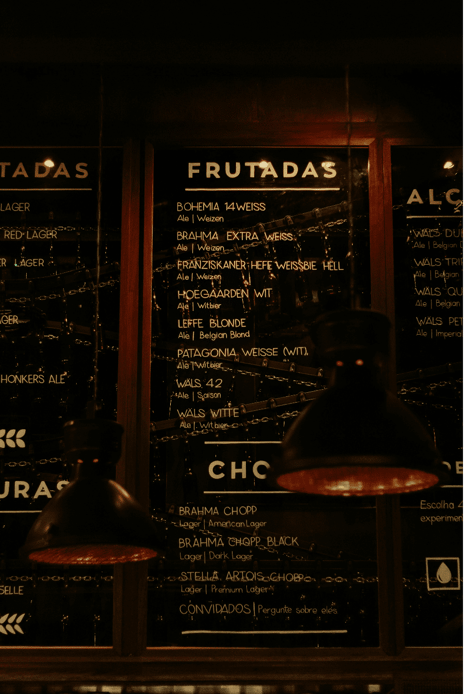
De prompt noemt helderheid, croppen of een specifieke techniek niet. Hij vraagt simpelweg om de inhoud:
image_path = Path("images/bar_menu.jpg")
image_part = types.Part.from_bytes(
data=image_path.read_bytes(), mime_type="image/jpeg"
)
prompt = (
"Read every drink listed on this menu board, including the ones "
"partially hidden behind the lamps and on the side panels. For "
"each drink, give me the name and beer style."
)Standaard vision leest het goed verlichte middenpaneel zonder moeite en haalt acht bieren uit de sectie "FRUTADAS" en vier uit "CHOPP". Maar het linker paneel komt zo terug:
[ANSWER]
### Left Panel (Partially visible)
* **[Unreadable] LAGER** | [Style unreadable]
* **RED LAGER** | [Style unreadable]
* **[Unreadable] LAGER** | [Style unreadable]
* **[Unreadable]GER** | [Style unreadable]
* **HONKERS ALE** | [Style unreadable]
* **[Unreadable]SELLE** | [Style unreadable]Zes entries, de meeste met onleesbare namen en allemaal zonder stijl. Het model ziet dat er tekst staat, maar kan het niet ontcijferen.
De agentic-call draait twee coderondes. Eerst cropt het alle drie de panelen:
[CODE]
middle_panel = [200, 320, 950, 780]
left_panel = [200, 0, 950, 260]
right_panel = [200, 840, 700, 1000]
# ... crops and saves each region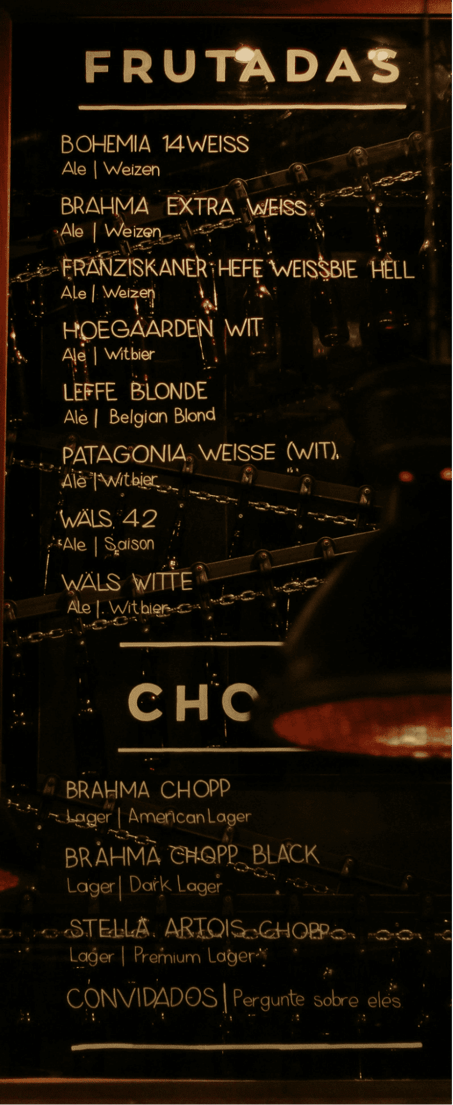
Na het observeren van die crops besluit het model dat het linker en rechter paneel meer zoom nodig hebben. Het voert een tweede ronde uit:
[CODE]
left_panel_top = [100, 0, 500, 250]
left_panel_bottom = [500, 0, 980, 250]
right_panel_top = [100, 800, 600, 1000]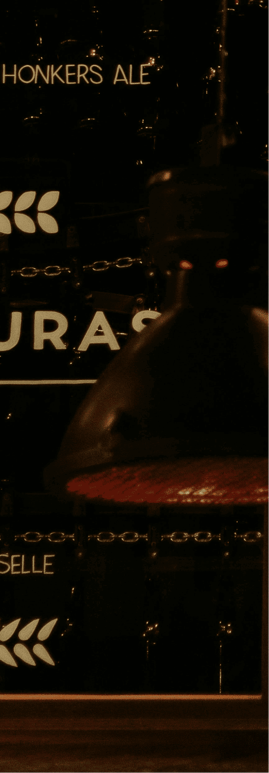
Met die extra zoom herstelt het model namen die standaard vision als onleesbaar labelde: Amber Lager, Honkers Ale (Goose Island) en Demoiselle (Colorado) van het linker paneel, plus Wals Dubbel, Tripel, Quadrupel en Petroleum van het rechter. Het identificeert ook de kop van het linker paneel als "MISTURAS" en die van het rechter als "ALCOÓLICAS".
De prompt zei nooit "crop de panelen" of "zoom in op de donkere gebieden." Hij vroeg om de drankjes en hun stijlen, en het model redeneerde vanaf dat doel terug.
Wat dit voorbeeld anders maakt dan de supermarktstelling is de tweede pass. Na de eerste ronde crops keek het model naar wat het had, besloot dat linker en rechter panelen nog steeds te moeilijk te lezen waren, en voerde zelfstandig een tweede ronde met krapper ingezoomde crops uit.
De loop corrigeerde zichzelf.
Dat is de opbrengst van de methode openlaten: het model preprocesst niet één keer, het herhaalt tot de resultaten voldoen aan de lat die de prompt legt.
Tellen en annoteren met agentic vision in Gemini 3
Het barmenu werkte omdat de prompt de methode openliet en het model zelf uitvogelde wat te doen. Dat geldt niet altijd. Soms heeft het model expliciete instructies nodig over welke tool te gebruiken, en dit volgende voorbeeld laat zien waar die grens ligt.
De onderstaande afbeelding toont munten verspreid over een bureau en een zwarte map. Sommige overlappen, enkele zijn deels verborgen, en de mix van koper en zilver maakt het makkelijk om de tel kwijt te raken.
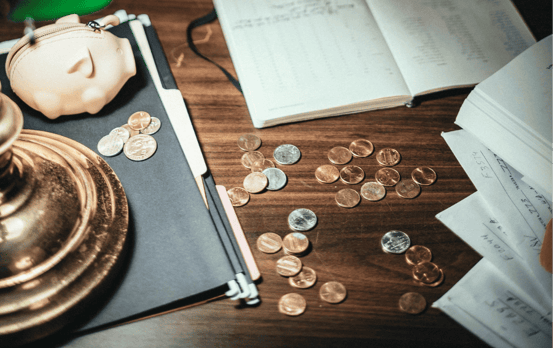
Een logische eerste aanpak is het model te vragen elke munt te annoteren zodat het van zijn eigen markeringen kan tellen. Google’s documentatie bevestigt dat agentic vision direct op afbeeldingen bounding boxes en labels kan tekenen met PIL en OpenCV in de sandbox. Dus:
image_path = Path("images/coins.jpg")
image_part = types.Part.from_bytes(
data=image_path.read_bytes(), mime_type="image/jpeg"
)
prompt_v1 = (
"Count every coin in this image. Draw a bounding box or circle "
"around each one and number them. Check for overlapping or "
"partially hidden coins. Give me the final count."
)
response_v1 = client.models.generate_content(
model=MODEL,
contents=[image_part, prompt_v1],
config=agentic_config,
)
print_response(response_v1, show_thoughts=True)Het model cropt vijf regio’s, analyseert elk en geeft een telling van 34. Maar kijk naar het antwoordformaat:
[ANSWER] Final Count: 34 coins in total.
[
{"box_2d": [387, 175, 451, 236], "label": "1"},
{"box_2d": [356, 196, 407, 248], "label": "2"},
{"box_2d": [319, 231, 375, 274], "label": "3"},
...
]Het gaf boundingbox-coördinaten als JSON terug in plaats van iets op de afbeelding te tekenen. De prompt zei "draw", maar het model zag dat als een beschrijvingstaak en gaf gestructureerde tekstoutput.
De documentatie over code-executie hint waarom: "Terwijl het model automatisch inzoomt voor kleine details, moet je het expliciet vragen om code te gebruiken voor andere taken." Het woord "draw" is vaag genoeg dat het model het pad met alleen tekst koos.
De taak beschrijven in termen van de code die je wilt dat het draait, haalt die vaagheid weg:
prompt_v2 = (
"Count every coin in this image. Use Python to draw a numbered "
"bounding box on the image around each coin you find. Check for "
"overlapping or partially hidden coins. After annotating, give "
"me the final count."
)
response_v2 = client.models.generate_content(
model=MODEL,
contents=[image_part, prompt_v2],
config=agentic_config,
)
print_response(response_v2, show_thoughts=True)Dit keer schrijft het model echte tekencode:
[CODE]
import PIL.Image
import PIL.ImageDraw
img = PIL.Image.open('input_file_0.jpeg')
width, height = img.size
coins = [
[383, 175, 452, 227], [352, 196, 411, 255], ... # 34 total
]
draw = PIL.ImageDraw.Draw(img)
for i, coin in enumerate(coins):
ymin, xmin, ymax, xmax = coin
left, top, right, bottom = (xmin*width/1000, ymin*height/1000,
xmax*width/1000, ymax*height/1000)
draw.rectangle([left, top, right, bottom], outline='red', width=3)
draw.text((left, top), str(i + 1), fill='red')
[RESULT] (Outcome.OUTCOME_OK)
Total coins detected: 34
[IMAGE] image/png, 3,685,043 bytes
[ANSWER] I have identified and counted a total of 34 coins.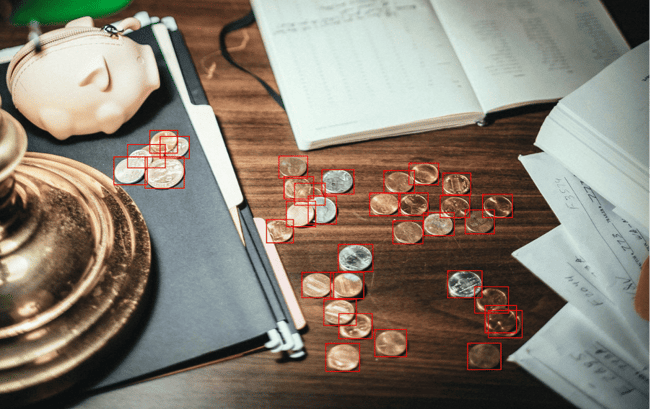
Elke munt krijgt een rood kader en een nummer. De daadwerkelijke telling is 35 of 36, afhankelijk van hoe je twee overlappende munten onderaan het kader beoordeelt.
Het model kwam uit op 34 en miste er één of twee in die cluster. Maar de annotatie werkt als een visueel kladblok: in plaats van een getal dat je op goed vertrouwen moet aannemen, krijg je een verifieerbaar artefact dat je vakje voor vakje kunt controleren.
De volledige niet-ingekorte output voor beide calls staat in deze gist.
Meerstaps-extractie en plotten
De vorige voorbeelden hadden elk één hoofdtaak (tekst lezen, objecten tellen). Dit voorbeeld schakelt er meerdere achter elkaar: crop een tabel uit een foto, extraheer de getallen naar een DataFrame en genereer een grafiek. De afbeelding is een IRS-achtige belastingtabel gefotografeerd op een bureau met een rekenmachine.
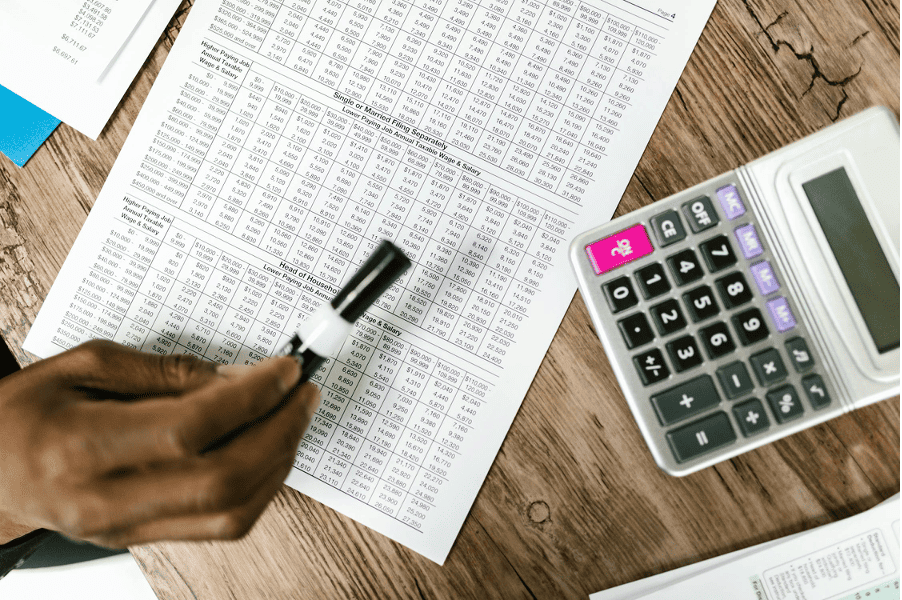
De prompt beschrijft de volledige pipeline in één keer:
image_path = Path("images/data_table.jpg")
image_part = types.Part.from_bytes(
data=image_path.read_bytes(), mime_type="image/jpeg"
)
prompt = (
"Crop and zoom into the table in this image. Extract the first "
"10 rows of data into a structured format. Identify the column "
"headers. Then create a bar chart comparing the values in the "
"numeric columns for those 10 rows. Summarize which row has the "
"highest and lowest values."
)
response = client.models.generate_content(
model=MODEL,
contents=[image_part, prompt],
config=agentic_config,
)
print_response(response, show_thoughts=True)Het model neemt vier coderondes om van de volledige foto tot een afgewerkte grafiek te komen. De eerste drie zijn progressieve zoomen: het cropt de tabel "Single or Married Filing Separately", dan de kolomkoppen, dan de eerste 10 rijen data, waarbij het vijf tussenafbeeldingen genereert. Hier is de eerste crop waarin het de tabel isoleert:
Tegen ronde vier heeft het genoeg detail gelezen om de getallen te extraheren. Het bouwt een pandas DataFrame, print de tabel en genereert een gegroepeerd staafdiagram in één codeblok:
[CODE]
import matplotlib.pyplot as plt
import pandas as pd
data = [
{"Higher Paying Job Wage": "$0 - 9,999",
"$0 - 9,999": 0, "$10,000 - 19,999": 940,
"$20,000 - 29,999": 1020, "$30,000 - 39,999": 1020},
... # 10 rows total
]
df = pd.DataFrame(data)
df.set_index("Higher Paying Job Wage").plot(kind='bar', figsize=(12, 6))
plt.title('Tax Table: Single or Married Filing Separately')
plt.ylabel('Tax Amount')
plt.savefig('tax_bar_chart.png')De geëxtraheerde tabel:
|
Higher Paying Job Wage |
$0 - 9,999 |
$10,000 - 19,999 |
$20,000 - 29,999 |
$30,000 - 39,999 |
|
$0 - 9,999 |
$0 |
$940 |
$1,020 |
$1,020 |
|
$10,000 - 19,999 |
$940 |
$1,540 |
$1,620 |
$2,020 |
|
$20,000 - 29,999 |
$1,020 |
$1,620 |
$2,100 |
$3,100 |
|
$30,000 - 39,999 |
$1,020 |
$2,020 |
$3,100 |
$4,100 |
|
$40,000 - 59,999 |
$1,870 |
$3,470 |
$4,550 |
$5,550 |
|
$60,000 - 79,999 |
$1,870 |
$3,470 |
$4,690 |
$5,890 |
|
$80,000 - 99,999 |
$2,000 |
$3,810 |
$5,090 |
$6,290 |
|
$100,000 - 124,999 |
$2,040 |
$3,840 |
$5,120 |
$6,320 |
|
$125,000 - 149,999 |
$2,040 |
$3,840 |
$5,120 |
$6,910 |
|
$150,000 - 174,999 |
$2,220 |
$4,830 |
$6,910 |
$8,910 |
En de gegenereerde staafgrafiek:
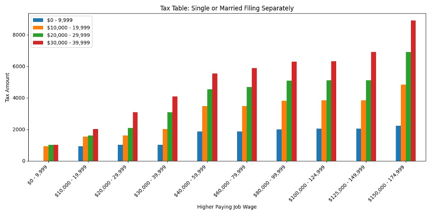
De volledige niet-ingekorte output staat in deze gist.
Eén API-call leverde een gestructureerde DataFrame op, een samenvatting met de rijen met hoogste en laagste waarde, en een publicatieklare staafgrafiek. De prompt noemde vier dingen (crop, extraheren, grafiek, samenvatten), en het model behandelde elk als een fase in een pipeline waar de output van de ene stap de input voor de volgende was.
Eerdere voorbeelden gebruikten de loop om één bewerking te verfijnen (betere crops, betere annotaties). Dit voorbeeld laat zien dat de loop verschillende bewerkingen aan elkaar rijgt, die elk voortbouwen op wat de vorige ronde opleverde.
Conclusie
Agentic vision verandert één API-call in een feedbackloop waarin het model code schrijft, kijkt naar wat het opleverde en bepaalt wat daarna te doen.
Het supermarktvoorbeeld liet het basispatroon zien: snij regio’s uit die te klein zijn om te lezen en antwoord vanaf de vergrote versies. Het barmenu voegde een tweede dimensie toe, waarbij het model één ronde crops uitvoerde, besloot dat die niet genoeg waren en zelfstandig verder inzoomde op de probleemgebieden.
Bij de munten veranderde annotatie een gok in een controleerbaar artefact. De belastingtabel schakelde vier verschillende bewerkingen achter elkaar (crop, extraheren, berekenen, plotten) binnen één request.
Elk voorbeeld onthulde ook iets over prompten. Een lat voor compleetheid zetten ("som alle producten op") duwde het model richting grondigheid. De methode openlaten liet het zijn eigen preprocessingpad kiezen.
Maar dubbelzinnige werkwoorden zoals "draw" stuurden het soms het verkeerde spoor op, en overschakelen naar "Use Python to draw" loste dat op.
Het patroon: beschrijf wat je geproduceerd wilt hebben, wees specifiek over de tool wanneer de taak dubbelzinnig is, en laat de loop de rest afhandelen.
Alle code uit deze tutorial draait met gemini-3-flash-preview en de google-genai-SDK. Wil je dieper gaan, dan behandelt DataCamps Introduction to AI Agents-cursus het loop-patroon achter dit alles.
Agentic Vision in Gemini 3 FAQ's
Wat is agentic vision in Gemini 3 Flash?
Agentic vision is een functie waarbij Gemini 3 Flash tijdens een antwoord Python-code kan schrijven en uitvoeren om afbeeldingen te manipuleren voordat het antwoordt. Het gebruikt een Think-, Act-, Observe-loop om in een gesandboxte omgeving afbeeldingen te croppen, te zoomen, te annoteren en te verbeteren, allemaal binnen één API-call.
Hoe schakel ik agentic vision in de Gemini API in?
Voeg een code-executietool toe aan je GenerateContentConfig: tools=[types.Tool(code_execution=types.ToolCodeExecution())]. Dit geeft het model toegang tot een gesandboxte Python-omgeving met 43 voorgeïnstalleerde libraries, waaronder PIL, OpenCV en matplotlib.
Waarom slaat het model code-executie over, zelfs als het is ingeschakeld?
Het model schrijft alleen code wanneer het besluit dat één blik op de afbeelding niet genoeg is. Als het met de oorspronkelijke resolutie zeker kan antwoorden, slaat het het code-executiepad over. Dit is met opzet en gedocumenteerd door Google.
Wat is het verschil tussen "draw" en "Use Python to draw" in prompts?
"Draw" is dubbelzinnig en het model kan tekstbeschrijvingen of JSON-coördinaten teruggeven in plaats van een echte afbeelding. Door "Use Python to draw" toe te voegen, geef je aan dat het model uitvoerbare code moet schrijven die een visuele output produceert, wat het code-executiepad betrouwbaar triggert.
Kan ik agentic vision combineren met custom function calling?
Nee. Code-executie en custom function calling kunnen niet in dezelfde API-call worden gebruikt. Als je workflow beide nodig heeft, moet je aparte calls doen.

Ik ben een contentmaker op het gebied van data science met meer dan 2 jaar ervaring en een van de grootste achterbannen op Medium. Ik schrijf graag uitgebreide artikelen over AI en ML met een vleugje sarcastische stijl, want je moet toch íets doen om ze wat minder saai te maken. Ik heb meer dan 130 artikelen en een DataCamp-cursus gemaakt, en er is nog een nieuwe in de maak. Mijn content is door meer dan 5 miljoen paar ogen gezien, van wie 20k volgers werden op zowel Medium als LinkedIn.
Je stuurt een afbeelding naar een vision-API met de vraag om een klein prijslabel te lezen. Het antwoord komt zelfverzekerd terug—en fout. Hetzelfde bij het tellen van objecten in een rommelige foto: het model kijkt één keer naar de volledige afbeelding en gokt een totaal dat er ver naast zit.
Gemini 3 Flash pakt dit anders aan. Met code-executie ingeschakeld kan het halverwege een antwoord Python schrijven en uitvoeren om afbeeldingen te croppen, in te zoomen en te annoteren voordat het zich vastlegt op een antwoord. Google noemt dit agentic vision en meldt een kwaliteitswinst van 5–10% op vision-benchmarks.
Deze tutorial loopt door vier voorbeelden die steeds lastiger worden: piepkleine tekst lezen in een supermarktstelling, dranknamen van een schemerig barmenu halen, verspreide munten tellen en tabeldata extraheren naar een grafiek.
Wat is agentic vision? De "Think, Act, Observe"-loop
Het idee is eenvoudig. Met code-executie actief kan Gemini 3 halverwege stoppen, Python schrijven en uitvoeren in een sandbox, kijken wat de code opleverde en bepalen wat de volgende stap is.
Voor vision-taken betekent dit meestal dat het model delen van een afbeelding uitsnijdt, ze vergroot, bounding boxes tekent of het contrast aanpast om details naar voren te halen die op de oorspronkelijke resolutie niet zichtbaar zijn.
Dit verloopt als een driefasige loop.
Tijdens Think kijkt het model naar wat het heeft (de originele afbeelding, of een versie die al is gecropt of geannoteerd) en plant de volgende stap. Het kan besluiten dat een prijslabel te klein is om te lezen en moet worden gecropt en vergroot.
Act zet dat plan om in Python. De sandbox heeft 43 voorgeïnstalleerde libraries (PIL, OpenCV, matplotlib en meer), dus het model kan de beeldbewerkingscode schrijven die het nodig heeft.
Na het uitvoeren van de code sluit Observe de loop. Output (nieuwe afbeeldingen, geprinte tekst, berekende waarden) stroomt terug de context in. Vanaf daar geeft het model ofwel antwoord, of het gaat nog een ronde.
Eén API-call kan meerdere keren door deze loop gaan. In de komende voorbeelden zie je dat het in één request zeven stellingregio’s cropt. In een ander voorbeeld extraheert het tabeldata naar een pandas DataFrame en genereert het een staafdiagram, allemaal binnen dezelfde call.
Als het agentic-loopconcept nieuw voor je is, behandelt DataCamps AI Agent Fundamentals-track dit uitvoerig.
Beperkingen en grenzen
Je omgeving inrichten voor agentic vision
Haal een API-sleutel bij ai.google.dev en sla die op als
GOOGLE_API_KEYin je omgeving of een.env-bestand. Installeer daarna de SDK en beeldbibliotheken:Begin met het aanmaken van de client:
Die
timeout=600_000is belangrijk. Agentic-vision-calls omvatten meerdere rondes van codegeneratie en -uitvoering in de sandbox, en één request kan ongeveer vier minuten duren.De standaard httpx-timeout verbreekt de verbinding ruim daarvoor, waardoor je achterblijft met een stille
ReadTimeouten geen idee wat er is gebeurd.Stel vervolgens de agentic-config in:
toolsis de schakelaar voor code-executie. Het geeft het model een gesandboxte Python-omgeving met 43 libraries (numpy, pandas, PIL, matplotlib, OpenCV en meer). Elk codeblok krijgt 30 seconden om te draaien, en de sandbox probeert bij fouten tot 5 keer opnieuw.thinking_level="HIGH"geeft het model meer ruimte om te plannen voordat het code schrijft. Voor meerstaps vision-werk maakt dit merkbaar verschil.include_thoughts=Truetoont die redenatie in de response-onderdelen, handig voor debugging.media_resolutionbepaalt hoeveel tokens de invoerafbeelding krijgt voordat de loop überhaupt start.MEDIA_RESOLUTION_HIGHis een goede standaard. Je kunt opschalen naarMEDIA_RESOLUTION_ULTRA_HIGHvoor zeer dichte afbeeldingen of terugschakelen naarMEDIA_RESOLUTION_LOWwanneer snelheid belangrijker is dan detail.Dezezelfde setup werkt op Vertex AI met minimale aanpassingen. Voor een bredere walkthrough van de Gemini 3 API buiten vision om, zie de bijbehorende tutorial.
Agentic Vision in Gemini 3: fijne details lezen met crop en zoom
De onderstaande afbeelding is een Duitse supermarktstelling met drie rijen producten. Langs de rand van elke plank staan prijslabels, en onderaan staat een "Liebe Kunden"-mededeling. De labels zijn leesbaar als je zelf inzoomt, maar klein genoeg dat een model dat naar de volledige afbeelding kijkt, moet bepalen wat het wel en niet kan ontcijferen.
De meerledige response parsen
Agentic-responses zijn geen losse tekstblokken. Ze komen binnen als een lijst met onderdelen: denken, code die het model schreef, uitvoerresultaten, gegenereerde afbeeldingen en het eindantwoord. Deze helper loopt ze langs:
Elk voorbeeld in deze tutorial gebruikt dezelfde functie, dus definieer hem één keer en hergebruik hem.
Laad nu de stellingafbeelding en schrijf een prompt die het model vraagt de mededeling te lezen en elk product met prijs op te sommen.
Draai het eerst zonder code-executie:
Hier is een ingekorte versie van de output:
De vertaling van de mededeling klopt, en het model leest de Uncle Ben’s-labels die het herkent. Maar ongeveer een derde van de items is "(Label obscured)", en merken als Oryza, Reis-fit en Reiskugeln komen helemaal niet voor.
Nu dezelfde prompt met de agentic-config:
De outputstructuur is anders. In plaats van één
[ANSWER]doorloopt het de volledige Think/Act/Observe-loop:De zeven crops die het model genereerde:
Na het observeren van die crops geeft het model een volledig antwoord:
De volledige niet-ingekorte output voor beide calls staat in deze gist.
De agentic-response leest 30+ producten over alle drie planken. De Oryza-, Reis-fit-, Madras Curry-, Reiskugeln- en Steam Basmati-items die standaard vision als "(obscured)" labelde, verschijnen nu met namen en prijzen.
Het verschil gaat niet om hallucinatie versus nauwkeurigheid; standaard vision is eerlijk over wat het niet kan lezen. Agentic vision accepteert die beperking simpelweg niet en zoomt in tot het wel kan.
De prompt speelt hier een rol. Door het model te vragen "alle zichtbare productnamen en hun prijzen" op te sommen, leg je de lat voor compleetheid hoger en duw je het richting croppen.
Een vagere prompt zoals "beschrijf deze afbeelding" zou waarschijnlijk een eenmalig antwoord opleveren, zelfs met code-executie aan, omdat het model geen reden ziet om verder te gaan.