

Program
AI Ajanının Temelleri
6 sa
Küçük bir fiyat etiketini okumasını isteyerek bir görme API’sine görüntü gönderiyorsunuz. Yanıt kendinden emin ve yanlış geliyor. Dağınık bir fotoğrafta nesne sayma da aynı: model tüm görüntüye bir kez bakıyor ve hedeften çok uzak bir sayı tahmin ediyor.
Gemini 3 Flash bunu farklı ele alıyor. Kod yürütme açıkken, yanıt ortasında Python yazıp çalıştırarak görüntüleri kırpabilir, yakınlaştırabilir ve açıklama ekleyebilir; sonra yanıta karar verir. Google buna etken görme diyor ve görsel kıyaslamalarda %5–10 kalite artışı bildiriyor.
Bu eğitim, giderek zorlaşan dört örnek üzerinden ilerliyor: market rafından küçük puntoları okumak, loş ışıklı bar menüsünden içecek adlarını çekmek, dağılmış madeni paraları saymak ve tablo verisini grafiğe aktarmak.
Fikir basit. Kod yürütme aktifken, Gemini 3 yanıtın ortasında durabilir, bir kum havuzunda Python yazıp çalıştırabilir, kodun ürettiğine bakabilir ve bir sonraki adımı belirleyebilir.
Görsel görevlerde bu genellikle görüntünün bölgelerini kesip çıkarmak, büyütmek, sınırlayıcı kutular çizmek veya kontrastı ayarlayarak özgün çözünürlükte görünmeyen ayrıntıları ortaya çıkarmak anlamına gelir.
Bu, üç aşamalı bir döngü olarak işler.
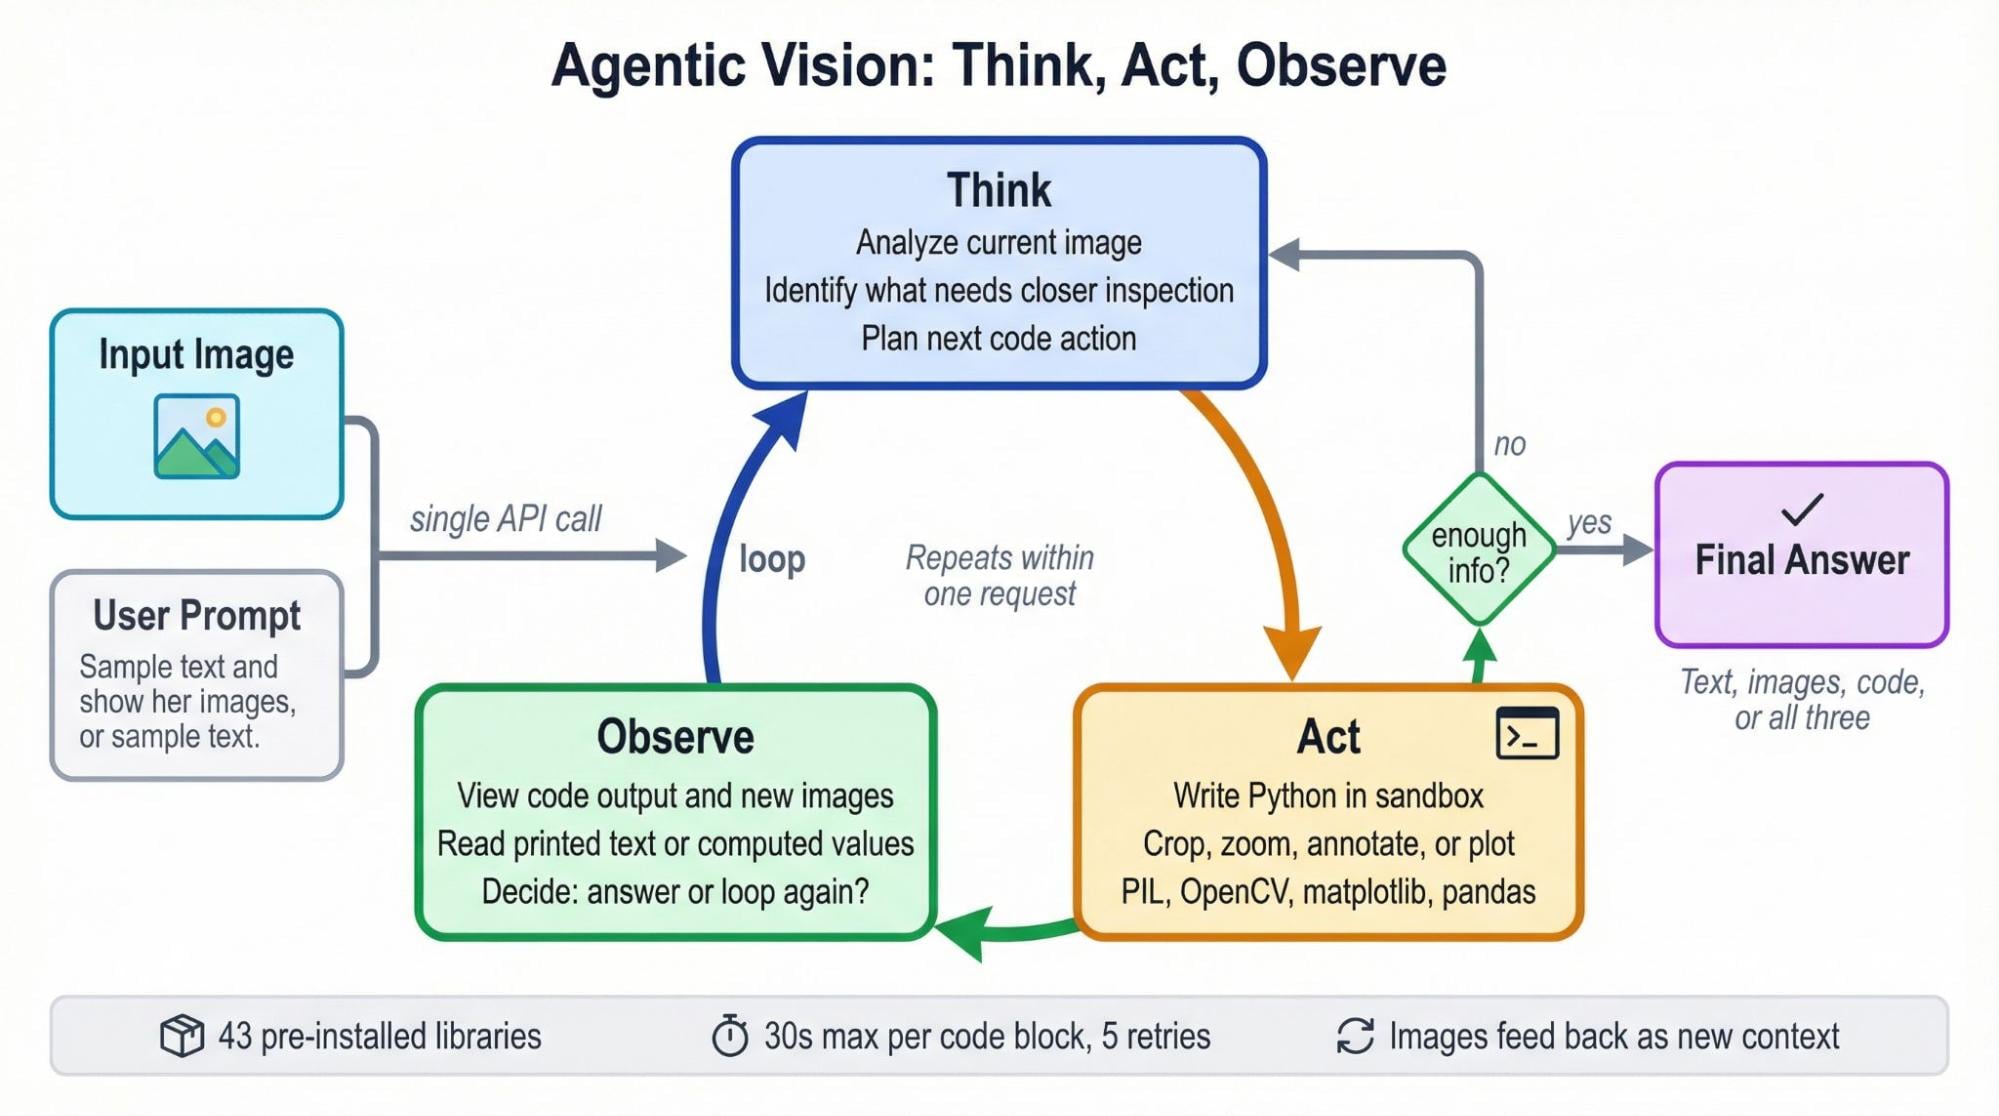
Think sırasında model elindekine (özgün görüntü veya zaten kırpılmış/açıklama eklenmiş sürüm) bakar ve bir sonraki hamlesini planlar. Örneğin bir fiyat etiketinin okunamayacak kadar küçük olduğuna karar verip kırpılıp büyütülmesi gerektiğini düşünebilir.
Act bu planı Python’a dönüştürür. Kum havuzunda 43 ön yüklü kütüphane (PIL, OpenCV, matplotlib ve daha fazlası) vardır; model ihtiyaç duyduğu görüntü işleme kodunu yazabilir.
Kod çalıştıktan sonra Observe döngüyü kapatır. Çıktı (yeni görüntüler, yazdırılan metin, hesaplanan değerler) bağlama geri beslenir. Buradan model ya yanıtlar ya da döngüye tekrar girer.
Tek bir API çağrısı bu döngüyü birden çok kez çevrimleyebilir. İlerideki örneklerde tek istekte yedi raf bölgesini kırptığını göreceksiniz. Başka bir örnekte tablo verilerini bir pandas DataFrame’ine çıkarıp aynı çağrıda çubuk grafik üretiyor.
Etken döngü kavramı sizin için yeniyse, DataCamp’in AI Agent Fundamentals öğrenim yolunda bu konu ayrıntılı olarak ele alınıyor.
Bir API anahtarı alın: ai.google.dev ve bunu ortamınızda veya bir .env dosyasında GOOGLE_API_KEY olarak saklayın. Ardından SDK ve görüntü kütüphanelerini kurun:
pip install google-genai python-dotenv Pillow matplotlib opencv-pythonİlk olarak istemciyi oluşturun:
from google import genai
from google.genai import types
from dotenv import load_dotenv

load_dotenv()

client = genai.Client(
    http_options=types.HttpOptions(timeout=600_000)
)
MODEL = "gemini-3-flash-preview"
Şu timeout=600_000 önemli. Etken görme çağrıları, kum havuzunda çoklu kod üretme ve yürütme turları içerir; tek bir istek yaklaşık dört dakika sürebilir.
Varsayılan httpx zaman aşımı bağlantıyı çok daha önce keser; sizi sessiz bir ReadTimeout ile ve ne olduğuna dair ipucu olmadan bırakır.
Şimdi etken yapılandırmayı kurun:
agentic_config = types.GenerateContentConfig(
    tools=[types.Tool(code_execution=types.ToolCodeExecution())],
	thinking_config=types.ThinkingConfig(
    	thinking_level="HIGH",
    	include_thoughts=True
	),
    media_resolution=types.MediaResolution.MEDIA_RESOLUTION_HIGH,
)
tools kod yürütmenin açma düğmesidir. Modele 43 kütüphaneli (numpy, pandas, PIL, matplotlib, OpenCV ve daha fazlası) izole bir Python ortamı sağlar. Her kod bloğunun çalışması için 30 saniye vardır ve kum havuzu hatalarda en fazla 5 kez yeniden dener.
thinking_level="HIGH" modelin kod yazmadan önce daha fazla plan yapmasına olanak verir. Çok adımlı görsel işlerde fark edilir bir katkı sağlar. include_thoughts=True ise yanıttaki parçalarda bu akıl yürütmeyi görünür kılar; hata ayıklamada faydalıdır.
media_resolution döngü başlamadan önce girdi görüntüsünün kaç token alacağını ayarlar. MEDIA_RESOLUTION_HIGH iyi bir varsayılandır. Çok yoğun görüntüler için MEDIA_RESOLUTION_ULTRA_HIGH’a çıkabilir veya hız ayrıntıdan önemliyse MEDIA_RESOLUTION_LOW’a inebilirsiniz.
Aynı kurulum Vertex AI üzerinde çok az değişiklikle çalışır. Görme dışındaki Gemini 3 API için daha geniş bir anlatım için eşlik eden eğitime bakın.
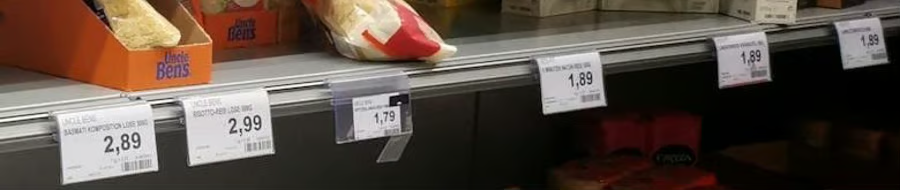
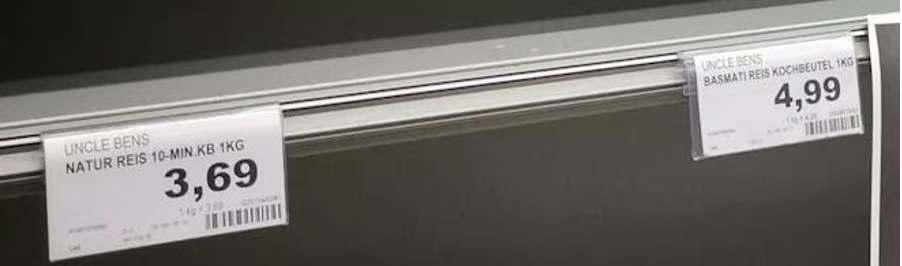
Aşağıdaki görüntü üç sıra üründen oluşan bir Alman market rafı. Her raf kenarında fiyat etiketleri var ve altta "Liebe Kunden" (Değerli Müşteriler) notu yer alıyor. Siz kendiniz yakınlaştırırsanız etiketler okunabilir; ancak model tüm görüntüye baktığında hangisini ayırt edip hangisini edemeyeceğine karar vermesi gerekiyor.
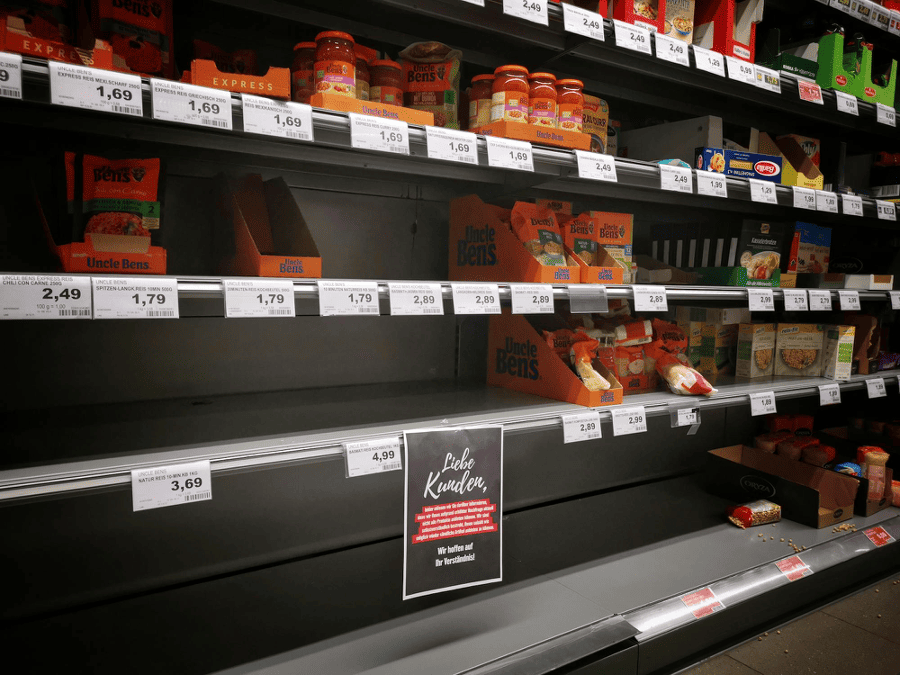
Etken yanıtlar tek bir metin bloğu değildir. Düşünme, modelin yazdığı kod, yürütme sonuçları, üretilen görüntüler ve nihai yanıttan oluşan parça listesi olarak gelirler. Şu yardımcı işlev bunları adım adım gezer:
def print_response(response, show_thoughts=False):
	for part in response.candidates[0].content.parts:
    	if part.thought and show_thoughts:
        	print("[THINK]", part.text[:500])
    	elif part.executable_code:
        	print("[CODE]")
        	print(part.executable_code.code)
    	elif part.code_execution_result:
        	print(f"[RESULT] ({part.code_execution_result.outcome})")
            print(part.code_execution_result.output)
    	elif part.inline_data:
        	print(f"[IMAGE] {part.inline_data.mime_type}, "
                  f"{len(part.inline_data.data):,} bytes")
    	elif part.text:
        	print("[ANSWER]", part.text)
Bu eğitimdeki her örnek aynı işlevi kullanır; bir kez tanımlayın ve tekrar kullanın.
Şimdi raf görüntüsünü yükleyin ve modelden tabelayı okumasını ve her ürünü fiyatıyla birlikte listelemesini isteyen bir komut yazın.
from pathlib import Path

image_path = Path("images/grocery_shelf.jpg")
image_part = types.Part.from_bytes(
	data=image_path.read_bytes(), mime_type="image/jpeg"
)

prompt = (
	"Read the 'Liebe Kunden' sign at the bottom of the shelf. "
	"What does it say? Also list all visible product names "
	"and their prices from the shelf labels."
)
İlk olarak kod yürütme olmadan çalıştırın:
standard_config = types.GenerateContentConfig(
    media_resolution=types.MediaResolution.MEDIA_RESOLUTION_HIGH,
)

standard_response = client.models.generate_content(
	model=MODEL,
	contents=[image_part, prompt],
	config=standard_config,
)
print_response(standard_response)
Çıktının kısaltılmış bir sürümü şöyle:
[ANSWER] Based on the image provided, here is the information requested:

### The 'Liebe Kunden' Sign
> "Dear Customers, unfortunately, we must inform you that due to
> increased demand, we cannot currently offer all products..."

### Product Names and Prices (from shelf labels)

**Top Row Labels:**
*   Uncle Ben's Express Reis Mexi-Scharf 250g: 1,69
*   Uncle Ben's Express Reis Griechisch 250g: 1,69
*   Uncle Ben's Express Reis Curry 250g: 1,69
*   Channa Masala 300g (partially obscured): 2,49
*   (Label obscured): 2,49
*   (Label obscured): 1,29
*   (Label obscured): 0,99
...

**Second Row Labels:**
*   Uncle Ben's Express Reis Chili con Carne 250g: 2,49
*   Uncle Ben's Spitzen-Langkorn Reis 10 Min 500g: 1,79
*   (Label obscured): 2,99
*   (Label obscured): 2,79
...
Tabela çevirisi doğru ve model tanıyabildiği Uncle Ben’s etiketlerini okuyor. Ancak girdilerin yaklaşık üçte biri "(Label obscured)" ve Oryza, Reis-fit, Reiskugeln gibi markalar hiç görünmüyor.
Şimdi aynı komutu etken yapılandırmayla çalıştırın:
agentic_response = client.models.generate_content(
	model=MODEL,
	contents=[image_part, prompt],
	config=agentic_config,
)
print_response(agentic_response, show_thoughts=True)
Çıktı yapısı farklı. Tek bir [ANSWER] yerine, tam Think/Act/Observe döngüsünü adım adım ilerletiyor:
[THINK] Okay, so the primary goal here is twofold: First, I need to
decipher that "Liebe Kunden" sign down there. Then, I need to build a
comprehensive list of what's on this shelf...

[CODE]
import PIL.Image

img = PIL.Image.open('input_file_0.jpeg')
width, height = img.size

crops = [
	{'box_2d': [630, 447, 887, 559], 'label': 'liebe_kunden_sign'},
	{'box_2d': [80, 40, 240, 560], 'label': 'shelf1_left'},
	{'box_2d': [190, 550, 310, 980], 'label': 'shelf1_right'},
	{'box_2d': [400, 0, 480, 450], 'label': 'shelf2_left'},
	{'box_2d': [410, 450, 480, 1000], 'label': 'shelf2_right'},
	{'box_2d': [630, 130, 760, 460], 'label': 'shelf3_left'},
	{'box_2d': [550, 600, 660, 990], 'label': 'shelf3_right'},
]
# ... crops and saves each region

[IMAGE] image/png, 135,953 bytes
[IMAGE] image/png, 90,395 bytes
[IMAGE] image/png, 125,816 bytes
[IMAGE] image/png, 102,288 bytes
[IMAGE] image/png, 173,606 bytes
[IMAGE] image/png, 283,263 bytes
[IMAGE] image/png, 100,522 bytes
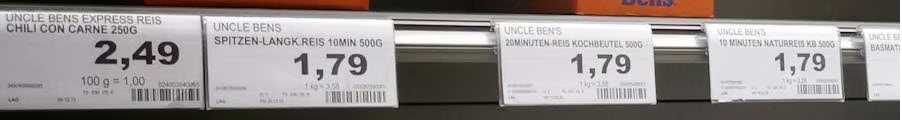
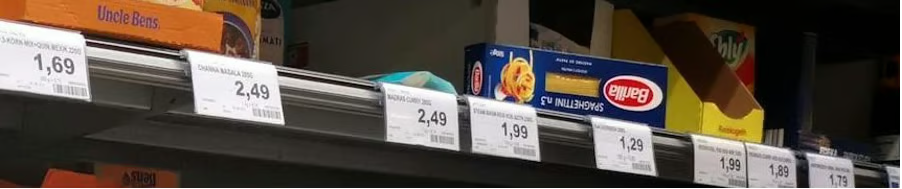
Modelin ürettiği yedi kırpma:
Bu kırpmaları gözlemledikten sonra model eksiksiz bir yanıt üretiyor:
[ANSWER]
**Top Shelf (Left to Right):**
*   Uncle Ben's Express Reis Mexi. Scharf 250g: 1,69 €
*   Channa Masala 285g: 2,49 €
*   Madras Curry 285g: 2,49 €
*   Steam Basmati Reis Kochbeutel 250g: 1,99 €
*   Reiskugeln Pur 4x2 St: 1,99 €
...

**Middle Shelf (Left to Right):**
*   Uncle Ben's Express Reis Chili con Carne 250g: 2,49 €
*   Oryza Langkorn & Wildreis 500g Kochbeutel: 2,99 €
*   Oryza Basmati & Wildreis 500g Kochbeutel: 2,79 €
*   Oryza Jasmin Reis 500g Kochbeutel: 2,79 €
...

**Bottom Shelf (Left to Right):**
*   Uncle Ben's Natur Reis 10-Min. Kochbeutel 1kg: 3,69 €
*   Reis-fit 10 Minuten Natur-Reis 500g: 1,89 €
*   Reis-fit Langkorn & Wildreis 500g: 1,89 €
...
Her iki çağrının da tam, kısaltılmamış çıktıları bu gist’te mevcut.
Etken yanıt üç raf boyunca 30’dan fazla ürünü okuyor. Standart görmede "(obscured)" olarak kalan Oryza, Reis-fit, Madras Curry, Reiskugeln ve Steam Basmati ürünleri ad ve fiyatlarıyla görünüyor.
Fark, halüsinasyon ile doğruluk arasında değil; standart görme okuyamadığını dürüstçe söylüyor. Etken görme sadece bu sınıra razı olmuyor ve okuyana kadar yakınlaştırıyor.
İstemin de rolü var. Modele "tüm görünür ürün adlarını ve fiyatlarını listele" demek, onu kırpmaya yönelten bir eksiksizlik eşiği koyuyor.
"Bu görüntüyü açıkla" gibi daha muğlak bir komut, kod yürütme açık olsa bile büyük olasılıkla tek geçişte bir yanıt üretirdi; çünkü model daha ileri gitmek için bir sebep görmezdi.
Bu görüntü loş ışıkta çekilmiş Brezilya’ya ait bir bar menüsü. Altın renkli yazıyla içeceklerin listelendiği üç cam panel var; ancak sarkıt lambalar sol panelin kısımlarını kapatıyor, sağ panel kadrajın kenarında zar zor görünüyor ve cam yansımaları yüzeye yayılmış durumda.
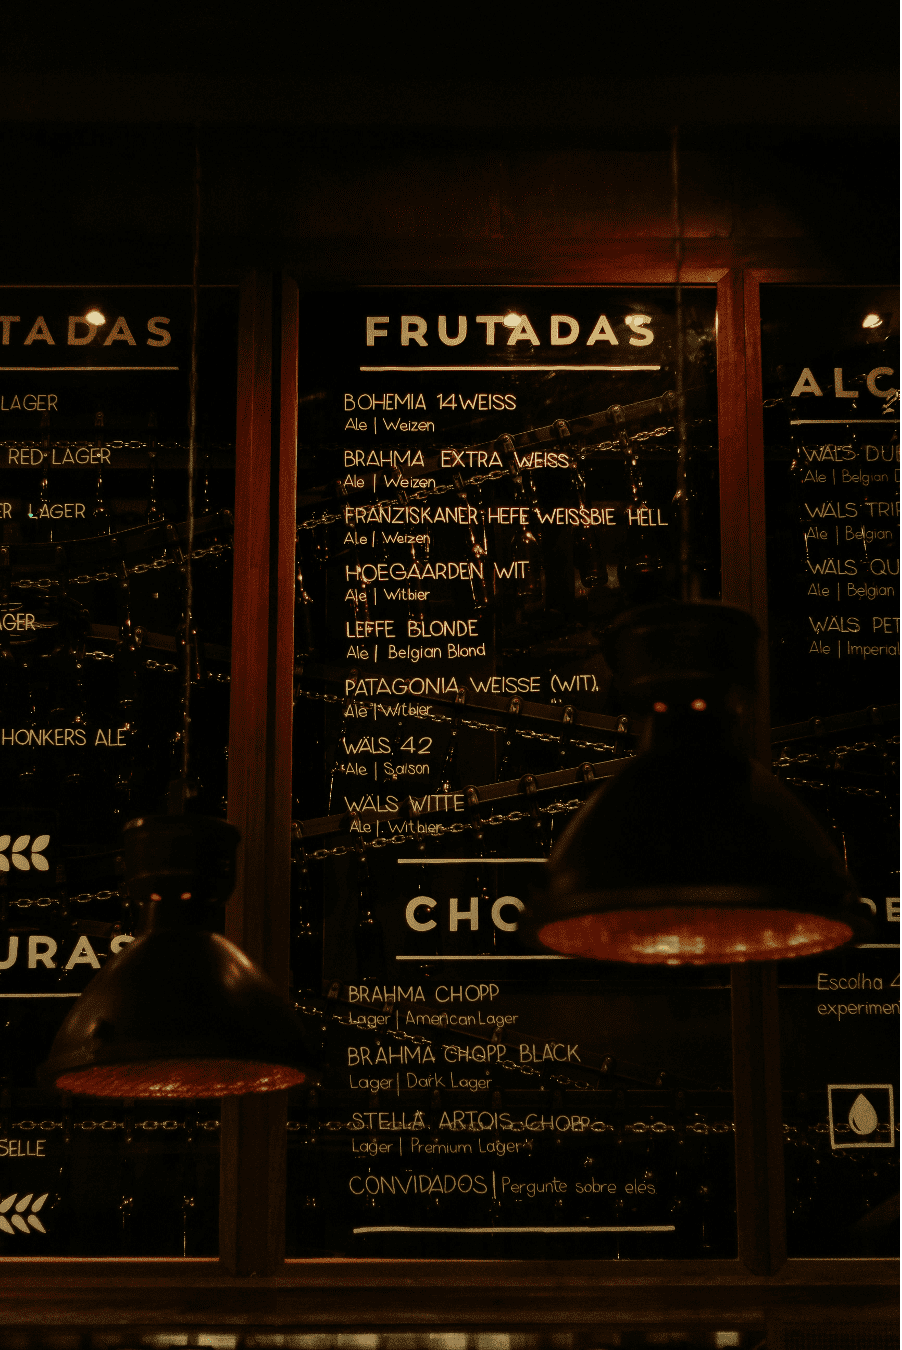
Komutta parlaklık, kırpma veya belirli bir teknikten söz edilmiyor. Sadece içeriği istiyor:
image_path = Path("images/bar_menu.jpg")
image_part = types.Part.from_bytes(
	data=image_path.read_bytes(), mime_type="image/jpeg"
)

prompt = (
	"Read every drink listed on this menu board, including the ones "
	"partially hidden behind the lamps and on the side panels. For "
	"each drink, give me the name and beer style."
)
Standart görme, "FRUTADAS" bölümünden sekiz ve "CHOPP" bölümünden dört birayı güçlü aydınlatılmış orta panelden sorunsuz okuyor. Ancak sol panel şöyle dönüyor:
[ANSWER]
### Left Panel (Partially visible)
*   **[Unreadable] LAGER** | [Style unreadable]
*   **RED LAGER** | [Style unreadable]
*   **[Unreadable] LAGER** | [Style unreadable]
*   **[Unreadable]GER** | [Style unreadable]
*   **HONKERS ALE** | [Style unreadable]
*   **[Unreadable]SELLE** | [Style unreadable]
Altı girdi; çoğunun adı okunamıyor ve stillerinin tamamı eksik. Model orada metin olduğunu görüyor ama ayırt edemiyor.
Etken çağrı iki kod turu çalıştırıyor. İlkinde üç panelin tamamını kırpıyor:
[CODE]
middle_panel = [200, 320, 950, 780]
left_panel = [200, 0, 950, 260]
right_panel = [200, 840, 700, 1000]
# ... crops and saves each region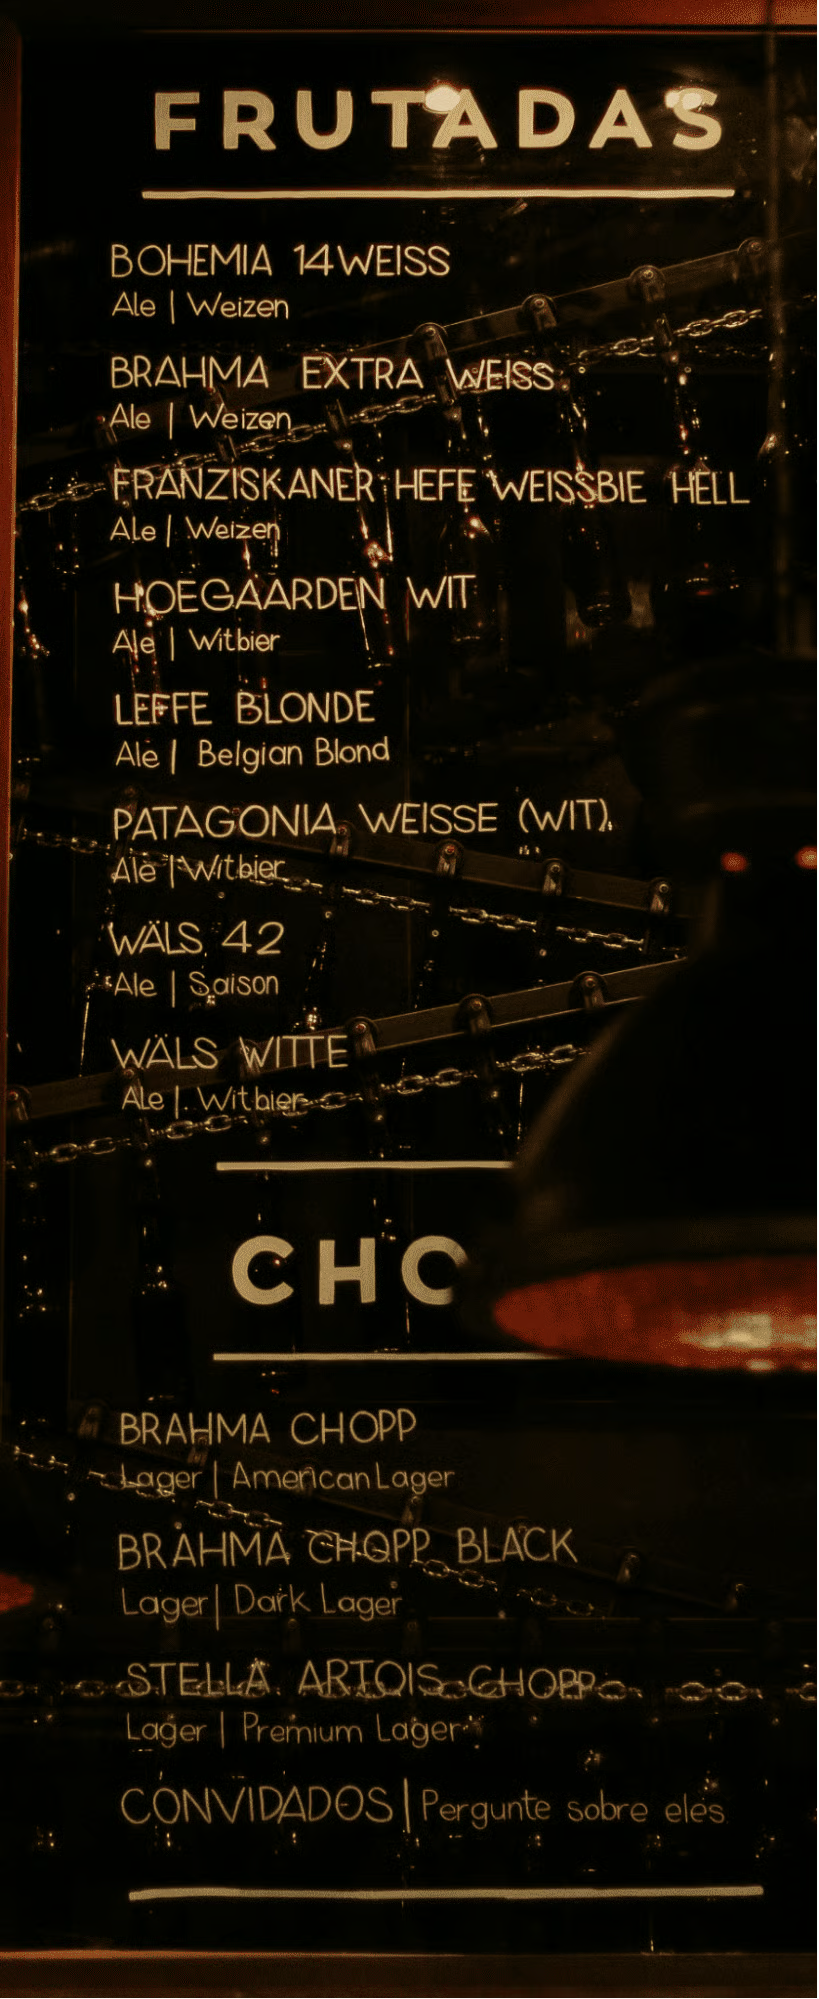
Bu kırpmaları gözlemledikten sonra model sol ve sağ panellerin daha fazla yakınlaştırmaya ihtiyaç duyduğuna karar veriyor. İkinci turu çalıştırıyor:
[CODE]
left_panel_top = [100, 0, 500, 250]
left_panel_bottom = [500, 0, 980, 250]
right_panel_top = [100, 800, 600, 1000]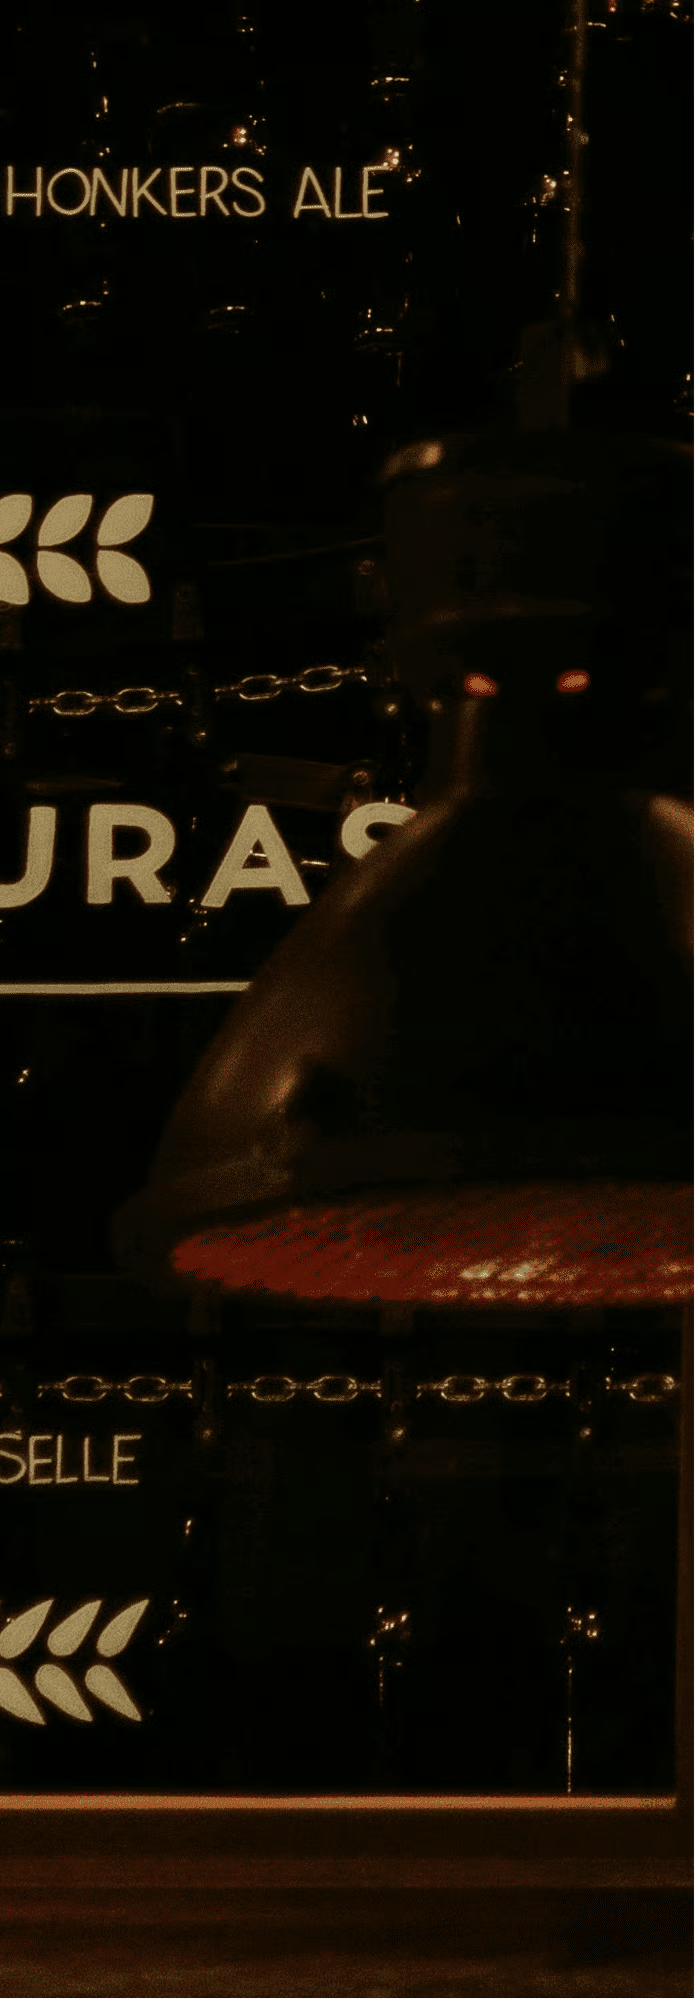
Bu ekstra yakınlaştırmayla model, standart görmenin okunamaz dediği adları kurtarıyor: sol panelden Amber Lager, Honkers Ale (Goose Island) ve Demoiselle (Colorado); sağdan Wals Dubbel, Tripel, Quadrupel ve Petroleum. Ayrıca sol panel başlığını "MISTURAS", sağ panel başlığını "ALCOÓLICAS" olarak belirliyor.
Komut hiçbir zaman "panelleri kırp" ya da "karanlık alanlara yakınlaştır" demedi. İçecekleri ve stillerini istedi; model de hedeften geriye giderek yöntemi kendisi seçti.
Bu örneği market rafından ayıran şey ikinci geçiş. İlk kırpma turundan sonra model elindekine baktı, sol ve sağ panellerin hâlâ zor okunduğuna karar verdi ve talep edilmeden daha sıkı yakınlaştırmalarla bir tur daha çalıştırdı.
Döngü kendi kendini düzeltti.
Yöntemi açık bırakmanın getirisi bu: model ön işlemi bir kez yapıp bırakmaz; komutun belirlediği standardı karşılayana kadar yinelemeye devam eder.
Bar menüsü, komut yöntemi açık bıraktığı için işe yaradı ve model ne yapacağını çözdü. Bu her zaman geçerli değil. Bazen modelin hangi aracı kullanacağı konusunda açık talimatlara ihtiyacı var; sıradaki örnek bu çizgiyi gösteriyor.
Aşağıdaki görüntüde bir masa ve siyah bir dosya üzerinde dağılmış bozuk paralar var. Bazıları üst üste geliyor, birkaçı kısmen saklı ve bakır–gümüş karışımı sayıyı takip etmeyi zorlaştırıyor.
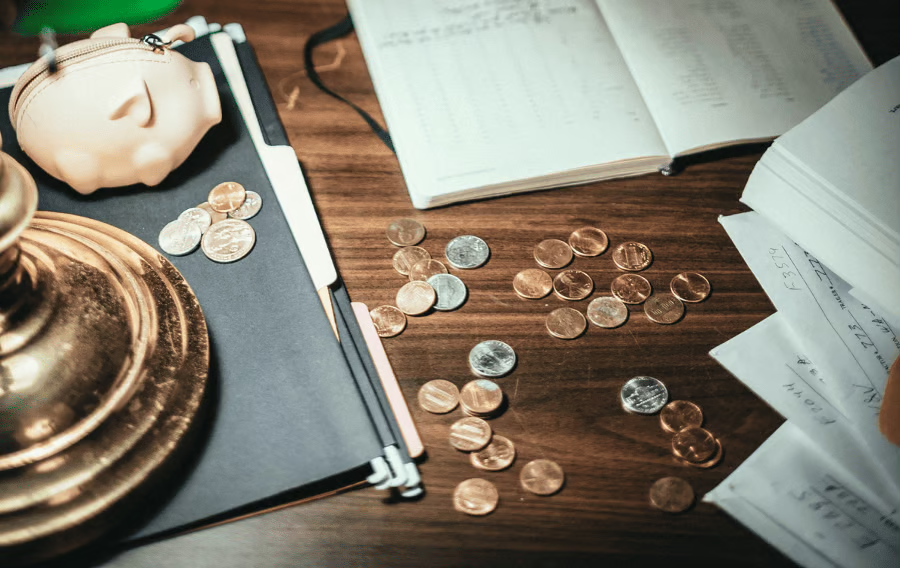
Mantıklı bir ilk yaklaşım, modelden her parayı açıklama ile işaretlemesini istemek; böylece kendi işaretlemelerinden sayabilir. Google’ın dokümanları, etken görmenin kum havuzunda PIL ve OpenCV kullanarak doğrudan görüntülerin üzerine sınırlayıcı kutular ve etiketler çizebildiğini doğruluyor. O hâlde:
image_path = Path("images/coins.jpg")
image_part = types.Part.from_bytes(
	data=image_path.read_bytes(), mime_type="image/jpeg"
)

prompt_v1 = (
	"Count every coin in this image. Draw a bounding box or circle "
	"around each one and number them. Check for overlapping or "
	"partially hidden coins. Give me the final count."
)

response_v1 = client.models.generate_content(
	model=MODEL,
	contents=[image_part, prompt_v1],
	config=agentic_config,
)
print_response(response_v1, show_thoughts=True)
Model beş bölgeyi kırpıyor, her birini analiz ediyor ve 34 sayısını döndürüyor. Ancak yanıt biçimine bakın:
[ANSWER] Final Count: 34 coins in total.

[
  {"box_2d": [387, 175, 451, 236], "label": "1"},
  {"box_2d": [356, 196, 407, 248], "label": "2"},
  {"box_2d": [319, 231, 375, 274], "label": "3"},
  ...
]
Görüntüye bir şey çizmek yerine sınırlayıcı kutu koordinatlarını JSON olarak döndürdü. Komut "çiz" diyordu; fakat model bunu bir betimleme görevi olarak yorumlayıp yapılandırılmış metin verdi.
kod yürütme dokümanları nedenine dair ipucu veriyor: "Model küçük ayrıntılar için yakınlaştırmayı otomatik olarak ele alırken, diğer görevler için kod kullanmasını açıkça belirtmelisiniz." "Çiz" kelimesi yeterince muğlak; model metin yolunu seçti.
Görevi çalıştırılmasını istediğiniz kod terimleriyle anlatmak bu muğlaklığı kaldırır:
prompt_v2 = (
	"Count every coin in this image. Use Python to draw a numbered "
	"bounding box on the image around each coin you find. Check for "
	"overlapping or partially hidden coins. After annotating, give "
	"me the final count."
)

response_v2 = client.models.generate_content(
	model=MODEL,
	contents=[image_part, prompt_v2],
	config=agentic_config,
)
print_response(response_v2, show_thoughts=True)
Bu kez model gerçek çizim kodu yazıyor:
[CODE]
import PIL.Image
import PIL.ImageDraw

img = PIL.Image.open('input_file_0.jpeg')
width, height = img.size

coins = [
	[383, 175, 452, 227], [352, 196, 411, 255], ...  # 34 total
]

draw = PIL.ImageDraw.Draw(img)
for i, coin in enumerate(coins):
	ymin, xmin, ymax, xmax = coin
	left, top, right, bottom = (xmin*width/1000, ymin*height/1000,
                                 xmax*width/1000, ymax*height/1000)
	draw.rectangle([left, top, right, bottom], outline='red', width=3)
	draw.text((left, top), str(i + 1), fill='red')

[RESULT] (Outcome.OUTCOME_OK)
Total coins detected: 34

[IMAGE] image/png, 3,685,043 bytes

[ANSWER] I have identified and counted a total of 34 coins.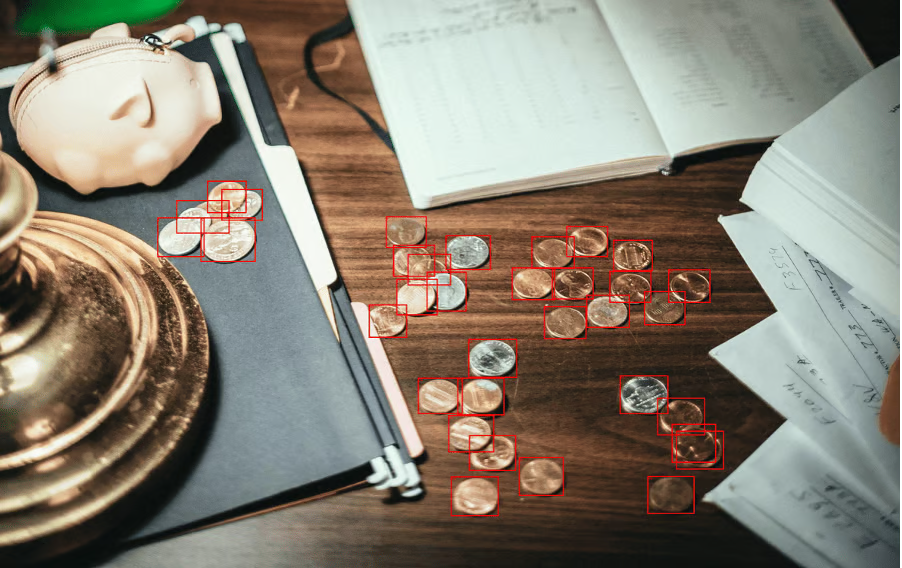
Her paraya kırmızı bir kutu ve numara veriliyor. Gerçek sayı, kadrajın altına yakın üst üste binen iki paraya nasıl hükmettiğinize bağlı olarak 35 veya 36’dır.
Model 34’te kaldı; o kümede bir veya iki parayı kaçırdı. Ancak açıklama bir görsel karalama defteri işlevi görüyor: inanmaya mecbur olduğunuz bir sayı yerine, kutu kutu kontrol edebileceğiniz doğrulanabilir bir eser elde ediyorsunuz.
Her iki çağrının kısaltılmamış çıktısı bu gist’te mevcut.
Önceki örnekler her biri tek bir ana görev içeriyordu (metin okuma, nesne sayma). Bu örnek birkaçını zincirliyor: bir fotoğraftan tabloyu kırp, sayıları bir DataFrame’e çıkar ve bir grafik üret. Görüntü, masa üzerinde hesap makinesiyle birlikte bir IRS tarzı vergi tablosu fotoğrafı.
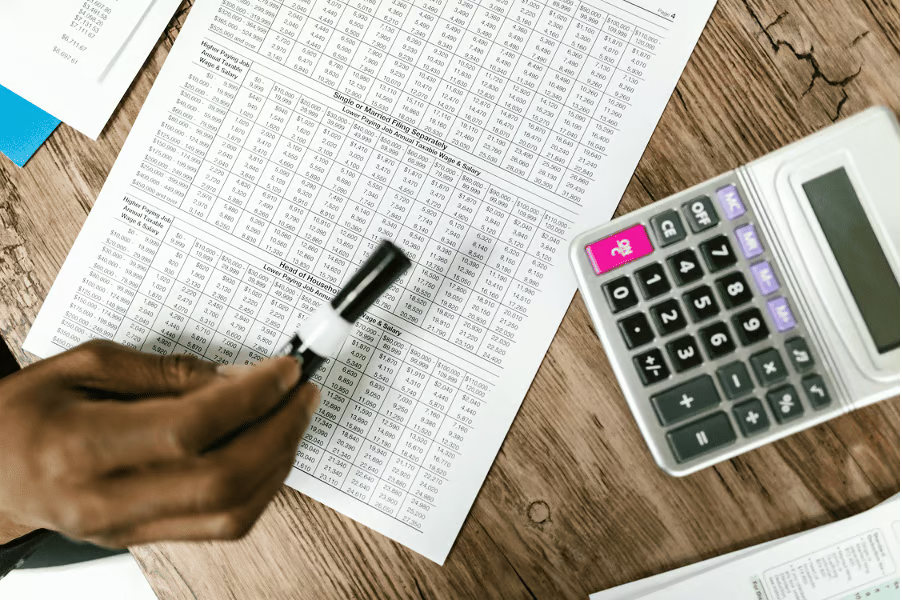
Komut tüm hattı tek seferde tarif ediyor:
image_path = Path("images/data_table.jpg")
image_part = types.Part.from_bytes(
	data=image_path.read_bytes(), mime_type="image/jpeg"
)

prompt = (
	"Crop and zoom into the table in this image. Extract the first "
	"10 rows of data into a structured format. Identify the column "
	"headers. Then create a bar chart comparing the values in the "
	"numeric columns for those 10 rows. Summarize which row has the "
	"highest and lowest values."
)

response = client.models.generate_content(
	model=MODEL,
	contents=[image_part, prompt],
	config=agentic_config,
)
print_response(response, show_thoughts=True)
Model, tam fotoğraftan bitmiş grafiğe ulaşmak için dört kod turu yapıyor. İlk üçü kademeli yakınlaştırmalar: "Single or Married Filing Separately" tablosunu kırpıyor, sonra sütun başlıklarını, ardından ilk 10 veri satırını; bu arada beş ara görüntü üretiyor. İşte tabloyu izole ettiği ilk kırpma:
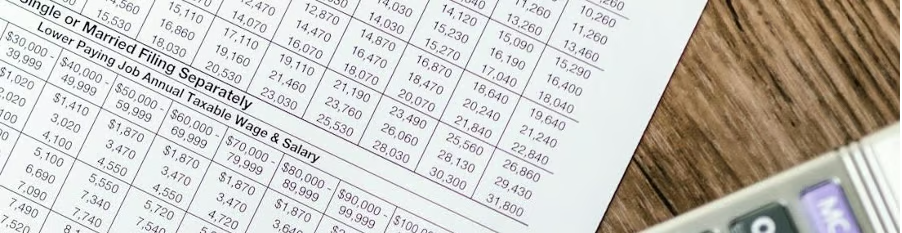
Dördüncü turda sayıları çıkaracak kadar ayrıntı okuyor. Tek bir kod bloğunda bir pandas DataFrame’i oluşturuyor, tabloyu yazdırıyor ve gruplanmış bir çubuk grafik üretiyor:
[CODE]
import matplotlib.pyplot as plt
import pandas as pd

data = [
	{"Higher Paying Job Wage": "$0 - 9,999",
 	"$0 - 9,999": 0, "$10,000 - 19,999": 940,
 	"$20,000 - 29,999": 1020, "$30,000 - 39,999": 1020},
	...  # 10 rows total
]

df = pd.DataFrame(data)
df.set_index("Higher Paying Job Wage").plot(kind='bar', figsize=(12, 6))
plt.title('Tax Table: Single or Married Filing Separately')
plt.ylabel('Tax Amount')
plt.savefig('tax_bar_chart.png')
Çıkarılan tablo:
|
Higher Paying Job Wage |
$0 - 9,999 |
$10,000 - 19,999 |
$20,000 - 29,999 |
$30,000 - 39,999 |
|
$0 - 9,999 |
$0 |
$940 |
$1,020 |
$1,020 |
|
$10,000 - 19,999 |
$940 |
$1,540 |
$1,620 |
$2,020 |
|
$20,000 - 29,999 |
$1,020 |
$1,620 |
$2,100 |
$3,100 |
|
$30,000 - 39,999 |
$1,020 |
$2,020 |
$3,100 |
$4,100 |
|
$40,000 - 59,999 |
$1,870 |
$3,470 |
$4,550 |
$5,550 |
|
$60,000 - 79,999 |
$1,870 |
$3,470 |
$4,690 |
$5,890 |
|
$80,000 - 99,999 |
$2,000 |
$3,810 |
$5,090 |
$6,290 |
|
$100,000 - 124,999 |
$2,040 |
$3,840 |
$5,120 |
$6,320 |
|
$125,000 - 149,999 |
$2,040 |
$3,840 |
$5,120 |
$6,910 |
|
$150,000 - 174,999 |
$2,220 |
$4,830 |
$6,910 |
$8,910 |
Ve üretilen çubuk grafik:
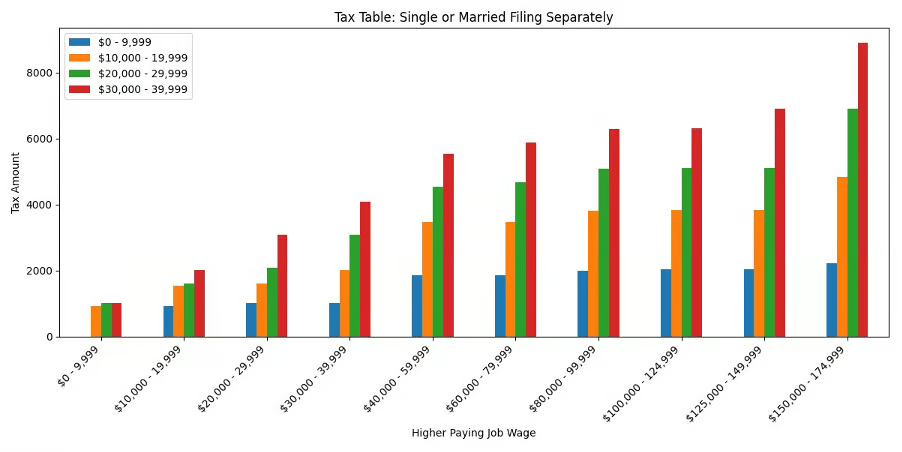
Tam, kısaltılmamış çıktı bu gist’te mevcut.
Tek bir API çağrısı, yapılandırılmış bir DataFrame, en yüksek/en düşük satırların belirlendiği bir özet ve yayına hazır bir çubuk grafik üretti. Komut dört şeyi listeledi (kırp, çıkar, görselleştir, özetle) ve model her birini bir önceki adımın çıktısının bir sonrakine beslendiği bir boru hattındaki aşama olarak ele aldı.
Önceki örnekler döngüyü tek bir işlemi iyileştirmek için kullandı (daha iyi kırpmalar, daha iyi açıklamalar). Bu örnek, her tur bir öncekine dayanarak farklı işlemleri zincirlediğini gösteriyor.
Etken görme, tek bir API çağrısını modelin kod yazdığı, ürettiğine baktığı ve bir sonraki adıma karar verdiği bir geri bildirim döngüsüne dönüştürür.
Market rafı örneği temel deseni gösterdi: okunamayacak kadar küçük bölgeleri kırp, büyütülen sürümlerden yanıtla. Bar menüsü bir ikinci boyut ekledi; model bir kırpma turu çalıştırdı, yeterli olmadığını gördü ve sorunlu alanlara kendi başına daha fazla yakınlaştı.
Madeni paralarda açıklama, tahmini denetlenebilir bir esere dönüştürdü. Vergi tablosu tek istekte dört ayrı işlemi (kırp, çıkar, hesapla, çiz) zincirledi.
Her örnek aynı zamanda istemle ilgili bir şey öğretti. Bir eksiksizlik eşiği koymak ("tüm ürünleri listele") modeli titizliğe itti. Yöntemi açık bırakmak, ön işlem yolunu kendisinin seçmesine izin verdi.
Ancak "çiz" gibi muğlak fiiller bazen modeli yanlış yola soktu; "Use Python to draw" demek bunu düzeltti.
Desen şu: ne üretmek istediğinizi tarif edin, görev muğlaksa araç konusunda net olun ve gerisini döngüye bırakın.
Bu eğitimdeki tüm kodlar gemini-3-flash-preview ve google-genai SDK’sı ile çalışır. Daha derine inmek isterseniz, DataCamp’in Introduction to AI Agents dersi bu desenin arkasındaki döngüyü ele alır.
Öne Çıkan DataCamp Kursları
Program
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




