

कम रोशनी और बाधाओं के बीच पढ़ना
यह छवि धुंधली रोशनी में खींचा गया एक ब्राज़ीलियाई बार मेन्यू है। तीन काँच पैनलों पर सुनहरे अक्षरों में ड्रिंक्स लिखे हैं, लेकिन पेंडेंट लैंप बाएँ पैनल के हिस्सों को ढकते हैं, दाएँ पैनल का केवल किनारा फ्रेम में है, और काँच की परावर्तियाँ सतह पर फैली हैं।
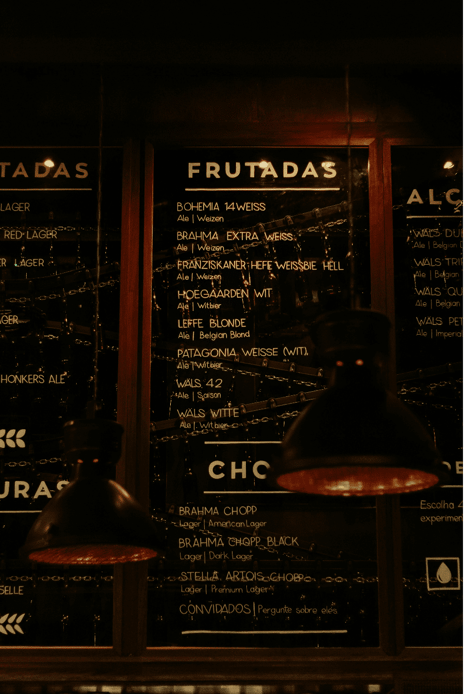
प्रॉम्प्ट में रोशनी, क्रॉपिंग या किसी विशेष तकनीक का ज़िक्र नहीं है। यह बस सामग्री माँगता है:
image_path = Path("images/bar_menu.jpg")
image_part = types.Part.from_bytes(
data=image_path.read_bytes(), mime_type="image/jpeg"
)
prompt = (
"Read every drink listed on this menu board, including the ones "
"partially hidden behind the lamps and on the side panels. For "
"each drink, give me the name and beer style."
)स्टैंडर्ड विज़न बिना परेशानी के अच्छी रोशनी वाले मध्य पैनल को पढ़ लेता है—"FRUTADAS" सेक्शन से आठ बीयर और "CHOPP" से चार। लेकिन बायाँ पैनल कुछ यूँ आता है:
[ANSWER]
### Left Panel (Partially visible)
* **[Unreadable] LAGER** | [Style unreadable]
* **RED LAGER** | [Style unreadable]
* **[Unreadable] LAGER** | [Style unreadable]
* **[Unreadable]GER** | [Style unreadable]
* **HONKERS ALE** | [Style unreadable]
* **[Unreadable]SELLE** | [Style unreadable]छह प्रविष्टियाँ—ज्यादातर के नाम अपठनीय और सबके स्टाइल गायब। मॉडल देखता है कि वहाँ टेक्स्ट है पर पढ़ नहीं पाता।
Agentic कॉल दो कोड राउंड चलाता है। पहले, यह तीनों पैनल क्रॉप करता है:
[CODE]
middle_panel = [200, 320, 950, 780]
left_panel = [200, 0, 950, 260]
right_panel = [200, 840, 700, 1000]
# ... crops and saves each region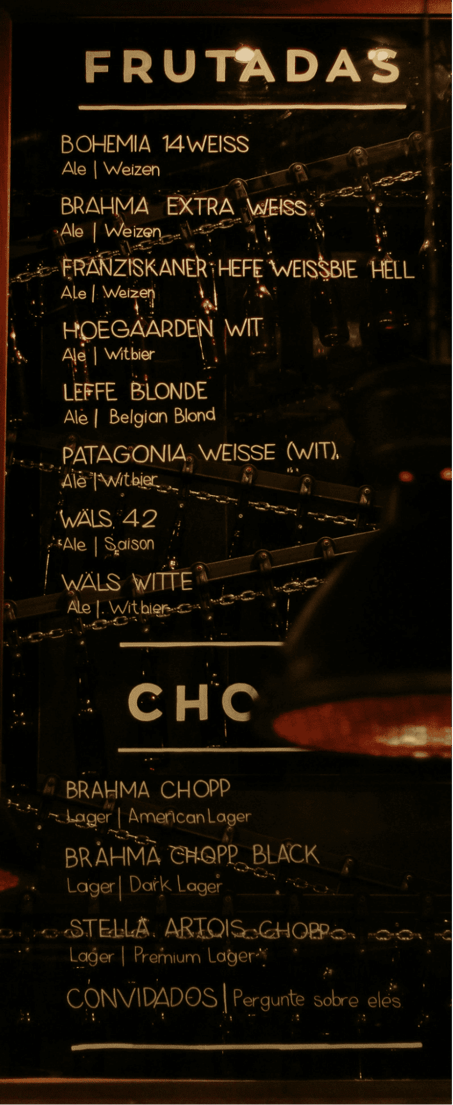
इन क्रॉप्स को देखने के बाद, मॉडल तय करता है कि बाएँ और दाएँ पैनल को और ज़ूम चाहिए। यह दूसरा राउंड चलाता है:
[CODE]
left_panel_top = [100, 0, 500, 250]
left_panel_bottom = [500, 0, 980, 250]
right_panel_top = [100, 800, 600, 1000]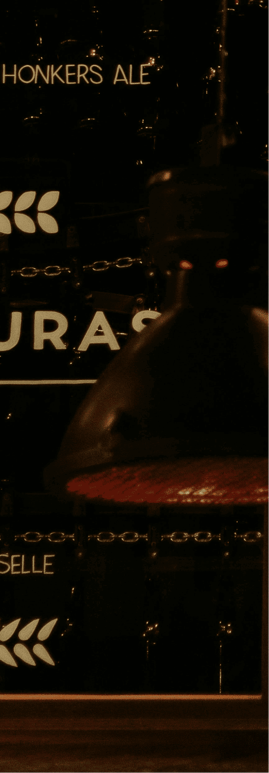
उस अतिरिक्त ज़ूम से, मॉडल वे नाम वापस पा लेता है जिन्हें स्टैंडर्ड विज़न ने अपठनीय कहा था: बाएँ पैनल से Amber Lager, Honkers Ale (Goose Island), और Demoiselle (Colorado); तथा दाएँ से Wals Dubbel, Tripel, Quadrupel, और Petroleum। यह बाएँ पैनल की हेडिंग "MISTURAS" और दाएँ की "ALCOÓLICAS" भी पहचानता है।
प्रॉम्प्ट ने कभी नहीं कहा था "पैनल क्रॉप करो" या "अँधेरे हिस्सों में ज़ूम करो"। उसने ड्रिंक और उनके स्टाइल माँगे, और मॉडल ने उस लक्ष्य से उलटा काम करते हुए तरीका तय किया।
किराना शेल्फ़ के उदाहरण से अलग यहाँ दूसरी पास है। पहले राउंड के क्रॉप्स के बाद मॉडल ने देखा कि उसके पास क्या है, माना कि बाएँ और दाएँ पैनल अब भी पढ़ने में कठिन हैं, और निर्देश दिए बिना खुद ही और तंग ज़ूम्स चलाए।
लूप ने खुद-सुधार किया।
यही लाभ है तरीके को खुला छोड़ने का: मॉडल केवल एक बार प्रीप्रोसेस नहीं करता, वह तब तक दोहराता है जब तक परिणाम प्रॉम्प्ट द्वारा तय मानक पर खरे न उतरें।
Gemini 3 में Agentic Vision के साथ काउंटिंग और एनोटेशन
बार मेन्यू इसलिए कामयाब रहा क्योंकि प्रॉम्प्ट ने तरीका खुला छोड़ा, और मॉडल ने खुद तय किया क्या करना है। यह हमेशा नहीं चलता। कभी-कभी मॉडल को साफ़ निर्देश चाहिए कि कौन सा टूल उपयोग करना है—अगला उदाहरण यही रेखा दिखाता है।
नीचे की छवि में डेस्क और काले फोल्डर पर बिखरे सिक्के हैं। कुछ एक-दूसरे पर हैं, कुछ आंशिक रूप से छिपे, और तांबे-सिल्वर का मिश्रण गिनती चूकना आसान बना देता है।
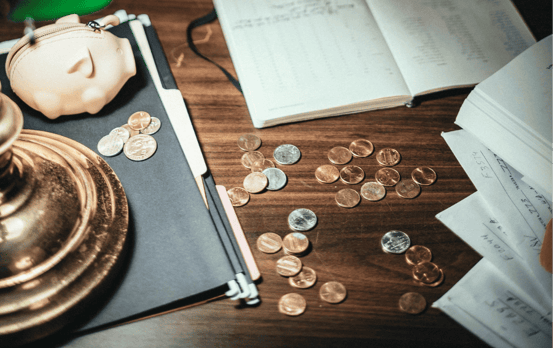
सम्भावित पहला तरीका है मॉडल से हर सिक्के पर एनोटेशन करवाना ताकि वह अपनी निशानदेही से गिन सके। Google के दस्तावेज़ पुष्टि करते हैं कि agentic vision सैंडबॉक्स में PIL और OpenCV से सीधे छवियों पर बॉन्डिंग बॉक्स और लेबल बना सकता है। तो:
image_path = Path("images/coins.jpg")
image_part = types.Part.from_bytes(
data=image_path.read_bytes(), mime_type="image/jpeg"
)
prompt_v1 = (
"Count every coin in this image. Draw a bounding box or circle "
"around each one and number them. Check for overlapping or "
"partially hidden coins. Give me the final count."
)
response_v1 = client.models.generate_content(
model=MODEL,
contents=[image_part, prompt_v1],
config=agentic_config,
)
print_response(response_v1, show_thoughts=True)मॉडल पाँच क्षेत्र क्रॉप करता है, हर एक का विश्लेषण करता है, और 34 की गिनती लौटाता है। लेकिन उत्तर का फ़ॉर्मेट देखें:
[ANSWER] Final Count: 34 coins in total.
[
{"box_2d": [387, 175, 451, 236], "label": "1"},
{"box_2d": [356, 196, 407, 248], "label": "2"},
{"box_2d": [319, 231, 375, 274], "label": "3"},
...
]इसने छवि पर कुछ बनवाने के बजाय JSON में बॉन्डिंग बॉक्स निर्देशांक दिए। प्रॉम्प्ट में "draw" था, लेकिन मॉडल ने उसे वर्णनात्मक कार्य माना और स्ट्रक्चर्ड टेक्स्ट दे दिया।
The code execution docs इसका संकेत देते हैं: "हालाँकि मॉडल छोटे विवरणों के लिए अपने आप ज़ूम संभालता है, अन्य कार्यों के लिए आपको उसे स्पष्ट रूप से कोड उपयोग करने के लिए प्रेरित करना चाहिए।" "draw" शब्द इतना अस्पष्ट था कि मॉडल ने टेक्स्ट-ओनली राह चुनी।
कार्य को उस कोड की भाषा में बताना जो आप चलवाना चाहते हैं, अस्पष्टता हटाता है:
prompt_v2 = (
"Count every coin in this image. Use Python to draw a numbered "
"bounding box on the image around each coin you find. Check for "
"overlapping or partially hidden coins. After annotating, give "
"me the final count."
)
response_v2 = client.models.generate_content(
model=MODEL,
contents=[image_part, prompt_v2],
config=agentic_config,
)
print_response(response_v2, show_thoughts=True)इस बार, मॉडल असली ड्रॉइंग कोड लिखता है:
[CODE]
import PIL.Image
import PIL.ImageDraw
img = PIL.Image.open('input_file_0.jpeg')
width, height = img.size
coins = [
[383, 175, 452, 227], [352, 196, 411, 255], ... # 34 total
]
draw = PIL.ImageDraw.Draw(img)
for i, coin in enumerate(coins):
ymin, xmin, ymax, xmax = coin
left, top, right, bottom = (xmin*width/1000, ymin*height/1000,
xmax*width/1000, ymax*height/1000)
draw.rectangle([left, top, right, bottom], outline='red', width=3)
draw.text((left, top), str(i + 1), fill='red')
[RESULT] (Outcome.OUTCOME_OK)
Total coins detected: 34
[IMAGE] image/png, 3,685,043 bytes
[ANSWER] I have identified and counted a total of 34 coins.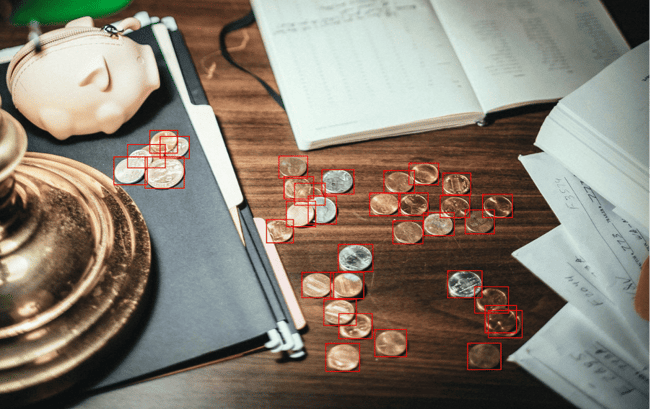
हर सिक्का लाल बॉक्स और नंबर पाता है। वास्तविक संख्या 35 या 36 है, इस पर निर्भर कि आप फ्रेम के नीचे की ओर ओवरलैप कर रहे दो सिक्कों का कैसे आकलन करते हैं।
मॉडल 34 पर पहुँचा, उस क्लस्टर में एक-दो छूट गए। लेकिन एनोटेशन एक दृश्य स्क्रैचपैड का काम करता है: केवल एक संख्या पर भरोसा करने के बजाय, आपको एक सत्यापनीय आर्टिफैक्ट मिलता है जिसे आप बॉक्स-दर-बॉक्स जाँच सकते हैं।
दोनों कॉल्स का पूरा, बिना काटा हुआ आउटपुट इस gist में उपलब्ध है।
मल्टी-स्टेप एक्सट्रैक्शन और प्लॉटिंग
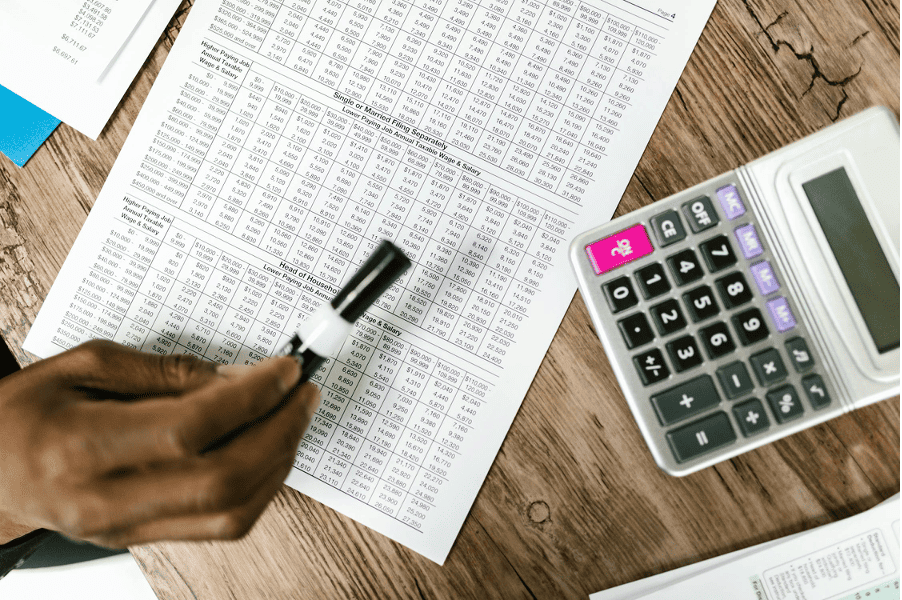
पिछले उदाहरणों में एक मुख्य कार्य था (टेक्स्ट पढ़ना, ऑब्जेक्ट गिनना)। यह वाला कई कार्य जोड़ता है: फोटो से टेबल क्रॉप करना, संख्याएँ DataFrame में निकालना, और चार्ट बनाना। छवि डेस्क पर कैलकुलेटर के साथ IRS-स्टाइल टैक्स टेबल की है।
प्रॉम्प्ट एक ही बार में पूरा पाइपलाइन बताता है:
image_path = Path("images/data_table.jpg")
image_part = types.Part.from_bytes(
data=image_path.read_bytes(), mime_type="image/jpeg"
)
prompt = (
"Crop and zoom into the table in this image. Extract the first "
"10 rows of data into a structured format. Identify the column "
"headers. Then create a bar chart comparing the values in the "
"numeric columns for those 10 rows. Summarize which row has the "
"highest and lowest values."
)
response = client.models.generate_content(
model=MODEL,
contents=[image_part, prompt],
config=agentic_config,
)
print_response(response, show_thoughts=True)पूरा फोटो से तैयार चार्ट तक पहुँचने में मॉडल चार कोड राउंड लेता है। पहले तीन प्रोग्रेसिव ज़ूम्स हैं: यह "Single or Married Filing Separately" टेबल क्रॉप करता है, फिर कॉलम हेडर, फिर पहले 10 रो डेटा—और रास्ते में पाँच इंटरमीडिएट छवियाँ बनाता है। यहाँ पहला क्रॉप है जहाँ यह टेबल अलग करता है:
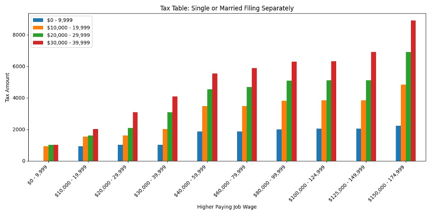
चौथे राउंड तक, यह पर्याप्त विवरण पढ़ लेता है ताकि संख्याएँ निकाल सके। यह एक pandas DataFrame बनाता है, टेबल प्रिंट करता है, और एक ही कोड ब्लॉक में ग्रुप्ड बार चार्ट बनाता है:
[CODE]
import matplotlib.pyplot as plt
import pandas as pd
data = [
{"Higher Paying Job Wage": "$0 - 9,999",
"$0 - 9,999": 0, "$10,000 - 19,999": 940,
"$20,000 - 29,999": 1020, "$30,000 - 39,999": 1020},
... # 10 rows total
]
df = pd.DataFrame(data)
df.set_index("Higher Paying Job Wage").plot(kind='bar', figsize=(12, 6))
plt.title('Tax Table: Single or Married Filing Separately')
plt.ylabel('Tax Amount')
plt.savefig('tax_bar_chart.png')एक्सट्रैक्टेड टेबल:
|
Higher Paying Job Wage |
$0 - 9,999 |
$10,000 - 19,999 |
$20,000 - 29,999 |
$30,000 - 39,999 |
|
$0 - 9,999 |
$0 |
$940 |
$1,020 |
$1,020 |
|
$10,000 - 19,999 |
$940 |
$1,540 |
$1,620 |
$2,020 |
|
$20,000 - 29,999 |
$1,020 |
$1,620 |
$2,100 |
$3,100 |
|
$30,000 - 39,999 |
$1,020 |
$2,020 |
$3,100 |
$4,100 |
|
$40,000 - 59,999 |
$1,870 |
$3,470 |
$4,550 |
$5,550 |
|
$60,000 - 79,999 |
$1,870 |
$3,470 |
$4,690 |
$5,890 |
|
$80,000 - 99,999 |
$2,000 |
$3,810 |
$5,090 |
$6,290 |
|
$100,000 - 124,999 |
$2,040 |
$3,840 |
$5,120 |
$6,320 |
|
$125,000 - 149,999 |
$2,040 |
$3,840 |
$5,120 |
$6,910 |
|
$150,000 - 174,999 |
$2,220 |
$4,830 |
$6,910 |
$8,910 |
और जेनरेट किया गया बार चार्ट:
पूरा, बिना काटा हुआ आउटपुट इस gist में उपलब्ध है।
एक API कॉल से संरचित DataFrame, अधिकतम/न्यूनतम रो पहचाने हुए सारांश, और प्रकाशन-योग्य बार चार्ट निकल आया। प्रॉम्प्ट ने चार चीजें सूचीबद्ध कीं (क्रॉप, एक्सट्रैक्ट, चार्ट, समरी), और मॉडल ने हर एक को पाइपलाइन के चरण की तरह लिया जहाँ एक स्टेप का आउटपुट अगले में गया।
पहले के उदाहरणों में लूप एक ही ऑपरेशन को निखारने के लिए था (बेहतर क्रॉप्स, बेहतर एनोटेशन)। यह उदाहरण दिखाता है कि लूप अलग-अलग ऑपरेशंस को एक साथ जोड़ सकता है, हर बार पिछले राउंड के नतीजों पर निर्माण करते हुए।
निष्कर्ष
Agentic vision एक ही API कॉल को फीडबैक लूप में बदल देता है जहाँ मॉडल कोड लिखता है, परिणाम देखता है, और अगला कदम तय करता है।
किराना शेल्फ़ के उदाहरण ने बुनियादी पैटर्न दिखाया: जो हिस्से छोटे हैं उन्हें क्रॉप करो, बड़ा कर के पढ़ो, फिर उत्तर दो। बार मेन्यू ने दूसरा आयाम जोड़ा—मॉडल ने एक राउंड क्रॉप्स चलाए, समझा कि वे पर्याप्त नहीं, और स्वतः ही समस्या-क्षेत्रों में और ज़ूम कर दिया।
सिक्कों के लिए, एनोटेशन ने अनुमान को जाँचने योग्य आर्टिफैक्ट में बदला। टैक्स टेबल ने चार अलग ऑपरेशन (क्रॉप, एक्सट्रैक्ट, कंप्यूट, प्लॉट) एक ही अनुरोध में जोड़ दिए।
हर उदाहरण ने प्रॉम्प्टिंग के बारे में भी कुछ सिखाया। पूर्णता का मानक सेट करना ("सभी प्रोडक्ट्स सूचीबद्ध करें") मॉडल को पूरी तरह काम करने की ओर धकेलता है। तरीका खुला छोड़ने से वह अपना प्रीप्रोसेसिंग रास्ता चुनता है।
लेकिन "draw" जैसे अस्पष्ट क्रिया-शब्द कभी-कभी उसे गलत दिशा में ले गए—"Use Python to draw" पर स्विच करने से वह ठीक हो गया।
पैटर्न: जो आउटपुट चाहिए उसे बताएँ, जब कार्य अस्पष्ट हो तो टूल के बारे में विशिष्ट हों, और बाकी लूप पर छोड़ दें।
इस ट्यूटोरियल का सारा कोड gemini-3-flash-preview और google-genai SDK के साथ चलता है। और गहराई में जाने के लिए, DataCamp का Introduction to AI Agents कोर्स इस पूरी लूप-पैटर्न को कवर करता है।
Agentic Vision in Gemini 3 FAQs
Gemini 3 Flash में agentic vision क्या है?
Agentic vision एक फ़ीचर है जिसमें Gemini 3 Flash उत्तर के दौरान Python कोड लिख और चला सकता है ताकि उत्तर देने से पहले छवियों में हेरफेर कर सके। यह Think, Act, Observe लूप का उपयोग करके सैंडबॉक्स्ड वातावरण में छवियों को क्रॉप, ज़ूम, एनोटेट और एन्हांस करता है—वह भी एक ही API कॉल में।
Gemini API में agentic vision कैसे सक्षम करें?
अपनी GenerateContentConfig में code execution टूल जोड़ें: tools=[types.Tool(code_execution=types.ToolCodeExecution())]। इससे मॉडल को 43 प्री-इंस्टॉल्ड लाइब्रेरीज़—जैसे PIL, OpenCV, और matplotlib—के साथ सैंडबॉक्स्ड Python environment की पहुँच मिलती है।
मॉडल सक्षम होने पर भी कभी-कभी कोड निष्पादन क्यों छोड़ देता है?
मॉडल तभी कोड लिखता है जब उसे लगता है कि एक बार छवि देखने से काम नहीं चलेगा। यदि वह मूल रेज़ोल्यूशन से आत्मविश्वास के साथ उत्तर दे सकता है, तो वह कोड निष्पादन पथ छोड़ देता है। यह Google के अनुसार डिज़ाइन का हिस्सा है।
प्रॉम्प्ट्स में "draw" और "Use Python to draw" में क्या अंतर है?
"draw" कहना अस्पष्ट है—मॉडल वास्तविक छवि बनाने के बजाय टेक्स्ट वर्णन या JSON निर्देशांक लौटा सकता है। "Use Python to draw" जोड़ने से मॉडल executable कोड लिखता है जो दृश्य आउटपुट बनाता है—और कोड निष्पादन पथ भरोसेमंद रूप से ट्रिगर होता है।
क्या मैं agentic vision को कस्टम फ़ंक्शन कॉलिंग के साथ जोड़ सकता/सकती हूँ?
नहीं। कोड निष्पादन और कस्टम फ़ंक्शन कॉलिंग एक ही API अनुरोध में साथ उपयोग नहीं किए जा सकते। यदि आपके वर्कफ़्लो को दोनों चाहिए, तो हर एक के लिए अलग-अलग कॉल करें।

मैं 2 से अधिक वर्षों के अनुभव वाला डेटा साइंस कंटेंट क्रिएटर हूँ और Medium पर सबसे बड़े फॉलोइंग्स में से एक रखता हूँ। मुझे एआई और एमएल पर विस्तार से लेख लिखना पसंद है, जिसमें हल्का-सा व्यंग्यात्मक अंदाज रहता है—क्योंकि कुछ तो करना पड़ता है ताकि वे कम उबाऊ लगें। मैंने 130 से अधिक लेख और एक DataCamp कोर्स तैयार किया है, और एक और बन रहा है। मेरा कंटेंट 50 लाख से अधिक लोगों ने देखा है, जिनमें से 20 हज़ार लोग Medium और LinkedIn पर फॉलोअर्स बन गए।
आप किसी vision API को एक छवि भेजते हैं और उससे छोटे प्राइस लेबल को पढ़ने के लिए कहते हैं। जवाब आत्मविश्वास से भरा आता है—और गलत। बिखरी हुई वस्तुओं की गिनती भी यही कहानी: मॉडल पूरी छवि पर एक नज़र डालता है और संख्या का ऐसा अनुमान लगाता है जो वास्तविकता से बहुत दूर है।
Gemini 3 Flash इसे अलग तरह से संभालता है। कोड निष्पादन चालू होने पर, यह उत्तर के बीच में ही Python लिख और चला सकता है—ताकि अंतिम उत्तर देने से पहले छवियों को क्रॉप, ज़ूम और एनोटेट कर सके। Google इसे agentic vision कहता है और vision बेंचमार्क्स पर 5–10% गुणवत्ता सुधार रिपोर्ट करता है।
यह ट्यूटोरियल चार उदाहरणों से होकर गुजरता है जो धीरे-धीरे कठिन होते जाते हैं: किराना शेल्फ से बारीक अक्षर पढ़ना, धुंधली रोशनी वाले बार मेन्यू से ड्रिंक के नाम खींचना, बिखरे हुए सिक्कों की गिनती करना, और टेबल डेटा निकालकर चार्ट बनाना।
Agentic Vision क्या है? "Think, Act, Observe" लूप
विचार सरल है। कोड निष्पादन सक्रिय होने पर, Gemini 3 उत्तर के बीच रुक सकता है, सैंडबॉक्स में Python लिख और चला सकता है, कोड ने क्या निकाला उसे देख सकता है, और अगला कदम तय कर सकता है।
विज़न कार्यों में, इसका मतलब अक्सर होता है कि मॉडल छवि के हिस्सों को काट रहा है, उन्हें बड़ा कर रहा है, बॉन्डिंग बॉक्स बना रहा है, या कंट्रास्ट समायोजित कर रहा है ताकि वे विवरण निकाले जा सकें जो मूल रेज़ोल्यूशन पर नजर नहीं आते।
यह तीन-चरणीय लूप के रूप में चलता है।
Think चरण में, मॉडल यह देखता है कि उसके पास क्या है (मूल छवि, या उसकी कोई क्रॉप/एनोटेटेड प्रति) और अगली चाल की योजना बनाता है। वह तय कर सकता है कि प्राइस लेबल पढ़ने के लिए बहुत छोटा है और उसे क्रॉप व बड़ा करने की ज़रूरत है।
Act उस योजना को Python में बदल देता है। सैंडबॉक्स में पहले से 43 लाइब्रेरीज़ (PIL, OpenCV, matplotlib, आदि) मौजूद हैं, इसलिए मॉडल ज़रूरत के मुताबिक कोई भी इमेज प्रोसेसिंग कोड लिख सकता है।
कोड चलने के बाद, Observe लूप को बंद करता है। आउटपुट (नई छवियां, प्रिंटेड टेक्स्ट, गणना किए गए मान) फिर संदर्भ में लौट आते हैं। वहां से, मॉडल या तो उत्तर दे देता है या फिर से लूप में चला जाता है।
एक ही API कॉल इस लूप से कई बार गुजर सकता है। आगे के उदाहरणों में, आप देखेंगे कि यह एक अनुरोध में शेल्फ के सात हिस्से क्रॉप करता है। एक अन्य में, यह pandas DataFrame में टेबल डेटा निकालता है और उसी कॉल के भीतर एक बार चार्ट बनाता है।
यदि agentic लूप की अवधारणा आपके लिए नई है, तो DataCamp का AI Agent Fundamentals ट्रैक इसे विस्तार से कवर करता है।
सीमाएँ और दायरे
Agentic Vision के लिए अपना वातावरण तैयार करना
API कुंजी यहाँ से लें ai.google.dev और उसे अपने environment या
.envफ़ाइल मेंGOOGLE_API_KEYके रूप में सहेजें। फिर SDK और इमेज लाइब्रेरीज़ इंस्टॉल करें:क्लाइंट बनाकर शुरू करें:
यह
timeout=600_000मायने रखता है। Agentic vision कॉल्स में सैंडबॉक्स के अंदर कोड जनरेशन और निष्पादन के कई दौर होते हैं, और एक अनुरोध को लगभग चार मिनट लग सकते हैं।डिफ़ॉल्ट httpx टाइमआउट उससे पहले ही कनेक्शन मार देगा, जिससे आपके पास चुपचाप होने वाला
ReadTimeoutरह जाएगा और अंदाज़ा नहीं लगेगा कि क्या हुआ।अब agentic कॉन्फ़िग सेट करें:
toolsकोड निष्पादन का ऑन-स्विच है। यह मॉडल को 43 लाइब्रेरीज़ (numpy, pandas, PIL, matplotlib, OpenCV, आदि) वाली सैंडबॉक्स्ड Python environment देता है। हर कोड ब्लॉक को चलने के लिए 30 सेकंड मिलते हैं, और सैंडबॉक्स त्रुटियों पर अधिकतम 5 बार रीट्राइ करता है।thinking_level="HIGH"मॉडल को कोड लिखने से पहले योजना बनाने के लिए अधिक स्वतंत्रता देता है। मल्टी-स्टेप विज़न कार्यों के लिए यह ध्यान देने योग्य फर्क लाता है।include_thoughts=Trueसेट करने से प्रतिक्रिया के पार्ट्स में वही तर्क दिखाई देता है, जो डिबगिंग में काम आता है।media_resolutionयह तय करता है कि लूप शुरू होने से पहले इनपुट इमेज को कितने टोकन्स मिलते हैं।MEDIA_RESOLUTION_HIGHअच्छा डिफ़ॉल्ट है। बहुत सघन छवियों के लिए आप इसेMEDIA_RESOLUTION_ULTRA_HIGHतक बढ़ा सकते हैं, या जब गति विवरण से अधिक मायने रखती हो तोMEDIA_RESOLUTION_LOWपर ला सकते हैं।यही सेटअप थोड़े बदलावों के साथ Vertex AI पर भी काम करता है। विज़न से परे Gemini 3 API का व्यापक वॉकथ्रू देखने के लिए साथ वाला ट्यूटोरियल देखें।
Gemini 3 में Agentic Vision: क्रॉप और ज़ूम से सूक्ष्म विवरण पढ़ना
नीचे की छवि एक जर्मन किराना स्टोर की शेल्फ है जिसमें तीन पंक्तियों में प्रोडक्ट्स हैं। हर शेल्फ किनारे पर प्राइस लेबल लगे हैं, और नीचे की ओर "Liebe Kunden" (प्रिय ग्राहक) का नोटिस है। आप खुद ज़ूम करें तो लेबल पढ़े जा सकते हैं, लेकिन वे इतने छोटे हैं कि पूरी छवि को एक साथ देखने वाला मॉडल तय करता है कि वह क्या पढ़ सकता है और क्या नहीं।
मल्टी-पार्ट प्रतिक्रिया को पार्स करना
Agentic प्रतिक्रियाएँ एकल टेक्स्ट ब्लॉक नहीं होतीं। वे हिस्सों की सूची के रूप में आती हैं: सोच, मॉडल द्वारा लिखा कोड, निष्पादन परिणाम, जेनरेट की गई छवियाँ, और अंतिम उत्तर। यह हेल्पर उन्हें क्रम से पढ़ता है:
इस ट्यूटोरियल के हर उदाहरण में यही फ़ंक्शन उपयोग होता है, इसलिए इसे एक बार परिभाषित करें और दोबारा उपयोग करें।
अब शेल्फ इमेज लोड करें और ऐसा प्रॉम्प्ट लिखें जो मॉडल से साइन पढ़ने और हर प्रोडक्ट को उसकी कीमत सहित सूचीबद्ध करने के लिए कहे।
पहले इसे कोड निष्पादन के बिना चलाएँ:
आउटपुट का संक्षिप्त संस्करण यह है:
साइन का अनुवाद सही है, और मॉडल Uncle Ben’s के जो लेबल पहचान सकता है उन्हें पढ़ लेता है। लेकिन लगभग एक-तिहाई प्रविष्टियाँ "(Label obscured)" हैं, और Oryza, Reis-fit, तथा Reiskugeln जैसे ब्रांड बिल्कुल नहीं दिखते।
अब वही प्रॉम्प्ट agentic कॉन्फ़िग के साथ:
आउटपुट संरचना अलग है। एकल
[ANSWER]की बजाय यह पूरा Think/Act/Observe लूप दिखाता है:मॉडल द्वारा जेनरेट किए गए ये सात क्रॉप्स:
इन क्रॉप्स को देखने के बाद, मॉडल पूरा उत्तर देता है:
दोनों कॉल्स का पूरा, बिना काटा हुआ आउटपुट यहाँ उपलब्ध है इस gist में।
Agentic प्रतिक्रिया तीनों शेल्फ़ पर 30+ प्रोडक्ट्स पढ़ लेती है। Oryza, Reis-fit, Madras Curry, Reiskugeln, और Steam Basmati जैसे आइटम, जिन्हें standard vision ने "(obscured)" कहा था, नाम और कीमत सहित दिखते हैं।
फर्क hallucination बनाम सटीकता का नहीं है; standard vision ईमानदारी से बताता है कि वह क्या नहीं पढ़ सकता। Agentic vision बस उस सीमा को नहीं मानता—और तब तक ज़ूम करता है जब तक पढ़ न ले।
यहाँ प्रॉम्प्ट की भी भूमिका है। मॉडल से "सभी दिखने वाले प्रोडक्ट नाम और उनकी कीमतें सूचीबद्ध करें" कहना एक पूर्णता का मानक तय करता है जो उसे क्रॉप की ओर धकेलता है।
"इस छवि का वर्णन करें" जैसा अस्पष्ट प्रॉम्प्ट संभवतः कोड निष्पादन ऑन होने पर भी सिंगल-पास उत्तर देगा, क्योंकि मॉडल को आगे बढ़ने का कारण नज़र नहीं आता।