
{count, plural, one {Cursus} other {Cursussen}}
AI-agents bouwen met Google ADK
{hours} uur
7.6K
Gemini 3 Pro is het state‑of‑the‑art AI‑model waar we allemaal op hebben gewacht, met een enorme contextvenster van één miljoen tokens dat moeiteloos datasets, documenten, video’s en codebases in één keer verwerkt. Het levert redeneren op PhD‑niveau en blinkt uit in multimodale verwerking van tekst, afbeeldingen, audio en video voor naadloze creatieve workflows.
In deze project‑gebaseerde tutorial laat ik je zien hoe je de Gemini 3 API gebruikt om multi‑agent applicaties te bouwen die een door de gebruiker aangeleverde CSV‑dataset gebruiken en diepgaande data‑analyse uitvoeren.
Kort samengevat voert de multi‑agent app het volgende uit:
Wil je meer leren over het bouwen van agentische AI‑workflows? Bekijk dan onze gids voor Google Antigravity, de Gemini 3 Flash‑tutorial en de skill track AI Agent Fundamentals.
1. Voer deze opdracht uit om alle vereiste pakketten voor onze multi‑agent app te installeren:
!pip install -q google-genai langgraph langsmith grandalf pydantic pandas matplotlib markdown2 weasyprint markdown-it-py mdit-py-pluginsPakketoverzicht:
Opmerking: we gebruiken Jupyter Notebook om dit project te bouwen.
2. Ga naar Google AI Studio en genereer je API‑sleutel. Zorg dat je facturatie is ingesteld op je account, want het Gemini 3 Pro‑model is niet beschikbaar in de gratis laag.
3. Maak vervolgens een gratis LangSmith‑account aan en genereer de API‑sleutel.
4. Sla beide API‑sleutels op als omgevingsvariabelen in je lokale systeem. Stel LANGSMITH_API_KEY en GEMINI_API_KEY in.
5. Importeer alle benodigde Python‑pakketten in je notebook:
from google import genai
from google.genai import types
from pydantic import BaseModel
from langgraph.graph import StateGraph, END
import os, json, textwrap, traceback
from pathlib import Path
import pandas as pd
import markdown2
import weasyprint
6. Stel de omgevingsvariabelen in om de LangSmith‑projectnaam te specificeren en LangSmith‑tracking in te schakelen:
os.environ["LANGSMITH_TRACING"] = "true"
os.environ["LANGSMITH_API_KEY"] = os.environ.get("LANGSMITH_API_KEY", "YOUR_LANGSMITH_KEY")
os.environ["LANGSMITH_PROJECT"] = os.environ.get("LANGSMITH_PROJECT", "autolab-gemini3pro")
7. Maak de map aan waar alle afbeeldingen en PDF’s worden opgeslagen:
ARTIFACTS_DIR = Path("artifacts")
ARTIFACTS_DIR.mkdir(exist_ok=True)In deze sectie richten we een Gemini API‑client in en wikkelen we aanroepen naar het model in zodat ze getraceerd en gelogd kunnen worden in LangSmith. Daarnaast halen we metadata over tokengebruik op en geven die terug in een formaat dat geschikt is voor LangSmith.
Eerst initialiseren we de Gemini GenAI‑client door de API‑sleutel op te geven:
client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])
MODEL = "gemini-3-pro-preview"
Vervolgens schrijven we een kleine wrapper rond een Gemini‑modelaanroep om automatische tracing door LangSmith in te schakelen. Met de @traceable‑decorator registreren we de functie als een LLM‑run.
Binnen deze functie stuurt de code de prompt naar Gemini en haalt details over tokengebruik op, die essentieel zijn voor nauwkeurige LangSmith‑tracking, conform de tracingrichtlijnen.
Tot slot retourneert de functie de tekstoutput van het model samen met tokenstatistieken en de ruwe respons in het formaat dat LangSmith verwacht, zodat de run correct in de UI wordt weergegeven.
from langsmith import traceable
@traceable(name="gemini_generate_content", run_type="llm")
def gemini_call(prompt: str, thinking_level: str = "high"):
    """
    Gemini wrapper that:
    - uses correct ThinkingConfig schema
    - returns LangSmith LLM-run format so token usage shows in UI
    """
    resp = client.models.generate_content(
        model=MODEL,
        contents=prompt,
        config=types.GenerateContentConfig(
            thinking_config=types.ThinkingConfig(thinking_level=thinking_level)
        ),
    )

    usage = getattr(resp, "usage_metadata", None)
    token_usage = None
    if usage:
        token_usage = {
            "prompt_tokens": usage.prompt_token_count,
            "completion_tokens": usage.candidates_token_count,
            "total_tokens": usage.total_token_count,
            "thoughts_tokens": getattr(usage, "thoughts_token_count", None),
        }

    return {
        "generations": [{"text": resp.text}],
        "llm_output": {
            "model_name": MODEL,
            "token_usage": token_usage,
        },
        "raw_response": resp,
}We maken nu tools die datasetinspectie, veilige Python‑uitvoering en Markdown‑naar‑PDF‑rapportgeneratie bieden, die binnen een AI‑agentworkflow worden gebruikt.
Deze tool neemt een bestandspad, leest de CSV in een pandas DataFrame en bouwt daarna een samenvatting met de datasetvorm, kolomnamen, het datatype van elke kolom, percentages ontbrekende waarden, de eerste vijf rijen en volledige beschrijvende statistieken. Het retourneert deze samenvatting zodat een agent de dataset snel kan begrijpen.
def load_dataset(path: str):
    df = pd.read_csv(path)

    summary = {
        "shape": df.shape,
        "columns": list(df.columns),
        "dtypes": {c: str(t) for c, t in df.dtypes.items()},
        "missing_pct": df.isna().mean().to_dict(),
        "head": df.head(5).to_dict(orient="records"),
        "describe": df.describe(include="all").fillna("").to_dict()
    }
return summaryDeze tool draait dynamisch gegenereerde Python‑code veilig in een beperkte omgeving. Hij bereidt een kleine lokale omgeving voor en voert vervolgens de aangeleverde code uit met exec.
De uitgevoerde code hoort paden van artifacts (zoals opgeslagen plots) en metadata terug te geven.
def run_python(code: str):
    """
    Generated code MUST:
      - save plots to ARTIFACTS_DIR
      - collect paths in _artifacts (list[str])
      - collect meta in _charts_meta (list[dict])
      - optionally set _stdout (string)
    """
    local_env = {"ARTIFACTS_DIR": ARTIFACTS_DIR}
    try:
        exec(textwrap.dedent(code), {}, local_env)
        return {
            "ok": True,
            "stdout": local_env.get("_stdout", ""),
            "artifacts": local_env.get("_artifacts", []),
            "charts_meta": local_env.get("_charts_meta", []),
        }
    except Exception:
return {"ok": False, "traceback": traceback.format_exc()}Deze tool zet Markdown om naar een fraai opgemaakte PDF. Eerst wordt een markdownparser gebouwd die tabellen, lijsten, takenlijsten en voetnoten ondersteunt.
Vervolgens zet render_pdf de markdowntekst om naar HTML, verpakt het in een aangepaste template met CSS‑stijl (met controle over lettertypen, tabelweergave, afbeeldingsgrootte, enz.) en gebruikt WeasyPrint om een PDF‑bestand te genereren.
Tot slot wordt de PDF opgeslagen in de artifacts‑map en wordt het pad geretourneerd.
from markdown_it import MarkdownIt
from mdit_py_plugins.tasklists import tasklists_plugin
from mdit_py_plugins.footnote import footnote_plugin

# Create a strong markdown parser once (supports tables, lists, etc.)
md = (
    MarkdownIt("commonmark", {"breaks": True, "html": True})
    .enable(["table", "strikethrough"])
    .use(tasklists_plugin)
    .use(footnote_plugin)
)

def render_pdf(markdown_text: str):
    """
    Better Markdown -> HTML -> PDF:
    - proper tables
    - stable lists
    - centered/small images
    - clean page breaks
    """
    html_body = md.render(markdown_text)

    html_template = f"""
    <html>
    <head>
      <meta charset="utf-8">
      <style>
        body {{
          font-family: Arial, sans-serif;
          font-size: 12px;
          line-height: 1.5;
          color: #111;
        }}

        h1 {{ font-size: 20px; margin-bottom: 6px; }}
        h2 {{ font-size: 16px; margin-top: 18px; margin-bottom: 6px; }}
        h3 {{ font-size: 13px; margin-top: 12px; margin-bottom: 4px; }}

        p {{ margin: 6px 0; }}

        ul, ol {{
          margin: 6px 0 6px 18px;
        }}
        li {{ margin: 2px 0; }}

        table {{
          width: 100%;
          border-collapse: collapse;
          margin: 8px 0 12px 0;
          font-size: 11px;
        }}
        th, td {{
          border: 1px solid #ccc;
          padding: 6px;
          text-align: left;
        }}
        th {{ background: #f2f2f2; }}

        img {{
          display: block;
          margin: 8px auto 8px auto;
          max-width: 70%;
          height: auto;
          page-break-inside: avoid;
        }}

        .chart-block {{
          page-break-inside: avoid;
          margin-bottom: 12px;
        }}

        code {{
          background: #f6f6f6;
          padding: 2px 4px;
          border-radius: 4px;
          font-size: 11px;
        }}
        pre code {{
          display: block;
          padding: 8px;
          overflow-x: auto;
        }}
      </style>
    </head>
    <body>
      {html_body}
    </body>
    </html>
    """

    pdf_path = ARTIFACTS_DIR / "report.pdf"
    weasyprint.HTML(
        string=html_template,
        base_url=str(ARTIFACTS_DIR.parent.resolve())
    ).write_pdf(str(pdf_path))

    return str(pdf_path)
Dit registreert simpelweg alle drie de functies als beschikbare tools voor de agent om te gebruiken.
TOOLS = [load_dataset, run_python, render_pdf]Deze klasse definieert een gedeeld state‑object dat alles bevat wat de agentworkflow produceert: zoals het datasetpad, profileringsinfo, het gegenereerde plan, code, uitvoeringsresultaten, inzichten en het eindrapport, plus herhaal‑limieten en foutmeldingen om oneindige lussen te voorkomen.
class State(BaseModel):
    dataset_path: str
    profile: dict | None = None
    plan: dict | None = None
    code: str | None = None
    exec_result: dict | None = None
    charts_meta: list | None = None
    insights: str | None = None
    report_md: str | None = None
    report_pdf: str | None = None

    retry_count: int = 0          # NEW: stop infinite loops
    last_error: str | None = None # NEW: pass traceback to coder

MAX_RETRIES = 2We maken nu AI‑agents die samenwerken om de dataset te profileren, analysecode te schrijven en uit te voeren, inzichten te genereren en een definitief PDF‑rapport te produceren.
Deze agent is verantwoordelijk voor het begrijpen van de dataset en het maken van een gestructureerd analyseplan. Hij laadt eerst de dataset met de tool load_dataset, die een samenvatting geeft met vormen, ontbrekende waarden, kolomtypes, beschrijvende statistieken en voorbeeldrijen.
Vervolgens stuurt hij deze datasetsamenvatting naar de LLM met zeer expliciete instructies: bepaal het taaktype, kies indien van toepassing een doeldkolom, beslis welke exploratieve stappen moeten worden gezet, stel de te genereren grafieken voor en schets eventuele modelleer‑stappen als de dataset classificatie of regressie suggereert.
De LLM retourneert een JSON‑structuur die dit plan weergeeft, en de agent parseert die, met een fallback naar ruwe tekst als JSON‑parsing mislukt.
Tot slot slaat hij zowel het datasetprofiel als het gegenereerde plan op in de gedeelde state, zodat de volgende agents alle informatie hebben die ze nodig hebben.
@traceable(name="profiler_agent")
def profiler_agent(state: State):
    profile = load_dataset(state.dataset_path)

    prompt = f"""
    You are the Data Profiler Agent.
    Produce a JSON analysis plan with:
      - task_type: "classification"|"regression"|"eda_only"
      - target_column (if any)
      - eda_steps (list)
      - charts_to_make (list)  # 5-10 max, most informative
      - baseline_model_steps (list if modeling)
      - risks_or_data_issues (list)

    Dataset profile:
    {json.dumps(profile, indent=2)}
    """

    resp = gemini_call(prompt, thinking_level="high")
    text = resp["generations"][0]["text"]

    try:
        plan = json.loads(text)
    except:
        plan = {"raw_plan": text}

    state.profile = profile
    state.plan = plan
return stateDeze agent zet het analyseplan om in uitvoerbare Python‑code. Hij ontvangt het datasetprofiel, het plan en eventuele eerdere uitvoeringsfout. Met al die context vraagt hij de LLM om uitsluitend Python‑code uit te geven.
De prompt bevat strikte eisen: laad de dataset, volg het plan exact, genereer elke opgegeven grafiek, sla plots op in ARTIFACTS_DIR, houd paden en grafiekmetadata bij, vang console‑output, sluit figuren na opslaan, en bereken optioneel modelleer‑metrics.
Dit zorgt ervoor dat de code reproduceerbaar en veilig is in de sandbox. Het resultaat wordt opgeslagen in state.code, klaar voor de executor om te draaien.
@traceable(name="code_writer_agent")
def code_writer_agent(state: State):
    prompt = f"""
    You are the Code Writer Agent.
    Write Python code ONLY (no markdown).

    Previous error to fix (if any):
    {state.last_error}

    HARD REQUIREMENTS:
    1. Load dataset from: {state.dataset_path}
    2. Follow the plan exactly.
    3. Create ALL charts in charts_to_make.
    4. Save every chart in ARTIFACTS_DIR with filenames like:
         ARTIFACTS_DIR / "chart_01_<short_name>.png"
    5. Track saved plot paths in _artifacts (list[str]).
    6. Track chart metadata in _charts_meta (list[dict]) with:
         {{
           "title": "<human readable chart title>",
           "filename": "artifacts/chart_01_x.png",
           "description": "<what this plot shows (1-2 sentences)>",
           "one_liner": "<ONE line insight from the chart>"
         }}
       The one_liner MUST be a single sentence, max ~20 words.

    7. Store useful console output in _stdout.

    IMPORTANT:
    - import matplotlib.pyplot as plt
    - plt.close() after saving each plot
    - ensure _artifacts and _charts_meta exist even if empty
    - if modeling, add baseline metrics to _stdout

    Dataset profile:
    {json.dumps(state.profile, indent=2)}

    Analysis plan:
    {json.dumps(state.plan, indent=2)}

    Return ONLY executable python code.
    """

    resp = gemini_call(prompt, thinking_level="high")
    state.code = resp["generations"][0]["text"]
return stateDeze agent draait de Python‑code die door de Code‑schrijver is geproduceerd met de geïsoleerde run_python‑sandbox. Hij legt uitvoeringsresultaten, grafiekmetadata, standaarduitvoer en alle gemaakte artifacts vast.
Als de code succesvol draait, worden de resultaten opgeslagen en gaat de workflow normaal verder. Als het mislukt, verhoogt de agent de retry‑teller en slaat de traceback op zodat de Code‑schrijver de fout bij de volgende poging kan herstellen.
Met MAX_RETRIES om de lus te begrenzen, voorkomt deze agent oneindig herhalen en levert hij de feedbacksignalen die nodig zijn voor zelfcorrectie.
@traceable(name="executor_agent")
def executor_agent(state: State):
    result = run_python(state.code)
    state.exec_result = result
    state.charts_meta = result.get("charts_meta", [])

    if not result["ok"]:
        state.retry_count += 1
        state.last_error = result.get("traceback", "Unknown error")

return stateDeze agent interpreteert de volledige analyse. Hij neemt het datasetprofiel, de uitvoer van de uitvoering en de grafiekmetadata, en produceert menselijk leesbare analytische inzichten.
Hij instrueert de LLM om gestructureerde inzichten te genereren: voor elke grafiek twee takeaways en één risico, en vervolgens een beperkte set algemene inzichten.
De agent moet zorgen voor geen lege bullets, geen herhaalde punten, en inzichten moeten specifiek zijn voor de dataset en niet generiek.
Het resulterende inzichtverslag wordt opgeslagen in state.insights en wordt een input voor de laatste rapportagestap.
@traceable(name="insights_agent")
def insights_agent(state: State):
    prompt = f"""
    You are the Insights Agent.

    HARD REQUIREMENTS:
    - No empty bullets.
    - No repeated bullets.
    - Be specific to this dataset and these charts.
    - Output format:

      ### Chart Insights
      For each chart in charts_meta:
      - **<title>**
        - Takeaway 1 (one sentence)
        - Takeaway 2 (one sentence)
        - Caveat/Risk (one sentence)

      ### Overall Insights
      - 3-5 bullets max, each one sentence.

    Inputs:
    Profile:
    {json.dumps(state.profile, indent=2)}

    Execution result:
    {json.dumps(state.exec_result, indent=2)}

    Charts meta:
    {json.dumps(state.charts_meta, indent=2)}
    """

    resp = gemini_call(prompt, thinking_level="high")
    state.insights = resp["generations"][0]["text"]
return stateDit is de laatste synthese‑agent. Hij gebruikt de volledige pipeline‑output: profiel, inzichten, grafiekmetadata, uitvoeringslogs en stelt een volledig, netjes Markdown‑rapport samen.
De prompt dwingt strikte opmaakregels af: geen dubbele titels, consistente witruimte, elke grafiek exact één keer weergegeven in een gestandaardiseerd HTML‑blok, en inzichten netjes geïntegreerd.
Zodra de Markdown is gemaakt, roept de agent render_pdf aan om deze met WeasyPrint om te zetten in een gepolijste PDF. Zowel de Markdown als het PDF‑pad worden opgeslagen in de gedeelde state, waarmee de analyseworkflow wordt afgerond.
@traceable(name="report_agent")
def report_agent(state: State):
    prompt = f"""
    You are the Report Agent.
    Create a neat Markdown report (HTML allowed).

    HARD REQUIREMENTS:
    - Do NOT repeat section titles or chart titles.
    - Do NOT output empty bullet points. If a bullet would be empty, skip it.
    - Keep spacing consistent: one blank line between sections.
    - Use charts_meta as the ONLY source of charts.
    - Include EVERY chart, exactly once, in the same order as charts_meta.
    - For each chart output EXACTLY this block:

      <div class="chart-block">
        <h3>Chart {{i}}: {{title}}</h3>
        <img src="{{filename}}" alt="{{title}}">
        <p><b>What it shows:</b> {{one_liner}}</p>
      </div>

      Where:
      - title, filename, one_liner come from charts_meta
      - one_liner must be ONE sentence, max ~20 words.

    Sections:
    1. Dataset Overview (short)
    2. Data Quality Notes (bullets)
    3. Exploratory Analysis (chart-by-chart blocks only, no extra chart titles)
    4. Modeling Results (if any; use a markdown table)
    5. Key Insights (use insights text)
    6. Recommendations / Next Steps (bullets)

    Inputs:
    Profile: {json.dumps(state.profile, indent=2)}
    Exec stdout: {state.exec_result.get("stdout","")}
    Exec ok: {state.exec_result.get("ok")}
    Traceback (if any): {state.exec_result.get("traceback","")}
    Charts meta:
    {json.dumps(state.charts_meta, indent=2)}
    Insights:
    {state.insights}

    Return ONLY the Markdown report.
    """

    resp = gemini_call(prompt, thinking_level="low")
    state.report_md = resp["generations"][0]["text"]
    state.report_pdf = render_pdf(state.report_md)
return stateDeze laatste stap omvat het samenstellen van de complete multi‑agentworkflow door alle agents in een toestand‑gestuurde graaf te combineren.
Er wordt een StateGraph gemaakt met een gedeeld State‑model, zodat elke agent tijdens de workflow met hetzelfde evoluerende state‑object werkt. Elk onderdeel, zoals de profiler, code‑schrijver, executor, inzichten‑schrijver en rapportbouwer, wordt als een aparte node aan de graaf toegevoegd, die een specifieke fase in de pipeline vertegenwoordigt.
De workflow start altijd met de profiler‑agent, die als instappunt is aangewezen. Dit zorgt ervoor dat het proces begint met een grondig begrip van de dataset en het genereren van een analyseplan.
Er worden edges gedefinieerd om de stroom van het proces vast te leggen. Na profilering gaat de uitvoer naar de code‑schrijver, die vervolgens doorvoer geeft aan de executor. De sleutel ligt in de conditionele routering vanaf de executor.
Een hulpfunctie, retry_or_continue, bekijkt het uitvoeringsresultaat. Als de code succesvol draait, gaat de workflow door naar de inzichten‑agent.
Als het mislukt maar er nog retries beschikbaar zijn, wordt er teruggesprongen naar de code‑schrijver voor automatische correctie.
Als er geen retries meer over zijn, wordt verdere analyse overgeslagen en gaat het direct naar de rapportgenerator, zodat het systeem niet in een eindeloze lus terechtkomt. De conditionele edges worden opgenomen in de executor‑node zodat de workflow zich kan aanpassen op basis van succes of falen van de uitvoering.
Tot slot verbindt de graaf de inzichtfase met de rapportfase, en vanaf de rapportfase met het einde van de workflow. De graaf wordt daarna gecompileerd tot een uitvoerbare structuur en er wordt een ASCII‑diagram gegenereerd om de flow te visualiseren.
Deze multi‑agentgraaf orkestreert de volledige adaptieve analysepipeline, met ondersteuning voor foutherstel, stapsgewijze coördinatie en soepele overgangen tussen agents.
g = StateGraph(State)

g.add_node("profiler", profiler_agent)
g.add_node("code_writer", code_writer_agent)
g.add_node("executor", executor_agent)
g.add_node("insights", insights_agent)
g.add_node("report", report_agent)

g.set_entry_point("profiler")
g.add_edge("profiler", "code_writer")
g.add_edge("code_writer", "executor")

def retry_or_continue(state: State):
    # success path
    if state.exec_result and state.exec_result.get("ok"):
        return "insights"
    # stop retrying after MAX_RETRIES
    if state.retry_count >= MAX_RETRIES:
        return "report"
    return "code_writer"

g.add_conditional_edges(
    "executor",
    retry_or_continue,
    {"code_writer": "code_writer", "insights": "insights", "report": "report"}
)

g.add_edge("insights", "report")
g.add_edge("report", END)

graph = g.compile()

print(graph.get_graph().draw_ascii())
+-----------+
| __start__ |
+-----------+
*
*
*
+----------+
| profiler |
+----------+
*
*
*
+-------------+
| code_writer |
+-------------+
.
.
.
+----------+
| executor |
+----------+
.. ..
.. ..
. ..
+----------+ .
| insights | ..
+----------+ ..
** ..
** ..
* .
+--------+
| report |
+--------+
*
*
*
+---------+
| __end__ |
+---------+ Om de volledige pipeline te draaien, geef je simpelweg een datasetpad op, maak je een initiële State‑instantie en roep je de gecompileerde graaf aan. In ons geval geven we de Boston Housing‑dataset mee.
DATASET_PATH = "/work/housing.csv"  # <-- change this

state = State(dataset_path=DATASET_PATH)
out = graph.invoke(state)
Na het aanroepen voert het multi‑agentsysteem automatisch de volledige analyse uit: de dataset profileren, een plan genereren, Python‑code schrijven en uitvoeren, inzichten extraheren en zowel een Markdown‑ als een PDF‑rapport produceren.
--- Modeling Baseline Results ---
Dataset Shape: (489, 4)
Linear Regression -> RMSE: 82,395.54, R2: 0.6911
Random Forest     -> RMSE: 56,931.38, R2: 0.8525
Observations: Random Forest typically outperforms Linear Regression due to capturing non-linear relationships (e.g., LSTAT).
Na afloop kun je je LangSmith‑dashboard openen en naar het project “autolab-gemini3pro” gaan. Elke agent‑run verschijnt daar.
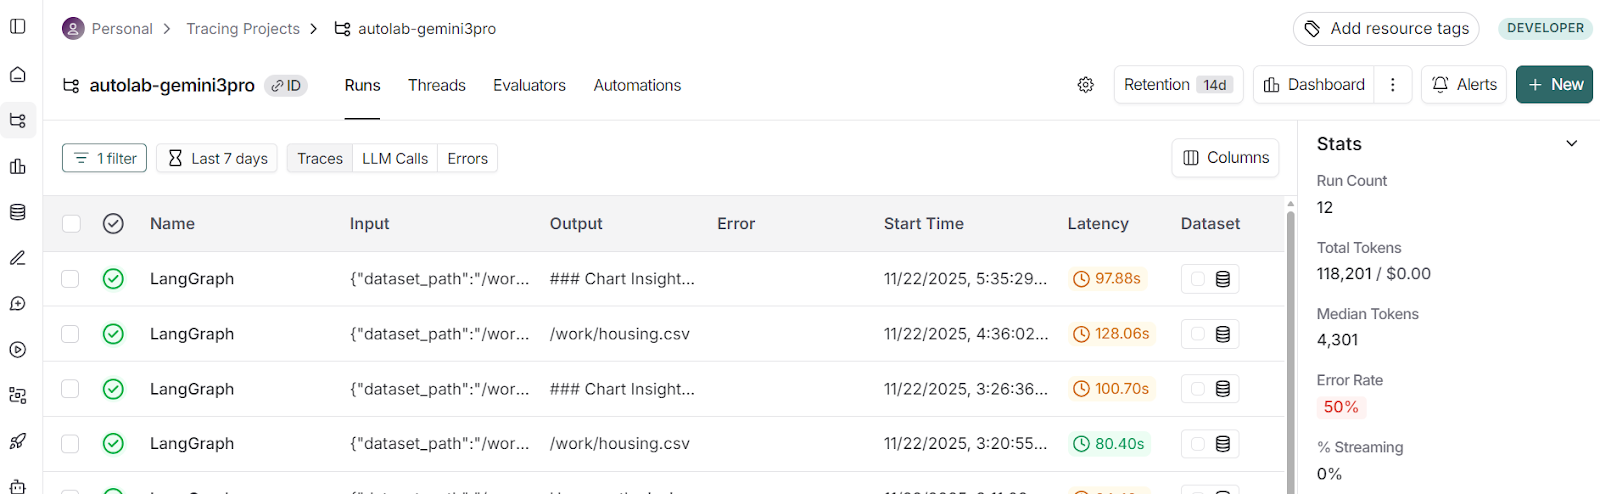
Als je op de recente run klikt en overschakelt naar de Waterfall‑weergave, zie je de tijdlijn van elke stap: hoe lang de agents erover deden en welke tools ze gebruikten.

Je kunt elke agent openen om te inspecteren:
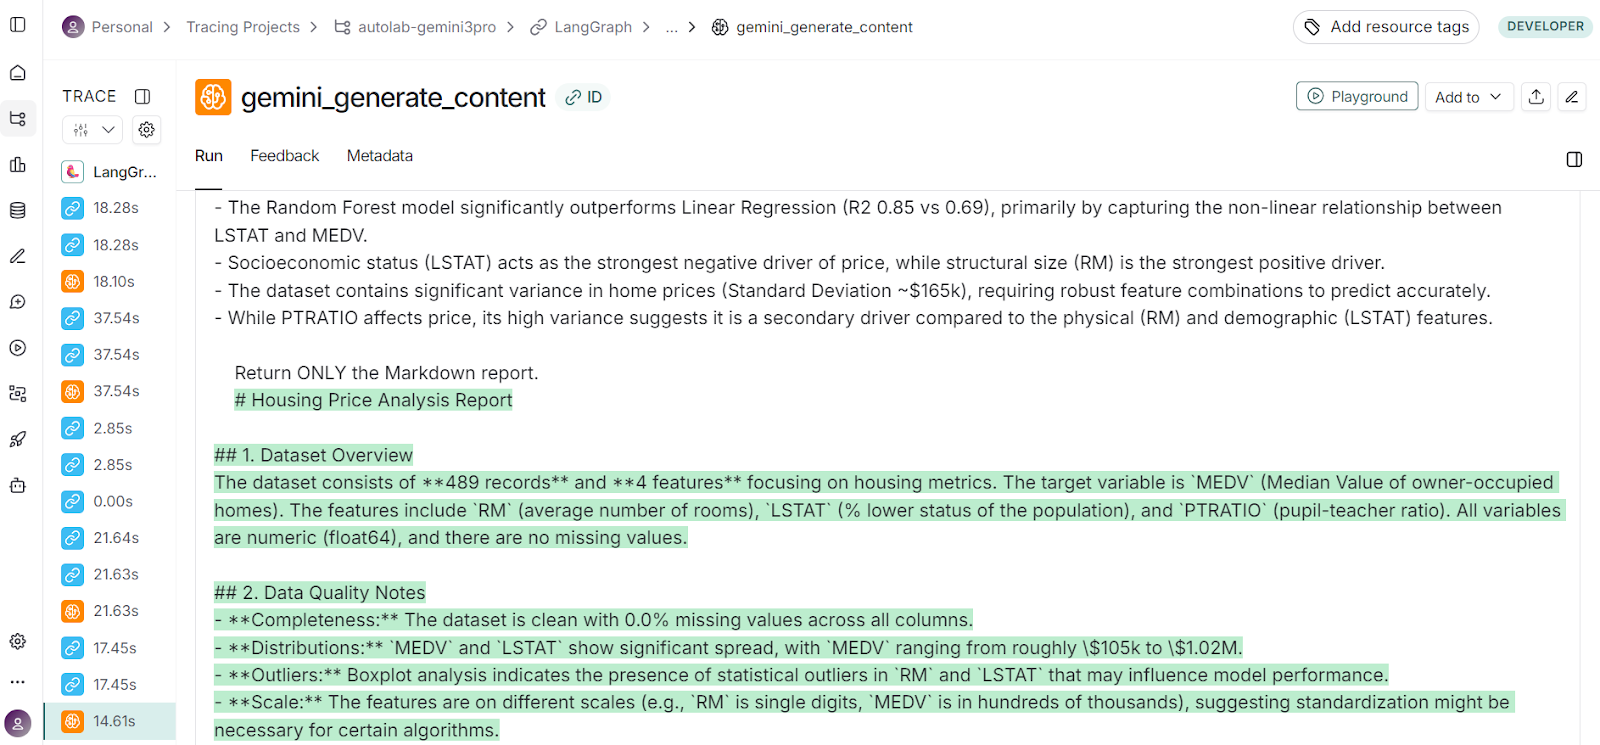
LangSmith was cruciaal bij het verbeteren van de hele workflow. Wat je ziet is de eindversie, maar het kostte veel pogingen om dit project goed te krijgen, en LangSmith hielp me de problemen in de agents te debuggen.
Zodra de multi‑agentworkflow is voltooid, kun je het gegenereerde Markdown‑rapport direct in je notebook bekijken.
De Markdown‑versie is handig om snel de analyse te beoordelen, inzichten te lezen en de rapportstructuur te bekijken zonder je werkruimte te verlaten.
print(out["report_md"][:2000])# Housing Price Analysis Report
## 1. Dataset Overview
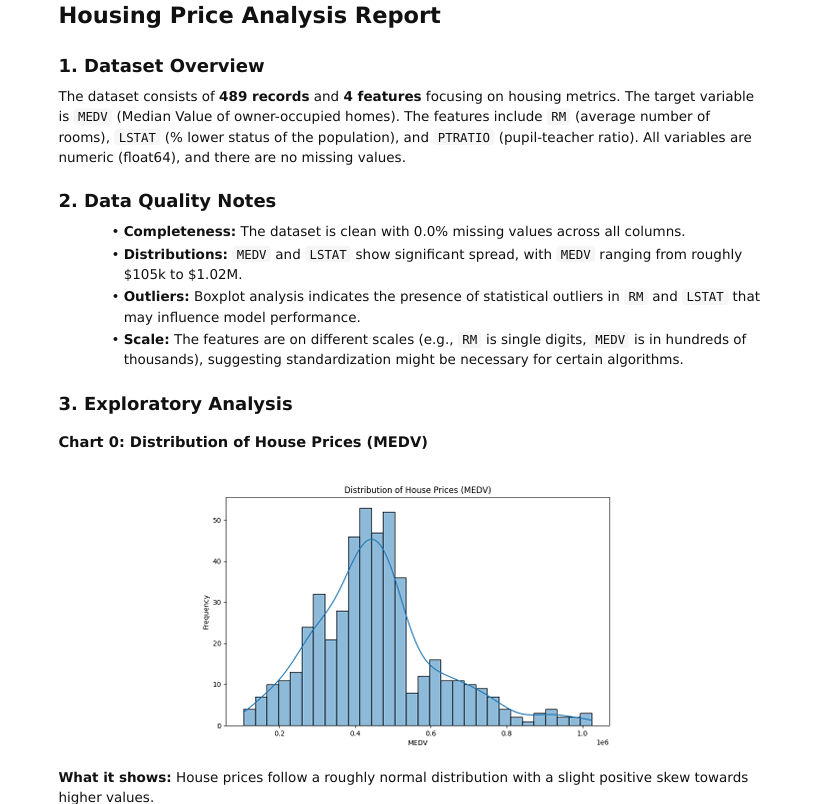
The dataset consists of **489 records** and **4 features** focusing on housing metrics. The target variable is `MEDV` (Median Value of owner-occupied homes). The features include `RM` (average number of rooms), `LSTAT.............Naast de Markdown produceert de workflow ook een gepolijst PDF‑rapport. De PDF wordt automatisch opgeslagen in de artifacts‑map, en je kunt het pad zo bekijken:
print("PDF saved at:", out["report_pdf"])PDF saved at: artifacts/report.pdfDe gegenereerde PDF is uitstekend en bevat alle kernelementen van de analyse: verhalende uitleg, visueel weergegeven grafieken, interpretaties van grafieken, modelleringsoverzichten en eindaanbevelingen.
Dit maakt het ideaal om te delen met teamgenoten, leidinggevenden of klanten, vooral wanneer je een nette, presentatieklare versie van de resultaten wilt.
Werken aan dit project maakte duidelijk hoe ver moderne AI‑modellen en graaf‑gebaseerde agentworkflows zijn geëvolueerd. Nog niet zo lang geleden kostte het dagen finetuning, debuggen en omgaan met onvoorspelbaar gedrag om zelfs maar één agent met meerdere tools te bouwen.
Tegenwoordig kan een systeem met modellen zoals Gemini 3 Pro de dataset begrijpen, accurate code genereren, analyses draaien, visualisaties interpreteren en een gepolijst rapport samenstellen met opmerkelijke betrouwbaarheid.
In dit project hebben we een complete multi‑agent data‑analyseapplicatie gebouwd die elke CSV‑dataset kan verwerken, end‑to‑end exploratieve analyse kan uitvoeren, basismodellen kan draaien, inzichten kan genereren en een volledig opgemaakt PDF‑rapport kan produceren.
Dit project gebruikt vijf gecoördineerde agents: profilering & planning, codegeneratie, uitvoering met retries, inzichten genereren en rapportage, en drie kerntools voor datasetladen, veilige code‑uitvoering en Markdown‑naar‑PDF‑rendering.
Het resultaat is een schone, geautomatiseerde analyseflow die een professioneel, verhalend rapport oplevert, ondersteund door visualisaties.
Topcursussen op DataCamp
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

