

Wat is DeepSeek-Coder-V2?
DeepSeek-Coder-V2 is een open-source Mixture-of-Experts (MoE) code-taalmodel dat kan wedijveren met de prestaties van GPT-4 op codespecifieke taken. Dit model is ontworpen om developers te ondersteunen en brengt verschillende belangrijke features mee:
- Meertalig: Getraind op zowel code als natuurlijke taal in meerdere talen, waaronder Engels en Chinees, waardoor het veelzijdig inzetbaar is voor wereldwijde developmentteams.
- Veelzijdig: Ondersteunt een uitgebreid scala van meer dan 338 programmeertalen, voor uiteenlopende code-omgevingen en behoeften.
- Grote schaal: Voorgetraind op biljoenen tokens aan code- en tekstdata, wat het begrip en de generatie in uiteenlopende code-scenario’s versterkt.
- Meerdere groottes: De modellen zijn beschikbaar in verschillende groottes, zodat developers het model kunnen kiezen dat het best past bij hun rekenmiddelen en projectvereisten.
Je kunt het model gebruiken via de website van DeepSeek; ze bieden betaalde API-toegang en een chat. De broncode is beschikbaar op GitHub en het onderzoeksartikel staat op arXiv.
De modellen worden gehost op Huggingface—maar je hebt onderzoeks-grade hardware nodig om de modellen lokaal te draaien vanwege hun omvang.
DeepSeek-Coder-V2-benchmarks
Laten we kijken hoe goed DeepSeek-Coder-V2 presteert op benchmarks en hoe het zich verhoudt tot modellen als GPT-4 Turbo, Gemini 1.5 Pro, Claude 3 Opus, LLaMA 3-70B en Codestral.
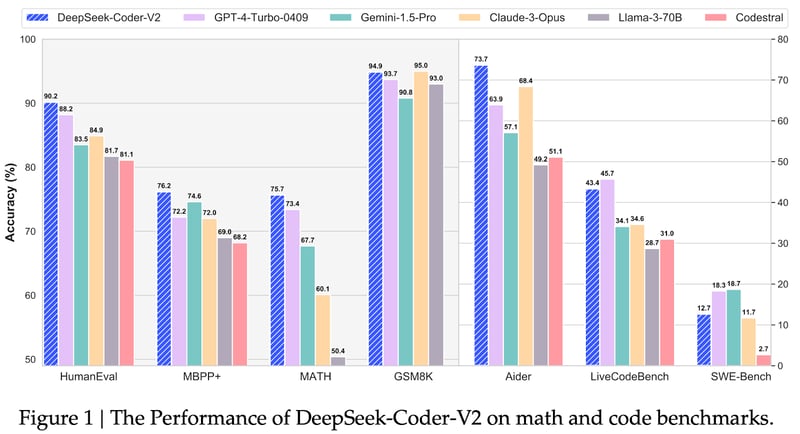
Bron: Qihao Zhu e.a.
HumanEval
De HumanEval-benchmark meet de vaardigheid in codegeneratie door te evalueren of gegenereerde code specifieke unittests doorstaat. DeepSeek-Coder-V2 laat hier uitzonderlijke prestaties zien met een nauwkeurigheid van 90,2%. Dit onderstreept het vermogen van het model om functionele en accurate codefragmenten te genereren, zelfs in complexe scenario’s.
MBPP+
De MBPP+-benchmark richt zich op codebegrip en beoordeelt het vermogen van een model om codestructuren en -semantiek te begrijpen en te interpreteren. DeepSeek-Coder-V2 blinkt ook hier uit met een nauwkeurigheid van 76,2%, wat wijst op een sterk begrip van de betekenis en functionaliteit van code.
MATH
De MATH-benchmark test het wiskundig redeneervermogen van een model binnen code. DeepSeek-Coder-V2 behoudt zijn voorsprong met een nauwkeurigheid van 75,7%, wat duidt op vaardigheid in het afhandelen van wiskundige bewerkingen en logica die in code zijn ingebed—cruciaal bij veel programmeertaken.
GSM8K
De GSM8K-benchmark richt zich op het oplossen van rekenkundige tekstproblemen op basisschoolniveau en beoordeelt bredere probleemoplossende vaardigheden dan puur codegeneratie. DeepSeek-Coder-V2 eindigt net achter Claude 3 Opus met een nauwkeurigheid van 94,9% en laat zien wiskundige problemen in natuurlijke taal te kunnen begrijpen en oplossen.
Aider
De Aider-benchmark evalueert het vermogen van een model om code-assistentie en suggesties te bieden. DeepSeek-Coder-V2 leidt met een nauwkeurigheid van 73,7%, wat suggereert dat het een waardevol hulpmiddel kan zijn voor developers die realtime begeleiding en ondersteuning zoeken tijdens het coderen.
LiveCodeBench
De LiveCodeBench-benchmark meet codegeneratieprestaties in realistische scenario’s. DeepSeek-Coder-V2 behaalt een nauwkeurigheid van 43,4% (tweede na GPT-4-Turbo-0409) en toont daarmee het vermogen om functionele en bruikbare code te genereren in praktische contexten.
SWE Bench Benchmark
De SWE-Bench-benchmark beoordeelt AI-modellen specifiek op hun vermogen om software-engineeringtaken uit te voeren, zoals codegeneratie, debuggen en het begrijpen van complexe programmeerconcepten. In deze context behaalde DeepSeek-Coder-V2 een score van 12,7—solide, maar niet leidend. Het blijft achter bij GPT-4-Turbo-0409 (18,7) en Gemini-1.5-Pro (18,3), die beter presteren op deze taken. DeepSeek-Coder-V2 presteerde echter beter dan modellen als Claude-3-Opus (11,7), Llama-3-70B (2,7) en Codestral, wat suggereert dat het een betrouwbare, maar niet topklasse optie is voor software-engineeringtoepassingen op basis van deze benchmark.
Hoe DeepSeek-Coder-V2 werkt
DeepSeek-Coder-V2 bouwt voort op het DeepSeek-V2-model en gebruikt een geavanceerde Mixture-of-Experts (MoE)-architectuur om hoge prestaties op codespecifieke taken te behalen. Het model benut meerdere expertmodellen, elk gespecialiseerd in verschillende codeertaken, en selecteert dynamisch de meest relevante expert op basis van de inputcode. Deze aanpak verhoogt de efficiëntie en nauwkeurigheid.
Het trainingsproces van DeepSeek-Coder-V2 omvat meerdere cruciale componenten. Het is voorgetraind op een uitgebreide dataset bestaande uit 60% broncode, 10% wiskundecorpus en 30% natuurlijke-taalcorpus, in totaal 10,2 biljoen tokens. Deze diverse dataset stelt het model in staat om code effectief te begrijpen en te genereren. De broncodedataset omvat 1.170 miljard tokens afkomstig van GitHub en CommonCrawl en bestrijkt 338 programmeertalen—een aanzienlijke uitbreiding ten opzichte van eerdere modellen.
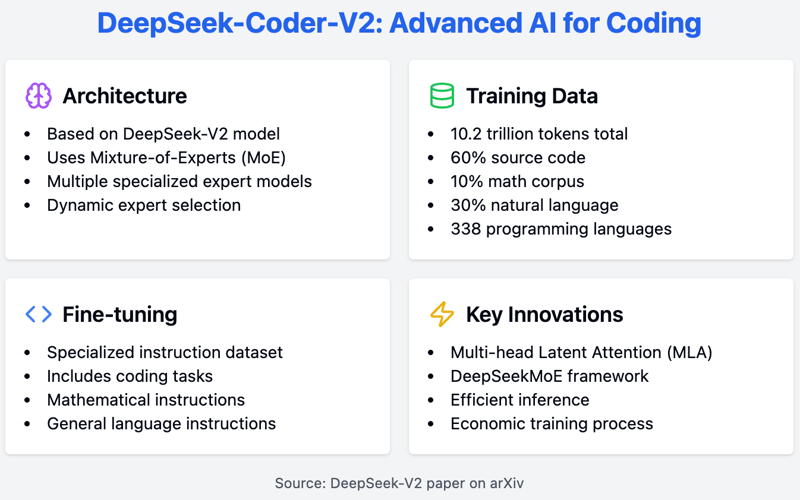
Na de pretraining ondergaat het model fine-tuning met een gespecialiseerde instructiedataset met codeer-, wiskunde- en algemene taalopdrachten. Dit verbetert de respons op prompts in natuurlijke taal en maakt van het model een bruikbare assistent.
Voor wie geïnteresseerd is in de onderliggende architectuur: het DeepSeek-V2-model, waarop DeepSeek-Coder-V2 is gebaseerd, introduceert innovaties zoals Multi-head Latent Attention (MLA) en het DeepSeekMoE-framework. Deze vernieuwingen dragen bij aan efficiënte inferentie en economisch trainen, zoals beschreven in het DeepSeek-V2-artikel op arXiv.
Aan de slag met DeepSeek-Coder-V2
Er zijn verschillende manieren om met het DeepSeek-Coder-V2-model te beginnen. Je kunt het model lokaal draaien via Hugging Face’s transformers-bibliotheek. Houd er wel rekening mee dat de modellen behoorlijk groot zijn en veel rekenkracht vereisen.
Als alternatief biedt DeepSeek een betaalde API en een online chatinterface vergelijkbaar met ChatGPT. De online chat van DeepSeek kan zelfs HTML- en JavaScript-code direct in het chatvenster draaien! Deze feature is behoorlijk innovatief—iets soortgelijks heb ik alleen gezien bij de Artifacts van het Claude 3.5 Sonnet-model. Voor dit artikel gebruiken we de chatfunctie voor onze voorbeelden.
DeepSeek-Coder-V2: voorbeeldgebruik
Voor het eerste voorbeeld vraag ik het model om Conway’s Game of Life te programmeren in HTML en JavaScript. Ik gaf het model de volgende prompt: “Kun je Conway’s Game of Life in HTML schrijven?” Dit is de reactie:
Certainly! Below is a simple implementation of Conway's Game of Life using HTML, CSS, and JavaScript. This version will display the grid in an HTML table and update it every second.<!DOCTYPE html>
<html lang="en">
<head>
<meta charset="UTF-8">
<meta name="viewport" content="width=device-width, initial-scale=1.0">
<title>Conway's Game of Life</title>
<style>
table {
border-collapse: collapse;
}
td {
width: 10px;
height: 10px;
border: 1px solid #ccc;
}
.alive {
background-color: black;
}
.dead {
background-color: white;
}
</style>
</head>
<body>
<h1>Conway's Game of Life</h1>
<table id="grid"></table>
<script>
const N = 50; // Grid size
let grid = createGrid(N);
let intervalId;
function createGrid(N) {
let grid = new Array(N);
for (let i = 0; i < N; i++) {
grid[i] = new Array(N);
for (let j = 0; j < N; j++) {
grid[i][j] = Math.random() > 0.7 ? 1 : 0;
}
}
return grid;
}
function renderGrid(grid) {
const table = document.getElementById('grid');
table.innerHTML = '';
for (let i = 0; i < N; i++) {
const row = table.insertRow();
for (let j = 0; j < N; j++) {
const cell = row.insertCell();
cell.classList.add(grid[i][j] ? 'alive' : 'dead');
}
}
}
function updateGrid(grid) {
const newGrid = grid.map(row => row.slice());
for (let i = 0; i < N; i++) {
for (let j = 0; j < N; j++) {
const aliveNeighbors = countAliveNeighbors(grid, i, j);
if (grid[i][j] === 1) {
newGrid[i][j] = aliveNeighbors === 2 || aliveNeighbors === 3 ? 1 : 0;
} else {
newGrid[i][j] = aliveNeighbors === 3 ? 1 : 0;
}
}
}
return newGrid;
}
function countAliveNeighbors(grid, x, y) {
let count = 0;
for (let i = -1; i <= 1; i++) {
for (let j = -1; j <= 1; j++) {
if (i === 0 && j === 0) continue;
const newX = (x + i + N) % N;
const newY = (y + j + N) % N;
count += grid[newX][newY];
}
}
return count;
}
function startGame() {
intervalId = setInterval(() => {
grid = updateGrid(grid);
renderGrid(grid);
}, 1000);
}
renderGrid(grid);
startGame();
</script>
</body>
</html>We kunnen ook op de knop “Run HTML” aan het einde van de reactie klikken om de Game of Life direct in het chatvenster te krijgen.
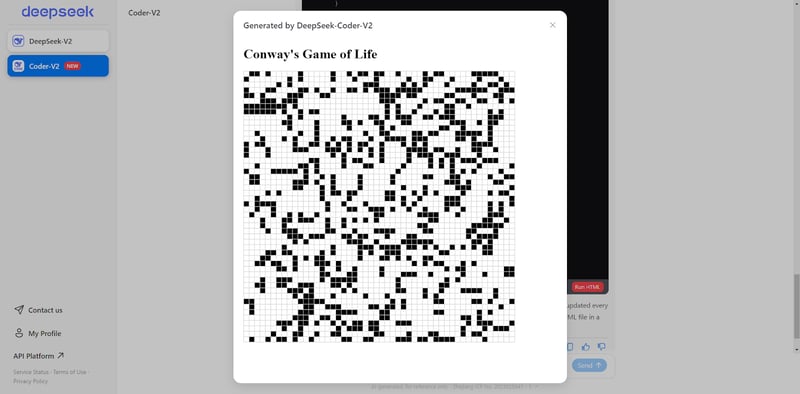
Screenshot door de auteur.
Vervolgens vroeg ik het model om een dynamische website van het spel te maken waarbij ik de beginconfiguratie van het bord kon kiezen. Dit is het resultaat—en het werkt vrijwel vlekkeloos.
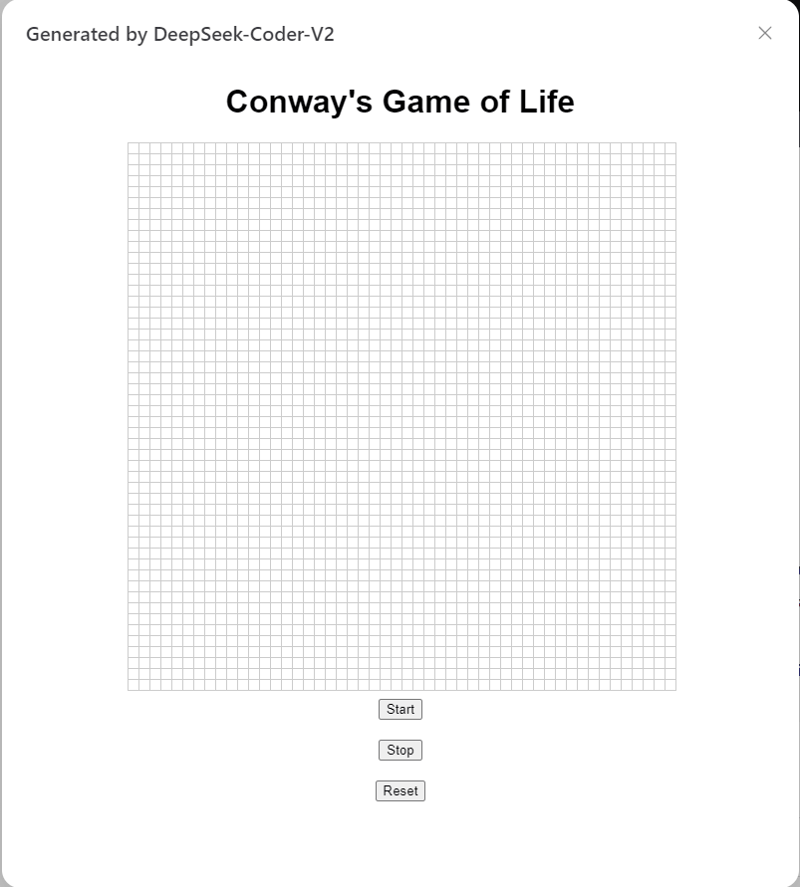
Screenshot door de auteur.
Voor het laatste voorbeeld testte ik het model op een moeilijke Project Euler-opgave—het “springende kikker”-probleem. Hier is de code die het model genereerde:
import numpy as np
MOD = 10**9
def matrix_power(matrix, n):
result = np.identity(len(matrix), dtype=int)
while n > 0:
if n % 2 == 1:
result = np.dot(result, matrix) % MOD
matrix = np.dot(matrix, matrix) % MOD
n //= 2
return result
def fib_matrix(n):
if n == 0:
return 0
elif n == 1:
return 1
A = np.array([[1, 1, 1], [1, 0, 0], [0, 1, 0]], dtype=int)
A_power = matrix_power(A, n - 3)
initial_vector = np.array([2, 1, 1])
return np.dot(A_power, initial_vector)[0] % MOD
def S(L):
result = 0
for n in range(1, L + 1):
f_n = fib_matrix(n)
result = (result + f_n**3) % MOD
return result
# Compute S(10**14) % 10**9
print(S(10**14))Dit script zou eeuwig duren om te draaien, dus ik vroeg het model om het te optimaliseren en kreeg de volgende output:
import numpy as np
MOD = 10**9
def matrix_power(matrix, n):
result = np.identity(len(matrix), dtype=int)
while n > 0:
if n % 2 == 1:
result = np.dot(result, matrix) % MOD
matrix = np.dot(matrix, matrix) % MOD
n //= 2
return result
def fib_matrix(n):
if n == 0:
return 0
elif n == 1:
return 1
A = np.array([[1, 1, 1], [1, 0, 0], [0, 1, 0]], dtype=int)
A_power = matrix_power(A, n - 3)
initial_vector = np.array([2, 1, 1])
return np.dot(A_power, initial_vector)[0] % MOD
def find_pisano_period(m):
previous, current = 0, 1
for i in range(m * m):
previous, current = current, (previous + current) % m
if previous == 0 and current == 1:
return i + 1
def S(L):
pisano_period = find_pisano_period(MOD)
period_sum = 0
for n in range(1, pisano_period + 1):
f_n = fib_matrix(n)
period_sum = (period_sum + f_n**3) % MOD
full_periods, remainder = divmod(L, pisano_period)
result = (full_periods * period_sum) % MOD
for n in range(1, remainder + 1):
f_n = fib_matrix(n)
result = (result + f_n**3) % MOD
return result
# Compute S(10**14) % 10**9
print(S(10**14))Ik liet de geoptimaliseerde code een half uur draaien, maar er kwam nog steeds geen resultaat uit. Hoewel ik denk dat de oplossingen correct zijn, zit de uitdaging in het optimaliseren van de code. Aangezien slechts 328 mensen dit probleem hebben weten op te lossen, is het niet verrassend dat het model het niet kon oplossen.
Conclusie
DeepSeek-Coder-V2 is een waardevolle aanwinst voor het groeiende veld van open-source codeassistenten en laat concurrerende prestaties zien ten opzichte van gevestigde, propriëtaire modellen.
Haal het meeste uit DeepSeek-Coder-V2 door best practices te volgen en duidelijke, specifieke prompts te geven. Ik moedig je ook aan om feedback te geven aan de ontwikkelaars als je bugs tegenkomt.
Als je meer wilt leren over AI-codeassistenten, raad ik deze DataFramed-podcast aan: The Future of Programming with Kyle Daigle, COO at GitHub.



Nu AI-codeassistenten zoals GitHub Copilot aan populariteit winnen onder developers, verschijnen er ook open-source alternatieven.
Een opvallend voorbeeld is DeepSeek-Coder-V2, een robuust open-source model dat geavanceerde machinelearningtechnieken gebruikt. Het is specifiek ontworpen voor codegerelateerde taken en biedt prestaties die vergelijkbaar zijn met GPT-4 bij codegeneratie, -aanvulling en -begrip.
In dit artikel leg ik de functies en mogelijkheden van DeepSeek-Coder-V2 uit en laat ik zien hoe je met deze tool aan de slag gaat.