
Notre promo record : -60 % sur les compétences en IA et data
Acheter
DeepSeek-Coder-V2 est un modèle de langage de code open source basé sur une Mixture-of-Experts (MoE) qui rivalise avec GPT-4 sur les tâches de code. Conçu pour accompagner les développeurs, ce modèle apporte plusieurs atouts clés :
Vous pouvez accéder au modèle sur le site de DeepSeek, qui propose une API payante et un chat. Le code source est disponible sur GitHub et l’article de recherche est hébergé sur arXiv.
Les modèles sont hébergés sur Hugging Face ; toutefois, il faut un matériel de niveau recherche pour exécuter localement ces modèles compte tenu de leur taille.
Voyons comment DeepSeek-Coder-V2 se comporte sur différents benchmarks et comment il se compare à des modèles comme GPT-4 Turbo, Gemini 1.5 Pro, Claude 3 Opus, LLaMA 3‑70B et Codestral.
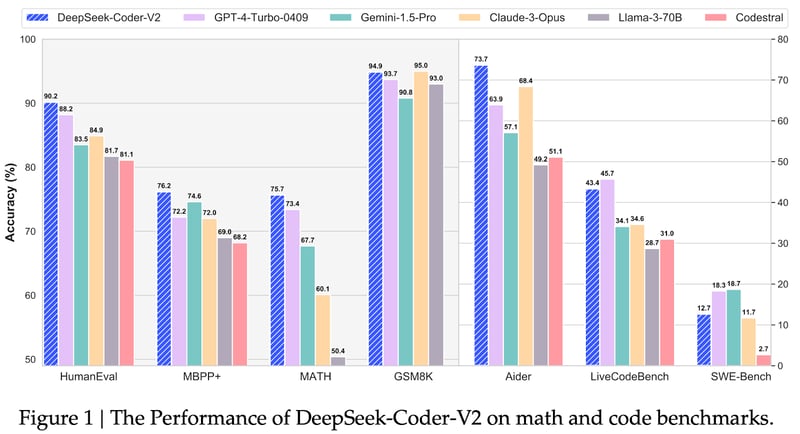
Source : Qihao Zhu et al.
Le benchmark HumanEval mesure l’aptitude à générer du code en vérifiant si le code produit réussit des tests unitaires précis. DeepSeek-Coder-V2 y affiche d’excellents résultats, avec une précision de 90,2 %. Cela souligne sa capacité à générer des extraits de code fonctionnels et exacts, y compris dans des cas complexes.
Le benchmark MBPP+ évalue la compréhension de code, c’est‑à‑dire la capacité du modèle à appréhender les structures et la sémantique. DeepSeek-Coder-V2 y excelle également, avec une précision de 76,2 %, signe d’une solide compréhension du sens et de la fonctionnalité du code.
Le benchmark MATH teste le raisonnement mathématique dans le code. DeepSeek-Coder-V2 conserve son avance avec 75,7 % de précision, indiquant sa maîtrise des opérations et de la logique mathématiques intégrées au code, un enjeu clé de nombreuses tâches de programmation.
GSM8K porte sur la résolution de problèmes arithmétiques de niveau primaire, évaluant des compétences plus larges que la simple génération de code. DeepSeek-Coder-V2 arrive juste derrière Claude 3 Opus avec une précision de 94,9 %, démontrant sa capacité à comprendre et résoudre des problèmes formulés en langage naturel.
Le benchmark Aider évalue la capacité du modèle à assister et suggérer du code. DeepSeek-Coder-V2 arrive en tête avec 73,7 % de précision, signe d’un fort potentiel comme outil d’assistance en temps réel pour les développeurs.
LiveCodeBench mesure la génération de code en conditions réalistes. DeepSeek-Coder-V2 atteint 43,4 % de précision (deuxième après GPT‑4‑Turbo‑0409), montrant sa capacité à produire du code fonctionnel et exploitable en pratique.
Le benchmark SWE‑Bench évalue spécifiquement les modèles d’IA sur des tâches d’ingénierie logicielle : génération de code, débogage et compréhension de concepts complexes. Dans ce cadre, DeepSeek-Coder-V2 obtient un score de 12,7 : une performance solide mais qui n’est pas la meilleure. Il est devancé par GPT‑4‑Turbo‑0409 (18,7) et Gemini‑1.5‑Pro (18,3), supérieurs sur ces tâches. Cependant, DeepSeek-Coder-V2 surpasse Claude‑3‑Opus (11,7), Llama‑3‑70B (2,7) et Codestral, ce qui en fait une option fiable, sans être de tout premier plan, pour les usages d’ingénierie logicielle selon ce benchmark.
DeepSeek-Coder-V2 s’appuie sur le modèle DeepSeek‑V2 et utilise une architecture Mixture‑of‑Experts (MoE) sophistiquée pour atteindre de hautes performances sur les tâches liées au code. Le modèle orchestre plusieurs experts, chacun spécialisé sur des tâches différentes, et sélectionne dynamiquement l’expert le plus pertinent selon l’entrée. Cette approche renforce l’efficacité et la précision.
L’entraînement de DeepSeek-Coder-V2 s’articule autour de plusieurs éléments clés. Il est pré‑entraîné sur un vaste jeu de données composé à 60 % de code source, 10 % de corpus mathématique et 30 % de langage naturel, pour un total de 10,2 billions de tokens. Cette diversité lui permet de bien comprendre et générer du code. Le corpus de code source comprend 1 170 milliards de tokens issus de GitHub et CommonCrawl, couvrant 338 langages, un élargissement majeur par rapport aux modèles précédents.
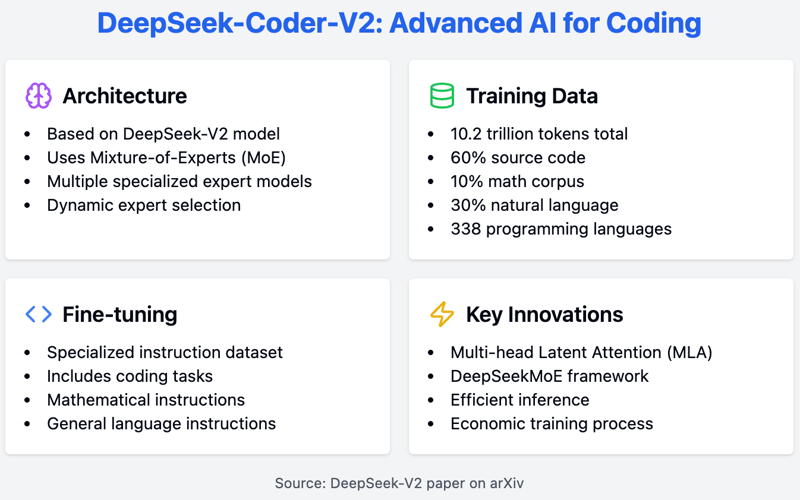
Après le pré‑entraînement, le modèle est affiné avec un jeu d’instructions spécialisé couvrant le code, les mathématiques et le langage général. Ce processus améliore sa réponse aux invites en langage naturel et en fait un assistant réellement utile.
Pour celles et ceux qui s’intéressent à l’architecture sous‑jacente, le modèle DeepSeek‑V2, sur lequel repose DeepSeek‑Coder‑V2, introduit des innovations comme le Multi‑head Latent Attention (MLA) et le framework DeepSeekMoE. Elles contribuent à une inférence efficace et à un entraînement plus économique, comme détaillé dans l’article DeepSeek‑V2 disponible sur arXiv.
Plusieurs options s’offrent à vous pour utiliser DeepSeek‑Coder‑V2. Vous pouvez l’exécuter en local via la bibliothèque transformers de Hugging Face. Notez toutefois que ces modèles sont très volumineux et exigent des ressources de calcul importantes.
Autre possibilité : DeepSeek propose une API payante et une interface de chat en ligne, similaire à ChatGPT. Le chat de DeepSeek peut même exécuter du code HTML et JavaScript directement dans la fenêtre ! Une fonctionnalité assez innovante — je n’ai vu quelque chose d’approchant que dans les Artifacts du modèle Claude 3.5 Sonnet. Pour cet article, nous utiliserons le chat pour nos exemples.
Pour le premier exemple, je demande au modèle de programmer le jeu de la vie de Conway en HTML et JavaScript. J’ai utilisé l’invite : « Pouvez‑vous écrire le jeu de la vie de Conway en HTML ? » Voici la réponse :
Certainly! Below is a simple implementation of Conway's Game of Life using HTML, CSS, and JavaScript. This version will display the grid in an HTML table and update it every second.<!DOCTYPE html>
<html lang="en">
<head>
<meta charset="UTF-8">
<meta name="viewport" content="width=device-width, initial-scale=1.0">
<title>Conway's Game of Life</title>
<style>
table {
border-collapse: collapse;
}
td {
width: 10px;
height: 10px;
border: 1px solid #ccc;
}
.alive {
background-color: black;
}
.dead {
background-color: white;
}
</style>
</head>
<body>
<h1>Conway's Game of Life</h1>
<table id="grid"></table>
<script>
const N = 50; // Grid size
let grid = createGrid(N);
let intervalId;
function createGrid(N) {
let grid = new Array(N);
for (let i = 0; i < N; i++) {
grid[i] = new Array(N);
for (let j = 0; j < N; j++) {
grid[i][j] = Math.random() > 0.7 ? 1 : 0;
}
}
return grid;
}
function renderGrid(grid) {
const table = document.getElementById('grid');
table.innerHTML = '';
for (let i = 0; i < N; i++) {
const row = table.insertRow();
for (let j = 0; j < N; j++) {
const cell = row.insertCell();
cell.classList.add(grid[i][j] ? 'alive' : 'dead');
}
}
}
function updateGrid(grid) {
const newGrid = grid.map(row => row.slice());
for (let i = 0; i < N; i++) {
for (let j = 0; j < N; j++) {
const aliveNeighbors = countAliveNeighbors(grid, i, j);
if (grid[i][j] === 1) {
newGrid[i][j] = aliveNeighbors === 2 || aliveNeighbors === 3 ? 1 : 0;
} else {
newGrid[i][j] = aliveNeighbors === 3 ? 1 : 0;
}
}
}
return newGrid;
}
function countAliveNeighbors(grid, x, y) {
let count = 0;
for (let i = -1; i <= 1; i++) {
for (let j = -1; j <= 1; j++) {
if (i === 0 && j === 0) continue;
const newX = (x + i + N) % N;
const newY = (y + j + N) % N;
count += grid[newX][newY];
}
}
return count;
}
function startGame() {
intervalId = setInterval(() => {
grid = updateGrid(grid);
renderGrid(grid);
}, 1000);
}
renderGrid(grid);
startGame();
</script>
</body>
</html>Nous pouvons aussi cliquer sur le bouton « Run HTML » à la fin de la réponse pour exécuter le jeu directement dans la fenêtre de chat.
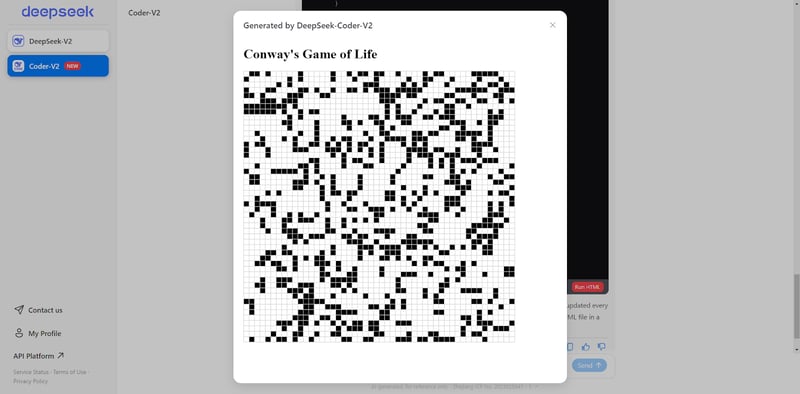
Capture d’écran de l’auteur.
Ensuite, j’ai demandé au modèle de créer un site dynamique du jeu me permettant de choisir la configuration initiale du plateau. Voici le résultat : cela fonctionne de manière très fluide.
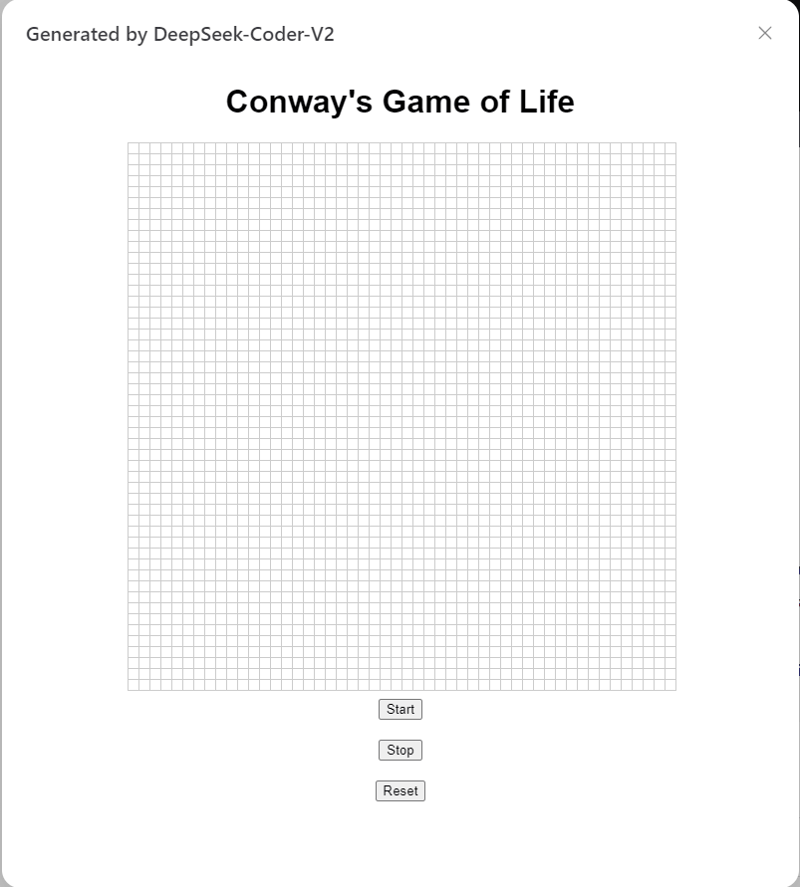
Capture d’écran de l’auteur.
Pour le dernier exemple, j’ai testé le modèle sur un problème difficile de Project Euler — le problème « jumping frog ». Voici le code généré par le modèle :
import numpy as np
MOD = 10**9
def matrix_power(matrix, n):
result = np.identity(len(matrix), dtype=int)
while n > 0:
if n % 2 == 1:
result = np.dot(result, matrix) % MOD
matrix = np.dot(matrix, matrix) % MOD
n //= 2
return result
def fib_matrix(n):
if n == 0:
return 0
elif n == 1:
return 1
A = np.array([[1, 1, 1], [1, 0, 0], [0, 1, 0]], dtype=int)
A_power = matrix_power(A, n - 3)
initial_vector = np.array([2, 1, 1])
return np.dot(A_power, initial_vector)[0] % MOD
def S(L):
result = 0
for n in range(1, L + 1):
f_n = fib_matrix(n)
result = (result + f_n**3) % MOD
return result
# Compute S(10**14) % 10**9
print(S(10**14))Ce script prendrait une éternité à s’exécuter, j’ai donc demandé au modèle de l’optimiser et j’ai obtenu la sortie suivante :
import numpy as np
MOD = 10**9
def matrix_power(matrix, n):
result = np.identity(len(matrix), dtype=int)
while n > 0:
if n % 2 == 1:
result = np.dot(result, matrix) % MOD
matrix = np.dot(matrix, matrix) % MOD
n //= 2
return result
def fib_matrix(n):
if n == 0:
return 0
elif n == 1:
return 1
A = np.array([[1, 1, 1], [1, 0, 0], [0, 1, 0]], dtype=int)
A_power = matrix_power(A, n - 3)
initial_vector = np.array([2, 1, 1])
return np.dot(A_power, initial_vector)[0] % MOD
def find_pisano_period(m):
previous, current = 0, 1
for i in range(m * m):
previous, current = current, (previous + current) % m
if previous == 0 and current == 1:
return i + 1
def S(L):
pisano_period = find_pisano_period(MOD)
period_sum = 0
for n in range(1, pisano_period + 1):
f_n = fib_matrix(n)
period_sum = (period_sum + f_n**3) % MOD
full_periods, remainder = divmod(L, pisano_period)
result = (full_periods * period_sum) % MOD
for n in range(1, remainder + 1):
f_n = fib_matrix(n)
result = (result + f_n**3) % MOD
return result
# Compute S(10**14) % 10**9
print(S(10**14))J’ai laissé tourner le code optimisé pendant une demi‑heure, sans obtenir de résultat. Bien que je pense que les approches soient correctes, la difficulté réside dans l’optimisation. Étant donné que seules 328 personnes ont réussi ce problème, il n’est pas surprenant que le modèle n’y soit pas parvenu.
DeepSeek-Coder-V2 s’impose comme une contribution majeure aux assistants de codage open source, avec des performances compétitives face aux modèles propriétaires établis.
Pour en tirer le meilleur parti, formulez des invites claires et spécifiques. N’hésitez pas non plus à faire remonter vos retours aux développeurs si vous rencontrez des bugs.
Pour aller plus loin sur les assistants de codage en IA, je vous recommande cet épisode du podcast DataFramed : The Future of Programming with Kyle Daigle, COO at GitHub.

blog
 Kurtis Pykes • 9 min

Tutoriel

Tutoriel
Kurtis Pykes • 15 minFormez-vous à l’IA avec ces cours !
Cursus
Apprenez à créer des applications alimentées par l'IA avec les derniers outils de développement d'IA, notamment l'API OpenAI, Hugging Face et LangChain.
Cours
Découvrez comment créer des applications alimentées par l'IA en utilisant des LLM, des invites, des chaînes et des agents dans LangChain.
Cours
Dans ce cours, vous découvrirez le cadre MLOps moderne, en explorant le cycle de vie et le déploiement des modèles d'apprentissage automatique.


Alors que les assistants de codage en IA comme GitHub Copilot gagnent en popularité auprès des développeurs, des alternatives open source voient également le jour.
Un exemple remarquable est DeepSeek-Coder-V2, un modèle open source robuste qui s’appuie sur des techniques avancées d’apprentissage automatique. Conçu spécifiquement pour les tâches liées au code, il offre des performances comparables à GPT-4 en génération, complétion et compréhension de code.
Dans cet article, je vous présente les fonctionnalités et capacités de DeepSeek-Coder-V2 et vous explique comment bien démarrer avec cet outil.