Wat is Llama 3?
Llama 3 is een AI voor tekstgeneratie. Net als de GPT- en Claude-modellen van respectievelijk OpenAI en Anthropic, geef je een tekstprompt en genereert het model een tekstantwoord. De nieuwste modellen beloven betere prestaties, vooral op het gebied van contextbegrip en logisch redeneren. De Llama-modellen drijven Meta AI aan, een slimme assistent in Instagram, WhatsApp, Messenger en Facebook.
Llama 3 is een model met "open weights". Dat betekent dat het model zelf open source is, wat enige transparantie biedt over hoe het berekeningen uitvoert. Toch zijn de volledige details om het te reproduceren, zoals de datasets die voor training zijn gebruikt, niet openbaar beschikbaar.
Een afbeelding van 3 lama’s gemaakt met Midjourney. Prompt: “A cartoon of 3 llamas happily frolicking in a field”
Nieuwe mogelijkheden van Llama3
Llama 3 is beschikbaar in twee groottes: een model met 8 miljard parameters en een model met 70 miljard parameters. In het algemeen leveren meer parameters een betere outputkwaliteit op, maar maken ze het model trager en duurder om te draaien. 70 miljard parameters is vergelijkbaar met veel concurrerende modellen, hoewel er ook modellen zijn met nog grotere aantallen parameters. Een derde, groter model met 400 miljard parameters is aangekondigd als zijnde in ontwikkeling.
Het contextvenster—de hoeveelheid tekst waarover in één keer geredeneerd kan worden—is verdubbeld van 4096 naar 8192 tokens. Een token verwijst naar één woord of leesteken, al worden sommige woorden opgesplitst in meerdere tokens. In het Engels zijn vier tokens ongeveer drie woorden, dus het nieuwe contextvenster komt neer op zo’n 15 pagina’s tekst (bij 400 woorden per pagina). Hoewel de toename welkom is, zit dit nog ver van de voorhoede: Claude 3-modellen bieden een contextvenster van 200.000 tokens.
Verdere kenmerken van het model werden niet beschreven in het aankondigingsartikel. In plaats daarvan lag de focus vooral op het omliggende software-ecosysteem.
Llama 3-ecosysteem
Samen met de aankondiging van Llama3 presenteerde Meta een reeks tools om het werken met Llama makkelijker en veiliger te maken. Hier volgt een overzicht.
Llama Guard 2
Llama Guard 2 is een LLM-tool om tekst als "veilig" of "onveilig" te classificeren. Het kan zowel voor prompts als voor antwoorden worden gebruikt. Zo kan het detecteren of tekst beschrijvingen van geweld, haatdragende taal of andere ongewenste inhoud bevat.
Een voorbeeldtoepassing is een chatbot. Je kunt elke prompt controleren en als de inhoud als onveilig wordt aangemerkt, geef je een waarschuwing of gebruik je een andere manier om met de problematische inhoud om te gaan. Evenzo kun je, als de chatbot een als onveilig aangemerkt antwoord genereert, dit onderscheppen en opnieuw proberen voordat de gebruiker het ziet.
Naast de veilig/onveilig-vlag worden de antwoorden van Llama Guard 2 voorzien van een veiligheidslabel—één van elf categorieën ongewenste inhoud uit de MLCommons AI Safety Taxonomy.
Llama Code Shield
Llama Code Shield classificeert code als veilig of onveilig. Nu veel softwareontwikkelaars LLM’s gebruiken om hen te helpen bij het schrijven van code, bestaat het risico dat onveilige code wordt gegenereerd en in productie belandt. De tool is ontworpen om te worden ingebouwd in AI-codeerassistenten en geïntegreerd in andere tools zoals VSCode en DataLab.
CyberSec Eval 2
CyberSec Eval 2 laat je beoordelen hoe veilig een LLM is. De oorspronkelijke CyberSec Eval laat je de veiligheid van codegeneratie en bescherming tegen cyberaanvallen evalueren. De nieuwste versie bouwt hierop voort, met functies om de vatbaarheid voor prompt-injectie, geautomatiseerde offensieve cybersecurity-capaciteiten en de neiging tot misbruik van een code-interpreter te beoordelen.
torchtune
torchtune is een Python-pakket dat samenwerkt met het PyTorch deep learning-framework om het ontwikkelen van je eigen LLM’s eenvoudiger te maken. Er zijn tools voor vier taken.
- Nieuwe modellen bouwen uit bouwstenen op basis van bestaande LLM’s
- LLM’s fine-tunen met technieken zoals LoRA en QLoRA
- Instellingen configureren voor training, kwantisatie en evaluatie van de modellen
- Prompt-sjablonen en datasetintegratie voor toegankelijkere training
torchtune is geïntegreerd met populaire machinelearningplatforms zoals Hugging Face, Weights & Biases, EleutherAI en Executorch.
Wat zijn de usecases van Llama 3?
De usecases van Llama 3 zijn hetzelfde als die van Llama 2 en andere LLM’s. Veelvoorkomende toepassingen zijn onder meer:
- Chatbots: Klantenservice, support en engagement automatiseren via conversatie-agents.
- Samenvatten van documenten: Lange documenten inkorten tot kortere versies met de kernpunten, nuttig in juridische, academische en zakelijke context.
- Contentcreatie: Artikelen, rapporten, blogs en zelfs creatieve teksten zoals poëzie en verhalen genereren.
- E-mail- en communicatie-assistentie: Het opstellen van e-mails, antwoorden en andere routinematige communicatie automatiseren.
- Productbeschrijvingen: Automatisch unieke en aansprekende productbeschrijvingen genereren voor e-commercewebsites.
- Educatieve tools: Samenvattingen, oefenvragen en educatieve content maken die is afgestemd op het niveau van studenten.
- Programmeren en codegeneratie: Ontwikkelaars helpen door codesnippets te genereren, bestaande code te debuggen of programmeeraanbevelingen te geven.
- Data-analyserapporten: Bevindingen samenvatten en rapporten genereren op basis van gestructureerde data-invoer.
- Virtuele assistenten: Persoonlijke assistent-apps aandrijven die agenda’s beheren, vragen beantwoorden en taken uitvoeren.
Hoe verhoudt de performance van Llama 3 zich?
In de aankondiging van Meta staan benchmarkresultaten voor de versies met acht miljard (8B) en zeventig miljard (70B) parameters van Llama 3, vergeleken met twee andere modellen.
De volgende benchmarks zijn gebruikt.
- Massive Multitask Language Understanding (MMLU). Taken over basale wiskunde, Amerikaanse geschiedenis, informatica, rechten en meer. Om hoge nauwkeurigheid te behalen, moeten modellen beschikken over uitgebreide wereldkennis en probleemoplossend vermogen.
- Graduate-Level Google-Proof Q&A (GPQA). Meerkeuzevragen opgesteld door domeinexperts in biologie, natuurkunde en scheikunde. De vragen zijn van hoge kwaliteit en extreem moeilijk: experts met of werkend aan een PhD in de betreffende domeinen scoren 74% nauwkeurigheid.
- HumanEval. Een test van de functionele correctheid van computercode, gebruikt voor het controleren van codegeneratie.
- GSM-8K. Hoogwaardige, taalkundig diverse rekenverhalen op basisschoolniveau.
- MATH. Wiskundeproblemen voor middelbare school en bovenbouw.
Het Llama 3 8B-model is vergeleken met Google’s Gemma 7B It en Mistral 7B Instruct. Dit zijn LLM’s met een vergelijkbare omvang (een vergelijkbaar aantal parameters), modellen met open weights die beschikbaar zijn op het Hugging Face-platform en bedoeld voor vergelijkbare usecases. De resultaten staan in Figuur 1.
Llama 3 8B presteert ruimschoots beter dan de andere twee modellen op alle vijf benchmarks.
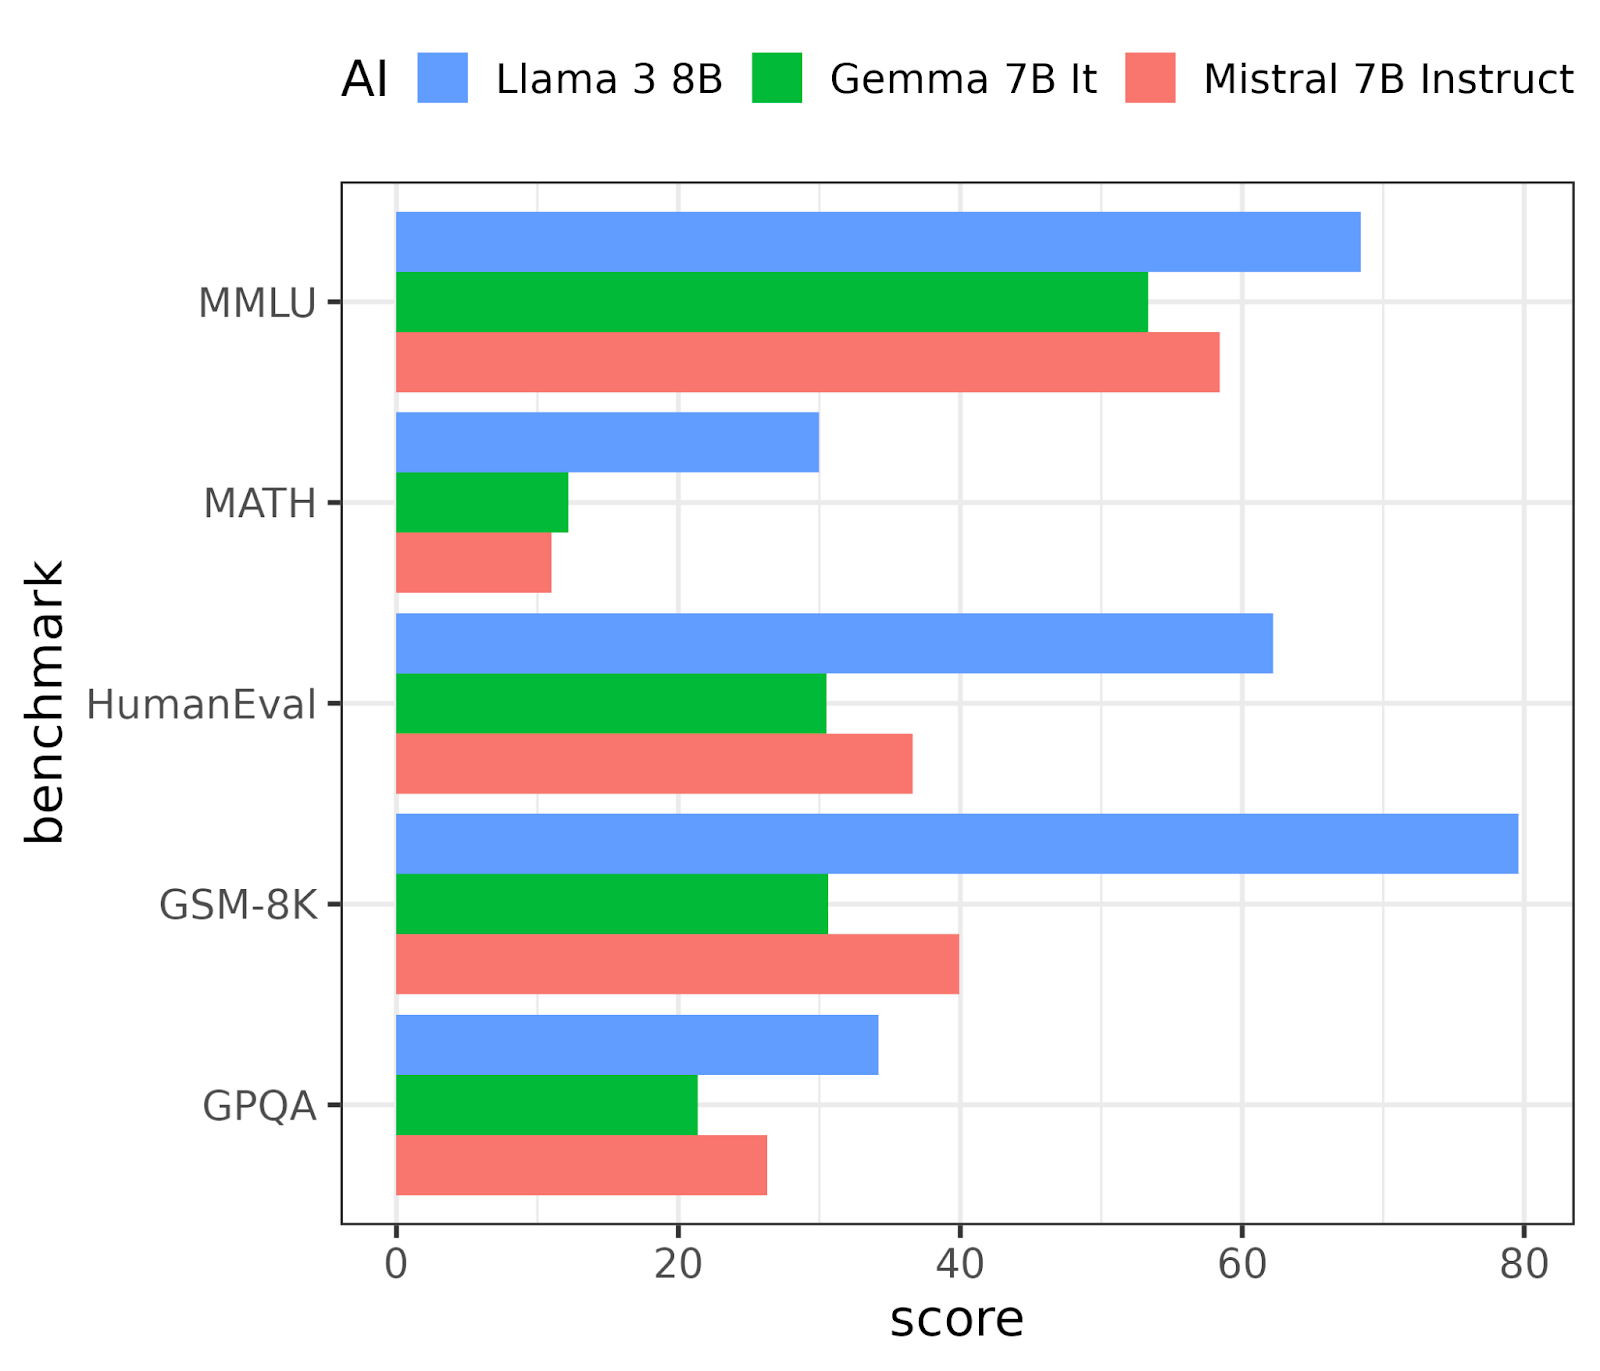
Figuur 1. De prestaties van Llama 3 8B ten opzichte van twee vergelijkbare modellen op 5 LLM-benchmarks.
Llama 3 70B is vergeleken met Google DeepMind’s Gemini Pro 1.5 en Anthropic’s Claude 3 Sonnet. Dit zijn bijna state-of-the-art modellen, al niet de allerbeste beschikbare (die eer gaat momenteel heen en weer tussen OpenAI’s GPT-4 Turbo en Anthropic’s Claude 3 Opus). De resultaten staan in Figuur 2.
Hier zijn de prestaties grotendeels gelijk op drie van de benchmarks. Llama 3 80B wint op de HumanEval-benchmark voor codegeneratie en staat tweede na Gemini Pro 1.5 op de MATH-benchmark.
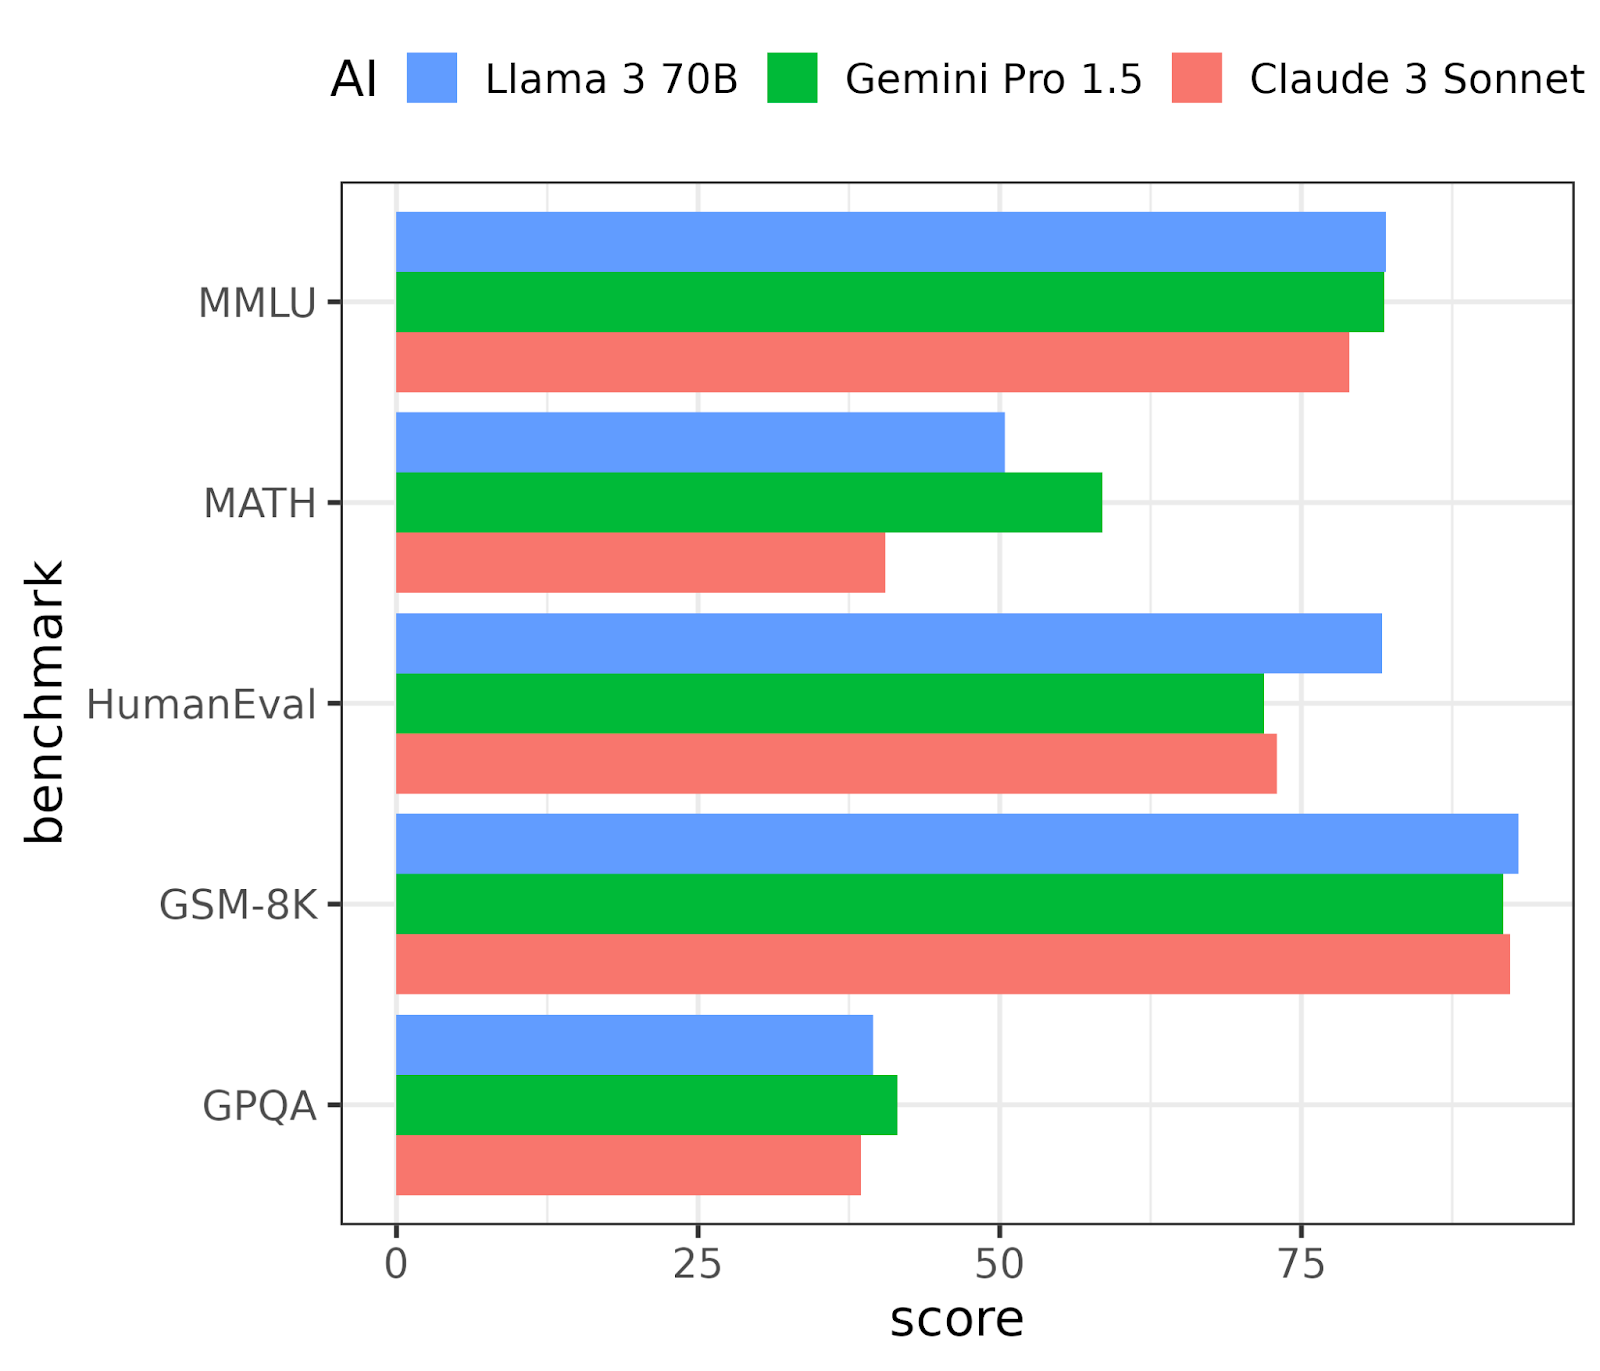
Figuur 2. De prestaties van Llama 3 70B ten opzichte van twee vergelijkbare modellen op 5 LLM-benchmarks.
De benchmarkresultaten interpreteren
Er zijn meer dan vijf benchmarks: Llama 3 is op 15 benchmarks getest, maar in de aankondiging zijn alleen de resultaten voor vijf getoond. Evenzo zijn er veel meer LLM’s om mee te vergelijken. Het is onduidelijk in hoeverre Meta selectief is geweest bij het presenteren van de resultaten.
Ten tweede is outputkwaliteit slechts één maat voor performance. De tijd en kosten om antwoorden te genereren zijn ook belangrijk en worden niet behandeld in de aankondiging.
Ten derde verschilt performance altijd per usecase, dus je moet het op je eigen problemen en je eigen hardware proberen om nauwkeurige resultaten voor jouw toepassingen te krijgen.
Chatbot Arena-ranglijsten
In de dagen na de aankondiging van Meta is de performance van Llama 3 verschenen op de LMSYS Chatbot Arena Leaderboard, een publieke ranglijst van LLM’s. Llama 3 70B staat momenteel op de 6e plaats, de hoogste notering van alle LLM’s met open weights. (Het staat achter diverse versies van OpenAI GPT-4, Anthropic Claude 3 Opus en Google Gemini Pro.) Ondertussen staat Llama 3 8B op plek 14.
Dit zijn opmerkelijke sprongen in de ranglijst, en het is de moeite waard om te kijken wat er sinds Llama 2 is veranderd.
Hoe werkt Llama 3?
Llama 3 gebruikt, net als zijn voorgangers en de GPT-serie, een decoder-only transformer-architectuur. Dit is de meest gebruikelijke architectuur voor modellen die tekst genereren. (Het tegenovergestelde type, encoder-only-architecturen, wordt gebruikt voor het begrijpen of classificeren van door de gebruiker aangeleverde tekst.)
In de aankondiging van Llama 3 worden geen radicale wijzigingen aan de modelstructuur of het trainingsproces beschreven. In plaats daarvan zijn er veel optimalisaties rond de trade-offs tussen outputkwaliteit, responssnelheid en ontwikkelinspanning.
Een nieuwe tokenizer, die tekst omzet in tokens, is efficiënter, waardoor prompts en antwoorden 15% minder tokens innemen. Er past dus meer tekst in het contextvenster.
Een nieuw attention-mechanisme—de techniek waarmee LLM’s bepalen welke woorden of zinsdelen essentieel zijn voor het genereren van de output—genaamd grouped query attention, biedt een betere balans tussen outputkwaliteit en generatiesnelheid dan eerdere mechanismen.
De trainingsdataset is zeven keer zo groot als die van Llama 2 en bevat vier keer zoveel code. In het algemeen geldt: meer code in de trainingsdata betekent dat LLM’s beter worden in het genereren van code.
Interessant is dat het Llama 2-model is gebruikt om data te evalueren en te classificeren voor opname in de trainingsset van Llama 3. Het gebruik van AI om een nóg betere AI te maken is al lang een sciencefictionklassieker (het is een plotpunt in The Hitchhiker’s Guide to the Galaxy) en wordt nu in de praktijk gebracht.
Ook het post-trainingsproces is geoptimaliseerd. Nadat een LLM is gemaakt, kan dat "ruwe" LLM worden bijgesteld om de prestaties te verbeteren. Meta merkt op dat het Llama 3-proces de volgende technieken omvat.
- Supervised fine-tuning, een supervised machine learning-techniek waarbij paren van prompts en een hoogwaardig antwoord worden gebruikt als voorbeelden van goede output.
- Rejection sampling, waarbij meerdere outputs worden gegenereerd en gerangschikt, en de slechtste worden verworpen.
- Direct Policy Optimization en Proximal Policy Optimization, reinforcement learning-technieken waarbij het model een beloning krijgt voor goede antwoorden.
Wat ontbrak er?
Er waren enkele opvallende omissies in deze release.
Geen multimodale AI
OpenAI’s ChatGPT combineert de GPT-4-tekst-AI met de DALL∙E 3-beeld-AI. Het is dus "multimodaal". De aankondiging van Meta suggereert dat het multimodaal maken van Llama 3 een doel is voor de nabije toekomst.
Geen meertalige AI
De Llama 3-dataset wordt beschreven als 95% Engelstalige tekst. Dat betekent dat de prestaties voor andere talen naar verwachting veel zwakker zijn. Net als bij multimodale AI staat een meertalige versie van Llama 3 op de roadmap.
Geen Mixture of Experts
Een techniek die niet werd genoemd in de aankondiging is het gebruik van een mixture-of-experts-architectuur. Hierbij bestaat een LLM uit meerdere kleinere LLM’s die zich specialiseren in beperktere taken (bijvoorbeeld een LLM voor codegeneratie, één voor documentsamenvatting en één voor dialoog). Deze aanpak werd gepopulariseerd door de Mixtral-modellen van Mistral AI en zou de basis zijn van OpenAI’s GPT-4, wat betere prestaties per parameter oplevert. Met andere woorden: met deze techniek kun je dezelfde prestaties behalen met een kleiner (en dus goedkoper en sneller) model. Aangezien Meta deze techniek niet noemt (en er geen vermelding van is in de Llama 3 GitHub-repository), mogen we aannemen dat de methode niet is gebruikt.
Geen World Model
Meta’s Chief AI Scientist, Yann LeCun, is een groot voorstander van world models, waarbij de AI een intern model ontwikkelt van hoe de wereld werkt om sneller te leren, complexe taken uit te voeren en zich aan te passen aan onbekende situaties. Deze radicale architectuur werd niet genoemd in de aankondiging en lijkt dus niet aanwezig in Llama 3.
Waar kan ik Llama 3 gebruiken?
Llama 3 is te downloaden via de website en de GitHub-repository. Het drijft al de Meta AI-assistent in Facebook, Instagram, WhatsApp en Messenger aan, dus je kunt Llama 3 impliciet uitproberen door Meta AI op die platforms te gebruiken.
Integraties met AWS, Databricks, Google Cloud, Hugging Face, Kaggle, IBM WatsonX, Microsoft Azure, NVIDIA NIM en Snowflake zijn aangekondigd als "binnenkort beschikbaar", zodat je Llama 3 via die platforms kunt benaderen.
Is Llama 3 belangrijk?
Aan de top van het prestatiespectrum draait het recente verhaal in het landschap van large language models om de strijd tussen OpenAI’s GPT-4 en Anthropic’s Claude 3 Opus, met Google Gemini Pro en Cohere’s Command R+ op de hielen. Of de grotere Llama 3-variant die in ontwikkeling is mee kan dingen naar de kroon, moet nog blijken, maar intussen heeft Meta aanzienlijke prestatieverbeteringen in Llama 3 bereikt.
In de afgelopen jaren presteerden gesloten modellen (waarbij details van het model niet openbaar zijn) beter dan meer open modellen. Dat Llama 3 op de 6e plaats staat, is daarom veelzeggend.
Meta’s belangrijkste kortetermijndoel voor Llama is eenvoudigweg het aandrijven van de slimme Meta AI-assistent voor zijn socialmediaplatforms. Dat is een heel ander bedrijfsmodel dan dat van OpenAI, Anthropic of Cohere, die hun LLM willen verkopen voor gebruik in AI-producten van andere bedrijven. In dat opzicht zijn prestatiebenchmarks voor het genereren van code of het oplossen van wiskunde misschien minder relevant voor het bedrijf.
Meta beschikt over een unieke trainingsdataset van social posts die door miljarden gebruikers zijn gemaakt en—los van de eer—de enige prestatiemaatstaf die telt is: "Voorziet Llama 3 voldoende in de behoeften van socialmediagebruikers?"
Daarnaast betekent de open-weights-aanpak dat Llama 3 mogelijk goedkoper is om te draaien dan de concurrentie. Door de AI in wezen weg te geven, zet Meta de prijzen onder druk die concurrenten voor hun API’s kunnen vragen. Dat is belangrijk, want de uitbundige optimisme van 2023 en dromen van almaar toenemende prestaties van generatieve AI hebben plaatsgemaakt voor een nuchterder 2024, waarin executives merken hoe duur LLM-functies zijn en performance per dollar hoog op de prioriteitenlijst is komen te staan.
Modellen met open weights zijn ook belangrijk in situaties waarin dataprivacy cruciaal is, bijvoorbeeld bij het gebruik van financiële data, zorgdata of persoonsgegevens. Het doorgeven van zulke gevoelige data aan een LLM die door een ander bedrijf wordt gehost (zoals bij GPT en andere gesloten modellen) brengt een bedrijfsrisico met zich mee dat de meeste organisaties niet willen nemen. Dit betekent vaak een complexere architectuur voor een chatbot of andere AI-functie om de gevoelige data van de LLM te scheiden. Een open-weights-model zoals Llama 3 kan worden gehost waar de organisatie maar wil, waardoor het eenvoudiger wordt om AI-producten en -functies te bouwen met behoud van dataprivacy.
Slotopmerkingen
Llama 3 lijkt een iteratieve verbetering ten opzichte van Llama 2. Er zijn geen grote wijzigingen aan de architectuur aangekondigd en geen grote nieuwe features.
De focus op trade-offs tussen kosten en performance suggereert dat Meta mikt op een AI die goedkoop op schaal kan draaien. Het meest interessante nieuws betreft het ecosysteem: andere ontwikkelaars helpen om efficiënter LLM’s van hoge kwaliteit te bouwen is een van de belangrijkste voordelen van Meta’s open aanpak.
Als je graag wilt beginnen met generatieve AI, helpt onze AI Fundamentals skill track je op weg met machine learning, deep learning, NLP, generatieve modellen en meer. Je kunt ook onze gidsen lezen over het fine-tunen van Llama 3, Llama 3.1 en Llama 3.2.

