Lernpfad
Entwicklung von KI-Anwendungen
21 Std.
DeepSeek-Coder-V2 ist ein Open-Source-Mixture-of-Experts (MoE)-Codemodell, das bei code-spezifischen Aufgaben mit der Leistung von GPT-4 konkurriert. Für Entwicklerinnen und Entwickler entwickelt, bringt das Modell mehrere zentrale Stärken mit:
Du kannst über DeepSeek’s Website darauf zugreifen, dort gibt es eine kostenpflichtige API und einen Chat. Der Quellcode ist auf GitHub verfügbar und das Forschungspaper liegt auf arXiv.
Die Modelle liegen auf Hugging Face – aufgrund der Größe brauchst du für den lokalen Betrieb allerdings Hardware auf Forschungsniveau.
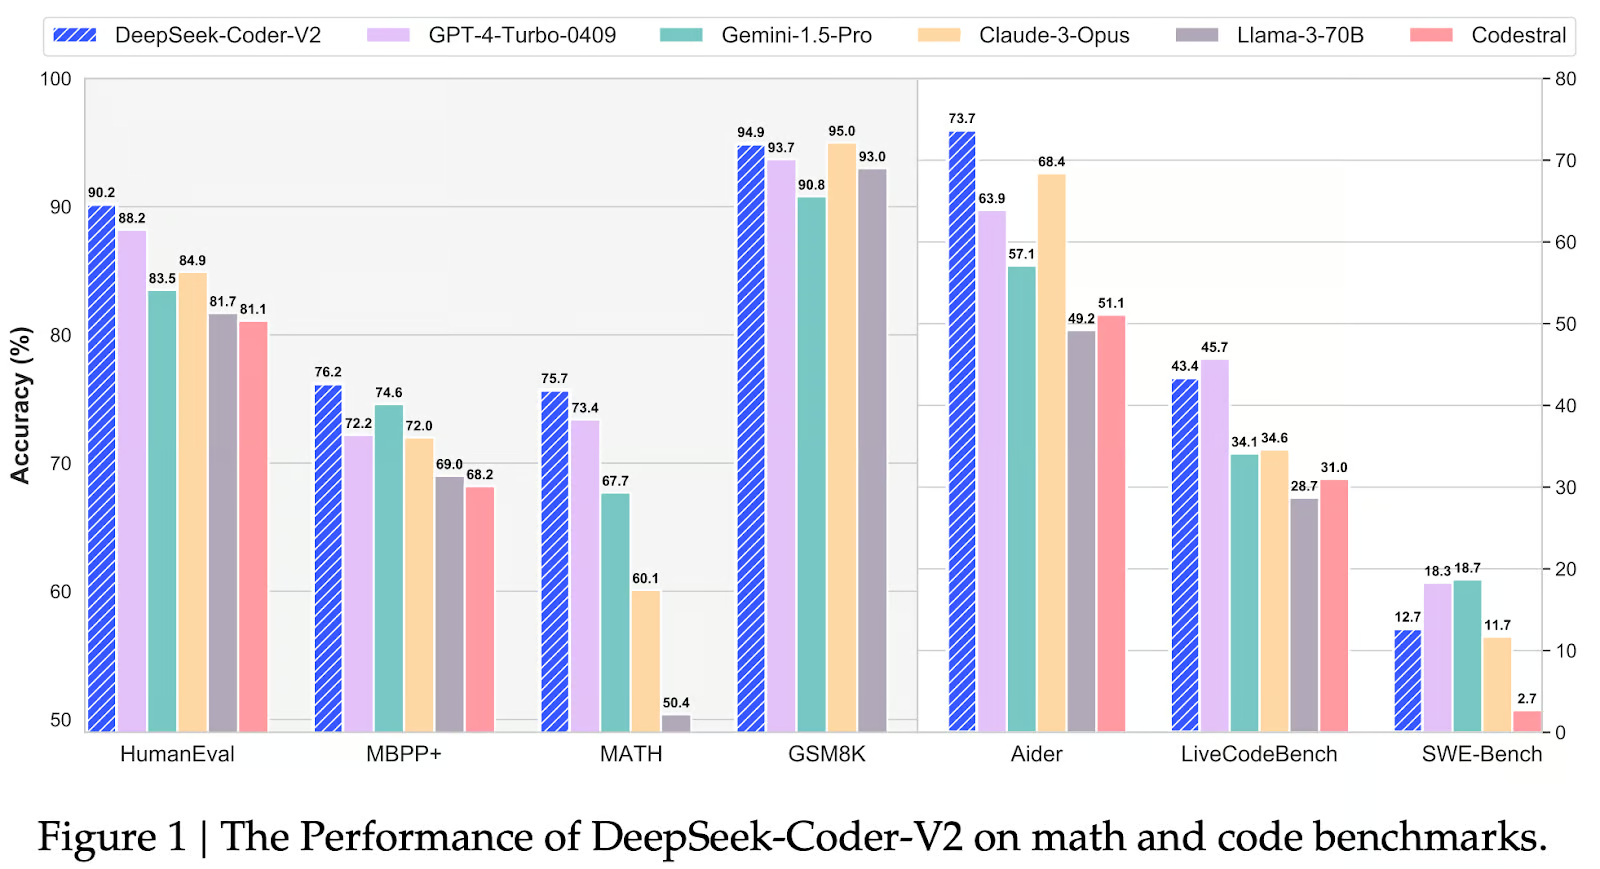
Schauen wir uns an, wie DeepSeek-Coder-V2 in Benchmarks abschneidet und wie es im Vergleich zu Modellen wie GPT-4 Turbo, Gemini 1.5 Pro, Claude 3 Opus, LLaMA 3-70B und Codestral abschneidet.
Quelle: Qihao Zhu et. al
Der HumanEval-Benchmark misst die Fähigkeit zur Codegenerierung, indem geprüft wird, ob generierter Code bestimmte Unit-Tests besteht. DeepSeek-Coder-V2 liefert hier hervorragende Ergebnisse mit einer Genauigkeit von 90,2 %. Das unterstreicht die Stärke des Modells, auch in komplexeren Szenarien funktionsfähige und korrekte Codeausschnitte zu erzeugen.
Der MBPP+-Benchmark fokussiert Codeverständnis und bewertet die Fähigkeit eines Modells, Codestrukturen und -semantik zu erfassen. DeepSeek-Coder-V2 überzeugt auch hier mit 76,2 % Genauigkeit und zeigt ein ausgeprägtes Verständnis von Bedeutung und Funktionalität von Code.
Der MATH-Benchmark testet mathematisches Schlussfolgern im Kontext von Code. DeepSeek-Coder-V2 liegt mit 75,7 % Genauigkeit vorn und zeigt damit Stärke bei mathemischen Operationen und Logik im Code – ein Kernaspekt vieler Programmieraufgaben.
GSM8K prüft das Lösen von Textaufgaben auf Grundschulniveau und bewertet damit Problemlösekompetenzen jenseits reiner Codegenerierung. DeepSeek-Coder-V2 liegt knapp hinter Claude 3 Opus mit 94,9 % Genauigkeit und zeigt, dass es mathematische Fragestellungen in natürlicher Sprache gut erfassen und lösen kann.
Der Aider-Benchmark bewertet die Fähigkeit eines Modells, Codehilfe und Vorschläge zu geben. DeepSeek-Coder-V2 führt hier mit 73,7 % Genauigkeit und eignet sich damit als wertvolles Werkzeug für Entwicklerinnen und Entwickler, die Echtzeitunterstützung suchen.
LiveCodeBench misst die Codegenerierung in realen Anwendungsszenarien. DeepSeek-Coder-V2 erreicht 43,4 % Genauigkeit (zweiter Platz nach GPT-4-Turbo-0409) und zeigt damit, dass es in der Praxis funktionsfähigen, nutzbaren Code erzeugen kann.
Der SWE-Bench-Benchmark bewertet speziell die Fähigkeit von KI-Modellen, Software-Engineering-Aufgaben wie Codegenerierung, Debugging und das Verständnis komplexer Programmierkonzepte zu bewältigen. DeepSeek-Coder-V2 erzielt hier 12,7 Punkte – solide, aber nicht führend. Es liegt hinter GPT-4-Turbo-0409 (18,7) und Gemini-1.5-Pro (18,3), die in diesen Aufgaben stärker sind. Dennoch übertrifft DeepSeek-Coder-V2 Modelle wie Claude-3-Opus (11,7), Llama-3-70B (2,7) und Codestral und ist damit laut diesem Benchmark eine zuverlässige, wenn auch nicht Spitzen-Option für Software-Engineering-Anwendungen.
DeepSeek-Coder-V2 baut auf DeepSeek-V2 auf und nutzt eine ausgefeilte Mixture-of-Experts-(MoE)-Architektur für starke Leistungen bei Codeaufgaben. Das Modell greift auf mehrere Expertinnen/Experten-Modelle zurück, die auf unterschiedliche Codetätigkeiten spezialisiert sind, und wählt dynamisch die passendsten Experten anhand der Eingabe aus. Das steigert Effizienz und Genauigkeit.
Das Training von DeepSeek-Coder-V2 umfasst mehrere Bausteine. Vortrainiert wurde es auf einem umfangreichen Datensatz aus 60 % Quellcode, 10 % Mathe-Korpus und 30 % natürlicher Sprache – insgesamt 10,2 Billionen Token. Diese Vielfalt ermöglicht es dem Modell, Code effektiv zu verstehen und zu generieren. Der Quellcode-Datensatz umfasst 1.170 Milliarden Token aus GitHub und CommonCrawl und deckt 338 Programmiersprachen ab – eine deutliche Erweiterung gegenüber früheren Modellen.
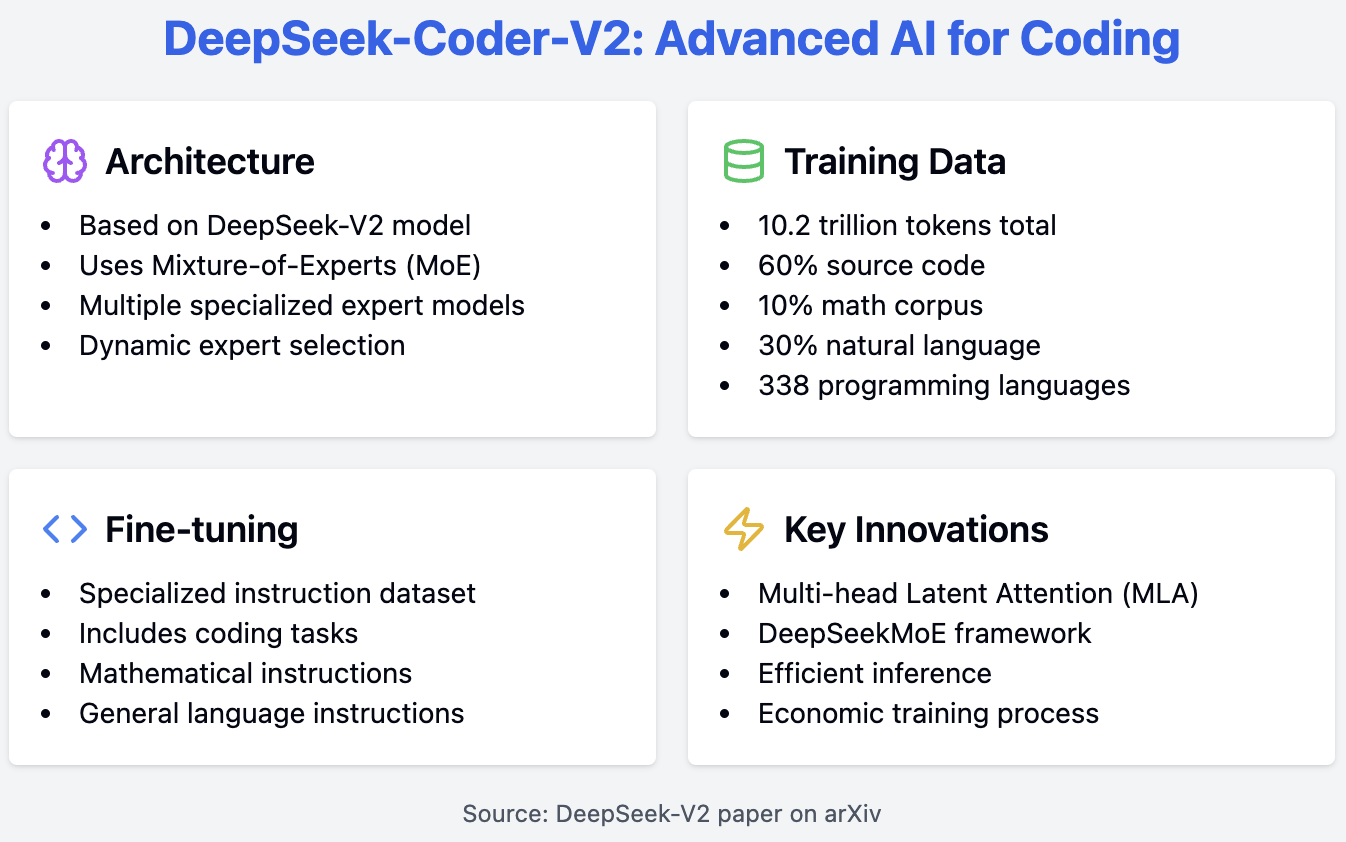
Nach dem Pretraining folgt ein Feintuning mit einem speziellen Instruktionsdatensatz aus Coding-, Mathematik- und allgemeinen Sprachaufgaben. Dadurch reagiert das Modell besser auf natürliche Spracheingaben und wird zu einem hilfreichen Assistenten.
Für alle, die sich für die Architektur interessieren: Das zugrunde liegende DeepSeek-V2 führt Neuerungen wie Multi-head Latent Attention (MLA) und das DeepSeekMoE-Framework ein. Diese Innovationen ermöglichen effiziente Inferenz und kostengünstiges Training – Details findest du im DeepSeek-V2-Paper auf arXiv.
Es gibt mehrere Wege, mit DeepSeek-Coder-V2 zu starten. Du kannst das Modell lokal über die transformers-Bibliothek von Hugging Face ausführen. Beachte aber, dass die Modelle sehr groß sind und erhebliche Rechenressourcen erfordern.
Alternativ bietet DeepSeek eine kostenpflichtige API und eine Online-Chat-Oberfläche ähnlich wie ChatGPT. Der Online-Chat von DeepSeek kann sogar HTML- und JavaScript-Code direkt im Chatfenster ausführen! Diese Funktion ist ziemlich innovativ – etwas Vergleichbares kenne ich bisher nur von den Artifacts des Modells Claude 3.5 Sonnet. Für diesen Artikel nutzen wir den Chat für unsere Beispiele.
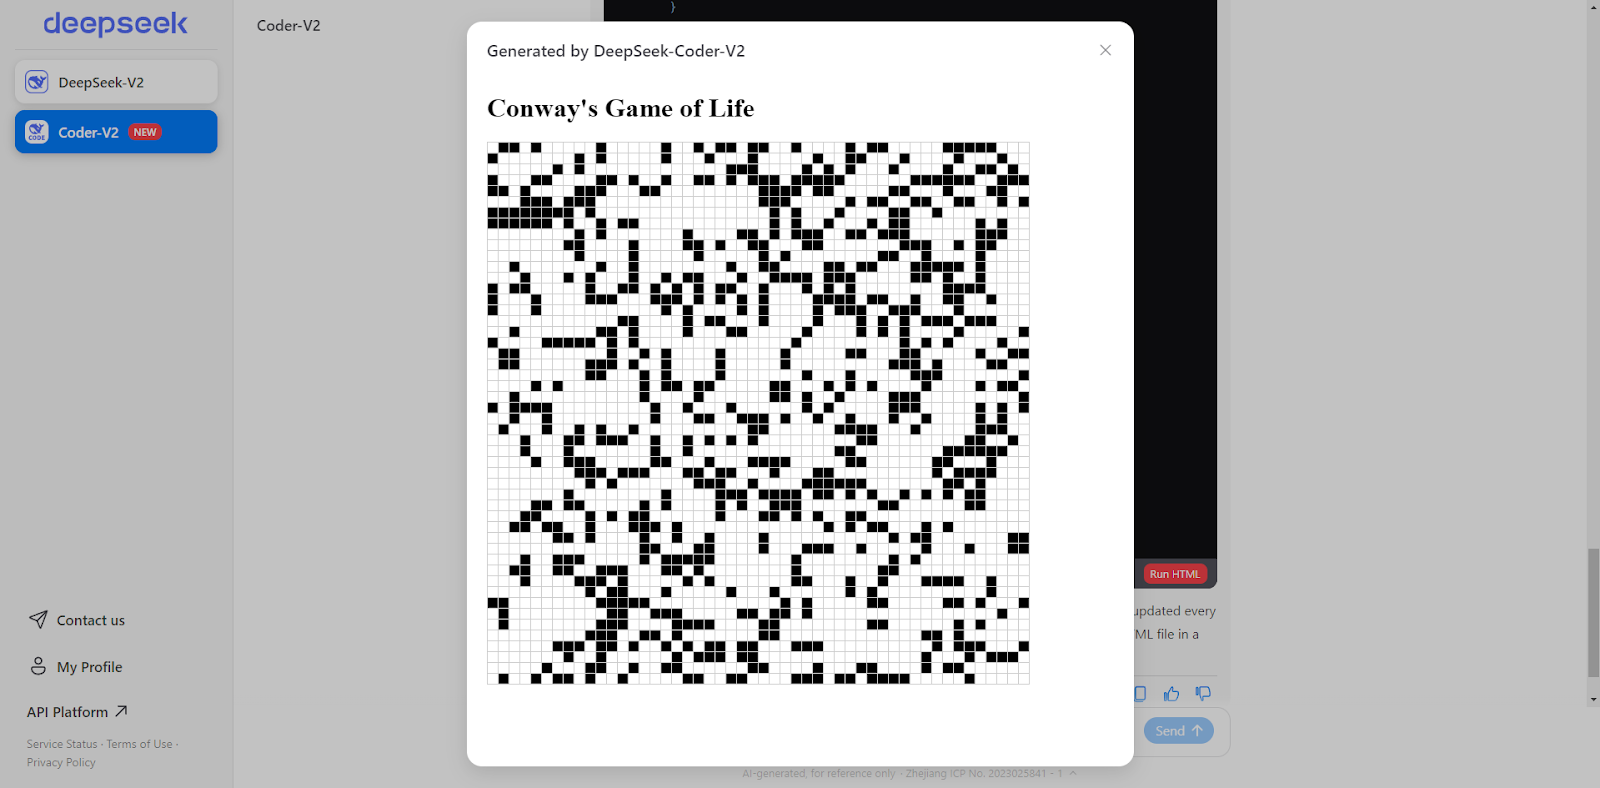
Im ersten Beispiel bitte ich das Modell, Conways Game of Life in HTML und JavaScript zu programmieren. Mein Prompt lautete: „Can you write Conway’s game of life in HTML?“ Hier ist die Antwort:
Certainly! Below is a simple implementation of Conway's Game of Life using HTML, CSS, and JavaScript. This version will display the grid in an HTML table and update it every second.<!DOCTYPE html>
<html lang="en">
<head>
<meta charset="UTF-8">
<meta name="viewport" content="width=device-width, initial-scale=1.0">
<title>Conway's Game of Life</title>
<style>
table {
border-collapse: collapse;
}
td {
width: 10px;
height: 10px;
border: 1px solid #ccc;
}
.alive {
background-color: black;
}
.dead {
background-color: white;
}
</style>
</head>
<body>
<h1>Conway's Game of Life</h1>
<table id="grid"></table>
<script>
const N = 50; // Grid size
let grid = createGrid(N);
let intervalId;
function createGrid(N) {
let grid = new Array(N);
for (let i = 0; i < N; i++) {
grid[i] = new Array(N);
for (let j = 0; j < N; j++) {
grid[i][j] = Math.random() > 0.7 ? 1 : 0;
}
}
return grid;
}
function renderGrid(grid) {
const table = document.getElementById('grid');
table.innerHTML = '';
for (let i = 0; i < N; i++) {
const row = table.insertRow();
for (let j = 0; j < N; j++) {
const cell = row.insertCell();
cell.classList.add(grid[i][j] ? 'alive' : 'dead');
}
}
}
function updateGrid(grid) {
const newGrid = grid.map(row => row.slice());
for (let i = 0; i < N; i++) {
for (let j = 0; j < N; j++) {
const aliveNeighbors = countAliveNeighbors(grid, i, j);
if (grid[i][j] === 1) {
newGrid[i][j] = aliveNeighbors === 2 || aliveNeighbors === 3 ? 1 : 0;
} else {
newGrid[i][j] = aliveNeighbors === 3 ? 1 : 0;
}
}
}
return newGrid;
}
function countAliveNeighbors(grid, x, y) {
let count = 0;
for (let i = -1; i <= 1; i++) {
for (let j = -1; j <= 1; j++) {
if (i === 0 && j === 0) continue;
const newX = (x + i + N) % N;
const newY = (y + j + N) % N;
count += grid[newX][newY];
}
}
return count;
}
function startGame() {
intervalId = setInterval(() => {
grid = updateGrid(grid);
renderGrid(grid);
}, 1000);
}
renderGrid(grid);
startGame();
</script>
</body>
</html>Wir können außerdem auf den Button „Run HTML“ am Ende der Antwort klicken und das Game of Life direkt im Chatfenster ausführen.
Screenshot von der Autorin/dem Autor.
Als Nächstes habe ich das Modell gebeten, eine dynamische Website für das Spiel zu erstellen, auf der ich die Startkonfiguration auswählen kann. So sieht das Ergebnis aus – und es funktioniert nahezu reibungslos.
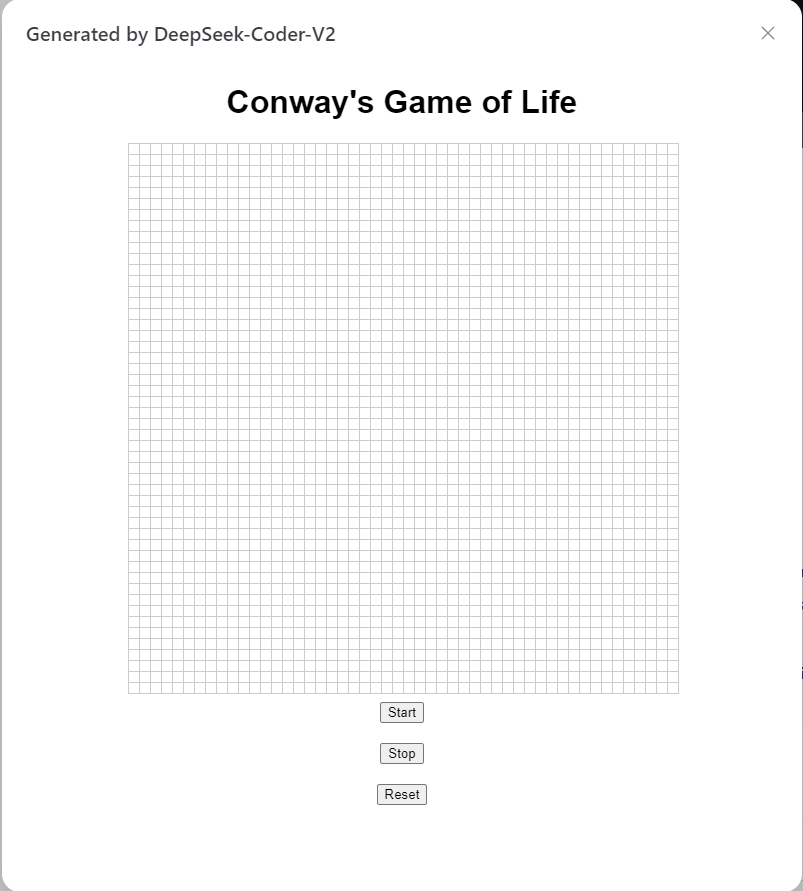
Screenshot von der Autorin/dem Autor.
Im letzten Beispiel habe ich das Modell mit einer schweren Project-Euler-Aufgabe getestet – dem „jumping frog“-Problem. Hier ist der vom Modell generierte Code:
import numpy as np

MOD = 10**9


def matrix_power(matrix, n):
    result = np.identity(len(matrix), dtype=int)

    while n > 0:
        if n % 2 == 1:
            result = np.dot(result, matrix) % MOD

        matrix = np.dot(matrix, matrix) % MOD
        n //= 2

    return result


def fib_matrix(n):
    if n == 0:
        return 0
    elif n == 1:
        return 1

    A = np.array([[1, 1, 1], [1, 0, 0], [0, 1, 0]], dtype=int)
    A_power = matrix_power(A, n - 3)
    initial_vector = np.array([2, 1, 1])

    return np.dot(A_power, initial_vector)[0] % MOD


def S(L):
    result = 0

    for n in range(1, L + 1):
        f_n = fib_matrix(n)
        result = (result + f_n**3) % MOD

    return result


# Compute S(10**14) % 10**9
print(S(10**14))
Dieses Skript würde ewig laufen, also habe ich das Modell um eine Optimierung gebeten und Folgendes erhalten:
import numpy as np

MOD = 10**9


def matrix_power(matrix, n):
    result = np.identity(len(matrix), dtype=int)

    while n > 0:
        if n % 2 == 1:
            result = np.dot(result, matrix) % MOD
        matrix = np.dot(matrix, matrix) % MOD
        n //= 2

    return result


def fib_matrix(n):
    if n == 0:
        return 0
    elif n == 1:
        return 1

    A = np.array([[1, 1, 1], [1, 0, 0], [0, 1, 0]], dtype=int)
    A_power = matrix_power(A, n - 3)
    initial_vector = np.array([2, 1, 1])

    return np.dot(A_power, initial_vector)[0] % MOD


def find_pisano_period(m):
    previous, current = 0, 1
    for i in range(m * m):
        previous, current = current, (previous + current) % m
        if previous == 0 and current == 1:
            return i + 1


def S(L):
    pisano_period = find_pisano_period(MOD)
    period_sum = 0

    for n in range(1, pisano_period + 1):
        f_n = fib_matrix(n)
        period_sum = (period_sum + f_n**3) % MOD

    full_periods, remainder = divmod(L, pisano_period)
    result = (full_periods * period_sum) % MOD

    for n in range(1, remainder + 1):
        f_n = fib_matrix(n)
        result = (result + f_n**3) % MOD

    return result


# Compute S(10**14) % 10**9
print(S(10**14))
Ich habe die optimierte Version eine halbe Stunde laufen lassen, aber es kam immer noch kein Ergebnis. Auch wenn die Ansätze korrekt erscheinen, liegt die Herausforderung in der Optimierung. Angesichts der Tatsache, dass nur 328 Personen dieses Problem gelöst haben, überrascht es nicht, dass das Modell daran scheitert.
DeepSeek-Coder-V2 ist eine bemerkenswerte Ergänzung im wachsenden Feld der Open-Source-Coding-Assistenten und liefert eine konkurrenzfähige Performance gegenüber etablierten proprietären Modellen.
Um das Maximum aus DeepSeek-Coder-V2 herauszuholen, arbeite mit klaren, präzisen Prompts. Gib den Entwicklerinnen und Entwicklern außerdem Feedback, falls dir Bugs auffallen.
Wenn du mehr über KI-Coding-Assistenten erfahren willst, empfehle ich diese DataFramed-Podcastfolge: The Future of Programming with Kyle Daigle, COO at GitHub.
Lerne KI mit diesen Kursen!
Lernpfad
Kurs
Kurs