

Che cos'è DeepSeek-Coder-V2?
DeepSeek-Coder-V2 è un modello open-source Mixture-of-Experts (MoE) per il linguaggio di programmazione che rivaleggia con le prestazioni di GPT-4 nei task specifici sul codice. Progettato per aiutare gli sviluppatori, questo modello porta in dote diverse caratteristiche chiave:
- Multilingue: addestrato sia su codice sia su linguaggio naturale in più lingue, tra cui inglese e cinese, risultando versatile per team di sviluppo globali.
- Versatile: supporta un'ampia gamma di oltre 338 linguaggi di programmazione, adattandosi a contesti e necessità di coding eterogenei.
- Ampia scala: pre-addestrato su trilioni di token di codice e testi, il che ne potenzia la comprensione e la generazione in vari scenari di programmazione.
- Diverse dimensioni: i modelli sono disponibili in più dimensioni, permettendo agli sviluppatori di scegliere quella più adatta alle proprie risorse computazionali e ai requisiti del progetto.
Puoi accedere al modello dal sito di DeepSeek: offrono accesso API a pagamento e una chat. Il codice sorgente è disponibile su GitHub e l'articolo di ricerca è ospitato su arXiv.
I modelli sono ospitati su Huggingface—tuttavia, per eseguirli in locale serve hardware di livello research a causa delle dimensioni.
Benchmark di DeepSeek-Coder-V2
Vediamo come si comporta DeepSeek-Coder-V2 sui benchmark e come si confronta con modelli come GPT-4 Turbo, Gemini 1.5 Pro, Claude 3 Opus, LLaMA 3-70B e Codestral.
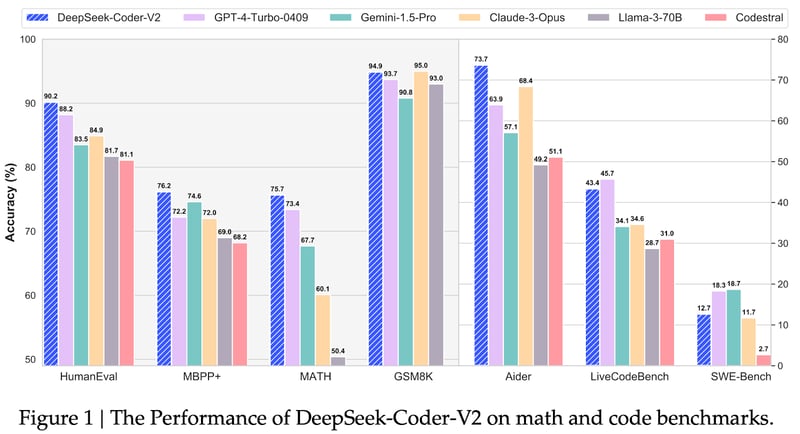
Fonte: Qihao Zhu et. al
HumanEval
Il benchmark HumanEval misura la competenza nella generazione di codice valutando se il codice generato supera specifici unit test. DeepSeek-Coder-V2 mostra prestazioni eccezionali in questo benchmark, raggiungendo un'accuratezza del 90,2%. Questo risultato evidenzia la capacità del modello di generare snippet di codice funzionali e accurati, anche in scenari complessi.
MBPP+
Il benchmark MBPP+ si concentra sulla comprensione del codice, valutando la capacità di un modello di capire e interpretare strutture e semantica del codice. Anche qui DeepSeek-Coder-V2 eccelle, raggiungendo un'accuratezza del 76,2%, a riprova della sua solida comprensione del significato e della funzionalità del codice.
MATH
Il benchmark MATH testa le capacità di ragionamento matematico del modello all'interno del codice. DeepSeek-Coder-V2 mantiene il vantaggio con un'accuratezza del 75,7%, indicando la sua abilità nel gestire operazioni matematiche e logica incorporata nel codice, un aspetto cruciale di molte attività di programmazione.
GSM8K
Il benchmark GSM8K si concentra sulla risoluzione di problemi di matematica a livello scolastico, valutando capacità di problem solving più ampie oltre la pura generazione di codice. DeepSeek-Coder-V2 si piazza appena dietro Claude 3 Opus con un'accuratezza del 94,9%, dimostrando la capacità di comprendere e risolvere problemi matematici presentati in linguaggio naturale.
Aider
Il benchmark Aider valuta la capacità di un modello di fornire assistenza e suggerimenti sul codice. DeepSeek-Coder-V2 è in testa con un'accuratezza del 73,7%, suggerendo il suo potenziale come strumento prezioso per gli sviluppatori in cerca di guida e supporto in tempo reale durante le attività di coding.
LiveCodeBench
Il benchmark LiveCodeBench misura le prestazioni di generazione del codice in scenari reali. DeepSeek-Coder-V2 raggiunge un'accuratezza del 43,4% (secondo dopo GPT-4-Turbo-0409), mostrando la capacità di generare codice funzionale e utilizzabile in contesti pratici.
SWE Bench Benchmark
Il benchmark SWE-Bench valuta specificamente i modelli di AI nella loro capacità di svolgere compiti di ingegneria del software, come generazione di codice, debugging e comprensione di concetti di programmazione complessi. In questo contesto, DeepSeek-Coder-V2 ha ottenuto un punteggio di 12,7, indicando una buona performance ma non leader. È dietro a GPT-4-Turbo-0409 (18,7) e Gemini-1.5-Pro (18,3), che mostrano capacità superiori in questi compiti. Tuttavia, DeepSeek-Coder-V2 ha comunque superato modelli come Claude-3-Opus (11,7), Llama-3-70B (2,7) e Codestral, suggerendo che sia un'opzione affidabile ma non di fascia altissima per applicazioni di ingegneria del software secondo questo benchmark.
Come funziona DeepSeek-Coder-V2
DeepSeek-Coder-V2 si basa sul modello DeepSeek-V2, utilizzando una sofisticata architettura Mixture-of-Experts (MoE) per ottenere alte prestazioni nei task specifici sul codice. Questo modello sfrutta più modelli esperti, ciascuno specializzato in diversi compiti di programmazione, e seleziona dinamicamente l'esperto più rilevante in base al codice in input. Questo approccio ne aumenta efficienza e accuratezza.
Il processo di training di DeepSeek-Coder-V2 comprende diversi elementi cruciali. È pre-addestrato su un dataset completo composto per il 60% da codice sorgente, 10% da corpus matematico e 30% da corpus di linguaggio naturale, per un totale di 10,2 trilioni di token. Questo dataset eterogeneo consente al modello di comprendere e generare codice in modo efficace. Il dataset di codice sorgente include 1.170 miliardi di token provenienti da GitHub e CommonCrawl, coprendo 338 linguaggi di programmazione, un'espansione significativa rispetto ai modelli precedenti.
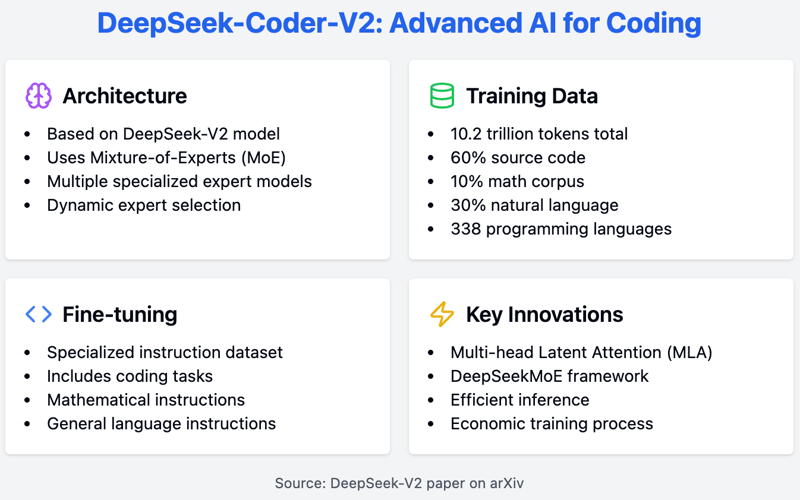
Dopo il pre-addestramento, il modello viene sottoposto a fine-tuning con un dataset di istruzioni specializzato che include istruzioni di coding, matematiche e di linguaggio generale. Questo processo migliora la reattività del modello ai prompt in linguaggio naturale, trasformandolo in un assistente utile.
Per chi è interessato all'architettura sottostante, il modello DeepSeek-V2, su cui si basa DeepSeek-Coder-V2, introduce innovazioni come la Multi-head Latent Attention (MLA) e il framework DeepSeekMoE. Queste innovazioni contribuiscono a un'inferenza efficiente e a un training economico, come dettagliato nel paper su DeepSeek-V2 disponibile su arXiv.
Primi passi con DeepSeek-Coder-V2
Ci sono diversi modi per iniziare a usare il modello DeepSeek-Coder-V2. Puoi eseguirlo in locale accedendovi tramite la transformers library di Hugging Face. Tieni però presente che i modelli sono piuttosto grandi e richiedono risorse computazionali significative.
In alternativa, DeepSeek offre un'API a pagamento e un'interfaccia chat online simile a ChatGPT. La chat online di DeepSeek può anche eseguire codice HTML e JavaScript direttamente nella finestra della chat! Questa funzionalità è piuttosto innovativa—ho visto qualcosa di simile solo negli Artifacts del modello Claude 3.5 Sonnet. Per questo articolo useremo la funzione di chat per i nostri esempi.
DeepSeek-Coder-V2: esempi d'uso
Per il primo esempio, chiederò al modello di programmare il gioco della vita di Conway in HTML e JavaScript. Ho posto al modello il seguente prompt: “Puoi scrivere il gioco della vita di Conway in HTML?” Ecco la risposta:
Certainly! Below is a simple implementation of Conway's Game of Life using HTML, CSS, and JavaScript. This version will display the grid in an HTML table and update it every second.<!DOCTYPE html>
<html lang="en">
<head>
<meta charset="UTF-8">
<meta name="viewport" content="width=device-width, initial-scale=1.0">
<title>Conway's Game of Life</title>
<style>
table {
border-collapse: collapse;
}
td {
width: 10px;
height: 10px;
border: 1px solid #ccc;
}
.alive {
background-color: black;
}
.dead {
background-color: white;
}
</style>
</head>
<body>
<h1>Conway's Game of Life</h1>
<table id="grid"></table>
<script>
const N = 50; // Grid size
let grid = createGrid(N);
let intervalId;
function createGrid(N) {
let grid = new Array(N);
for (let i = 0; i < N; i++) {
grid[i] = new Array(N);
for (let j = 0; j < N; j++) {
grid[i][j] = Math.random() > 0.7 ? 1 : 0;
}
}
return grid;
}
function renderGrid(grid) {
const table = document.getElementById('grid');
table.innerHTML = '';
for (let i = 0; i < N; i++) {
const row = table.insertRow();
for (let j = 0; j < N; j++) {
const cell = row.insertCell();
cell.classList.add(grid[i][j] ? 'alive' : 'dead');
}
}
}
function updateGrid(grid) {
const newGrid = grid.map(row => row.slice());
for (let i = 0; i < N; i++) {
for (let j = 0; j < N; j++) {
const aliveNeighbors = countAliveNeighbors(grid, i, j);
if (grid[i][j] === 1) {
newGrid[i][j] = aliveNeighbors === 2 || aliveNeighbors === 3 ? 1 : 0;
} else {
newGrid[i][j] = aliveNeighbors === 3 ? 1 : 0;
}
}
}
return newGrid;
}
function countAliveNeighbors(grid, x, y) {
let count = 0;
for (let i = -1; i <= 1; i++) {
for (let j = -1; j <= 1; j++) {
if (i === 0 && j === 0) continue;
const newX = (x + i + N) % N;
const newY = (y + j + N) % N;
count += grid[newX][newY];
}
}
return count;
}
function startGame() {
intervalId = setInterval(() => {
grid = updateGrid(grid);
renderGrid(grid);
}, 1000);
}
renderGrid(grid);
startGame();
</script>
</body>
</html>Possiamo anche cliccare il pulsante “Run HTML” alla fine della risposta per ottenere il gioco della vita direttamente nella finestra della chat.
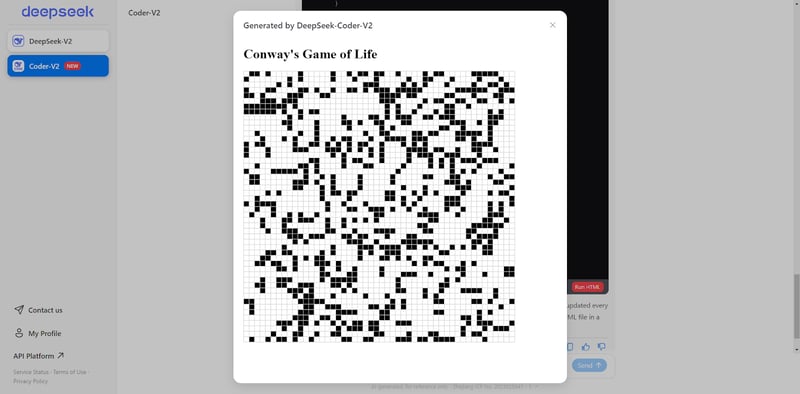
Screenshot dell'autore.
Successivamente, ho chiesto al modello di realizzare un sito dinamico del gioco in cui potessi scegliere la configurazione iniziale della griglia. Questo è l'aspetto del risultato, e funziona in modo piuttosto fluido.
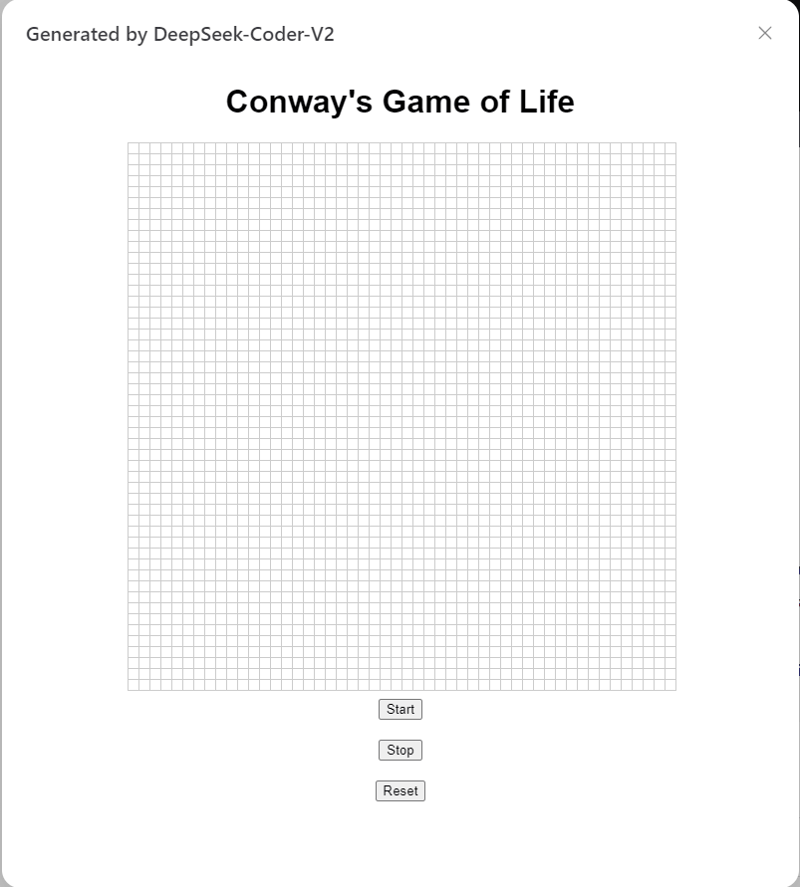
Screenshot dell'autore.
Per il nostro ultimo esempio, ho testato il modello su un difficile problema di Project Euler—il problema “jumping frog”. Ecco il codice generato dal modello:
import numpy as np
MOD = 10**9
def matrix_power(matrix, n):
result = np.identity(len(matrix), dtype=int)
while n > 0:
if n % 2 == 1:
result = np.dot(result, matrix) % MOD
matrix = np.dot(matrix, matrix) % MOD
n //= 2
return result
def fib_matrix(n):
if n == 0:
return 0
elif n == 1:
return 1
A = np.array([[1, 1, 1], [1, 0, 0], [0, 1, 0]], dtype=int)
A_power = matrix_power(A, n - 3)
initial_vector = np.array([2, 1, 1])
return np.dot(A_power, initial_vector)[0] % MOD
def S(L):
result = 0
for n in range(1, L + 1):
f_n = fib_matrix(n)
result = (result + f_n**3) % MOD
return result
# Compute S(10**14) % 10**9
print(S(10**14))Questo script impiegherebbe un'eternità a girare, quindi ho chiesto al modello di ottimizzarlo e ho ottenuto il seguente output:
import numpy as np
MOD = 10**9
def matrix_power(matrix, n):
result = np.identity(len(matrix), dtype=int)
while n > 0:
if n % 2 == 1:
result = np.dot(result, matrix) % MOD
matrix = np.dot(matrix, matrix) % MOD
n //= 2
return result
def fib_matrix(n):
if n == 0:
return 0
elif n == 1:
return 1
A = np.array([[1, 1, 1], [1, 0, 0], [0, 1, 0]], dtype=int)
A_power = matrix_power(A, n - 3)
initial_vector = np.array([2, 1, 1])
return np.dot(A_power, initial_vector)[0] % MOD
def find_pisano_period(m):
previous, current = 0, 1
for i in range(m * m):
previous, current = current, (previous + current) % m
if previous == 0 and current == 1:
return i + 1
def S(L):
pisano_period = find_pisano_period(MOD)
period_sum = 0
for n in range(1, pisano_period + 1):
f_n = fib_matrix(n)
period_sum = (period_sum + f_n**3) % MOD
full_periods, remainder = divmod(L, pisano_period)
result = (full_periods * period_sum) % MOD
for n in range(1, remainder + 1):
f_n = fib_matrix(n)
result = (result + f_n**3) % MOD
return result
# Compute S(10**14) % 10**9
print(S(10**14))Ho lasciato girare il codice ottimizzato per mezz'ora, ma non ha ancora prodotto un risultato. Sebbene ritenga che le soluzioni siano corrette, la difficoltà sta nell'ottimizzazione del codice. Dato che solo 328 persone sono riuscite a risolvere questo problema, non sorprende che il modello non ci sia riuscito.
Conclusione
DeepSeek-Coder-V2 è un'aggiunta notevole al crescente panorama degli assistenti di coding open-source, con prestazioni competitive rispetto ai modelli proprietari affermati.
Per ottenere il massimo da DeepSeek-Coder-V2, segui le best practice fornendo prompt chiari e specifici. Ti invito anche a fornire feedback agli sviluppatori se incontri bug.
Se vuoi saperne di più sugli assistenti di coding AI, ti consiglio di ascoltare questo podcast DataFramed: Il futuro della programmazione con Kyle Daigle, COO di GitHub.






Man mano che assistenti di coding AI come GitHub Copilot guadagnano popolarità tra gli sviluppatori, stanno emergendo anche alternative open-source.
Un esempio notevole è DeepSeek-Coder-V2, un solido modello open-source che utilizza tecniche avanzate di machine learning. È progettato specificamente per attività legate al codice, offrendo prestazioni paragonabili a GPT-4 nella generazione, completamento e comprensione del codice.
In questo articolo ti spiegherò le funzionalità e le capacità di DeepSeek-Coder-V2 e ti guiderò su come iniziare a usare questo strumento.