
Cursus
Werken met de OpenAI API
3 uur
179.5K
OpenAI heeft stilletjes GPT-5.1-Codex uitgebracht op het ontwikkelaarsplatform, en ontwikkelaars noemen het nu al het beste codemodel van dit moment. In tegenstelling tot eerdere Codex-versies is GPT-5.1-Codex gebouwd voor echte software-engineering, langdurige redenering en tool-gebruikende agents.
In deze tutorial bouwen we een complete GitHub Issue Analyzer-agent met OpenAI Agents en GPT-5.1 Codex.
Onze agent zal:
Deze agent gedraagt zich als een senior engineer: eerst onderzoeken, lezen, redeneren en plannen voordat er iets wordt geschreven. Bekijk ook onze aparte gids over GPT-5.1 om te zien wat er verder nieuw is.
GPT-5.1 Codex is een gespecialiseerde versie van GPT-5.1, gebouwd voor langdurige, agentische codetaken in plaats van alleen snippet-autocompletion. Het is doelgericht ontworpen voor echte software-engineering en agentische workflows, waardoor het de perfecte motor is achter onze Issue-naar-Plan-automatiseringsworkflow.
In tegenstelling tot algemene modellen begrijpt Codex codebases zoals een senior engineer dat doet; het leest issues, redeneert over de architectuur, identificeert de juiste mappen en bekijkt alleen de bestanden die er echt toe doen. Dit maakt de agent sneller, slimmer en veel kostenefficiënter.
Codex is geoptimaliseerd voor langdurige, agentische codetaken. Het integreert naadloos met ontwikkelaarstools zoals de GitHub CLI en Firecrawl API, waardoor onze agent issues kan ophalen, projectstructuren online kan verkennen, specifieke bestanden kan lezen en documentatie kan verzamelen indien nodig. Het volgt instructies nauwgezet, levert schone en betrouwbare analyses, en past zijn redeneerinspanning aan zodat het snel kan handelen bij eenvoudige taken en dieper gaat bij complexere.
Door sterke codebegrip te combineren met tool-bewuste redenering, geeft GPT-5.1 Codex onze agent het vermogen om een GitHub-issue te veranderen in een nauwkeurig, uitvoerbaar engineeringplan, zonder de hele repo te scannen of code te hallucineren. Het is de ruggengraat van de workflow omdat het de technische intuïtie, structuur en precisie brengt waar het project op steunt.
Voordat we in het project duiken, zorgen we dat je omgeving klaar is. Je hebt Git op je machine nodig. Als je het niet zeker weet, voer dan git --version uit om te controleren. Je hebt ook een OpenAI Developer Platform-account nodig met minstens $6 tegoed zodat de API-calls ononderbroken kunnen draaien.
Maak vervolgens een gratis Firecrawl-account aan en stel je API-sleutels in als omgevingsvariabelen. Hiermee kan je analyzer met OpenAI en Firecrawl communiceren:
export OPENAI_API_KEY=sk-...
export FIRECRAWL_API_KEY="fc-..."
Installeer daarna de Python-packages die de workflow aandrijven. De eerste, openai-agents, is een lichtgewicht framework dat het bouwen van multi-agent-pijplijnen verrassend eenvoudig maakt. De tweede, firecrawl-py, handelt het crawlen en extraheren van nuttige informatie uit je repositories of documentatie af.
pip install openai-agents
pip install firecrawl-py
Controleer tot slot of je GitHub CLI is geïnstalleerd en ingesteld. Met de volgende opdracht kun je inloggen op je GitHub-account.
gh auth login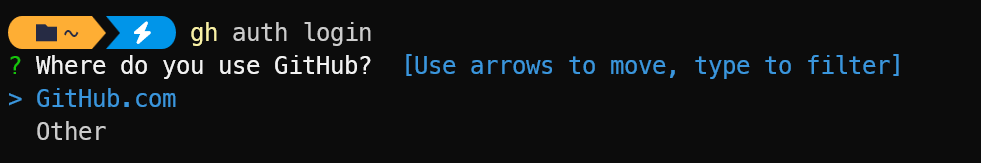
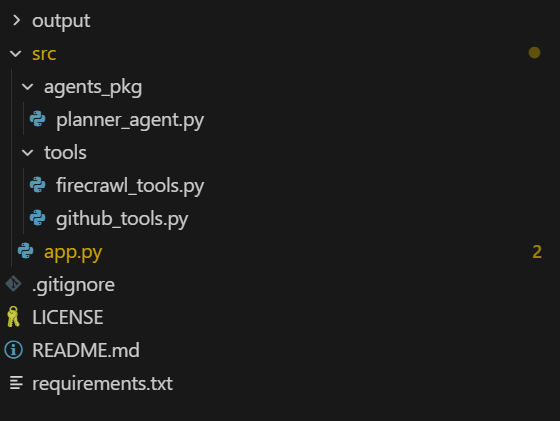
We maken een map met de naam "src" die alle codebestanden bevat. De map "agents_pkg" bevat alle agentbestanden, terwijl de map "tools" alle toolbestanden bevat.
De hoofdapplicatie, "app.py", biedt een command-line interface (CLI) die de planningsagents gebruikt om op basis van gebruikersinvoer een GitHub-issuerapport te genereren.
Zo zou je projectmap eruit moeten zien:
Eerst maken we een agentische tools-file die de agent helpt toegang te krijgen tot de GitHub- en Firecrawl API met eenvoudige Python-functies.
We beginnen met de tools. Maak een bestand met de naam firecrawl_tools.py in de map src/tools en voeg de volgende code toe.
1. Maak en retourneer een Firecrawl-client met de FIRECRAWL_API_KEY uit je omgeving; er wordt een fout gegenereerd als de sleutel ontbreekt.
import json
import os

from agents import function_tool
from firecrawl import firecrawl


def _get_firecrawl_client():
    api_key = os.getenv("FIRECRAWL_API_KEY")
    if not api_key:
        raise RuntimeError("FIRECRAWL_API_KEY is not set")
    return firecrawl(api_key=api_key)
2. Gebruikt Firecrawl om een gerichte webzoekopdracht uit te voeren (bijv. docs, blogposts, errors) en retourneert de resultaten als JSON zodat de agent ze kan gebruiken als externe context.
@function_tool
def firecrawl_search(query: str, limit: int = 3) -> str:
    """
    Run a Firecrawl search for docs related to the issue or tech stack.

    Args:
        query: Search query (usually based on issue title / framework / error message).
        limit: Max number of results to return.

    Returns:
        JSON string of Firecrawl search results.
    """
    client = _get_firecrawl_client()
    results = client.search(query=query, limit=limit)
    return json.dumps(results)
3. Scrapet één URL met Firecrawl (in markdown-formaat) en retourneert de gestructureerde paginacontent als JSON voor diepgaander technisch onderzoek.
@function_tool
def firecrawl_scrape(url: str) -> str:
    """
    Scrape a single URL using Firecrawl for deeper research.

    Args:
        url: URL to scrape (docs, blog, README in another repo, etc.).

    Returns:
        JSON (markdown/structured) content from Firecrawl scrape.
    """
    client = _get_firecrawl_client()
    result = client.scrape(url=url, params={"formats": ["markdown"]})
return json.dumps(result)Daarna maken we een bestand met de naam github_tools.py in de map src/tools en voegen we de volgende code toe.
1. Haalt een specifiek GitHub-issue op via de GitHub CLI en retourneert de details als JSON voor de agent om te lezen.
import base64
import json
import subprocess
from typing import List, Optional

from agents import function_tool


@function_tool
def get_github_issue(repo: str, issue_number: int) -> str:
    """
    Fetch a GitHub issue using the GitHub CLI.

    Args:
        repo: Repository in 'owner/name' format.
        issue_number: The issue number to fetch.

    Returns:
        A JSON string containing the issue fields (title, body, labels, URL, etc.),
        or an error payload if the command fails.
    """
    try:
        result = subprocess.run(
            [
                "gh",
                "issue",
                "view",
                str(issue_number),
                "--repo",
                repo,
                "--json",
                "number,title,body,labels,url,author,createdAt,state,assignees",
            ],
            capture_output=True,
            text=True,
            check=True,
        )
        return result.stdout
    except subprocess.CalledProcessError as e:
        return json.dumps(
            {
                "error": "Failed to fetch issue via GitHub CLI",
                "stderr": e.stderr,
                "repo": repo,
                "issue_number": issue_number,
            }
        )
2. Somt alleen de relevante bestanden op in een externe GitHub-repo (optioneel gefilterd op pad en extensie) zodat de agent niet het hele project hoeft te scannen.
@function_tool
def list_repo_files_gh(
    repo: str,
    max_files: int = 80,
    extensions: Optional[List[str]] = None,
    path_prefixes: Optional[List[str]] = None,
) -> str:
    """
    List *relevant* files in the remote repo using GitHub CLI.

    Uses:
        gh api repos/{repo}/git/trees/HEAD?recursive=1

    The agent is expected to reason first which areas of the codebase are likely relevant
    (e.g. 'src/', 'app/', 'backend/api/', 'cli/'), and then call this tool with a small
    set of path_prefixes instead of scanning the entire project.

    Args:
        repo: Repository in 'owner/name' format (e.g. openai/openai-agents-python).
        max_files: Max number of files to return.
        extensions: Optional list of file extensions to keep (e.g. [".py", ".ts"]).
        path_prefixes: Optional list of path prefixes to include (e.g. ["src/", "app/api/"]).

    Returns:
        JSON string with file paths and filters applied.
    """
    try:
        result = subprocess.run(
            [
                "gh",
                "api",
                f"repos/{repo}/git/trees/HEAD?recursive=1",
            ],
            capture_output=True,
            text=True,
            check=True,
        )
    except subprocess.CalledProcessError as e:
        return json.dumps(
            {
                "error": "Failed to list repo files via GitHub CLI",
                "stderr": e.stderr,
                "repo": repo,
            }
        )

    try:
        data = json.loads(result.stdout)
    except json.JSONDecodeError:
        return json.dumps(
            {
                "error": "Failed to parse JSON from gh api",
                "raw": result.stdout[:2000],
                "repo": repo,
            }
        )

    tree = data.get("tree", [])

    if extensions is not None and not isinstance(extensions, list):
        extensions = [str(extensions)]
    exts = [e.lower() for e in (extensions or [])]

    if path_prefixes is not None and not isinstance(path_prefixes, list):
        path_prefixes = [str(path_prefixes)]
    prefixes = [p.strip() for p in (path_prefixes or []) if p.strip()]

    paths: List[str] = []
    for entry in tree:
        if entry.get("type") != "blob":
            continue  # only files
        path = entry.get("path", "")
        if not path:
            continue

        # If prefixes are provided, only keep files under those subtrees
        if prefixes and not any(path.startswith(pref) for pref in prefixes):
            continue

        if exts:
            suffix = "." + path.split(".")[-1].lower() if "." in path else ""
            if suffix not in exts:
                continue

        paths.append(path)
        if len(paths) >= max_files:
            break

    return json.dumps(
        {
            "repo": repo,
            "count": len(paths),
            "files": paths,
            "filtered_by_extensions": bool(exts),
            "filtered_by_prefixes": bool(prefixes),
        }
    )
3. Downloadt en decodeert de inhoud van één bestand uit de repo met de GitHub CLI, en retourneert de tekst (indien nodig ingekort) als JSON.
@function_tool
def get_repo_file_gh(
    repo: str,
    path: str,
    ref: str = "",
    max_chars: int = 8000,
) -> str:
    """
    Read a file's contents from the remote repo using GitHub CLI.

    Uses:
        gh api repos/{repo}/contents/{path} [ -F ref=<branch> ]

    Args:
        repo: Repository in 'owner/name' format.
        path: File path in the repo (e.g. 'src/main.py').
        ref: Optional branch / commit / tag ref (default: repo's default branch).
        max_chars: Max characters of decoded content to return.

    Returns:
        JSON with file metadata and decoded content (truncated if needed),
        or an error payload if anything fails.
    """
    cmd = ["gh", "api", f"repos/{repo}/contents/{path}"]
    # Only add ref when explicitly set (GitHub default branch otherwise)
    if ref:
        cmd += ["-F", f"ref={ref}"]

    try:
        result = subprocess.run(
            cmd,
            capture_output=True,
            text=True,
            check=True,
        )
    except subprocess.CalledProcessError as e:
        return json.dumps(
            {
                "error": "Failed to fetch file via GitHub CLI",
                "stderr": e.stderr,
                "repo": repo,
                "path": path,
                "ref": ref or "DEFAULT_BRANCH",
            }
        )

    try:
        data = json.loads(result.stdout)
    except json.JSONDecodeError:
        return json.dumps(
            {
                "error": "Failed to parse JSON from gh api (contents)",
                "raw": result.stdout[:2000],
                "repo": repo,
                "path": path,
            }
        )

    if data.get("type") != "file":
        return json.dumps(
            {
                "error": "Path is not a file",
                "repo": repo,
                "path": path,
                "data_type": data.get("type"),
            }
        )

    encoding = data.get("encoding")
    content_b64 = data.get("content", "")

    if encoding != "base64":
        return json.dumps(
            {
                "error": "Unexpected encoding",
                "repo": repo,
                "path": path,
                "encoding": encoding,
            }
        )

    try:
        # GitHub often includes newlines in base64 payload
        raw_bytes = base64.b64decode(content_b64)
        text = raw_bytes.decode("utf-8", errors="replace")
    except Exception as e:  # noqa: BLE001
        return json.dumps(
            {
                "error": f"Failed to decode file content: {e}",
                "repo": repo,
                "path": path,
                "encoding": encoding,
            }
        )

    truncated = text[:max_chars]
    return json.dumps(
        {
            "repo": repo,
            "path": path,
            "ref": ref or "DEFAULT_BRANCH",
            "truncated": len(text) > max_chars,
            "content": truncated,
        }
)Hier definiëren we een Issue Planner-agent die weet hoe je:
We koppelen de GitHub- en Firecrawl-tools, geven de agent gedetailleerde instructies om kostbewust te werken en laten hem draaien op het gpt-5.1-codex-model.
Maak het bestand planner_agent.py in de map src/agents_pkg en voeg de volgende code toe:
from agents import Agent

from tools.github_tools import (
    get_github_issue,
    list_repo_files_gh,
    get_repo_file_gh,
)
from tools.firecrawl_tools import (
    firecrawl_search,
    firecrawl_scrape,
)


def build_planner_agent() -> Agent:
    """
    Issue Planner agent that:
    - Reads the GitHub issue
    - Reasons about which parts of the repo are relevant
    - Uses GitHub CLI to inspect a *small* set of files online
    - Uses Firecrawl for external research
    - Outputs a concrete, step-by-step execution plan
    """
    return Agent(
        name="Issue Planner",
        instructions=(
            "You are a senior software engineer.\n"
            "Goal: Given a GitHub issue and the online repo (structure + files), plus optional "
            "external research, produce a clear, step-by-step execution plan to resolve the issue.\n\n"
            "CONTEXT:\n"
            "- All repository interaction must be done *online* via GitHub CLI tools.\n"
            "- You have tools to: read the issue, list files under certain paths, read specific files, "
            "  and call Firecrawl search/scrape for docs.\n\n"
            "IMPORTANT STRATEGY (BE SMART):\n"
            "- Be selective and cost-aware. Do NOT scan the whole project.\n"
            "- First, deeply read the issue and infer which part of the system it affects:\n"
            "  routing layer, CLI, API handlers, DB layer, tests, etc.\n"
            "- Based on this reasoning, decide a small list of path prefixes and file types.\n\n"
            "RECOMMENDED WORKFLOW:\n"
            "1. Call get_github_issue(repo, issue_number) to fully understand the problem.\n"
            "2. From the issue, infer a small list of path prefixes where relevant code likely lives,\n"
            "   e.g. ['src/', 'app/', 'backend/api/', 'cli/'] depending on the project style.\n"
            "3. Call list_repo_files_gh with:\n"
            "   - extensions like ['.py', '.ts', '.js', '.tsx', '.jsx']\n"
            "   - path_prefixes set to that small, targeted list\n"
            "   This keeps the search focused instead of scanning the entire project.\n"
            "4. From the returned file list, pick at most ~5-15 key files that are most likely related\n"
            "   (entrypoints, routers, handlers, services, tests).\n"
            "5. Call get_repo_file_gh(repo, path=...) only on those selected files to inspect the "
            "   actual implementation.\n"
            "6. If you need framework or library context (FastAPI, Click, React, etc.), use\n"
            "   firecrawl_search and firecrawl_scrape to pull official docs or good examples.\n\n"
            "OUTPUT FORMAT (execution plan):\n"
            "After you have enough context from the issue + targeted code inspection (+ optional research), "
            "output a concise but concrete plan with sections:\n"
            "   - Issue summary\n"
            "   - Project/codebase understanding (where this issue lives in the architecture)\n"
            "   - Key files / components to touch (with file paths)\n"
            "   - Step-by-step implementation plan (Step 1, Step 2, ...)\n"
            "   - Testing strategy (unit / integration / manual)\n"
            "   - Edge cases, risks, and any open questions\n\n"
            "The plan must be actionable for a mid-level developer. Avoid generic advice; tie your steps "
            "to the actual files and modules you inspected.\n"
        ),
        tools=[
            get_github_issue,
            list_repo_files_gh,
            get_repo_file_gh,
            firecrawl_search,
            firecrawl_scrape,
        ],
        model="gpt-5.1-codex",
)Dit is het belangrijkste Python-bestand dat een command-line interface (CLI) biedt en alle logica, callbacks en foutafhandeling samenbrengt in één compleet bestand. Het gebruikt tools en agents uit andere bestanden efficiënt.
1. Eerst richten we alles in en importeren we wat de CLI nodig heeft. We nemen standaardbibliotheken op, zorgen voor correcte Unicode-uitvoer op Windows zodat emoji en symbolen goed worden afgedrukt, en importeren de OpenAI-runner samen met onze planner-agent.
2. Vervolgens definiëren we de command-line-opties, zodat je bij het uitvoeren van de tool een GitHub-repo en issue-nummer kunt meegeven.
src/app.py:
import argparse
import asyncio
import json
import os
import pathlib
import sys
from datetime import datetime

# Set UTF-8 encoding for stdout to handle Unicode characters
if sys.platform == "win32":
    import codecs
    sys.stdout = codecs.getwriter("utf-8")(sys.stdout.detach())
    sys.stderr = codecs.getwriter("utf-8")(sys.stderr.detach())

from agents import Runner, ItemHelpers
from openai.types.responses import ResponseTextDeltaEvent

from agents_pkg.planner_agent import build_planner_agent


def parse_args() -> argparse.Namespace:
    parser = argparse.ArgumentParser(
        description=(
            "Issue Planner: GPT-5.1-Codex + OpenAI Agents + GitHub CLI + Firecrawl\n"        )
    )
    parser.add_argument(
        "--repo",
        help="GitHub repo in 'owner/name' format (e.g. openai/openai-agents-python).",
    )
    parser.add_argument(
        "--issue",
        type=int,
        help="Issue number to plan for.",
    )
    return parser.parse_args()
3. Daarna verzamelen we de invoer en bereiden we de context voor. We lezen de repo en het issue uit de argumenten, zorgen dat de OpenAI API-sleutel is ingesteld, bouwen een duidelijke prompt die de agent vertelt hoe hij het issue stap voor stap moet analyseren, en maken een markdownbestand met een tijdstempel waarin het uiteindelijke plan wordt opgeslagen.
def get_user_input(args: argparse.Namespace) -> tuple[str, int]:
    """Get repository and issue number from arguments or user input."""
    repo = args.repo or input("GitHub repo (owner/name): ").strip()
    issue_number = args.issue or int(input("Issue number: ").strip())
    return repo, issue_number


def validate_environment() -> None:
    """Validate that required environment variables are set."""
    if not os.getenv("OPENAI_API_KEY"):
        raise RuntimeError("OPENAI_API_KEY is not set")


def build_user_prompt(repo: str, issue_number: int) -> str:
    """Build the user prompt for the agent."""
    return (
        f"You are helping me plan how to implement GitHub issue #{issue_number} "
        f"in repo '{repo}'.\n\n"
        "Be selective and cost-aware:\n"
        "1. Use get_github_issue(repo, issue_number) to understand the problem.\n"
        "2. Based on the issue text, first reason about which directories and components "
        "   are likely relevant.\n"
        "3. Call list_repo_files_gh(repo, extensions=['.py', '.ts', '.js', '.tsx', '.jsx'], "
        "   path_prefixes=[<your inferred prefixes>]) to only explore those areas.\n"
        "4. From those results, choose a small set of the most relevant files and call "
        "   get_repo_file_gh(repo, path=...) on them.\n"
        "5. Optionally, use firecrawl_search and firecrawl_scrape if you need external docs.\n"
        "6. Finally, generate the execution plan in the structured format from your instructions."
    )


def setup_output_file(repo: str, issue_number: int) -> pathlib.Path:
    """Create output directory and return the markdown file path."""
    output_dir = pathlib.Path("output")
    output_dir.mkdir(exist_ok=True)
    timestamp = datetime.now().strftime("%Y%m%d_%H%M%S")
    markdown_file = output_dir / f"execution_plan_{repo.replace('/', '_')}_issue_{issue_number}_{timestamp}.md"
    return markdown_file
4. Vervolgens maken we het denken van de agent zichtbaar. We proberen uit elk event een duidelijke redeneersnipper te halen en een korte “💭 Reasoning…”-regel te printen, zodat je in plaats van rauwe internals een leesbare hint ziet van waar het model op de achtergrond mee bezig is.
def extract_reasoning_text(event_item) -> str | None:
    """Extract reasoning text from a reasoning event item."""
    reasoning_text = None

    if hasattr(event_item, 'raw_item'):
        raw = event_item.raw_item
        # Try multiple attribute names
        for attr_name in ['content', 'text', 'reasoning', 'message', 'delta']:
            if hasattr(raw, attr_name):
                val = getattr(raw, attr_name)
                if val and str(val).strip() and str(val) != 'None':
                    reasoning_text = str(val)
                    break

        # If still not found, try to access as dict-like
        if not reasoning_text:
            try:
                if hasattr(raw, '__dict__'):
                    for key, val in raw.__dict__.items():
                        if val and str(val).strip() and str(val) != 'None' and key in ['content', 'text', 'reasoning', 'message', 'delta']:
                            reasoning_text = str(val)
                            break
            except:
                pass

    # Also try direct attributes on event.item
    if not reasoning_text:
        for attr_name in ['content', 'text', 'reasoning', 'message']:
            if hasattr(event_item, attr_name):
                val = getattr(event_item, attr_name)
                if val and str(val).strip() and str(val) != 'None':
                    reasoning_text = str(val)
                    break

    return reasoning_text


def handle_reasoning_event(event_item) -> None:
    """Handle and display reasoning events."""
    reasoning_text = extract_reasoning_text(event_item)

    if reasoning_text and reasoning_text.strip():
        # Show first line or first 100 chars
        first_line = reasoning_text.split('\n')[0].strip()[:100]
        if len(reasoning_text.split('\n')[0].strip()) > 100:
            first_line += "..."
        print(f"\n💭 Reasoning: {first_line}", flush=True)
    else:
        # Don't show "None" - just show that reasoning is happening
        print(f"\n💭 Reasoning...", flush=True)
5. Daarna verwerken we tooraanroepen en tracking. We detecteren welke tool de agent gebruikt, formatteren de argumenten (zoals repo, pad of query) tot een compacte string, printen een “🔧 Calling…”-melding, en houden intern bij welke tools actief zijn zodat we ze kunnen afronden en later alles kunnen samenvatten wat is uitgevoerd.
def extract_tool_info(event_item) -> tuple[str | None, str | None]:
    """Extract tool name and ID from a tool call event item."""
    tool_name = None
    tool_id = None

    # First try raw_item which contains the actual tool call data
    if hasattr(event_item, 'raw_item'):
        raw = event_item.raw_item
        # Try accessing tool_call through various paths
        tool_call = None
        if hasattr(raw, 'tool_call'):
            tool_call = raw.tool_call
        elif hasattr(raw, 'function_call'):
            tool_call = raw.function_call

        if tool_call:
            # Try to get name from tool_call
            if hasattr(tool_call, 'name'):
                tool_name = tool_call.name
            elif hasattr(tool_call, 'function') and hasattr(tool_call.function, 'name'):
                tool_name = tool_call.function.name
            # Try to get ID
            if hasattr(tool_call, 'id'):
                tool_id = tool_call.id
            elif hasattr(tool_call, 'tool_call_id'):
                tool_id = tool_call.tool_call_id

        # Fallback: try direct attributes on raw
        if not tool_name:
            if hasattr(raw, 'name'):
                tool_name = getattr(raw, 'name')
            elif hasattr(raw, 'function') and hasattr(raw.function, 'name'):
                tool_name = raw.function.name
            # Try using getattr with different possible attribute names
            for attr_name in ['tool_name', 'function_name', 'name']:
                if hasattr(raw, attr_name):
                    tool_name = getattr(raw, attr_name, None)
                    if tool_name:
                        break

    # Fallback to direct attributes
    if not tool_name and hasattr(event_item, 'tool_call'):
        tool_call = event_item.tool_call
        if hasattr(tool_call, 'name'):
            tool_name = tool_call.name
        if hasattr(tool_call, 'id'):
            tool_id = tool_call.id
        elif hasattr(tool_call, 'function') and hasattr(tool_call.function, 'name'):
            tool_name = tool_call.function.name
    if not tool_name and hasattr(event_item, 'name'):
        tool_name = event_item.name
    if not tool_name and hasattr(event_item, 'function'):
        func = event_item.function
        if hasattr(func, 'name'):
            tool_name = func.name

    return tool_name, tool_id


def format_tool_arguments(tool_call_obj) -> str:
    """Format tool arguments for display."""
    if not tool_call_obj or not hasattr(tool_call_obj, 'arguments'):
        return ""

    try:
        args_dict = json.loads(tool_call_obj.arguments) if isinstance(tool_call_obj.arguments, str) else tool_call_obj.arguments
        if 'repo' in args_dict:
            tool_args = f" → {args_dict['repo']}"
            if 'issue_number' in args_dict:
                tool_args += f"#{args_dict['issue_number']}"
            return tool_args
        elif 'path' in args_dict:
            return f" → {args_dict['path']}"
        elif 'query' in args_dict:
            q = str(args_dict['query'])
            return f" → {q[:40]}..." if len(q) > 40 else f" → {q}"
        elif 'url' in args_dict:
            return f" → {args_dict['url']}"
        elif 'extensions' in args_dict or 'path_prefixes' in args_dict:
            parts = []
            if 'extensions' in args_dict:
                parts.append(f"ext={args_dict['extensions']}")
            if 'path_prefixes' in args_dict:
                parts.append(f"paths={args_dict['path_prefixes']}")
            return f" → {', '.join(parts)}"
    except:
        pass

    return ""


def handle_tool_call_event(event_item, active_tools: dict, tool_counter: int) -> tuple[int, bool]:
    """Handle tool call events and return updated tool_counter and whether event was handled."""
    tool_name, tool_id = extract_tool_info(event_item)

    if tool_name:
        tool_counter += 1
        tool_id = tool_id or f"tool_{tool_counter}"
        active_tools[tool_id] = tool_name

        # Get tool arguments if available
        tool_call_obj = None
        if hasattr(event_item, 'raw_item') and hasattr(event_item.raw_item, 'tool_call'):
            tool_call_obj = event_item.raw_item.tool_call
        elif hasattr(event_item, 'tool_call'):
            tool_call_obj = event_item.tool_call

        tool_args = format_tool_arguments(tool_call_obj)
        print(f"\n[{tool_counter}] 🔧 Calling: {tool_name}{tool_args}...", flush=True)
        return tool_counter, True
    else:
        # Still couldn't extract - try to inspect raw_item structure
        if hasattr(event_item, 'raw_item'):
            raw = event_item.raw_item
            try:
                raw_attrs = [attr for attr in dir(raw) if not attr.startswith('_')]
                # Look for attributes that might contain the tool name
                for attr in raw_attrs:
                    try:
                        val = getattr(raw, attr)
                        if isinstance(val, str) and ('get_github' in val.lower() or 'list_repo' in val.lower() or 'firecrawl' in val.lower()):
                            tool_name = val
                            break
                        # Check if it's a dict-like object with name
                        if hasattr(val, 'name'):
                            tool_name = val.name
                            break
                    except:
                        continue

                if tool_name:
                    tool_counter += 1
                    tool_id = tool_id or f"tool_{tool_counter}"
                    active_tools[tool_id] = tool_name
                    print(f"\n[{tool_counter}] 🔧 Calling: {tool_name}...", flush=True)
                    return tool_counter, True
                else:
                    # Print raw_item structure for debugging
                    print(f"\n[DEBUG] raw_item attrs: {raw_attrs[:10]}", flush=True)
            except Exception as e:
                print(f"\n[DEBUG] Error inspecting raw_item: {e}", flush=True)

    return tool_counter, False


def handle_tool_output_event(event_item, active_tools: dict, completed_tools: list) -> None:
    """Handle tool output events and track completed tools."""
    tool_id = None

    # Try raw_item first
    if hasattr(event_item, 'raw_item') and hasattr(event_item.raw_item, 'tool_call_id'):
        tool_id = event_item.raw_item.tool_call_id
    elif hasattr(event_item, 'tool_call_id'):
        tool_id = event_item.tool_call_id
    elif hasattr(event_item, 'raw_item') and hasattr(event_item.raw_item, 'tool_call'):
        if hasattr(event_item.raw_item.tool_call, 'id'):
            tool_id = event_item.raw_item.tool_call.id
    elif hasattr(event_item, 'tool_call'):
        if hasattr(event_item.tool_call, 'id'):
            tool_id = event_item.tool_call.id
        elif hasattr(event_item.tool_call, 'function') and hasattr(event_item.tool_call.function, 'name'):
            # Try to match by name if ID not available
            tool_name_match = event_item.tool_call.function.name
            for tid, tname in active_tools.items():
                if tname == tool_name_match:
                    tool_id = tid
                    break

    if tool_id and tool_id in active_tools:
        tool_name = active_tools.pop(tool_id)
        completed_tools.append(tool_name)
    elif active_tools:
        # Fallback: use the first active tool
        tool_id, tool_name = next(iter(active_tools.items()))
        active_tools.pop(tool_id)
        completed_tools.append(tool_name)
6. Nu koppelen we de streamingloop en persistentie. We verwerken streamingevents van de agent, printen tokens zodra ze binnenkomen, tonen redenering en tooraanroepen in realtime, vallen netjes terug op een niet-streaming-run als er iets misgaat, en schrijven uiteindelijk het volledige uitvoeringsplan naar een markdownbestand met nuttige metadata.
async def process_streaming_events(result, repo: str, issue_number: int) -> str:
    """Process streaming events from the agent execution."""
    final_output = ""
    active_tools = {}  # Track active tool calls by ID
    tool_counter = 0
    completed_tools = []
    first_event_received = False

    # Stream the events as they come in
    async for event in result.stream_events():
        # Handle raw response events (token-by-token streaming) - print immediately
        if event.type == "raw_response_event" and isinstance(event.data, ResponseTextDeltaEvent):
            if not first_event_received:
                first_event_received = True
            delta = event.data.delta
            print(delta, end="", flush=True)
            final_output += delta
        # Handle run item events (higher level updates)
        elif event.type == "run_item_stream_event":
            item_type = getattr(event.item, 'type', 'unknown')

            # Show reasoning events
            if item_type == "reasoning_item":
                handle_reasoning_event(event.item)
            elif item_type == "tool_call_item":
                tool_counter, handled = handle_tool_call_event(event.item, active_tools, tool_counter)
                if handled:
                    first_event_received = True
            elif item_type == "tool_call_output_item":
                handle_tool_output_event(event.item, active_tools, completed_tools)
            elif item_type == "message_output_item":
                message_text = ItemHelpers.text_message_output(event.item)
                if message_text and (not final_output or message_text not in final_output):
                    print(f"\n{message_text}", flush=True)
                    final_output += message_text

    print()  # Add newline after streaming

    # Show summary of tools used
    if completed_tools:
        print(f"---\n\n📊 Tools used ({len(completed_tools)}): {', '.join(completed_tools)}", flush=True)

    # If no streaming events occurred, fall back to final output
    if not final_output:
        final_output = result.final_output
        if final_output:
            print(final_output, flush=True)

    return final_output

async def run_agent_with_streaming(agent, user_prompt: str, repo: str, issue_number: int) -> str:
    """Run the agent with streaming support and fallback handling."""
    try:
        # Run agent with streaming (run_streamed is synchronous, returns immediately)
        result = Runner.run_streamed(
            agent,
            input=user_prompt,
            context={"repo": repo, "issue_number": issue_number},
        )

        return await process_streaming_events(result, repo, issue_number)

    except Exception as e:
        print(f"⚠️  Error: {e}", flush=True)
        # Fallback to standard async run
        result = await Runner.run(
            agent,
            input=user_prompt,
            context={"repo": repo, "issue_number": issue_number},
        )
        print(result.final_output, flush=True)
        return result.final_output

def save_output_to_file(markdown_file: pathlib.Path, repo: str, issue_number: int, final_output: str) -> None:
    """Save the final output to a markdown file."""
    with open(markdown_file, 'w', encoding='utf-8') as f:
        f.write(f"# GitHub Issue Analysis: {repo}#{issue_number}\n\n")
        f.write(f"**Generated on:** {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}\n\n")
        f.write(f"**Repository:** {repo}\n")
        f.write(f"**Issue Number:** {issue_number}\n\n")
        f.write("---\n\n")
        f.write(final_output)

    print(f"---\n\n✅ Saved: {markdown_file}", flush=True)
7. Tot slot brengen we alles samen in het hoofdentrypoint. We parsen de argumenten, halen de repo en het issue op, valideren de omgeving, bouwen de agent en zijn prompt, draaien de planner met streaming (met fallback naar een sync-run indien nodig) en slaan het resultaat op.
async def main() -> None:
    """Main entry point for the application."""
    args = parse_args()
    repo, issue_number = get_user_input(args)
    validate_environment()

    agent = build_planner_agent()
    user_prompt = build_user_prompt(repo, issue_number)
    markdown_file = setup_output_file(repo, issue_number)

    print(f"\n🔍 Analyzing {repo}#{issue_number}...\n")

    # Run the agent with streaming support
    try:
        final_output = await run_agent_with_streaming(agent, user_prompt, repo, issue_number)
    except Exception as e:
        print(f"⚠️  Error: {e}", flush=True)
        # Final fallback to standard sync run
        result = Runner.run_sync(
            agent,
            input=user_prompt,
            context={"repo": repo, "issue_number": issue_number},
        )
        print(result.final_output, flush=True)
        final_output = result.final_output

    # Save output to file
    save_output_to_file(markdown_file, repo, issue_number, final_output)


if __name__ == "__main__":
    asyncio.run(main())
Opmerking: De broncode, configuratie en documentatie zijn beschikbaar in de GitHub-repository: kingabzpro/Issue-Analyzer. Bekijk deze en gebruik hem als leidraad bij het reproduceren van de resultaten.
Er zijn twee manieren om onze CLI-app te gebruiken: Interactieve modus, waarbij de app je stap voor stap vraagt om de naam van de repository en het issue-nummer op te geven, en CLI-modus, waarbij je alle informatie bij het starten van de app moet meegeven.
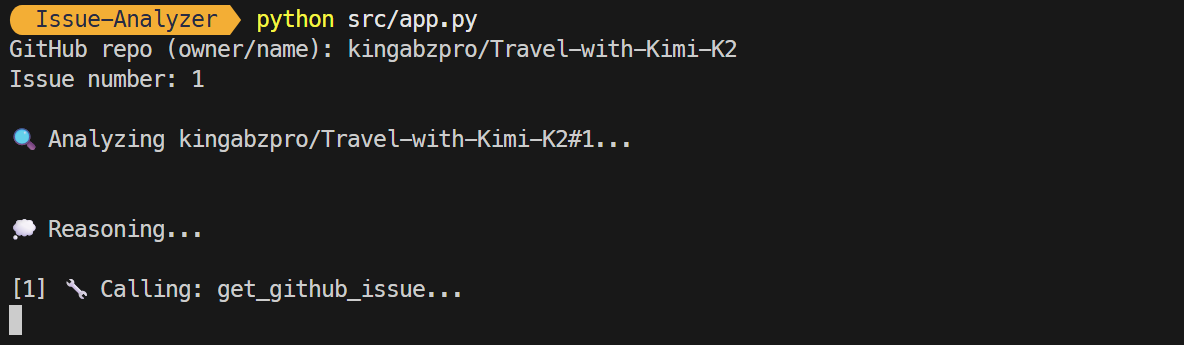
Om de interactieve modus te starten, typ je de volgende opdracht:
python src/app.pyZodra deze gestart is, word je gevraagd de naam van de repository en het issue-nummer op te geven, en begint de app tools en redenering te gebruiken om je te helpen.
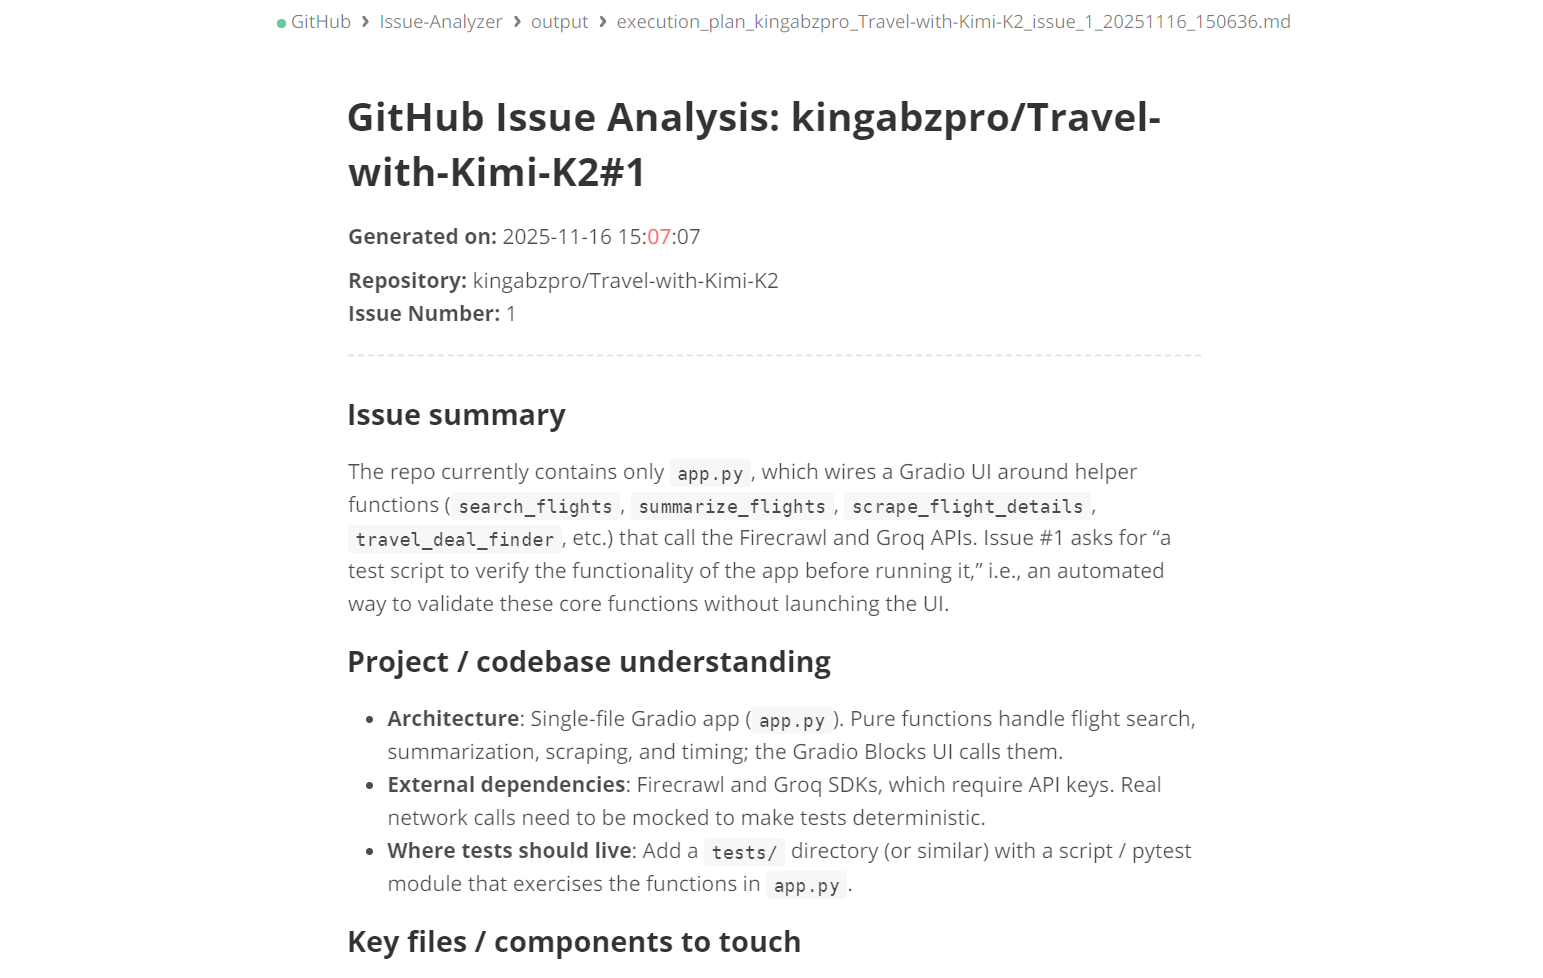
Binnen enkele seconden ontvang je een samenvatting van het issue en manieren om het op te lossen. Deze samenvatting bevat details over de gebruikte tools en de locatie van het markdownbestand waarin de informatie is opgeslagen.
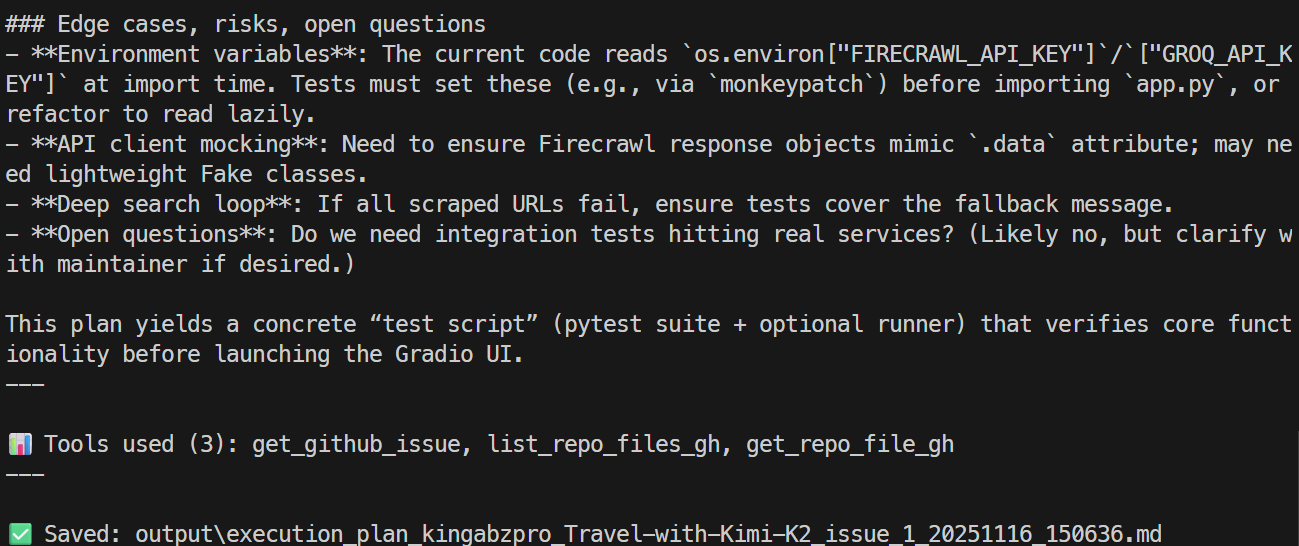
Je kunt het markdownbestand openen om een gedetailleerd issueplan te bekijken.
De CLI-modus vereist dat de naam van de repository en het issue-argument direct in de opdracht worden opgenomen, zoals hieronder:
python src/app.py --repo kingabzpro/Travel-with-Kimi-K2 --issue 1Het hele proces is gestreamd, wat betekent dat je ziet welke tools de agent gebruikt en of hij effectief redeneert. Ook de uiteindelijke gegenereerde respons wordt gestreamd.
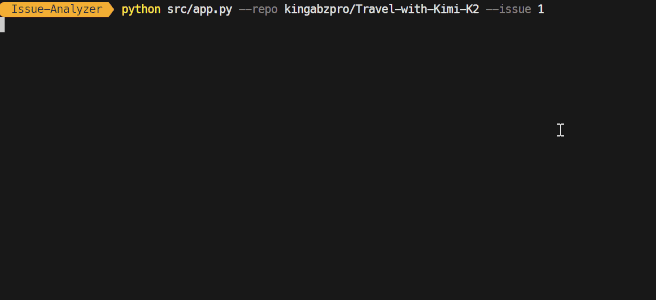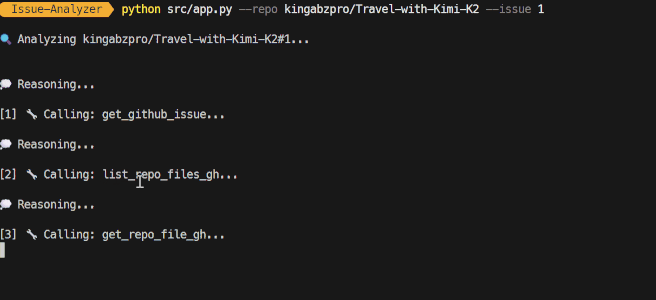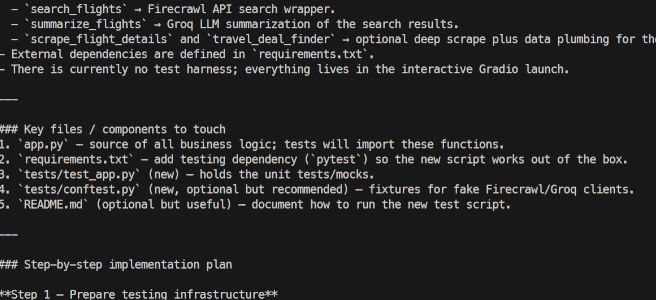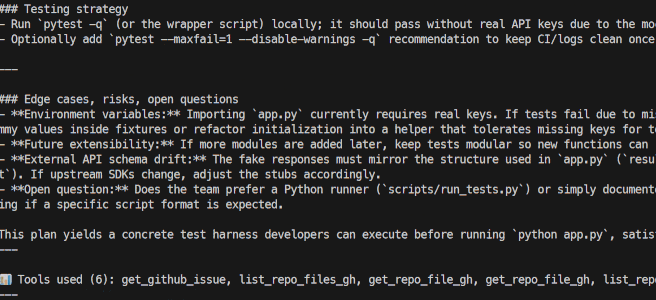
De huidige versie van de GitHub Issue Analyzer is ontworpen om issues te begrijpen en nauwkeurige uitvoeringsplannen te genereren.
De echte potentie van een agentische workflow zit echter in het automatiseren van alle stappen die volgen nadat het plan is gemaakt. Hier zijn enkele grote upgrades die je in het systeem kunt implementeren:
Het doel van het project is om een plan automatisch om te zetten in een werkende pull request. Dit stroomlijnt het ontwikkelproces en zorgt voor een efficiëntere workflow.
Deze functionaliteit omvat de mogelijkheid om vanuit de agent een nieuwe branch te maken, wat het implementeren van wijzigingen vergemakkelijkt. Daarnaast zal de agent codewijzigingen toepassen op basis van het gegenereerde plan en GitHub CLI-workflows uitvoeren, zoals gh pr create en gh pr view.
Bovendien zal het systeem automatisch PR-beschrijvingen, changelogs en gekoppelde issuereferenties genereren. Het zal ook labels slim toepassen, zoals bugfixes, enhancements of refactors.
Per saldo verandert dit initiatief de agent effectief in een volledig autonoom Issue-naar-Pull Request-automatiseringssysteem, wat de productiviteit en consistentie in de ontwikkelcyclus aanzienlijk verbetert.
Deze upgrade verbetert het proces van issue-analyse door batchmogelijkheden voor GitHub-issues te introduceren. In plaats van je op individuele problemen te richten, kunnen teams batchscans uitvoeren op meerdere issues tegelijk. Deze nieuwe functie maakt parallelle of in de wachtrij geplaatste analyse van volledige backlogs mogelijk, waardoor grotere aantallen issues effectiever kunnen worden afgehandeld.
Daarnaast helpt deze upgrade bij het identificeren van dubbele of gerelateerde issues, wat de organisatie verbetert. Issues kunnen worden geclassificeerd op basis van criteria zoals complexiteit, subsysteem of impact.
Om de operaties verder te stroomlijnen kunnen teams GitHub- of Firecrawl-tools in batchmodus draaien, wat de efficiëntie aanzienlijk verhoogt. Uiteindelijk biedt deze upgrade teams één opdracht die automatisch tientallen of zelfs honderden issues tegelijk kan triageren.
Voordat je een pull request (PR) maakt, is het essentieel dat de agent de voorgestelde wijzigingen grondig valideert in plaats van ze simpelweg te genereren. Dit validatieproces omvat verschillende geplande functies, waaronder het draaien van unittests via GitHub Actions of lokale testrunners om te zorgen dat de code zich gedraagt zoals verwacht.
Dependency-validatie is ook cruciaal. Dit houdt in dat imports worden gecontroleerd op juistheid, ontbrekende modules worden opgespoord en versiemismatches worden opgelost die het project zouden kunnen beïnvloeden. Verder spelen linting, formatting en typechecking een belangrijke rol bij het handhaven van codekwaliteit.
Het is van vitaal belang om te waarborgen dat de wijzigingen bestaande buildpijplijnen niet verstoren en om eventuele breaking changes aan API’s of regressies te detecteren. Door deze stappen te volgen, zorgen we dat de PR schoon, veilig en klaar voor productie is.
Geavanceerde, meerstapsagents bouwen met GPT-5.1 Codex en openai-agents is verrassend eenvoudig. Het enige wat je echt hoeft te doen, is je eigen tools definiëren en het model duidelijke instructies geven over wanneer en hoe ze te gebruiken.
In deze tutorial gebruikte ik de GitHub CLI omdat die snel, intuïtief en eenvoudig te integreren is, maar je kunt net zo goed de GitHub Python SDK, directe API-calls of een andere CLI of Bash-utility gebruiken. De flexibiliteit is hier de echte kracht.
Je kunt deze setup zo ver uitbreiden als je wilt.
Je zou bijvoorbeeld kunnen maken:
Het doel van deze tutorial was laten zien wat GPT-5.1 Codex echt kan: het handelt tool-calling moeiteloos af, begrijpt grote codebases, voert gestructureerde redenering uit en kan lange automatiseringsketens draaien zonder constante gebruikersinvoer.
Als je meer wilt leren over het bouwen van AI-agents, raad ik je aan onze AI Agents with Google ADK-cursus te bekijken, evenals onze lijst met AI-agentprojecten om te bouwen.
Topcursussen bij DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

