
Cours
Travailler avec l'API OpenAI
3 h
174.6K
OpenAI a discrètement publié GPT-5.1-Codex sur sa plateforme développeurs, et beaucoup le considèrent déjà comme le meilleur modèle de code disponible aujourd’hui. Contrairement aux premières versions de Codex, GPT-5.1-Codex est conçu pour de vraies tâches d’ingénierie logicielle, le raisonnement de longue durée et les agents outillés.
Dans ce tutoriel, nous allons créer un GitHub Issue Analyzer Agent complet avec OpenAI Agents et GPT-5.1 Codex.
Notre agent sera capable de :
Cet agent se comporte comme un ingénieur senior : il recherche, lit, raisonne et planifie avant d’écrire quoi que ce soit. Vous pouvez consulter notre guide sur GPT-5.1 pour découvrir les autres nouveautés.
GPT-5.1 Codex est une déclinaison spécialisée de GPT-5.1, pensée pour des tâches de codage agentiques et longue durée, au-delà de la simple autocomplétion de snippets. Il est taillé pour la vraie ingénierie logicielle et les workflows pilotés par des agents, ce qui en fait le moteur idéal de notre automatisation Issue-to-Plan.
Contrairement aux modèles généralistes, Codex appréhende les bases de code comme un ingénieur senior : il lit les issues, raisonne sur l’architecture, identifie les bons répertoires et n’inspecte que les fichiers réellement utiles. Résultat : un agent plus rapide, plus pertinent et nettement plus économique.
Codex est optimisé pour des tâches de codage agentiques de longue durée. Il s’intègre naturellement aux outils développeurs comme GitHub CLI et l’API Firecrawl, permettant à notre agent de récupérer des issues, d’explorer l’arborescence en ligne, de lire des fichiers précis et de collecter la documentation au besoin. Il suit les consignes de près, produit des analyses propres et fiables, et adapte l’effort de raisonnement pour aller vite sur le simple et creuser sur le complexe.
En combinant une forte compréhension du code et un raisonnement conscient des outils, GPT-5.1 Codex permet à notre agent de transformer une issue GitHub en plan d’ingénierie précis et actionnable, sans scanner tout le dépôt ni halluciner du code. C’est l’épine dorsale du workflow : il apporte l’intuition d’ingénierie, la structure et la rigueur dont le projet a besoin.
Avant de démarrer, assurons-nous que votre environnement est prêt. Git doit être installé sur votre machine. En cas de doute, exécutez git --version pour vérifier. Vous aurez aussi besoin d’un compte sur la plateforme développeurs OpenAI avec au moins 6 $ de crédit pour éviter toute interruption d’appels API.
Ensuite, créez un compte Firecrawl gratuit et définissez vos clés API comme variables d’environnement. Elles permettent à votre analyseur de communiquer avec OpenAI et Firecrawl :
export OPENAI_API_KEY=sk-...
export FIRECRAWL_API_KEY="fc-..."
Une fois cela en place, installez les packages Python qui alimentent le workflow. Le premier, openai-agents, est un framework léger qui facilite la création de pipelines multi-agents. Le second, firecrawl-py, gère le crawl et l’extraction d’informations utiles depuis vos dépôts ou votre documentation.
pip install openai-agents
pip install firecrawl-py
Enfin, assurez-vous que votre GitHub CLI est installé et configuré. La commande suivante vous aidera à vous connecter à votre compte GitHub.
gh auth login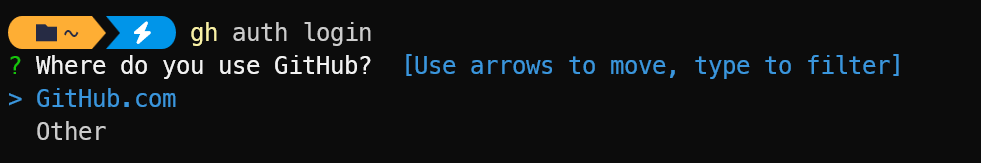
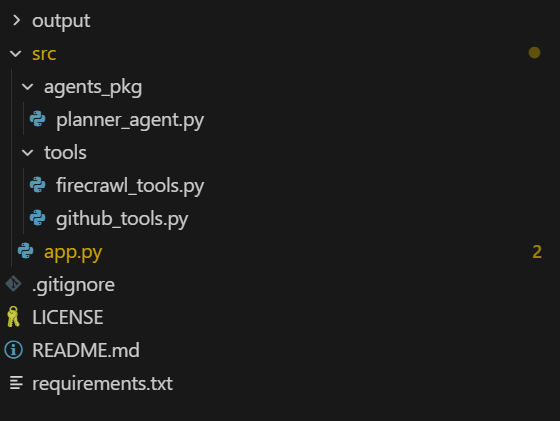
Nous allons créer un dossier « src » qui contiendra tout le code. Le dossier « agents_pkg » regroupera les fichiers d’agent, et « tools » contiendra les fichiers d’outils.
L’application principale, « app.py », propose une interface en ligne de commande (CLI) qui s’appuie sur les agents de planification pour générer un rapport d’issue GitHub à partir des saisies utilisateur.
Voici la structure attendue de votre projet :
Commençons par créer un fichier d’outils d’agent pour permettre à l’agent d’accéder à GitHub et à l’API Firecrawl via de simples fonctions Python.
On commence par les outils. Créez un fichier nommé firecrawl_tools.py dans le répertoire src/tools et ajoutez le code suivant.
1. Crée et retourne un client Firecrawl en utilisant la variable d’environnement FIRECRAWL_API_KEY, et lève une erreur si la clé est absente.
import json
import os

from agents import function_tool
from firecrawl import firecrawl


def _get_firecrawl_client():
    api_key = os.getenv("FIRECRAWL_API_KEY")
    if not api_key:
        raise RuntimeError("FIRECRAWL_API_KEY is not set")
    return firecrawl(api_key=api_key)
2. Utilise Firecrawl pour effectuer une recherche web ciblée (docs, articles, erreurs, etc.) et renvoie les résultats en JSON, utilisables par l’agent comme contexte externe.
@function_tool
def firecrawl_search(query: str, limit: int = 3) -> str:
    """
    Run a Firecrawl search for docs related to the issue or tech stack.

    Args:
        query: Search query (usually based on issue title / framework / error message).
        limit: Max number of results to return.

    Returns:
        JSON string of Firecrawl search results.
    """
    client = _get_firecrawl_client()
    results = client.search(query=query, limit=limit)
    return json.dumps(results)
3. Récupère le contenu d’une seule URL via Firecrawl (en markdown) et renvoie la page structurée en JSON pour une recherche technique plus approfondie.
@function_tool
def firecrawl_scrape(url: str) -> str:
    """
    Scrape a single URL using Firecrawl for deeper research.

    Args:
        url: URL to scrape (docs, blog, README in another repo, etc.).

    Returns:
        JSON (markdown/structured) content from Firecrawl scrape.
    """
    client = _get_firecrawl_client()
    result = client.scrape(url=url, params={"formats": ["markdown"]})
return json.dumps(result)Créez ensuite un fichier nommé github_tools.py dans le répertoire src/tools et ajoutez le code suivant.
1. Récupère une issue GitHub précise via GitHub CLI et renvoie ses détails en JSON pour que l’agent puisse la lire.
import base64
import json
import subprocess
from typing import List, Optional

from agents import function_tool


@function_tool
def get_github_issue(repo: str, issue_number: int) -> str:
    """
    Fetch a GitHub issue using the GitHub CLI.

    Args:
        repo: Repository in 'owner/name' format.
        issue_number: The issue number to fetch.

    Returns:
        A JSON string containing the issue fields (title, body, labels, URL, etc.),
        or an error payload if the command fails.
    """
    try:
        result = subprocess.run(
            [
                "gh",
                "issue",
                "view",
                str(issue_number),
                "--repo",
                repo,
                "--json",
                "number,title,body,labels,url,author,createdAt,state,assignees",
            ],
            capture_output=True,
            text=True,
            check=True,
        )
        return result.stdout
    except subprocess.CalledProcessError as e:
        return json.dumps(
            {
                "error": "Failed to fetch issue via GitHub CLI",
                "stderr": e.stderr,
                "repo": repo,
                "issue_number": issue_number,
            }
        )
2. Liste uniquement les fichiers pertinents d’un dépôt GitHub distant (avec filtres optionnels par chemin et extension) pour éviter de scanner tout le projet.
@function_tool
def list_repo_files_gh(
    repo: str,
    max_files: int = 80,
    extensions: Optional[List[str]] = None,
    path_prefixes: Optional[List[str]] = None,
) -> str:
    """
    List *relevant* files in the remote repo using GitHub CLI.

    Uses:
        gh api repos/{repo}/git/trees/HEAD?recursive=1

    The agent is expected to reason first which areas of the codebase are likely relevant
    (e.g. 'src/', 'app/', 'backend/api/', 'cli/'), and then call this tool with a small
    set of path_prefixes instead of scanning the entire project.

    Args:
        repo: Repository in 'owner/name' format (e.g. openai/openai-agents-python).
        max_files: Max number of files to return.
        extensions: Optional list of file extensions to keep (e.g. [".py", ".ts"]).
        path_prefixes: Optional list of path prefixes to include (e.g. ["src/", "app/api/"]).

    Returns:
        JSON string with file paths and filters applied.
    """
    try:
        result = subprocess.run(
            [
                "gh",
                "api",
                f"repos/{repo}/git/trees/HEAD?recursive=1",
            ],
            capture_output=True,
            text=True,
            check=True,
        )
    except subprocess.CalledProcessError as e:
        return json.dumps(
            {
                "error": "Failed to list repo files via GitHub CLI",
                "stderr": e.stderr,
                "repo": repo,
            }
        )

    try:
        data = json.loads(result.stdout)
    except json.JSONDecodeError:
        return json.dumps(
            {
                "error": "Failed to parse JSON from gh api",
                "raw": result.stdout[:2000],
                "repo": repo,
            }
        )

    tree = data.get("tree", [])

    if extensions is not None and not isinstance(extensions, list):
        extensions = [str(extensions)]
    exts = [e.lower() for e in (extensions or [])]

    if path_prefixes is not None and not isinstance(path_prefixes, list):
        path_prefixes = [str(path_prefixes)]
    prefixes = [p.strip() for p in (path_prefixes or []) if p.strip()]

    paths: List[str] = []
    for entry in tree:
        if entry.get("type") != "blob":
            continue  # only files
        path = entry.get("path", "")
        if not path:
            continue

        # If prefixes are provided, only keep files under those subtrees
        if prefixes and not any(path.startswith(pref) for pref in prefixes):
            continue

        if exts:
            suffix = "." + path.split(".")[-1].lower() if "." in path else ""
            if suffix not in exts:
                continue

        paths.append(path)
        if len(paths) >= max_files:
            break

    return json.dumps(
        {
            "repo": repo,
            "count": len(paths),
            "files": paths,
            "filtered_by_extensions": bool(exts),
            "filtered_by_prefixes": bool(prefixes),
        }
    )
3. Télécharge et décode le contenu d’un fichier du dépôt via GitHub CLI, puis renvoie le texte (tronqué si nécessaire) en JSON.
@function_tool
def get_repo_file_gh(
    repo: str,
    path: str,
    ref: str = "",
    max_chars: int = 8000,
) -> str:
    """
    Read a file's contents from the remote repo using GitHub CLI.

    Uses:
        gh api repos/{repo}/contents/{path} [ -F ref=<branch> ]

    Args:
        repo: Repository in 'owner/name' format.
        path: File path in the repo (e.g. 'src/main.py').
        ref: Optional branch / commit / tag ref (default: repo's default branch).
        max_chars: Max characters of decoded content to return.

    Returns:
        JSON with file metadata and decoded content (truncated if needed),
        or an error payload if anything fails.
    """
    cmd = ["gh", "api", f"repos/{repo}/contents/{path}"]
    # Only add ref when explicitly set (GitHub default branch otherwise)
    if ref:
        cmd += ["-F", f"ref={ref}"]

    try:
        result = subprocess.run(
            cmd,
            capture_output=True,
            text=True,
            check=True,
        )
    except subprocess.CalledProcessError as e:
        return json.dumps(
            {
                "error": "Failed to fetch file via GitHub CLI",
                "stderr": e.stderr,
                "repo": repo,
                "path": path,
                "ref": ref or "DEFAULT_BRANCH",
            }
        )

    try:
        data = json.loads(result.stdout)
    except json.JSONDecodeError:
        return json.dumps(
            {
                "error": "Failed to parse JSON from gh api (contents)",
                "raw": result.stdout[:2000],
                "repo": repo,
                "path": path,
            }
        )

    if data.get("type") != "file":
        return json.dumps(
            {
                "error": "Path is not a file",
                "repo": repo,
                "path": path,
                "data_type": data.get("type"),
            }
        )

    encoding = data.get("encoding")
    content_b64 = data.get("content", "")

    if encoding != "base64":
        return json.dumps(
            {
                "error": "Unexpected encoding",
                "repo": repo,
                "path": path,
                "encoding": encoding,
            }
        )

    try:
        # GitHub often includes newlines in base64 payload
        raw_bytes = base64.b64decode(content_b64)
        text = raw_bytes.decode("utf-8", errors="replace")
    except Exception as e:  # noqa: BLE001
        return json.dumps(
            {
                "error": f"Failed to decode file content: {e}",
                "repo": repo,
                "path": path,
                "encoding": encoding,
            }
        )

    truncated = text[:max_chars]
    return json.dumps(
        {
            "repo": repo,
            "path": path,
            "ref": ref or "DEFAULT_BRANCH",
            "truncated": len(text) > max_chars,
            "content": truncated,
        }
)Ici, nous définissons un agent Issue Planner qui sait :
Nous branchons les outils GitHub et Firecrawl, fournissons des instructions détaillées pour travailler en optimisant les coûts et demandons l’exécution avec le modèle gpt-5.1-codex.
Créez le fichier planner_agent.py dans le répertoire src/agents_pkg et ajoutez le code suivant :
from agents import Agent

from tools.github_tools import (
    get_github_issue,
    list_repo_files_gh,
    get_repo_file_gh,
)
from tools.firecrawl_tools import (
    firecrawl_search,
    firecrawl_scrape,
)


def build_planner_agent() -> Agent:
    """
    Issue Planner agent that:
    - Reads the GitHub issue
    - Reasons about which parts of the repo are relevant
    - Uses GitHub CLI to inspect a *small* set of files online
    - Uses Firecrawl for external research
    - Outputs a concrete, step-by-step execution plan
    """
    return Agent(
        name="Issue Planner",
        instructions=(
            "You are a senior software engineer.\n"
            "Goal: Given a GitHub issue and the online repo (structure + files), plus optional "
            "external research, produce a clear, step-by-step execution plan to resolve the issue.\n\n"
            "CONTEXT:\n"
            "- All repository interaction must be done *online* via GitHub CLI tools.\n"
            "- You have tools to: read the issue, list files under certain paths, read specific files, "
            "  and call Firecrawl search/scrape for docs.\n\n"
            "IMPORTANT STRATEGY (BE SMART):\n"
            "- Be selective and cost-aware. Do NOT scan the whole project.\n"
            "- First, deeply read the issue and infer which part of the system it affects:\n"
            "  routing layer, CLI, API handlers, DB layer, tests, etc.\n"
            "- Based on this reasoning, decide a small list of path prefixes and file types.\n\n"
            "RECOMMENDED WORKFLOW:\n"
            "1. Call get_github_issue(repo, issue_number) to fully understand the problem.\n"
            "2. From the issue, infer a small list of path prefixes where relevant code likely lives,\n"
            "   e.g. ['src/', 'app/', 'backend/api/', 'cli/'] depending on the project style.\n"
            "3. Call list_repo_files_gh with:\n"
            "   - extensions like ['.py', '.ts', '.js', '.tsx', '.jsx']\n"
            "   - path_prefixes set to that small, targeted list\n"
            "   This keeps the search focused instead of scanning the entire project.\n"
            "4. From the returned file list, pick at most ~5-15 key files that are most likely related\n"
            "   (entrypoints, routers, handlers, services, tests).\n"
            "5. Call get_repo_file_gh(repo, path=...) only on those selected files to inspect the "
            "   actual implementation.\n"
            "6. If you need framework or library context (FastAPI, Click, React, etc.), use\n"
            "   firecrawl_search and firecrawl_scrape to pull official docs or good examples.\n\n"
            "OUTPUT FORMAT (execution plan):\n"
            "After you have enough context from the issue + targeted code inspection (+ optional research), "
            "output a concise but concrete plan with sections:\n"
            "   - Issue summary\n"
            "   - Project/codebase understanding (where this issue lives in the architecture)\n"
            "   - Key files / components to touch (with file paths)\n"
            "   - Step-by-step implementation plan (Step 1, Step 2, ...)\n"
            "   - Testing strategy (unit / integration / manual)\n"
            "   - Edge cases, risks, and any open questions\n\n"
            "The plan must be actionable for a mid-level developer. Avoid generic advice; tie your steps "
            "to the actual files and modules you inspected.\n"
        ),
        tools=[
            get_github_issue,
            list_repo_files_gh,
            get_repo_file_gh,
            firecrawl_search,
            firecrawl_scrape,
        ],
        model="gpt-5.1-codex",
)Voici le fichier Python principal qui fournit une interface CLI et centralise toute la logique, les callbacks et la gestion d’erreurs. Il exploite efficacement les outils et agents définis ailleurs.
1. D’abord, nous configurons et importons tout ce dont la CLI a besoin. Nous incluons les bibliothèques standard, assurons une sortie Unicode correcte sous Windows pour les emojis et symboles, et importons le runner OpenAI ainsi que notre agent planificateur.
2. Ensuite, nous définissons les options en ligne de commande pour passer le dépôt GitHub et le numéro de l’issue lors de l’exécution de l’outil.
src/app.py :
import argparse
import asyncio
import json
import os
import pathlib
import sys
from datetime import datetime

# Set UTF-8 encoding for stdout to handle Unicode characters
if sys.platform == "win32":
    import codecs
    sys.stdout = codecs.getwriter("utf-8")(sys.stdout.detach())
    sys.stderr = codecs.getwriter("utf-8")(sys.stderr.detach())

from agents import Runner, ItemHelpers
from openai.types.responses import ResponseTextDeltaEvent

from agents_pkg.planner_agent import build_planner_agent


def parse_args() -> argparse.Namespace:
    parser = argparse.ArgumentParser(
        description=(
            "Issue Planner: GPT-5.1-Codex + OpenAI Agents + GitHub CLI + Firecrawl\n"        )
    )
    parser.add_argument(
        "--repo",
        help="GitHub repo in 'owner/name' format (e.g. openai/openai-agents-python).",
    )
    parser.add_argument(
        "--issue",
        type=int,
        help="Issue number to plan for.",
    )
    return parser.parse_args()
3. Nous collectons ensuite les entrées et préparons le contexte. Nous lisons le dépôt et l’issue depuis les arguments, vérifions la présence de la clé API OpenAI, construisons une invite claire pour guider l’analyse de l’issue étape par étape, et créons un fichier markdown horodaté pour enregistrer le plan final.
def get_user_input(args: argparse.Namespace) -> tuple[str, int]:
    """Get repository and issue number from arguments or user input."""
    repo = args.repo or input("GitHub repo (owner/name): ").strip()
    issue_number = args.issue or int(input("Issue number: ").strip())
    return repo, issue_number


def validate_environment() -> None:
    """Validate that required environment variables are set."""
    if not os.getenv("OPENAI_API_KEY"):
        raise RuntimeError("OPENAI_API_KEY is not set")


def build_user_prompt(repo: str, issue_number: int) -> str:
    """Build the user prompt for the agent."""
    return (
        f"You are helping me plan how to implement GitHub issue #{issue_number} "
        f"in repo '{repo}'.\n\n"
        "Be selective and cost-aware:\n"
        "1. Use get_github_issue(repo, issue_number) to understand the problem.\n"
        "2. Based on the issue text, first reason about which directories and components "
        "   are likely relevant.\n"
        "3. Call list_repo_files_gh(repo, extensions=['.py', '.ts', '.js', '.tsx', '.jsx'], "
        "   path_prefixes=[<your inferred prefixes>]) to only explore those areas.\n"
        "4. From those results, choose a small set of the most relevant files and call "
        "   get_repo_file_gh(repo, path=...) on them.\n"
        "5. Optionally, use firecrawl_search and firecrawl_scrape if you need external docs.\n"
        "6. Finally, generate the execution plan in the structured format from your instructions."
    )


def setup_output_file(repo: str, issue_number: int) -> pathlib.Path:
    """Create output directory and return the markdown file path."""
    output_dir = pathlib.Path("output")
    output_dir.mkdir(exist_ok=True)
    timestamp = datetime.now().strftime("%Y%m%d_%H%M%S")
    markdown_file = output_dir / f"execution_plan_{repo.replace('/', '_')}_issue_{issue_number}_{timestamp}.md"
    return markdown_file
4. Nous rendons ensuite le raisonnement de l’agent visible. Nous essayons d’extraire un court extrait propre de chaque événement et d’afficher une ligne « 💭 Reasoning… », pour donner une idée lisible de ce que le modèle élabore en arrière-plan.
def extract_reasoning_text(event_item) -> str | None:
    """Extract reasoning text from a reasoning event item."""
    reasoning_text = None

    if hasattr(event_item, 'raw_item'):
        raw = event_item.raw_item
        # Try multiple attribute names
        for attr_name in ['content', 'text', 'reasoning', 'message', 'delta']:
            if hasattr(raw, attr_name):
                val = getattr(raw, attr_name)
                if val and str(val).strip() and str(val) != 'None':
                    reasoning_text = str(val)
                    break

        # If still not found, try to access as dict-like
        if not reasoning_text:
            try:
                if hasattr(raw, '__dict__'):
                    for key, val in raw.__dict__.items():
                        if val and str(val).strip() and str(val) != 'None' and key in ['content', 'text', 'reasoning', 'message', 'delta']:
                            reasoning_text = str(val)
                            break
            except:
                pass

    # Also try direct attributes on event.item
    if not reasoning_text:
        for attr_name in ['content', 'text', 'reasoning', 'message']:
            if hasattr(event_item, attr_name):
                val = getattr(event_item, attr_name)
                if val and str(val).strip() and str(val) != 'None':
                    reasoning_text = str(val)
                    break

    return reasoning_text


def handle_reasoning_event(event_item) -> None:
    """Handle and display reasoning events."""
    reasoning_text = extract_reasoning_text(event_item)

    if reasoning_text and reasoning_text.strip():
        # Show first line or first 100 chars
        first_line = reasoning_text.split('\n')[0].strip()[:100]
        if len(reasoning_text.split('\n')[0].strip()) > 100:
            first_line += "..."
        print(f"\n💭 Reasoning: {first_line}", flush=True)
    else:
        # Don't show "None" - just show that reasoning is happening
        print(f"\n💭 Reasoning...", flush=True)
5. Nous gérons ensuite les appels d’outils et le suivi. Nous détectons quel outil l’agent utilise, formons ses arguments (repo, chemin, requête…), affichons un message « 🔧 Calling… », et tenons une carte des outils actifs pour les marquer terminés et récapituler ensuite tout ce qui a été exécuté.
def extract_tool_info(event_item) -> tuple[str | None, str | None]:
    """Extract tool name and ID from a tool call event item."""
    tool_name = None
    tool_id = None

    # First try raw_item which contains the actual tool call data
    if hasattr(event_item, 'raw_item'):
        raw = event_item.raw_item
        # Try accessing tool_call through various paths
        tool_call = None
        if hasattr(raw, 'tool_call'):
            tool_call = raw.tool_call
        elif hasattr(raw, 'function_call'):
            tool_call = raw.function_call

        if tool_call:
            # Try to get name from tool_call
            if hasattr(tool_call, 'name'):
                tool_name = tool_call.name
            elif hasattr(tool_call, 'function') and hasattr(tool_call.function, 'name'):
                tool_name = tool_call.function.name
            # Try to get ID
            if hasattr(tool_call, 'id'):
                tool_id = tool_call.id
            elif hasattr(tool_call, 'tool_call_id'):
                tool_id = tool_call.tool_call_id

        # Fallback: try direct attributes on raw
        if not tool_name:
            if hasattr(raw, 'name'):
                tool_name = getattr(raw, 'name')
            elif hasattr(raw, 'function') and hasattr(raw.function, 'name'):
                tool_name = raw.function.name
            # Try using getattr with different possible attribute names
            for attr_name in ['tool_name', 'function_name', 'name']:
                if hasattr(raw, attr_name):
                    tool_name = getattr(raw, attr_name, None)
                    if tool_name:
                        break

    # Fallback to direct attributes
    if not tool_name and hasattr(event_item, 'tool_call'):
        tool_call = event_item.tool_call
        if hasattr(tool_call, 'name'):
            tool_name = tool_call.name
        if hasattr(tool_call, 'id'):
            tool_id = tool_call.id
        elif hasattr(tool_call, 'function') and hasattr(tool_call.function, 'name'):
            tool_name = tool_call.function.name
    if not tool_name and hasattr(event_item, 'name'):
        tool_name = event_item.name
    if not tool_name and hasattr(event_item, 'function'):
        func = event_item.function
        if hasattr(func, 'name'):
            tool_name = func.name

    return tool_name, tool_id


def format_tool_arguments(tool_call_obj) -> str:
    """Format tool arguments for display."""
    if not tool_call_obj or not hasattr(tool_call_obj, 'arguments'):
        return ""

    try:
        args_dict = json.loads(tool_call_obj.arguments) if isinstance(tool_call_obj.arguments, str) else tool_call_obj.arguments
        if 'repo' in args_dict:
            tool_args = f" → {args_dict['repo']}"
            if 'issue_number' in args_dict:
                tool_args += f"#{args_dict['issue_number']}"
            return tool_args
        elif 'path' in args_dict:
            return f" → {args_dict['path']}"
        elif 'query' in args_dict:
            q = str(args_dict['query'])
            return f" → {q[:40]}..." if len(q) > 40 else f" → {q}"
        elif 'url' in args_dict:
            return f" → {args_dict['url']}"
        elif 'extensions' in args_dict or 'path_prefixes' in args_dict:
            parts = []
            if 'extensions' in args_dict:
                parts.append(f"ext={args_dict['extensions']}")
            if 'path_prefixes' in args_dict:
                parts.append(f"paths={args_dict['path_prefixes']}")
            return f" → {', '.join(parts)}"
    except:
        pass

    return ""


def handle_tool_call_event(event_item, active_tools: dict, tool_counter: int) -> tuple[int, bool]:
    """Handle tool call events and return updated tool_counter and whether event was handled."""
    tool_name, tool_id = extract_tool_info(event_item)

    if tool_name:
        tool_counter += 1
        tool_id = tool_id or f"tool_{tool_counter}"
        active_tools[tool_id] = tool_name

        # Get tool arguments if available
        tool_call_obj = None
        if hasattr(event_item, 'raw_item') and hasattr(event_item.raw_item, 'tool_call'):
            tool_call_obj = event_item.raw_item.tool_call
        elif hasattr(event_item, 'tool_call'):
            tool_call_obj = event_item.tool_call

        tool_args = format_tool_arguments(tool_call_obj)
        print(f"\n[{tool_counter}] 🔧 Calling: {tool_name}{tool_args}...", flush=True)
        return tool_counter, True
    else:
        # Still couldn't extract - try to inspect raw_item structure
        if hasattr(event_item, 'raw_item'):
            raw = event_item.raw_item
            try:
                raw_attrs = [attr for attr in dir(raw) if not attr.startswith('_')]
                # Look for attributes that might contain the tool name
                for attr in raw_attrs:
                    try:
                        val = getattr(raw, attr)
                        if isinstance(val, str) and ('get_github' in val.lower() or 'list_repo' in val.lower() or 'firecrawl' in val.lower()):
                            tool_name = val
                            break
                        # Check if it's a dict-like object with name
                        if hasattr(val, 'name'):
                            tool_name = val.name
                            break
                    except:
                        continue

                if tool_name:
                    tool_counter += 1
                    tool_id = tool_id or f"tool_{tool_counter}"
                    active_tools[tool_id] = tool_name
                    print(f"\n[{tool_counter}] 🔧 Calling: {tool_name}...", flush=True)
                    return tool_counter, True
                else:
                    # Print raw_item structure for debugging
                    print(f"\n[DEBUG] raw_item attrs: {raw_attrs[:10]}", flush=True)
            except Exception as e:
                print(f"\n[DEBUG] Error inspecting raw_item: {e}", flush=True)

    return tool_counter, False


def handle_tool_output_event(event_item, active_tools: dict, completed_tools: list) -> None:
    """Handle tool output events and track completed tools."""
    tool_id = None

    # Try raw_item first
    if hasattr(event_item, 'raw_item') and hasattr(event_item.raw_item, 'tool_call_id'):
        tool_id = event_item.raw_item.tool_call_id
    elif hasattr(event_item, 'tool_call_id'):
        tool_id = event_item.tool_call_id
    elif hasattr(event_item, 'raw_item') and hasattr(event_item.raw_item, 'tool_call'):
        if hasattr(event_item.raw_item.tool_call, 'id'):
            tool_id = event_item.raw_item.tool_call.id
    elif hasattr(event_item, 'tool_call'):
        if hasattr(event_item.tool_call, 'id'):
            tool_id = event_item.tool_call.id
        elif hasattr(event_item.tool_call, 'function') and hasattr(event_item.tool_call.function, 'name'):
            # Try to match by name if ID not available
            tool_name_match = event_item.tool_call.function.name
            for tid, tname in active_tools.items():
                if tname == tool_name_match:
                    tool_id = tid
                    break

    if tool_id and tool_id in active_tools:
        tool_name = active_tools.pop(tool_id)
        completed_tools.append(tool_name)
    elif active_tools:
        # Fallback: use the first active tool
        tool_id, tool_name = next(iter(active_tools.items()))
        active_tools.pop(tool_id)
        completed_tools.append(tool_name)
6. Nous branchons maintenant la boucle de streaming et la persistance. Nous traitons les événements diffusés par l’agent, affichons les tokens au fil de l’eau, montrons le raisonnement et les appels d’outils en temps réel, assurons une bascule élégante vers un mode non-streaming en cas de souci, puis écrivons le plan d’exécution complet dans un fichier markdown avec des métadonnées utiles.
async def process_streaming_events(result, repo: str, issue_number: int) -> str:
    """Process streaming events from the agent execution."""
    final_output = ""
    active_tools = {}  # Track active tool calls by ID
    tool_counter = 0
    completed_tools = []
    first_event_received = False

    # Stream the events as they come in
    async for event in result.stream_events():
        # Handle raw response events (token-by-token streaming) - print immediately
        if event.type == "raw_response_event" and isinstance(event.data, ResponseTextDeltaEvent):
            if not first_event_received:
                first_event_received = True
            delta = event.data.delta
            print(delta, end="", flush=True)
            final_output += delta
        # Handle run item events (higher level updates)
        elif event.type == "run_item_stream_event":
            item_type = getattr(event.item, 'type', 'unknown')

            # Show reasoning events
            if item_type == "reasoning_item":
                handle_reasoning_event(event.item)
            elif item_type == "tool_call_item":
                tool_counter, handled = handle_tool_call_event(event.item, active_tools, tool_counter)
                if handled:
                    first_event_received = True
            elif item_type == "tool_call_output_item":
                handle_tool_output_event(event.item, active_tools, completed_tools)
            elif item_type == "message_output_item":
                message_text = ItemHelpers.text_message_output(event.item)
                if message_text and (not final_output or message_text not in final_output):
                    print(f"\n{message_text}", flush=True)
                    final_output += message_text

    print()  # Add newline after streaming

    # Show summary of tools used
    if completed_tools:
        print(f"---\n\n📊 Tools used ({len(completed_tools)}): {', '.join(completed_tools)}", flush=True)

    # If no streaming events occurred, fall back to final output
    if not final_output:
        final_output = result.final_output
        if final_output:
            print(final_output, flush=True)

    return final_output

async def run_agent_with_streaming(agent, user_prompt: str, repo: str, issue_number: int) -> str:
    """Run the agent with streaming support and fallback handling."""
    try:
        # Run agent with streaming (run_streamed is synchronous, returns immediately)
        result = Runner.run_streamed(
            agent,
            input=user_prompt,
            context={"repo": repo, "issue_number": issue_number},
        )

        return await process_streaming_events(result, repo, issue_number)

    except Exception as e:
        print(f"⚠️  Error: {e}", flush=True)
        # Fallback to standard async run
        result = await Runner.run(
            agent,
            input=user_prompt,
            context={"repo": repo, "issue_number": issue_number},
        )
        print(result.final_output, flush=True)
        return result.final_output

def save_output_to_file(markdown_file: pathlib.Path, repo: str, issue_number: int, final_output: str) -> None:
    """Save the final output to a markdown file."""
    with open(markdown_file, 'w', encoding='utf-8') as f:
        f.write(f"# GitHub Issue Analysis: {repo}#{issue_number}\n\n")
        f.write(f"**Generated on:** {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}\n\n")
        f.write(f"**Repository:** {repo}\n")
        f.write(f"**Issue Number:** {issue_number}\n\n")
        f.write("---\n\n")
        f.write(final_output)

    print(f"---\n\n✅ Saved: {markdown_file}", flush=True)
7. Enfin, nous rassemblons le tout dans le point d’entrée principal. Nous analysons les arguments, récupérons le dépôt et l’issue, validons l’environnement, construisons l’agent et son prompt, exécutons le planificateur en streaming (avec repli synchrone si nécessaire) et enregistrons le résultat.
async def main() -> None:
    """Main entry point for the application."""
    args = parse_args()
    repo, issue_number = get_user_input(args)
    validate_environment()

    agent = build_planner_agent()
    user_prompt = build_user_prompt(repo, issue_number)
    markdown_file = setup_output_file(repo, issue_number)

    print(f"\n🔍 Analyzing {repo}#{issue_number}...\n")

    # Run the agent with streaming support
    try:
        final_output = await run_agent_with_streaming(agent, user_prompt, repo, issue_number)
    except Exception as e:
        print(f"⚠️  Error: {e}", flush=True)
        # Final fallback to standard sync run
        result = Runner.run_sync(
            agent,
            input=user_prompt,
            context={"repo": repo, "issue_number": issue_number},
        )
        print(result.final_output, flush=True)
        final_output = result.final_output

    # Save output to file
    save_output_to_file(markdown_file, repo, issue_number, final_output)


if __name__ == "__main__":
    asyncio.run(main())
Remarque : Le code source, la configuration et la documentation sont disponibles sur le dépôt GitHub : kingabzpro/Issue-Analyzer. Consultez-le et servez-vous-en comme guide pour reproduire les résultats.
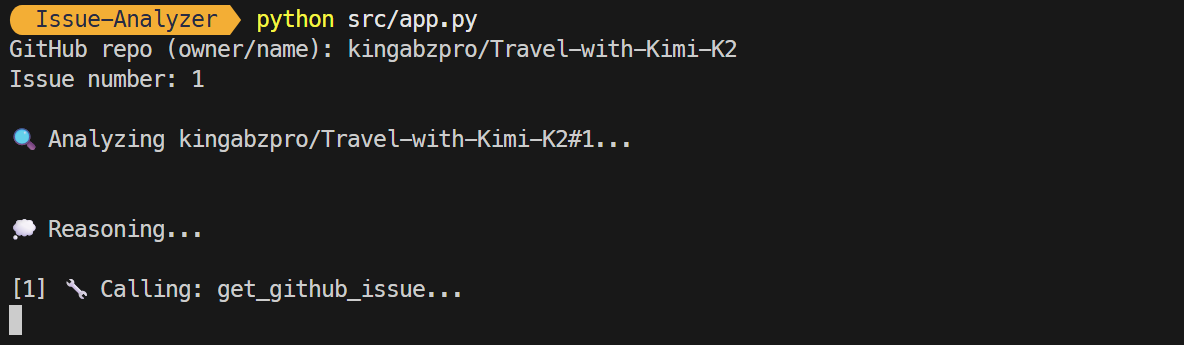
Deux modes sont possibles dans notre application CLI : le mode interactif, où l’application vous demande successivement le nom du dépôt et le numéro de l’issue, et le mode CLI, où vous fournissez toutes les informations dès le lancement.
Pour démarrer le mode interactif, tapez :
python src/app.pyUne fois lancé, on vous demandera le nom du dépôt et le numéro de l’issue, puis l’application utilisera les outils et le raisonnement pour vous assister.
En quelques secondes, vous recevrez un résumé de l’issue et des pistes de résolution. Ce résumé précise les outils utilisés et l’emplacement du fichier markdown où l’information est enregistrée.
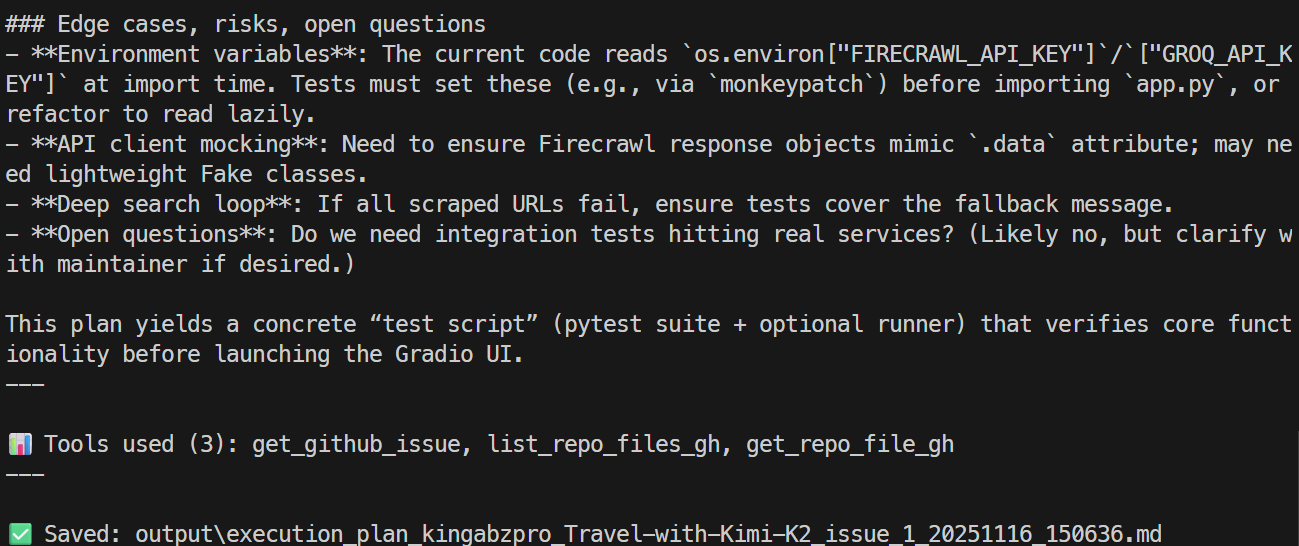
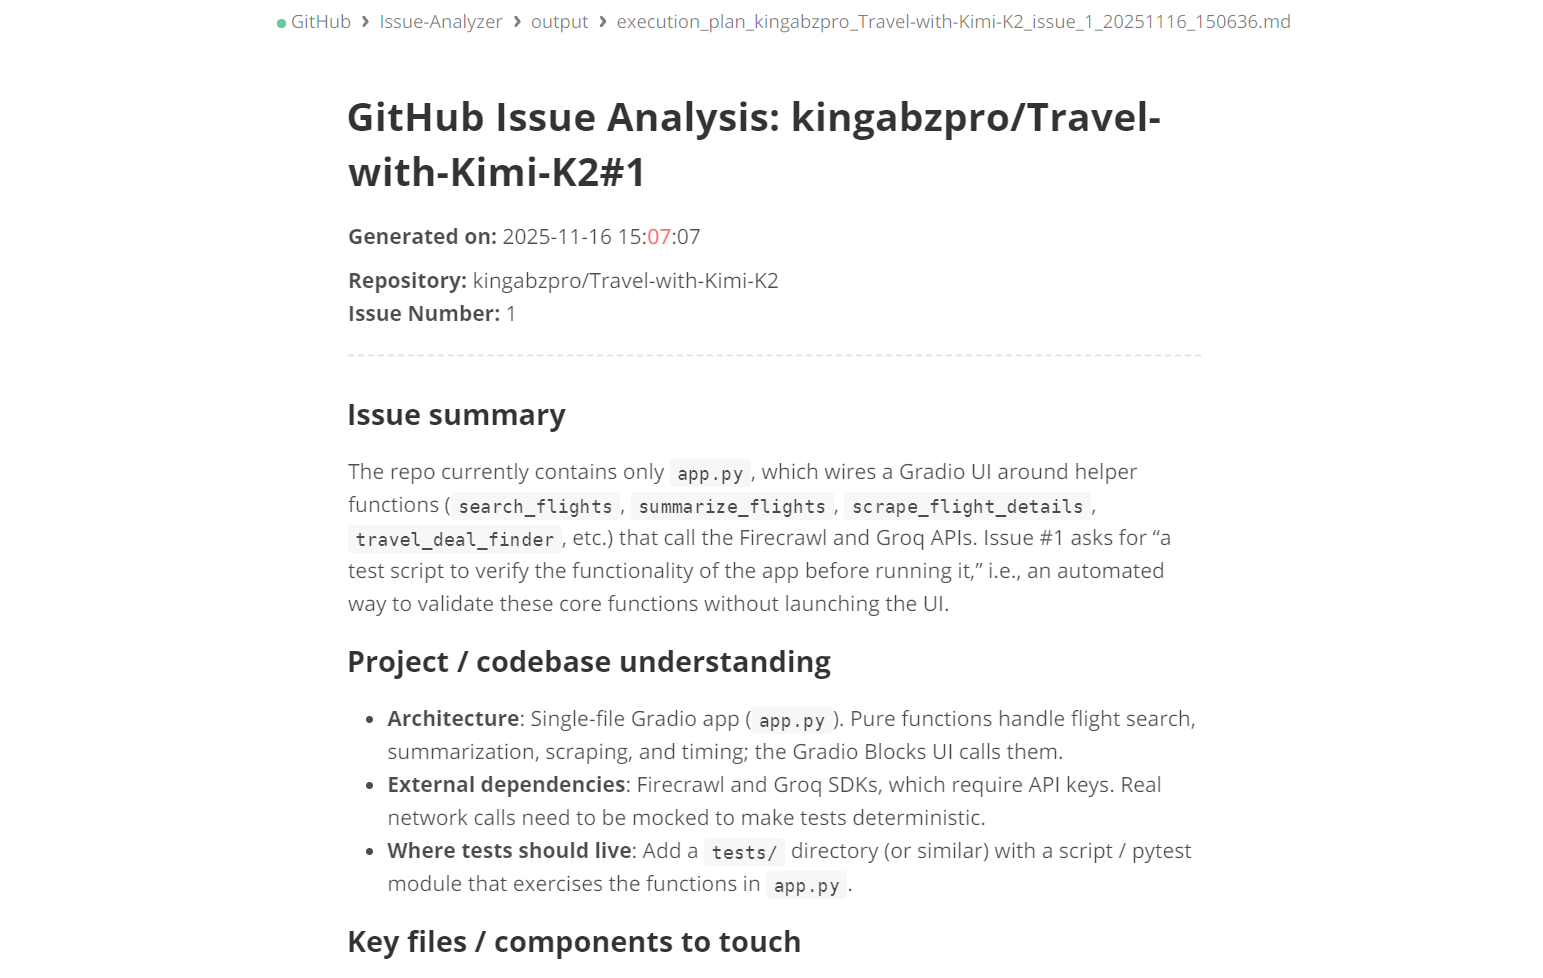
Ouvrez le fichier markdown pour consulter un plan détaillé de résolution de l’issue.
Le mode CLI nécessite d’indiquer directement le nom du dépôt et l’issue dans la commande, comme ci-dessous :
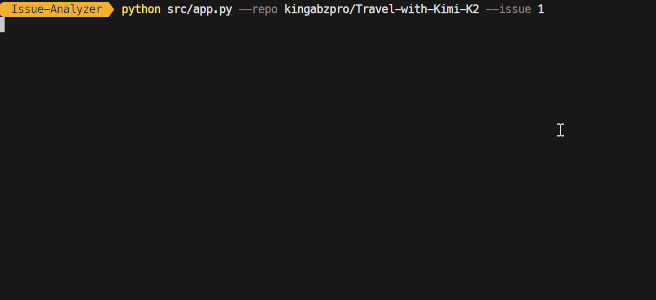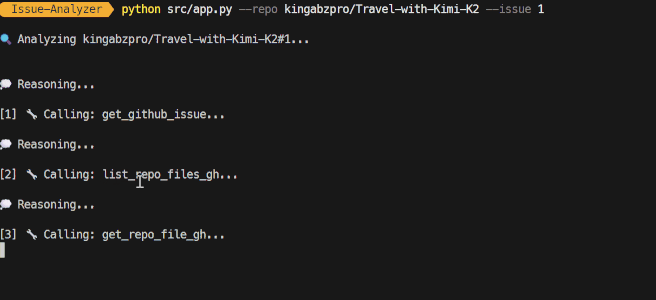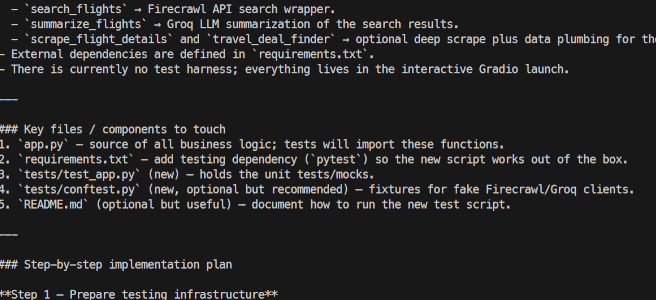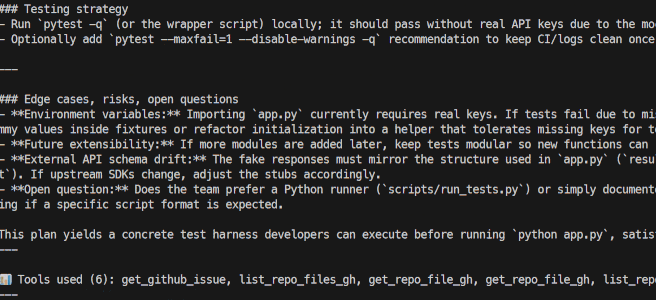
python src/app.py --repo kingabzpro/Travel-with-Kimi-K2 --issue 1Tout le processus est diffusé en continu : vous verrez quels outils l’agent utilise et s’il raisonne efficacement. La réponse finale est elle aussi diffusée en streaming.
La version actuelle de l’issue analyzer GitHub est conçue pour comprendre les issues et générer des plans d’exécution fiables.
Cependant, le vrai potentiel d’un workflow agentique réside dans l’automatisation des étapes qui suivent la création du plan. Voici des évolutions majeures à envisager :
L’objectif est de transformer automatiquement un plan en pull request fonctionnelle, afin de fluidifier le cycle de développement et gagner en efficacité.
Cette fonctionnalité inclura la création d’une nouvelle branche par l’agent, l’application de modifications de code basées sur le plan, et l’exécution de workflows GitHub CLI tels que gh pr create et gh pr view.
Le système pourra aussi générer automatiquement la description de la PR, le changelog et les références vers les issues liées. Il appliquera des labels de manière intelligente (bugfix, amélioration, refactor, etc.).
Au final, cela transforme l’agent en système autonome « Issue vers Pull Request », améliorant sensiblement productivité et cohérence dans le cycle de développement.
Cette amélioration apporte des capacités de traitement par lot des issues GitHub. Plutôt que d’opérer au cas par cas, les équipes pourront lancer des scans par lots sur de multiples issues en parallèle ou en file d’attente, pour traiter efficacement de gros volumes.
Elle facilitera aussi la détection des doublons ou des sujets liés et permettra une meilleure organisation. Les issues pourront être classées selon la complexité, le sous-système ou l’impact.
Pour aller plus loin, les outils GitHub ou Firecrawl pourront s’exécuter en mode groupé, améliorant fortement l’efficacité. À terme, une seule commande pourra trier automatiquement des dizaines, voire des centaines d’issues.
Avant de créer une pull request (PR), l’agent doit valider rigoureusement les changements proposés plutôt que de simplement les générer. Cela inclut l’exécution de tests unitaires via GitHub Actions ou en local pour garantir le bon comportement du code.
La validation des dépendances est également cruciale : contrôle des imports, détection des modules manquants et résolution des incompatibilités de versions pouvant impacter le projet. En complément, linting, formatage et vérification de types contribuent à la qualité du code.
Il est essentiel de s’assurer que les modifications ne cassent pas les pipelines de build existants et de détecter toute rupture d’API ou régression. En suivant ces étapes, la PR reste propre, sûre et prête pour la production.
Construire des agents avancés et multi-étapes avec GPT-5.1 Codex et openai-agents est étonnamment simple. Il suffit de définir vos outils et d’indiquer clairement au modèle quand et comment les utiliser.
Dans ce tutoriel, j’ai utilisé GitHub CLI car c’est rapide, intuitif et facile à intégrer, mais vous pourriez tout aussi bien recourir au SDK Python GitHub, à des appels API directs, ou à tout autre utilitaire CLI/Bash. La flexibilité fait la force de cette approche.
Vous pouvez étendre ce dispositif autant que vous le souhaitez.
Par exemple, vous pourriez créer :
L’objectif de ce tutoriel était de montrer ce dont GPT-5.1 Codex est réellement capable : appeler des outils sans friction, comprendre de vastes bases de code, raisonner de manière structurée et exécuter de longues chaînes d’automatisation sans intervention constante.
Si vous souhaitez aller plus loin dans la création d’agents IA, nous vous recommandons notre cours AI Agents with Google ADK ainsi que notre sélection de projets d’agents IA à réaliser.
Les meilleurs cours DataCamp
Cours
Cours
Cours