
Last chance! 50% off DataCamp Premium
Sale ends in
Data met hoge dimensionaliteit, in termen van aantal features, komt tegenwoordig steeds vaker voor bij machine learning-problemen. Om nuttige informatie uit deze grote hoeveelheden data te halen, moet je statistische technieken gebruiken om ruis of redundante data te verminderen. Je hebt namelijk vaak niet elke feature nodig om een model te trainen. Je kunt je model verbeteren door alleen die features te gebruiken die niet gecorreleerd en niet-redundant zijn. Hier speelt featureselectie een belangrijke rol. Het helpt niet alleen om je model sneller te trainen, maar vermindert ook de complexiteit, maakt het model makkelijker te interpreteren en verbetert de accuracy, precision of recall, afhankelijk van de gekozen prestatiemaatstaf.
In deze tutorial behandel je de volgende concepten:
Eerst leer je meer over featureselectie: je ziet wanneer je het kunt gebruiken en welke soorten methoden beschikbaar zijn om de belangrijkste features voor je model te selecteren!
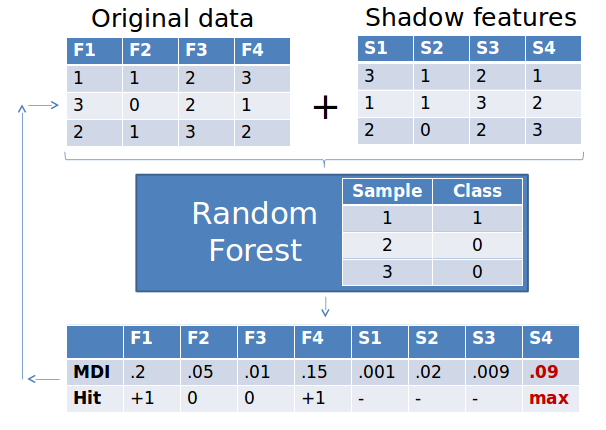
Vervolgens maak je kennis met het Boruta-algoritme. Je ziet hoe je hiermee top-down naar relevante features kunt zoeken door de belangrijkheid van originele attributen te vergelijken met de belangrijkheid die willekeurig haalbaar is, geschat met behulp van gepermuteerde kopieën, en stap voor stap irrelevante features te elimineren.
Je werpt ook een korte blik op de dataset waarop je de featureselectie gaat uitvoeren. Je ziet hoe je eenvoudig ontbrekende waarden kunt imputeren met behulp van het Amelia-pakket.
Tot slot leer je meer over het Boruta-pakket, waarmee je het algoritme kunt draaien.
In het algemeen kom je, wanneer je de dimensionaliteit van data wilt verminderen, methoden tegen zoals Principal Component Analysis, Singular Value Decomposition, enzovoort. Het is dus logisch om te vragen waarom je überhaupt andere featureselectiemethoden nodig hebt. Het punt met deze technieken is dat het onbewaakte manieren van featureselectie zijn: neem bijvoorbeeld PCA, dat variantie in data gebruikt om de componenten te vinden. Deze technieken houden geen rekening met de informatie tussen featurewaarden en de doelklasse of -waarden. Ook zijn er bepaalde aannames, zoals normaliteit, verbonden aan dit soort methoden die transformaties vereisen voordat je ze kunt toepassen. Deze beperkingen gelden niet voor alle soorten data.
Er zijn grofweg drie soorten featureselectiemethoden:
Filtermethoden: filtermethoden worden meestal als pre-processingstap gebruikt. De selectie van features is onafhankelijk van een machine learning-algoritme. In plaats daarvan worden features geselecteerd op basis van hun scores in verschillende statistische tests voor hun correlatie met de uitkomstvariabele. Enkele veelgebruikte filtermethoden zijn correlatiematen (Pearson, Spearman, Distance), de Chi-kwadraattoets, ANOVA, Fisher’s Score, enz.
Wrappermethoden: bij wrappermethoden gebruik je een subset van features en train je een model met die subset. Op basis van de bevindingen uit het vorige model besluit je features toe te voegen of te verwijderen uit de subset. Forward Selection en Backward Elimination zijn voorbeelden van wrappermethoden.
Embedded-methoden: dit zijn algoritmen met ingebouwde featureselectie. LASSO-regressie is zo’n voorbeeld.
In deze tutorial gebruik je een van de wrappermethoden die direct beschikbaar is in R via een pakket genaamd Boruta.
Het Boruta-algoritme is een wrapper rond het random forest-classificatiealgoritme. Het probeert alle belangrijke, interessante features in je dataset vast te leggen met betrekking tot een uitkomstvariabele.
Laten we het Boruta-algoritme gebruiken op een van de meest gangbare datasets: de Bank Marketing-data. Deze data vertegenwoordigt direct marketingcampagnes (telefoongesprekken) van een Portugese bank. Het doel van de classificatie is te voorspellen of de klant een termijndeposito zal afsluiten of niet.
Tip: bekijk zeker de gedetailleerde beschrijving van de verschillende features hier.
read_file <- read.csv('./bank_bank.csv',header=TRUE,sep=';',stringsAsFactors = F) #read csv into a dataframe
str(read_file)

## 'data.frame':    4521 obs. of  17 variables:
##  $ age      : int  30 33 35 30 59 35 36 39 41 43 ...
##  $ job      : chr  "unemployed" "services" "management" "management" ...
##  $ marital  : chr  "married" "married" "single" "married" ...
##  $ education: chr  "primary" "secondary" "tertiary" "tertiary" ...
##  $ default  : chr  "no" "no" "no" "no" ...
##  $ balance  : int  1787 4789 1350 1476 0 747 307 147 221 -88 ...
##  $ housing  : chr  "no" "yes" "yes" "yes" ...
##  $ loan     : chr  "no" "yes" "no" "yes" ...
##  $ contact  : chr  "cellular" "cellular" "cellular" "unknown" ...
##  $ day      : int  19 11 16 3 5 23 14 6 14 17 ...
##  $ month    : chr  "oct" "may" "apr" "jun" ...
##  $ duration : int  79 220 185 199 226 141 341 151 57 313 ...
##  $ campaign : int  1 1 1 4 1 2 1 2 2 1 ...
##  $ pdays    : int  -1 339 330 -1 -1 176 330 -1 -1 147 ...
##  $ previous : int  0 4 1 0 0 3 2 0 0 2 ...
##  $ poutcome : chr  "unknown" "failure" "failure" "unknown" ...
##  $ y        : chr  "no" "no" "no" "no" ...
Gebruik de functie summary() om de gebruikelijke beschrijvende statistieken van verschillende features in je dataset samen te vatten.
summary(read_file)

##       age            job              marital           education
##  Min.   :19.00   Length:4521        Length:4521        Length:4521
##  1st Qu.:33.00   Class :character   Class :character   Class :character
##  Median :39.00   Mode  :character   Mode  :character   Mode  :character
##  Mean   :41.17
##  3rd Qu.:49.00
##  Max.   :87.00
##    default             balance        housing              loan
##  Length:4521        Min.   :-3313   Length:4521        Length:4521
##  Class :character   1st Qu.:   69   Class :character   Class :character
##  Mode  :character   Median :  444   Mode  :character   Mode  :character
##                     Mean   : 1423
##                     3rd Qu.: 1480
##                     Max.   :71188
##    contact               day           month              duration
##  Length:4521        Min.   : 1.00   Length:4521        Min.   :   4
##  Class :character   1st Qu.: 9.00   Class :character   1st Qu.: 104
##  Mode  :character   Median :16.00   Mode  :character   Median : 185
##                     Mean   :15.92                      Mean   : 264
##                     3rd Qu.:21.00                      3rd Qu.: 329
##                     Max.   :31.00                      Max.   :3025
##     campaign          pdays           previous         poutcome
##  Min.   : 1.000   Min.   : -1.00   Min.   : 0.0000   Length:4521
##  1st Qu.: 1.000   1st Qu.: -1.00   1st Qu.: 0.0000   Class :character
##  Median : 2.000   Median : -1.00   Median : 0.0000   Mode  :character
##  Mean   : 2.794   Mean   : 39.77   Mean   : 0.5426
##  3rd Qu.: 3.000   3rd Qu.: -1.00   3rd Qu.: 0.0000
##  Max.   :50.000   Max.   :871.00   Max.   :25.0000
##       y
##  Length:4521
##  Class :character
##  Mode  :character
##
##
##
De functie summary() geeft centrummaten voor continue features, zoals gemiddelde, mediaan, kwantielen, enz. Als je categorische features in je dataset hebt, zie je ook de Class en Mode van die features.
Laten we nu de categorische features omzetten naar het datatype factor:
convert <- c(2:5, 7:9,11,16:17)
read_file[,convert] <- data.frame(apply(read_file[convert], 2, as.factor))
str(read_file)

## 'data.frame':    4521 obs. of  17 variables:
##  $ age      : int  30 33 35 30 59 35 36 39 41 43 ...
##  $ job      : Factor w/ 12 levels "admin.","blue-collar",..: 11 8 5 5 2 5 7 10 3 8 ...
##  $ marital  : Factor w/ 3 levels "divorced","married",..: 2 2 3 2 2 3 2 2 2 2 ...
##  $ education: Factor w/ 4 levels "primary","secondary",..: 1 2 3 3 2 3 3 2 3 1 ...
##  $ default  : Factor w/ 2 levels "no","yes": 1 1 1 1 1 1 1 1 1 1 ...
##  $ balance  : int  1787 4789 1350 1476 0 747 307 147 221 -88 ...
##  $ housing  : Factor w/ 2 levels "no","yes": 1 2 2 2 2 1 2 2 2 2 ...
##  $ loan     : Factor w/ 2 levels "no","yes": 1 2 1 2 1 1 1 1 1 2 ...
##  $ contact  : Factor w/ 3 levels "cellular","telephone",..: 1 1 1 3 3 1 1 1 3 1 ...
##  $ day      : int  19 11 16 3 5 23 14 6 14 17 ...
##  $ month    : Factor w/ 12 levels "apr","aug","dec",..: 11 9 1 7 9 4 9 9 9 1 ...
##  $ duration : int  79 220 185 199 226 141 341 151 57 313 ...
##  $ campaign : int  1 1 1 4 1 2 1 2 2 1 ...
##  $ pdays    : int  -1 339 330 -1 -1 176 330 -1 -1 147 ...
##  $ previous : int  0 4 1 0 0 3 2 0 0 2 ...
##  $ poutcome : Factor w/ 4 levels "failure","other",..: 4 1 1 4 4 1 2 4 4 1 ...
##  $ y        : Factor w/ 2 levels "no","yes": 1 1 1 1 1 1 1 1 1 1 ...
Omdat de datapunten worden geschud om schaduwfeatures te creëren en voor elk daarvan de Z-score wordt berekend, is het belangrijk om ontbrekende of lege waarden te behandelen voordat je het boruta-pakket gebruikt, anders krijg je een foutmelding.
(On)gelukkig heeft deze dataset geen van beide. Maar voor educatieve doeleinden voeg je wat NAs toe aan de data.
Zaai ontbrekende waarden in je dataset met de functie prodNA(). Je hebt toegang tot deze functie door het pakket missForest te installeren.
Onthoud dat je install.packages() kunt gebruiken om ontbrekende pakketten te installeren als dat nodig is!
library(missForest)

# Generate 5% missing values at random
bank.mis <- prodNA(read_file, noNA = 0.05)
Je kunt opnieuw de functie summary() aanroepen op je nieuwe dataframe om het aantal geïntroduceerde NAs te krijgen, maar laten we het eens iets creatiever aanpakken!
Laten we de ontbrekendheid in de data visualiseren met de volgende ggplot2-code:
library(reshape2)
library(ggplot2)
library(dplyr)
ggplot_missing <- function(x){

  x %>%
    is.na %>%
    melt %>%
    ggplot(data = .,
           aes(x = Var2,
               y = Var1)) +
    geom_raster(aes(fill = value)) +
    scale_fill_grey(name = "",
                    labels = c("Present","Missing")) +
    theme_minimal() +
    theme(axis.text.x  = element_text(angle=45, vjust=0.5)) +
    labs(x = "Variables in Dataset",
         y = "Rows / observations")
}
ggplot_missing(bank.mis)
De witte lijnen in de plot laten je visueel zien dat je ontbrekende waarden in elke feature hebt gezaaid, maar zie je hoeveel werk er in die functie ggplot_missing is gaan zitten? Het Amelia-pakket in R, dat je in de volgende sectie zult gebruiken, biedt een éénregelige alternatieve manier om een soortgelijke figuur te plotten:
library(Amelia)
missmap(bank.mis)
Probeer het zelf eens!
AmeliaJe kunt de ontbrekende waarden nu op verschillende manieren imputeren, zoals imputeren met gemiddelde, mediaan of modus (voor categorische features), maar laten we een ander krachtig pakket gebruiken voor het imputeren van ontbrekende waarden: Amelia.
Amelia neemt m bootstrapsteekproeven en past het EMB-algoritme (expectation-maximization met bootstrapping) toe op elke steekproef. De m schattingen van gemiddelden en varianties zullen verschillen. Uiteindelijk wordt de eerste set schattingen gebruikt om de eerste set ontbrekende waarden te imputeren met regressie, vervolgens wordt de tweede set schattingen gebruikt voor de tweede set, enzovoort. Meervoudige imputatie helpt bias te verminderen en de efficiëntie te vergroten. Daarnaast ondersteunt het parallel imputeren met behulp van multicore CPU’s.
Het heeft 3 belangrijke parameters:
m: het aantal te creëren geïmputeerde datasets.idvars: bewaar alle ID-variabelen en andere variabelen die je niet wilt imputeren.noms: zet nominale variabelen hier.library(Amelia)
amelia_bank <- amelia(bank.mis, m=3, parallel = "multicore",noms=c('job','marital','education','default','housing','loan','contact','month','poutcome','y'))
## -- Imputation 1 --
##
## 1 2 3 4 5 6
##
## -- Imputation 2 --
##
## 1 2 3 4 5 6
##
## -- Imputation 3 --
##
## 1 2 3 4 5Om toegang te krijgen tot de geïmputeerde dataframes, kun je de volgende subsetting gebruiken:
amelia_bank$imputations[[1]]Om de geïmputeerde dataset te exporteren naar csv-bestanden gebruik je:
write.amelia(amelia_bank, file.stem = "imputed_bank_data_set")Boruta-pakket in RLaten we nu het Boruta-algoritme gebruiken op een van de geïmputeerde datasets. Je kunt hiervoor het Boruta-pakket gebruiken:
library(Boruta)
set.seed(111)
boruta.bank_train <- Boruta(y~., data = amelia_bank$imputations[[1]], doTrace = 2)
print(boruta.bank_train)

## Boruta performed 99 iterations in 18.97234 mins.
##  10 attributes confirmed important: age, contact, day, duration,
## housing and 5 more;
##  3 attributes confirmed unimportant: education, job, marital;
##  3 tentative attributes left: balance, campaign, default;
Boruta geeft een oordeel over de significantie van features in een dataset. Veel ervan zijn al als belangrijk of onbelangrijk geclassificeerd, maar je ziet dat sommige in de categorie "tentative" zijn geplaatst.
Maar wat betekent dat?
Tentative features hebben een belangrijkheid die zo dicht bij die van hun beste schaduwfeatures ligt dat Boruta met het gewenste vertrouwen geen beslissing kan nemen binnen het standaard aantal Random Forest-runs.
Wat doe je daar dan aan?
Je zou kunnen overwegen om de parameter maxRuns te verhogen als er voorlopige (tentative) features overblijven. Let echter op dat je ook waarden kunt meegeven voor de parameters mtry en ntree, die worden doorgegeven aan de functie randomForest(). Met de eerste geef je het aantal variabelen op dat bij elke splitsing willekeurig als kandidaten wordt gekozen, terwijl je met de tweede het aantal bomen opgeeft dat je wilt groeien. Met deze argumenten zal de Random Forest-classifier convergeren bij een minimale waarde van de out-of-bag-fout.
Onthoud dat een out-of-bag-fout een schatting is om de voorspellingsfout te meten van classifiers die bootstrapaggregatie gebruiken om datamonsters voor training te sub-samplen. Het is de gemiddelde voorspellingsfout op elke trainingswaarneming X met alleen die bomen die X niet in hun bootstrapsteekproef hadden.
Als alternatief kun je het argument doTrace ook op 1 of 2 zetten, zodat je een voortgangsrapport krijgt van het proces.
Het boruta-pakket bevat ook een functie TentativeRoughFix(), die kan worden gebruikt om ontbrekende beslissingen op te vullen door de mediane Z-score van de feature eenvoudig te vergelijken met de mediane Z-score van de belangrijkste schaduwfeature:
#take a call on tentative features
boruta.bank <- TentativeRoughFix(boruta.bank_train)
print(boruta.bank)

## Boruta performed 99 iterations in 18.97234 mins.
## Tentatives roughfixed over the last 99 iterations.
##  12 attributes confirmed important: age, campaign, contact, day,
## default and 7 more;
##  4 attributes confirmed unimportant: balance, education, job,
## marital;
Boruta heeft nu zijn werk gedaan: het heeft elke feature succesvol geclassificeerd als belangrijk of onbelangrijk.
Je kunt nu de variabelebelangrijkheidsgrafiek van Boruta plotten door plot(boruta.bank) aan te roepen. De labels op de x-as zullen echter horizontaal staan. Dat oogt niet heel netjes.
Daarom voeg je de featurelabels verticaal toe aan de x-as, zoals in het volgende codeblok:
plot(boruta.bank, xlab = "", xaxt = "n")
lz<-lapply(1:ncol(boruta.bank$ImpHistory),function(i)
boruta.bank$ImpHistory[is.finite(boruta.bank$ImpHistory[,i]),i])
names(lz) <- colnames(boruta.bank$ImpHistory)
Labels <- sort(sapply(lz,median))
axis(side = 1,las=2,labels = names(Labels),
at = 1:ncol(boruta.bank$ImpHistory), cex.axis = 0.7)
Het label Importance op de y-as staat voor de Z-score van elke feature in de geschudde dataset.
De blauwe boxplots komen overeen met de minimale, gemiddelde en maximale Z-score van een schaduwfeature, terwijl de rode en groene boxplots respectievelijk de Z-scores van verworpen en bevestigde features weergeven. Zoals je ziet hebben de rode boxplots een lagere Z-score dan de maximale Z-score van de schaduwfeature, wat precies de reden is dat ze in de categorie onbelangrijk zijn geplaatst.
Je kunt de belangrijkheid van de features bevestigen door te typen:
getSelectedAttributes(boruta.bank, withTentative = F)

##  [1] "age"      "default"  "housing"  "loan"     "contact"  "day"
##  [7] "month"    "duration" "campaign" "pdays"    "previous" "poutcome"

bank_df <- attStats(boruta.bank)
print(bank_df)

##              meanImp  medianImp     minImp    maxImp   normHits  decision
## age       11.4236197 11.3760979  8.4250222 15.518420 1.00000000 Confirmed
## job        0.0741753  0.3002281 -1.7651336  1.566687 0.01010101  Rejected
## marital    1.8891283  2.0043568 -1.0276720  4.804499 0.22222222  Rejected
## education  1.5969540  1.6188117 -1.6836346  4.629572 0.28282828  Rejected
## default    2.3721979  2.3472820 -0.1434933  5.044653 0.50505051 Confirmed
## balance    2.3349682  2.3214378 -0.8098151  5.567993 0.51515152  Rejected
## housing    8.4147808  8.4384240  4.7392059 10.404609 1.00000000 Confirmed
## loan       4.1872186  4.2797591  2.0325838  6.263155 0.87878788 Confirmed
## contact   18.9482180 18.9757719 16.0937657 22.121461 1.00000000 Confirmed
## day        9.5645192  9.5828766  6.1842233 13.495442 1.00000000 Confirmed
## month     24.1475736 24.2067940 20.0621966 27.200679 1.00000000 Confirmed
## duration  71.5232213 71.1785055 64.3941499 78.249830 1.00000000 Confirmed
## campaign   2.6221456  2.6188180 -0.4144493  4.941482 0.65656566 Confirmed
## pdays     26.5650528 26.7123730 23.7902945 29.067476 1.00000000 Confirmed
## previous  20.9569022 20.9703991 18.7273357 23.117672 1.00000000 Confirmed
## poutcome  28.5166889 28.4885934 25.9855974 31.527154 1.00000000 Confirmed
Je kunt het resultaat eenvoudig valideren, want de feature duration heeft de hoogste belangrijkheid gekregen, wat ook in de databeschrijving wordt vermeld (klik hier) als je goed leest!
Voilà! Je hebt de belangrijkste features uit je dataset gefilterd door slechts een paar regels code te typen. Hiermee heb je ruis uit je data verwijderd, wat erg gunstig is voor elke classifier om een label aan een observatie toe te kennen. Een model trainen op deze belangrijke features zal de prestaties van je model zeker verbeteren — en dat was precies het doel van featureselectie!
Wil je de bronnen bekijken die voor deze tutorial zijn gebruikt? Kijk dan hiernaar:
R-cursussen
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

