
Cursus
Anomaly Detection in Python
4 uur
7.5K
Iedereen vindt het leuk om op te vallen, om anders te zijn. Maar dat is niet de eigenschap die je als data scientist in je datapunten wilt. Afwijkende datapunten of anomalieën in een dataset zijn een van de gevaarlijkste problemen met datakwaliteit die bijna alle dataprojecten teisteren.
Deze laatste zin kan je verrassen als je alleen hebt gewerkt met gepolijste open-sourcedatasets die vaak geen uitschieters bevatten. In echte datasets zijn er echter altijd enkele verschillen met de normale voorbeelden. Het is jouw taak om ze te detecteren en er op de juiste manier mee om te gaan.
In dit artikel leer je de basisideeën van dit proces, dat vaak anomaliedetectie wordt genoemd:
Aan het einde beheers je de fundamenten van anomaliedetectie en heb je het vertrouwen om de ontwrichtende invloed van uitschieters in je projecten te beperken.
Anomaliedetectie, soms uitschieterdetectie genoemd, is een proces om patronen of instanties in een dataset te vinden die significant afwijken van het verwachte of "normale gedrag".
De definitie van zowel "normale" als anomalie-data varieert sterk afhankelijk van de context. Hieronder staan een paar voorbeelden van anomaliedetectie in de praktijk.
Normaal: Routinematige aankopen en consistent uitgavenpatroon door een persoon in Londen.
Uitschieter: Een enorme opname vanuit Ierland van dezelfde rekening, wat kan duiden op mogelijke fraude.
Normaal: Regelmatige communicatie, stabiele gegevensoverdracht en naleving van het protocol.
Uitschieter: Plotselinge toename van gegevensoverdracht of gebruik van onbekende protocollen die wijzen op een mogelijke inbraak of malware.
Normaal: Stabiele hartslag en consistente bloeddruk
Uitschieter: Plotselinge stijging van de hartslag en daling van de bloeddruk, wat kan wijzen op een noodsituatie of een defect apparaat.
Anomaliedetectie omvat veel soorten ongecontroleerde methoden om afwijkende voorbeelden te identificeren. Dataspecialisten kiezen ze op basis van het type anomalie, de context, structuur en kenmerken van de dataset in kwestie. We behandelen ze in de komende secties.
Hoewel we hierboven al wat voorbeelden zagen, kijken we naar een waargebeurd verhaal over hoe anomaliedetectie in de financiële sector werkt.
Shaq O’Neal, viervoudig NBA-winnaar, wordt geruild van de Miami Heat naar de Phoenix Suns. Wanneer Shaq aankomt in het lege appartement dat door de Phoenix Suns is geregeld, wil hij midden in de nacht direct meubels kopen. Dus gaat hij naar Walmart en doet de grootste aankoop in de geschiedenis van Walmart van $70.000. Of in ieder geval, dat probeert hij; zijn kaart wordt geweigerd.
Hij vraagt zich af wat het probleem kan zijn (hij kan toch niet blut zijn!) Om 2 uur ’s nachts belt de beveiliging van American Express hem en vertelt dat zijn kaart als gestolen werd verdacht omdat iemand probeerde voor $70.000 te kopen bij Walmart in Phoenix (bekijk de anekdote voor het hele verhaal).
Er zijn zoveel andere toepassingen van anomaliedetectie buiten finance en fraudedetectie:
Anomaliedetectie is diep verweven met de dagelijkse diensten die we gebruiken, en vaak merken we het niet eens.
Data is het kostbaarste goed in data science, en anomalieën zijn de meest ontwrichtende bedreigingen voor de kwaliteit ervan. Slechte datakwaliteit betekent slechte:
en uiteindelijk een aangetaste basis voor geïnformeerde besluitvorming.
Anomalieën vertekenen statistische analyses door niet-bestaande patronen te introduceren, wat leidt tot verkeerde conclusies en onbetrouwbare voorspellingen. Omdat het vaak de extreme waarden in een dataset zijn, vertekenen anomalieën vaak de twee belangrijkste kenmerken van verdelingen: gemiddelde en standaarddeviatie.
Omdat de interne werking van bijna alle machinelearningmodellen sterk op deze twee maten leunt, is tijdige detectie van anomalieën cruciaal.
Anomaliedetectie omvat twee brede praktijken: uitschieterdetectie en noviteitsdetectie.
Uitschieters zijn abnormale of extreme datapunten die alleen in trainingsdata voorkomen. Daarentegen zijn noviteiten nieuwe of nog niet eerder geziene instanties ten opzichte van de oorspronkelijke (trainings)data.
Neem bijvoorbeeld een dataset met dagelijkse temperaturen in een stad. Op de meeste dagen ligt de temperatuur tussen 20°C en 30°C. Op een dag is er echter een piek van 40°C. Deze extreme temperatuur is een uitschieter omdat deze significant afwijkt van het gebruikelijke dagelijkse temperatuurbereik.
Stel je nu voor dat de stad een nieuw, nauwkeuriger weermonitoringsstation installeert. Daardoor begint de dataset consequent iets hogere temperaturen te registreren, variërend van 25°C tot 35°C. Deze aanhoudende stijging van de temperaturen is een noviteit en vertegenwoordigt een nieuw patroon dat is geïntroduceerd door het verbeterde monitoringsysteem.
Anomalieën daarentegen is een overkoepelende term voor zowel uitschieters als noviteiten. Het kan worden gebruikt om elke abnormale instantie in elke context te definiëren.
Het identificeren van het type anomalieën is cruciaal, omdat je daarmee het juiste algoritme kunt kiezen om ze te detecteren.
Net zoals er twee soorten anomalieën zijn, zijn er ook twee soorten uitschieters: univariaat en multivariaat. Afhankelijk van het type gebruiken we verschillende detectie-algoritmen.
Neem bijvoorbeeld een dataset met huizenprijzen in een wijk. De meeste huizen kosten tussen $200.000 en $400.000, maar er is Huis A met een uitzonderlijk hoge prijs van $1.000.000. Als we alleen de prijs analyseren, is Huis A een duidelijke uitschieter.
Laten we nu twee extra variabelen toevoegen aan onze dataset: de woonoppervlakte en het aantal slaapkamers. Als we de woonoppervlakte, het aantal slaapkamers en de prijs beschouwen, is het Huis B dat vreemd oogt:
Als we naar deze variabelen afzonderlijk kijken, lijken ze gewoontjes. Pas wanneer we ze combineren, ontdekken we dat Huis B een duidelijke multivariate uitschieter is.
Algoritmen voor anomaliedetectie verschillen afhankelijk van het type uitschieters en de structuur in de dataset.
Voor univariate uitschieterdetectie zijn de populairste methoden:
Voor multivariate uitschieters gebruiken we doorgaans machinelearningalgoritmen. Door hun diepte en kracht kunnen ze verfijnde patronen vinden in complexe datasets:
Naast het type anomalieën moet je rekening houden met datasetkenmerken en projectbeperkingen. Zo werkt Isolation Forest goed op vrijwel elke dataset, maar het is trager en rekenintensiever omdat het een ensemblemethode is. Ter vergelijking: LOF traint zeer snel, maar presteert mogelijk niet zo goed als Isolation Forest.
Je ziet een vergelijking van de meest voorkomende algoritmen voor anomaliedetectie op 55 datasets in het Python Outlier Detection (PyOD)-pakket.
Zoals bij vrijwel elke taak zijn er veel libraries in Python om anomaliedetectie uit te voeren. De beste kanshebbers zijn:
Hoewel scikit-learn vijf klassieke machinelearningalgoritmen biedt (je kunt ze gebruiken voor zowel univariate als multivariate uitschieters), bevat PyOD meer dan 30 algoritmen, van eenvoudige methoden zoals MAD tot complexe deep learning-modellen. Je kunt ook TensorFlow of PyTorch gebruiken voor custom modellen, maar die vallen buiten de scope van dit artikel.
Ik geef de voorkeur aan pyod vanwege de rijke bibliotheek met algoritmen en een API die consistent is met sklearn. Met slechts een paar regels code kun je met PyOD uitschieters in een dataset vinden en extraheren. Hier is een voorbeeld van het gebruik van MAD op een univariate dataset:
import pandas as pd
import seaborn as sns
from pyod.models.mad import MAD

# Load a sample dataset
diamonds = sns.load_dataset("diamonds")
# Extract the feature we want
X = diamonds[["price"]]

# Initialize and fit a model
mad = MAD().fit(X)

# Extract the outlier labels
labels = mad.labels_

>>> pd.Series(labels).value_counts()
0    49708
1     4232
Name: count, dtype: int64
Laten we de code regel voor regel doornemen. Eerst laden we de benodigde libraries voor datamanipulatie, het laden van een dataset en pyod voor het uitschieterdetectiemodel. Daarna, na het laden van de Diamonds-dataset die is ingebouwd in Seaborn, extraheren we de diamantprijzen.
Vervolgens initialiseren en fitten we in één regel een Median Absolute Deviation (MAD)-model op X. Daarna extraheren we de inlier- en uitschieterlabels met het attribuut labels_ van mad in labels.
Als we aan het eind de value counts van labels printen, zien we dat 49708 tot categorie 0 (inliers) behoort, terwijl 4232 tot 1 (uitschieters) behoort. Als we de uitschieters uit de oorspronkelijke dataset willen verwijderen, kunnen we pandas-subsetting gebruiken op diamonds:
outlier_free = diamonds[labels == 0]

>>> len(outlier_free)
49708
labels == 0 maakt een array van True/False-waarden (booleaanse array) waarbij True een inlier aangeeft.
Het proces van het maken van een multivariaat anomaliedetectiemodel is hetzelfde. Maar multivariate uitschieterdetectie vereist extra verwerkingsstappen als er categorische features aanwezig zijn:
>>> diamonds.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 53940 entries, 0 to 53939
Data columns (total 10 columns):
#   Column   Non-Null Count  Dtype
---  ------   --------------  -----
0   carat    53940 non-null  float64
1   cut      53940 non-null  category
2   color    53940 non-null  category
3   clarity  53940 non-null  category
4   depth    53940 non-null  float64
5   table    53940 non-null  float64
6   price    53940 non-null  int64
7   x        53940 non-null  float64
8   y        53940 non-null  float64
9   z        53940 non-null  float64
dtypes: category(3), float64(6), int64(1)
memory usage: 3.0 MB
Aangezien pyod verwacht dat alle features numeriek zijn, moeten we categorische variabelen encoden. We gebruiken Sklearn om dat te doen:
from sklearn.preprocessing import OrdinalEncoder

# Initialize the encoder
oe = OrdinalEncoder()

# Extract the categorical feature names
cats = diamonds.select_dtypes(include="category").columns.tolist()

# Encode the categorical features
cats_encoded = oe.fit_transform(diamonds[cats])

# Replace the old values with encoded values
diamonds.loc[:, cats] = cats_encoded

>>> diamonds.head()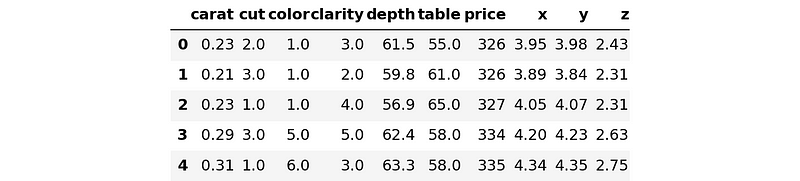
Laten we de code opnieuw regel voor regel doornemen. Eerst importeren en initialiseren we de klasse OrdinalEncoder die ordinale categorische features encodet. Ordinale features zijn variabelen met natuurlijke, geordende categorieën, zoals bij diamantkwaliteitsmetingen. De cut en clarity zijn ordinaal, terwijl color dat niet is. Maar om het niet te ingewikkeld te maken, beschouwen we het nu als ordinaal.
Vervolgens halen we de namen van de categorische features op met de methode select_dtypes van Pandas DataFrames. We koppelen de attributen .columns en .tolist() om kolomnamen te krijgen in een lijst genaamd cats.
Daarna gebruiken we de lijst om de gewenste features te transformeren met oe. Tot slot vervangen we met een handige Pandas-truc met .loc de oude tekstwaarden door numerieke waarden.
Voordat we een multivariaat model fitten, extraheren we de feature-array X. Het doel van de diamonds-dataset is om diamantprijzen te voorspellen op basis van hun kenmerken. Dus bevat X alle kolommen behalve price:
X = diamonds.drop("price", axis=1)
y = diamonds[["price"]]
Now, let’s build and fit the model:
from pyod.models.iforest import IForest

# Create a model with 10000 trees
iforest = IForest(n_estimators=10000)
iforest.fit(X)  # This will take a minute

# Extract the labels
labels = iforest.labels_
Hoe meer bomen de IForest-schatter heeft, hoe meer tijd het kost om het model op de dataset te fitten.
Nadat we labels hebben, kunnen we de uitschieters uit de oorspronkelijke data verwijderen:
X_outlier_free = X[labels == 0]
y_outlier_free = X[labels == 0]

>>> len(X_outlier_free)
48546

>>> # The length of the original dataset
>>> len(diamonds)
53940
Het model vond meer dan 5000 uitschieters!
Anomaliedetectie kan grotere uitdagingen opleveren dan andere machinelearningtaken vanwege het ongecontroleerde karakter. De meeste van deze uitdagingen kunnen echter worden beperkt met verschillende methoden (zie de volgende sectie voor bronnen).
Bij uitschieterdetectie moeten we twee vragen stellen:
Bij gecontroleerd leren kunnen we eenvoudig controleren of het model goed presteert door zijn voorspellingen op de testdata te vergelijken met de echte labels. Maar dat kunnen we niet doen bij uitschieterdetectie, omdat er geen kant-en-klare labels zijn die ons vertellen welke samples inliers en welke uitschieters zijn.
Dus sommige of zelfs de meeste van de +5000 uitschieters die in de diamonds-dataset zijn gevonden, zijn mogelijk helemaal geen uitschieters! Er is geen manier om het zeker te weten. Het kan enkele inliers als uitschieters hebben gelabeld en tegelijkertijd echte uitschieters hebben gemist.
Dit probleem van het niet kennen van het besmettingsniveau (het percentage uitschieters in een dataset) is het grootste bij anomaliedetectie. Daardoor kunnen we de prestaties van uitschieterclassifiers niet betrouwbaar meten en hun resultaten niet verifiëren.
Om deze reden hebben alle schatters in pyod een parameter genaamd contamination, die standaard is ingesteld op 0,1. Als machine learning engineer moet je deze parameter zelf tunen.
Natuurlijk zijn er soms alternatieven. Zo heeft het IsolationForest-model van Sklearn een intern algoritme om het besmettingsniveau automatisch te bepalen. Maar IsolationForest is geen wondermiddel voor alle uitschieterdetectieproblemen.
Een ander probleem bij anomaliedetectie is de onbalans in de data. Anomalieën zijn vaak zeldzaam in vergelijking met normale instanties, waardoor datasets onevenwichtig zijn. Deze onbalans kan het moeilijk maken om echte anomalieën te onderscheiden van onregelmatigheden binnen de meerderheidsklasse.
Het aanpakken van deze problemen (en veel meer dat we niet hebben behandeld) omvat het kiezen van geschikte algoritmen, hyperparametertuning, featureselectie, omgaan met klasonbalans, enzovoort.
We hebben je (waarschijnlijk) eerste kennismaking met de fascinerende wereld van anomaliedetectie afgerond. De fundamentele concepten en vaardigheden in deze tutorial brengen je al een heel eind bij het verder verkennen van anomaliedetectie.
Om je begrip te verdiepen, zijn hier enkele bronnen om hierna te bekijken:
Verdiep je vandaag nog in anomaliedetectie!
Cursus
Cursus
blog
Adel Nehme
15 min

