
Corso
Rilevamento delle anomalie in Python
4 ore
7.5K
A tutti piace distinguersi, essere diversi. Ma non è questa la qualità che vuoi nei tuoi punti dati quando fai data science. I punti dati divergenti, o anomalie, in un dataset sono uno dei problemi di qualità dei dati più pericolosi che affliggono quasi tutti i progetti.
Questa affermazione potrebbe sorprenderti se hai lavorato solo su dataset open source già ripuliti, che spesso non includono outlier. Tuttavia, i dataset del mondo reale presentano sempre qualche differenza rispetto ai campioni normali. Sta a te rilevarli e gestirli nel modo corretto.
In questo articolo imparerai le idee fondamentali di questo processo, spesso chiamato rilevamento delle anomalie:
Alla fine, avrai padroneggiato i fondamenti del rilevamento delle anomalie e acquisirai la sicurezza per mitigare l'influenza dirompente degli outlier nei tuoi progetti.
Il rilevamento delle anomalie, talvolta chiamato rilevamento degli outlier, è il processo di individuare pattern o istanze in un dataset che deviano in modo significativo dal comportamento atteso o “normale”.
La definizione di dati “normali” e anomali varia sensibilmente a seconda del contesto. Ecco alcuni esempi pratici di rilevamento delle anomalie.
Normale: Acquisti di routine e spese costanti da parte di un individuo a Londra.
Outlier: Un enorme prelievo effettuato dall'Irlanda dallo stesso conto, che lascia intendere un potenziale frode.
Normale: Comunicazioni regolari, trasferimento dati costante e rispetto del protocollo.
Outlier: Aumento improvviso del traffico o uso di protocolli sconosciuti che segnala una potenziale violazione o malware.
Normale: Frequenza cardiaca stabile e pressione sanguigna costante
Outlier: Aumento improvviso della frequenza cardiaca e diminuzione della pressione, che indica una possibile emergenza o un guasto dell'apparecchiatura.
Il rilevamento delle anomalie include molti metodi non supervisionati per identificare campioni divergenti. I professionisti dei dati li scelgono in base al tipo di anomalia, al contesto, alla struttura e alle caratteristiche del dataset in esame. Li vedremo nelle prossime sezioni.
Anche se abbiamo già visto alcuni esempi, vediamo ora una storia reale di come il rilevamento delle anomalie funziona in finanza.
Shaq O'Neal, quattro volte campione NBA, viene scambiato dai Miami Heat ai Phoenix Suns. Quando Shaq arriva nell'appartamento vuoto messo a disposizione dai Phoenix Suns, vuole arredarlo immediatamente nel cuore della notte. Così va al Walmart e tenta l'acquisto più grande nella storia di Walmart per 70.000 dollari. O almeno ci prova; la sua carta viene rifiutata.
Si chiede quale possa essere il problema (di certo non è al verde!). Alle 2 del mattino, la sicurezza di American Express lo chiama e gli dice che la sua carta è stata sospettata come rubata perché qualcuno stava cercando di fare un acquisto da 70.000 dollari al Walmart di Phoenix (guarda l'aneddoto per sentire l'intera storia).
Ci sono tantissime altre applicazioni reali del rilevamento delle anomalie oltre alla finanza e al rilevamento delle frodi:
Il rilevamento delle anomalie è intrecciato in profondità con i servizi che usiamo ogni giorno e spesso non ce ne accorgiamo nemmeno.
I dati sono la risorsa più preziosa nella data science e le anomalie sono le minacce più dirompenti alla loro qualità. Dati di scarsa qualità significano pessimi:
e, in definitiva, fondamenta compromesse per prendere decisioni informate.
Le anomalie distorcono le analisi statistiche introducendo pattern inesistenti, che portano a conclusioni errate e previsioni inaffidabili. Essendo spesso valori estremi in un dataset, le anomalie tendono a alterare le due caratteristiche più importanti delle distribuzioni: media e deviazione standard.
Poiché il funzionamento interno di quasi tutti i modelli di machine learning si basa molto su queste due metriche, un rilevamento tempestivo delle anomalie è cruciale.
Il rilevamento delle anomalie comprende due grandi pratiche: rilevamento degli outlier e rilevamento delle novità.
Gli outlier sono punti dati anomali o estremi che esistono solo nei dati di addestramento. Al contrario, le novità sono istanze nuove o mai viste prima rispetto ai dati originali (di training).
Per esempio, considera un dataset di temperature giornaliere in una città. La maggior parte dei giorni, le temperature vanno da 20 °C a 30 °C. Tuttavia, un giorno c'è un picco di 40 °C. Questa temperatura estrema è un outlier perché devìa in modo significativo dall'intervallo consueto.
Ora immagina che la città installi una nuova stazione meteo più accurata. Di conseguenza, il dataset inizia a registrare costantemente temperature leggermente più alte, tra 25 °C e 35 °C. Questo aumento prolungato è una novità, che rappresenta un nuovo pattern introdotto dal sistema di monitoraggio migliorato.
Anomalie, invece, è un termine ampio che include sia outlier sia novità. Può essere usato per definire qualsiasi istanza anomala in qualsiasi contesto.
Identificare il tipo di anomalie è fondamentale, perché ti permette di scegliere l'algoritmo giusto per rilevarle.
Così come esistono due tipi di anomalie, ci sono anche due tipi di outlier: univariati e multivariati. In base al tipo, useremo diversi algoritmi di rilevamento.
Per esempio, considera un dataset di prezzi delle case in un quartiere. La maggior parte delle case costa tra 200.000 e 400.000 dollari, ma c'è la Casa A con un prezzo eccezionalmente alto di 1.000.000 di dollari. Analizzando solo il prezzo, la Casa A è chiaramente un outlier.
Ora aggiungiamo due variabili al dataset: metratura e numero di camere da letto. Considerando metratura, camere da letto e prezzo, è la Casa B a sembrare strana:
Se guardiamo queste variabili singolarmente, sembrano ordinarie. Solo mettendole insieme scopriamo che la Casa B è chiaramente un outlier multivariato.
Gli algoritmi di rilevamento delle anomalie differiscono in base al tipo di outlier e alla struttura del dataset.
Per il rilevamento di outlier univariati, i metodi più diffusi sono:
Per gli outlier multivariati, in genere usiamo algoritmi di machine learning. Grazie alla loro profondità e potenza, riescono a trovare pattern intricati in dataset complessi:
Oltre al tipo di anomalie, dovresti considerare le caratteristiche del dataset e i vincoli di progetto. Per esempio, Isolation Forest funziona bene su quasi ogni dataset ma è più lento e richiede più calcolo, in quanto metodo a insieme. Al confronto, LOF è molto veloce in addestramento ma potrebbe non performare bene quanto Isolation Forest.
Puoi vedere un confronto dei più comuni algoritmi di rilevamento delle anomalie su 55 dataset dal pacchetto Python Outlier Detection (PyOD).
Come per praticamente qualsiasi compito, esistono molte librerie in Python per eseguire il rilevamento delle anomalie. Le migliori candidate sono:
Mentre scikit-learn offre cinque classici algoritmi di machine learning (che puoi usare sia per outlier univariati che multivariati), PyOD include oltre 30 algoritmi, da metodi semplici come MAD a modelli complessi di deep learning. Puoi anche usare TensorFlow o PyTorch per modelli personalizzati, ma vanno oltre lo scopo di questo articolo.
Preferisco pyod per la sua ricca libreria di algoritmi e un'API coerente con sklearn. Bastano poche righe di codice per trovare ed estrarre outlier da un dataset con PyOD. Ecco un esempio di utilizzo di MAD su un dataset univariato:
import pandas as pd
import seaborn as sns
from pyod.models.mad import MAD

# Load a sample dataset
diamonds = sns.load_dataset("diamonds")
# Extract the feature we want
X = diamonds[["price"]]

# Initialize and fit a model
mad = MAD().fit(X)

# Extract the outlier labels
labels = mad.labels_

>>> pd.Series(labels).value_counts()
0    49708
1     4232
Name: count, dtype: int64
Passiamo il codice riga per riga. Per prima cosa carichiamo le librerie necessarie per la manipolazione dei dati, il caricamento del dataset e pyod per il modello di rilevamento degli outlier. Poi, dopo aver caricato il dataset Diamonds integrato in Seaborn, estraiamo i prezzi dei diamanti.
Quindi inizializziamo e addestriamo in una sola riga un modello MAD (Median Absolute Deviation) su X. Successivamente estraiamo le etichette di inlier e outlier usando l'attributo labels_ di mad in labels.
Quando stampiamo il conteggio dei valori di labels alla fine, vediamo che 49708 appartengono alla categoria 0 (inlier), mentre 4232 alla 1 (outlier). Se vogliamo rimuovere gli outlier dal dataset originale, possiamo usare il subset di pandas su diamonds:
outlier_free = diamonds[labels == 0]

>>> len(outlier_free)
49708
labels == 0 crea un array di valori True/False (array booleano) in cui True indica un inlier.
Il processo per creare un modello multivariato di rilevamento delle anomalie è analogo. Ma il rilevamento di outlier multivariati richiede passaggi aggiuntivi se sono presenti variabili categoriali:
>>> diamonds.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 53940 entries, 0 to 53939
Data columns (total 10 columns):
#   Column   Non-Null Count  Dtype
---  ------   --------------  -----
0   carat    53940 non-null  float64
1   cut      53940 non-null  category
2   color    53940 non-null  category
3   clarity  53940 non-null  category
4   depth    53940 non-null  float64
5   table    53940 non-null  float64
6   price    53940 non-null  int64
7   x        53940 non-null  float64
8   y        53940 non-null  float64
9   z        53940 non-null  float64
dtypes: category(3), float64(6), int64(1)
memory usage: 3.0 MB
Dato che pyod si aspetta tutte le feature numeriche, dobbiamo codificare le variabili categoriali. Useremo Sklearn per farlo:
from sklearn.preprocessing import OrdinalEncoder

# Initialize the encoder
oe = OrdinalEncoder()

# Extract the categorical feature names
cats = diamonds.select_dtypes(include="category").columns.tolist()

# Encode the categorical features
cats_encoded = oe.fit_transform(diamonds[cats])

# Replace the old values with encoded values
diamonds.loc[:, cats] = cats_encoded

>>> diamonds.head()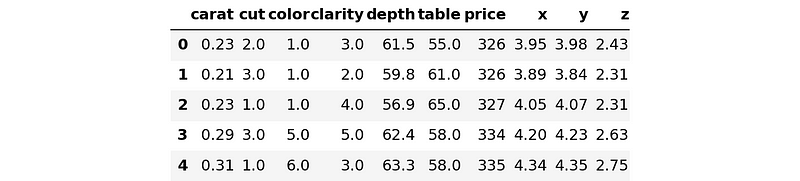
Rivediamo il codice riga per riga. Innanzitutto importiamo la classe OrdinalEncoder, che codifica le feature categoriali ordinali, e la inizializziamo. Le feature ordinali sono variabili con categorie naturali e ordinate, come nel caso delle misure di qualità dei diamanti. Il taglio (cut) e la purezza (clarity) sono ordinali, mentre il colore no. Ma per non complicare, lo considereremo ordinale per ora.
Quindi estraiamo i nomi delle feature categoriali usando il metodo select_dtypes dei DataFrame Pandas. Incateniamo gli attributi .columns e .tolist() per ottenere i nomi delle colonne in una lista chiamata cats.
Poi usiamo la lista per trasformare le feature desiderate con oe. Infine, con un comodo trucco di Pandas usando .loc, sostituiamo i vecchi valori testuali con quelli numerici.
Prima di addestrare un modello multivariato, estrarremo l'array di feature X. Lo scopo del dataset diamonds è prevedere il prezzo dei diamanti date le loro caratteristiche. Quindi, X conterrà tutte le colonne tranne price:
X = diamonds.drop("price", axis=1)
y = diamonds[["price"]]
Now, let’s build and fit the model:
from pyod.models.iforest import IForest

# Create a model with 10000 trees
iforest = IForest(n_estimators=10000)
iforest.fit(X)  # This will take a minute

# Extract the labels
labels = iforest.labels_
Più alberi ha lo stimatore IForest, più tempo richiede per adattarsi al dataset.
Dopo aver ottenuto le etichette, possiamo rimuovere gli outlier dai dati originali:
X_outlier_free = X[labels == 0]
y_outlier_free = X[labels == 0]

>>> len(X_outlier_free)
48546

>>> # The length of the original dataset
>>> len(diamonds)
53940
Il modello ha trovato oltre 5000 outlier!
Il rilevamento delle anomalie può presentare sfide maggiori rispetto ad altri compiti di machine learning a causa della sua natura non supervisionata. Tuttavia, la maggior parte di queste sfide può essere mitigata con vari metodi (vedi la prossima sezione per le risorse).
Nel rilevamento degli outlier, dobbiamo porci due domande:
Nel learning supervisionato, possiamo verificare facilmente se il modello funziona bene confrontando le sue previsioni sui dati di test con le etichette reali. Ma non possiamo fare lo stesso nel rilevamento degli outlier, perché non ci sono etichette pronte all'uso che ci dicano quali campioni sono inlier e quali outlier.
Quindi, alcuni o molti dei +5000 outlier trovati nel dataset dei diamanti potrebbero non essere realmente outlier! Non c'è modo di saperlo con certezza. Potrebbe aver etichettato alcuni inlier come outlier e allo stesso tempo aver perso alcuni outlier reali.
Questo problema di non conoscere il livello di contaminazione (la percentuale di outlier in un dataset) è il più grande nel rilevamento delle anomalie. Per questo non possiamo misurare affidabilmente le prestazioni dei classificatori di outlier, né verificare i loro risultati.
Per questo motivo, tutti gli stimatori in pyod hanno un parametro chiamato contamination, impostato di default a 0,1. Come machine learning engineer, devi regolare tu stesso questo parametro.
Certo, a volte ci sono alternative. Per esempio, il modello IsolationForest offerto da Sklearn ha un algoritmo interno per trovare automaticamente il livello di contaminazione. Ma IsolationForest non è una bacchetta magica per tutti i problemi di rilevamento degli outlier.
Un'altra criticità nel rilevamento delle anomalie è lo sbilanciamento dei dati. Le anomalie sono spesso rare rispetto alle istanze normali, causando dataset sbilanciati. Questo squilibrio può rendere difficile distinguere tra vere anomalie e irregolarità all'interno della classe maggioritaria.
Affrontare questi problemi (e molti altri che non abbiamo trattato) richiede la scelta di algoritmi adatti, il tuning degli iperparametri, la selezione delle feature, la gestione dello sbilanciamento delle classi e così via.
Abbiamo concluso la tua (probabile) prima introduzione al mondo affascinante del rilevamento delle anomalie. I concetti e le competenze fondamentali di questo tutorial possono portarti lontano nell'esplorazione dell'argomento.
Per approfondire, ecco alcune risorse da consultare:
Approfondisci oggi la tua comprensione del rilevamento delle anomalie!
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



