
Khóa học
Phát hiện bất thường với Python
4 giờ
7.5K
Ai cũng thích nổi bật, khác biệt. Nhưng đó lại không phải phẩm chất bạn muốn thấy ở các điểm dữ liệu khi làm khoa học dữ liệu. Các điểm dữ liệu lệch chuẩn hay dị thường trong một tập dữ liệu là một trong những vấn đề chất lượng dữ liệu nguy hiểm nhất, đe dọa hầu như mọi dự án dữ liệu.
Câu vừa rồi có thể khiến bạn ngạc nhiên nếu bạn chỉ làm việc với các tập dữ liệu nguồn mở đã được xử lý bóng bẩy, thường không có ngoại lệ. Tuy nhiên, dữ liệu thế giới thực luôn có những sai khác so với các mẫu bình thường. Nhiệm vụ của bạn là phát hiện và xử lý chúng một cách phù hợp.
Trong bài viết này, bạn sẽ học những ý tưởng nền tảng của quy trình này, thường được gọi là phát hiện dị thường:
Kết thúc bài, bạn sẽ nắm vững những điều cơ bản về phát hiện dị thường và tự tin giảm thiểu ảnh hưởng gây nhiễu của các ngoại lệ trong dự án của mình.
Phát hiện dị thường, đôi khi còn gọi là phát hiện ngoại lệ, là quá trình tìm các mẫu hoặc các trường hợp trong một tập dữ liệu lệch đáng kể so với hành vi mong đợi hay “bình thường”.
Định nghĩa về dữ liệu “bình thường” và dị thường thay đổi đáng kể theo ngữ cảnh. Dưới đây là vài ví dụ thực tế về phát hiện dị thường.
Bình thường: Các khoản mua sắm thường nhật và chi tiêu nhất quán của một cá nhân ở London.
Ngoại lệ: Một khoản rút tiền khổng lồ từ Ireland bằng cùng tài khoản đó, gợi ý khả năng gian lận.
Bình thường: Giao tiếp đều đặn, truyền dữ liệu ổn định và tuân thủ giao thức.
Ngoại lệ: Tăng đột ngột lượng dữ liệu truyền hoặc sử dụng các giao thức không rõ, báo hiệu khả năng bị xâm nhập hoặc có phần mềm độc hại.
Bình thường: Nhịp tim ổn định và huyết áp đều
Ngoại lệ: Nhịp tim tăng đột ngột và huyết áp giảm, cho thấy khả năng cấp cứu hoặc hỏng thiết bị.
Phát hiện dị thường bao gồm nhiều phương pháp không giám sát để nhận diện các mẫu lệch. Chuyên gia dữ liệu sẽ chọn dựa trên loại dị thường, bối cảnh, cấu trúc và đặc điểm của tập dữ liệu đang xử lý. Chúng ta sẽ bàn ở các phần tiếp theo.
Dù ở trên ta đã xem vài ví dụ, hãy cùng nhìn vào một câu chuyện đời thực về cách phát hiện dị thường hoạt động trong tài chính.
Shaq O’Neal, nhà vô địch NBA bốn lần, được chuyển nhượng từ Miami Heat sang Phoenix Suns. Khi Shaq đến căn hộ trống do Phoenix Suns cung cấp, anh muốn ngay lập tức sắm sửa đồ đạc giữa đêm. Vậy là anh ra Walmart và thực hiện giao dịch mua lớn nhất trong lịch sử Walmart trị giá 70.000 đô la. Hoặc ít nhất, anh cố gắng làm vậy; thẻ của anh bị từ chối.
Anh tự hỏi vấn đề có thể là gì (chẳng lẽ anh hết tiền!). Lúc 2 giờ sáng, bộ phận an ninh của American Express gọi cho anh và thông báo thẻ của anh bị nghi đánh cắp vì có ai đó đang cố gắng thanh toán 70.000 đô la tại Walmart ở Phoenix (xem giai thoại để nghe toàn bộ câu chuyện).
Còn rất nhiều ứng dụng thực tế khác của phát hiện dị thường ngoài tài chính và phát hiện gian lận:
Phát hiện dị thường được đan cài sâu vào các dịch vụ hàng ngày mà chúng ta sử dụng, và thường thì chúng ta không hề nhận ra.
Dữ liệu là tài sản quý giá nhất trong khoa học dữ liệu, và dị thường là mối đe dọa gây xáo trộn lớn nhất đối với chất lượng dữ liệu. Dữ liệu kém chất lượng dẫn đến kém chất lượng ở:
và cuối cùng là một nền tảng bị tổn hại cho việc ra quyết định dựa trên thông tin.
Dị thường làm méo mó các phân tích thống kê bằng cách đưa vào các mẫu không tồn tại, dẫn đến kết luận sai và dự báo thiếu tin cậy. Vì thường là các giá trị cực đoan trong tập dữ liệu, dị thường hay làm lệch hai đặc trưng quan trọng nhất của phân phối: trung bình và độ lệch chuẩn.
Do nội tại của gần như mọi mô hình học máy dựa mạnh vào hai thước đo này, phát hiện kịp thời các dị thường là rất quan trọng.
Phát hiện dị thường bao trùm hai thực hành lớn: phát hiện ngoại lệ (outlier) và phát hiện tính mới (novelty).
Outlier là những điểm dữ liệu bất thường hoặc cực đoan chỉ tồn tại trong dữ liệu huấn luyện. Ngược lại, novelty là những trường hợp mới hoặc chưa từng thấy so với dữ liệu gốc (dữ liệu huấn luyện).
Ví dụ, xét một tập dữ liệu nhiệt độ hàng ngày của một thành phố. Hầu hết các ngày, nhiệt độ dao động trong khoảng 20°C đến 30°C. Tuy nhiên, có một ngày nhiệt độ tăng vọt lên 40°C. Nhiệt độ cực đoan này là một outlier vì nó lệch đáng kể so với khoảng nhiệt độ thường ngày.
Giờ hãy tưởng tượng thành phố lắp một trạm theo dõi thời tiết mới chính xác hơn. Kết quả là tập dữ liệu bắt đầu ghi nhận nhất quán mức nhiệt nhỉnh hơn, dao động từ 25°C đến 35°C. Mức tăng kéo dài này là một novelty, đại diện cho một mẫu mới do hệ thống theo dõi được cải thiện đưa vào.
Anomalies, ngược lại, là một thuật ngữ rộng bao gồm cả outliers và novelties. Nó có thể dùng để chỉ bất kỳ trường hợp bất thường nào trong bất kỳ ngữ cảnh nào.
Nhận diện loại dị thường là rất quan trọng vì nó cho phép bạn chọn đúng thuật toán để phát hiện chúng.
Vì có hai loại dị thường, cũng có hai loại outlier: đơn biến và đa biến. Tùy loại, chúng ta sẽ dùng các thuật toán phát hiện khác nhau.
Ví dụ, xét một tập dữ liệu giá nhà trong một khu phố. Hầu hết các căn có giá từ 200.000 đến 400.000 đô la, nhưng có Nhà A với mức giá cực cao 1.000.000 đô la. Khi chỉ phân tích giá, Nhà A là một outlier rõ ràng.
Giờ, hãy thêm hai biến nữa vào tập dữ liệu: diện tích (square footage) và số phòng ngủ. Khi xét đồng thời diện tích, số phòng ngủ và giá, Nhà B lại trông kỳ lạ:
Khi nhìn từng biến riêng lẻ, chúng có vẻ bình thường. Chỉ khi ghép chúng lại, ta mới phát hiện Nhà B là một outlier đa biến rõ rệt.
Các thuật toán phát hiện dị thường khác nhau tùy theo loại outlier và cấu trúc của tập dữ liệu.
Với phát hiện outlier đơn biến, các phương pháp phổ biến nhất là:
Với outlier đa biến, ta thường dùng các thuật toán học máy. Nhờ chiều sâu và sức mạnh, chúng có thể tìm các mẫu tinh vi trong tập dữ liệu phức tạp:
Ngoài loại dị thường, bạn nên cân nhắc đặc điểm tập dữ liệu và ràng buộc dự án. Ví dụ, Isolation Forest hoạt động tốt trên hầu như mọi tập dữ liệu nhưng chậm và tốn tính toán do là phương pháp tổ hợp. So với đó, LOF huấn luyện rất nhanh nhưng có thể không hiệu quả bằng Isolation Forest.
Bạn có thể xem so sánh các thuật toán Phát hiện Dị thường phổ biến trên 55 tập dữ liệu từ gói Python Outlier Detection (PyOD).
Giống như hầu hết tác vụ khác, có nhiều thư viện Python để thực hiện phát hiện dị thường. Những lựa chọn tốt nhất là:
Trong khi scikit-learn cung cấp năm thuật toán học máy kinh điển (bạn có thể dùng cho cả outlier đơn biến và đa biến), PyOD bao gồm hơn 30 thuật toán, từ các phương pháp đơn giản như MAD đến các mô hình học sâu phức tạp. Bạn cũng có thể dùng TensorFlow hoặc PyTorch cho mô hình tùy chỉnh, nhưng chúng nằm ngoài phạm vi bài viết.
Tôi ưu tiên pyod vì thư viện thuật toán phong phú và API nhất quán với sklearn. Chỉ cần vài dòng mã là có thể tìm và trích xuất outlier khỏi một tập dữ liệu bằng PyOD. Đây là ví dụ dùng MAD trên một tập dữ liệu đơn biến:
import pandas as pd
import seaborn as sns
from pyod.models.mad import MAD

# Load a sample dataset
diamonds = sns.load_dataset("diamonds")
# Extract the feature we want
X = diamonds[["price"]]

# Initialize and fit a model
mad = MAD().fit(X)

# Extract the outlier labels
labels = mad.labels_

>>> pd.Series(labels).value_counts()
0    49708
1     4232
Name: count, dtype: int64
Hãy đi qua từng dòng mã. Đầu tiên, ta nạp các thư viện cần thiết để thao tác dữ liệu, tải tập dữ liệu và pyod cho mô hình phát hiện outlier. Sau đó, sau khi tải tập Diamonds tích hợp trong Seaborn, ta trích xuất giá kim cương.
Tiếp theo, ta khởi tạo và fit mô hình Median Absolute Deviation (MAD) cho X trong một dòng. Kế đó, ta trích xuất nhãn inlier và outlier bằng thuộc tính labels_ của mad vào biến labels.
Khi in số lần xuất hiện của labels ở cuối, ta thấy 49708 thuộc hạng mục 0 (inlier) trong khi 4232 thuộc 1 (outlier). Nếu muốn loại bỏ outlier khỏi tập dữ liệu gốc, ta có thể dùng phép chọn lọc của pandas trên diamonds:
outlier_free = diamonds[labels == 0]

>>> len(outlier_free)
49708
labels == 0 tạo một mảng True/False (mảng boolean) trong đó True biểu thị một inlier.
Quy trình tạo mô hình phát hiện dị thường đa biến cũng tương tự. Nhưng phát hiện outlier đa biến đòi hỏi các bước xử lý bổ sung nếu có đặc trưng phân loại:
>>> diamonds.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 53940 entries, 0 to 53939
Data columns (total 10 columns):
#   Column   Non-Null Count  Dtype
---  ------   --------------  -----
0   carat    53940 non-null  float64
1   cut      53940 non-null  category
2   color    53940 non-null  category
3   clarity  53940 non-null  category
4   depth    53940 non-null  float64
5   table    53940 non-null  float64
6   price    53940 non-null  int64
7   x        53940 non-null  float64
8   y        53940 non-null  float64
9   z        53940 non-null  float64
dtypes: category(3), float64(6), int64(1)
memory usage: 3.0 MB
Vì pyod kỳ vọng mọi đặc trưng đều là số, ta cần mã hóa các biến phân loại. Ta sẽ dùng Sklearn để làm việc này:
from sklearn.preprocessing import OrdinalEncoder

# Initialize the encoder
oe = OrdinalEncoder()

# Extract the categorical feature names
cats = diamonds.select_dtypes(include="category").columns.tolist()

# Encode the categorical features
cats_encoded = oe.fit_transform(diamonds[cats])

# Replace the old values with encoded values
diamonds.loc[:, cats] = cats_encoded

>>> diamonds.head()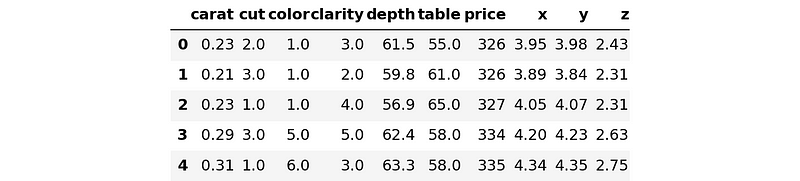
Cùng đi qua từng dòng mã lần nữa. Đầu tiên, ta nhập lớp OrdinalEncoder để mã hóa các đặc trưng phân loại thứ bậc và khởi tạo nó. Đặc trưng thứ bậc là các biến có các hạng mục có thứ tự tự nhiên như trong các phép đo chất lượng kim cương. Cut và clarity là thứ bậc, còn color thì không. Nhưng để tránh phức tạp, ta sẽ tạm coi nó là thứ bậc.
Sau đó, ta trích tên các đặc trưng phân loại bằng phương thức select_dtypes của DataFrame Pandas. Ta xâu chuỗi thuộc tính .columns và .tolist() để lấy tên cột trong một danh sách tên là cats.
Tiếp theo, ta dùng danh sách này để biến đổi các đặc trưng mong muốn với oe. Cuối cùng, dùng một mẹo hay của Pandas với .loc, ta thay thế các giá trị văn bản cũ bằng các giá trị số.
Trước khi fit mô hình đa biến, ta sẽ trích mảng đặc trưng X. Mục đích của tập diamonds là dự đoán giá kim cương dựa trên các đặc điểm của nó. Vì vậy, X sẽ chứa tất cả các cột ngoại trừ price:
X = diamonds.drop("price", axis=1)
y = diamonds[["price"]]
Now, let’s build and fit the model:
from pyod.models.iforest import IForest

# Create a model with 10000 trees
iforest = IForest(n_estimators=10000)
iforest.fit(X)  # This will take a minute

# Extract the labels
labels = iforest.labels_
Càng nhiều cây, bộ ước lượng IForest càng mất nhiều thời gian để fit mô hình với tập dữ liệu.
Sau khi có nhãn, ta có thể loại outlier khỏi dữ liệu gốc:
X_outlier_free = X[labels == 0]
y_outlier_free = X[labels == 0]

>>> len(X_outlier_free)
48546

>>> # The length of the original dataset
>>> len(diamonds)
53940
Mô hình đã tìm ra hơn 5000 outlier!
Phát hiện dị thường có thể đặt ra những thách thức lớn hơn các tác vụ học máy khác do tính chất không giám sát của nó. Tuy vậy, hầu hết các thách thức này có thể được giảm nhẹ bằng nhiều phương pháp (xem phần tiếp theo để biết tài nguyên).
Trong phát hiện outlier, chúng ta cần đặt hai câu hỏi:
Trong học có giám sát, ta có thể dễ dàng kiểm tra mô hình hoạt động tốt không bằng cách so sánh dự đoán trên dữ liệu kiểm tra với các nhãn thực. Nhưng ta không thể làm vậy trong phát hiện outlier vì không có sẵn nhãn cho biết mẫu nào là inlier, mẫu nào là outlier.
Vì vậy, một phần hay thậm chí phần lớn hơn 5000 outlier tìm được từ tập diamonds có thể thực ra không phải outlier! Không có cách nào biết chắc. Mô hình có thể đã gán nhãn một số inlier thành outlier đồng thời bỏ sót một số outlier thực.
Vấn đề không biết mức ô nhiễm (tỷ lệ outlier trong một tập dữ liệu) là thách thức lớn nhất trong phát hiện dị thường. Do đó, ta không thể đo lường đáng tin cậy hiệu năng của các bộ phân loại outlier, cũng không thể kiểm chứng kết quả của chúng.
Vì lý do này, mọi bộ ước lượng trong pyod đều có tham số contamination, mặc định là 0,1. Là kỹ sư học máy, bạn phải tự tinh chỉnh tham số này.
Dĩ nhiên, đôi khi có lựa chọn thay thế. Ví dụ, mô hình IsolationForest do Sklearn cung cấp có thuật toán nội bộ để tự động tìm mức ô nhiễm. Nhưng IsolationForest không phải là “viên đạn bạc” cho mọi bài toán phát hiện outlier.
Một vấn đề khác trong phát hiện dị thường là mất cân bằng dữ liệu. Dị thường thường hiếm so với các trường hợp bình thường, khiến tập dữ liệu bị mất cân bằng. Sự mất cân bằng này gây khó khăn trong việc phân biệt giữa dị thường thực sự và những bất thường trong lớp đa số.
Giải quyết những vấn đề này (và nhiều điều khác chưa đề cập) bao gồm chọn thuật toán phù hợp, tinh chỉnh siêu tham số, chọn đặc trưng, xử lý mất cân bằng lớp, v.v.
Chúng ta đã kết thúc lần chạm ngõ (có lẽ) đầu tiên của bạn với thế giới hấp dẫn của phát hiện dị thường. Các khái niệm và kỹ năng nền tảng trong hướng dẫn này sẽ giúp bạn tiến xa hơn khi khám phá phát hiện dị thường.
Để đào sâu hiểu biết của bạn, đây là một số tài nguyên nên xem tiếp:
Đào sâu Hiểu biết về Phát hiện Dị thường Ngay hôm nay!
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
