

Gebruik de Kimi K3.1 Pro API om een Image-to-CAD-agent te bouwen
Een image-to-CAD-agent zet afbeeldingen van een onderdeel om in een CAD-model dat je kunt bewerken.
Waarom Kimi K3.1 Pro en CadQuery passen bij image-to-CAD
Kimi K3.1 Pro kan vier afbeeldingen lezen en vervolgens reageren op wat zijn eigen code oplevert. Dezelfde Moonshot-blog die ik eerder noemde, rapporteert 92,7% met tools en 72.8% zonder op BenchCAD’s Vision2Code-taak, waarmee CAD-code wordt beoordeeld die is geschreven op basis van gerenderde aanzichten van een onderdeel. Die cijfers komen uit een subset van 1.000 cases op max-inspanning, en de score met tools gebruikte de Claude Code harness, zo een deel van die score kan aan de harness toebehoren.
De benchmark stuurt ook alle vier de aanzichten in één afbeelding en schaalt elk onderdeel vooraf naar dezelfde grootte. De mijne stuurt vier losse aanzichten plus één echte maat op high-inspanning, dus neem Moonshots getal als een reden om de test te draaien in plaats van als het resultaat. Toen ik deze proeven draaide, waren de open weights nog niet te downloaden.
CadQuery is het outputformaat omdat een CadQuery-script zelf een parametrisch model is. Een gat is een aanroep met een diameter en een positie, dus een latere bewerking wijzigt één getal en het solide model wordt opnieuw opgebouwd. Een STL-bestand geeft je driehoeken, en er is geen slot_width om te veranderen.
Wat de agent ziet en wat verborgen blijft
Kimi krijgt de vier referentiebeelden, de breedte van 60 mm en een systeemprompt. Die prompt legt millimeters en de assen vast, centreert het onderdeel op X en Y met de onderzijde op Z=0, en vraagt om benoemde afmetingen en een uiteindelijke solid in result.
Daarna weet Kimi alleen wat zijn tools terugrapporteren. De Kimi-API draait CadQuery niet, dus alle vier de tools leven in de applicatie:
-
execute_caddraait een programma in een Docker-container zonder netwerk en slaat het resultaat op als kandidaat -
inspect_cadrapporteert validiteit, aantal solids, bounding box, volume en cilindrische vlakken -
render_cadtekent de kandidaat vanuit dezelfde vier camera’s als de referentie -
submit_cadbeëindigt een fase met één kandidaat
Kimi ziet nooit de referentiecode of een score. De evaluator leest pas opgeslagen STEP-bestanden nadat de agent klaar is, zodat een score de agent niet kan sturen of stoppen.
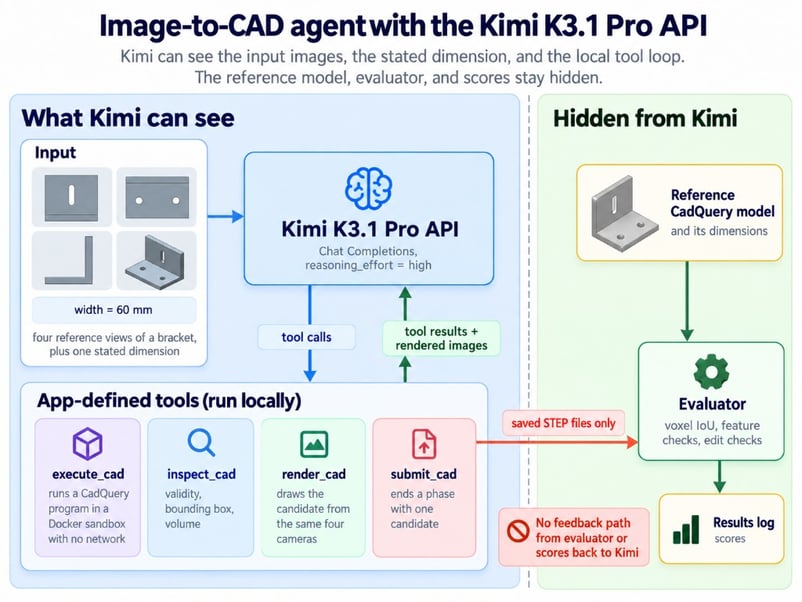 Scores stromen nooit terug naar Kimi. Afbeelding door auteur.
Installeer de Kimi K3.1 Pro API in Python
Om de Kimi K3.1 Pro API in Python te gebruiken, heb je vier dingen nodig. Ik testte alles op Linux x86_64 met deze versies:
-
Een Kimi API-sleutel met minstens $1 tegoed, volgens de K3.1 Pro-quickstart
-
Python 3.12.3 met
openai3.39.0, de OpenAI SDK -
cadquery2.8.0 voor het bouwen en controleren van solids -
Docker 29.9.2 voor de sandbox
De onderstaande snippets zijn uittreksels uit het volledige project in deze GitHub-repository, die je zo gaat clonen.
Installeer CadQuery en bouw de Docker-sandbox
De installatiegids van CadQuery geeft de voorkeur aan conda, al werkt pip op Python 3.12 ook. Clone de repository en richt deze in:
git clone https://github.com/KhalidAbdelaty/Kimi_K3.1_Pro_API_Tutorial.git
cd Kimi_K3.1_Pro_API_Tutorial
python -m venv .venv
source .venv/bin/activate # Windows: .venv\Scripts\Activate.ps1
pip install -r requirements.txt
cp .env.example .env # then add your MOONSHOT_API_KEY
docker build -t cad-sandbox:2.8.0 sandbox/Het sandbox-image installeert dezelfde CadQuery-versie en draait als een gewone gebruiker. Docker stelt standaard geen CPU- of geheugengrenzen in, volgens de documentatie over resourcebeperkingen, dus de runner stelt die in. Op de voorpagina van de repository staan de commando’s om het experiment te draaien en te scoren, inclusief een pad zonder API-sleutel of Docker.
Voordat Kimi’s code ooit de container bereikt, probeer je hem zelf te breken. Mijn testprogramma probeerde de API-sleutel te lezen, het netwerk te benaderen en buiten zijn tijdelijke map te schrijven, en alle drie de pogingen faalden.
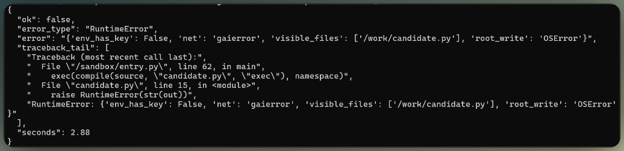
Drie geblokkeerde operaties in de sandbox. Afbeelding door auteur.
Doe je eerste Kimi K3.1 Pro API-aanroep
Dit is de reguliere OpenAI SDK, gericht op Moonshots endpoint. Zet reasoning_effort op elke aanvraag, want als je die weglaat, krijg je max, en je kunt het denken niet uitzetten.
client = OpenAI(api_key=os.environ["MOONSHOT_API_KEY"], base_url="https://api.moonshot.ai/v1")
response = client.chat.completions.create(
model="kimi-k3.1-pro",
reasoning_effort="high", # low, high, or max; the API default is max
max_completion_tokens=2048, # reasoning and answer share this cap
messages=[{"role": "user", "content": "In one sentence, what does a STEP file store?"}],
)
print(response.choices[0].message.content)
print("usage:", response.usage.model_dump(exclude_none=True))Laat temperature, top_p, n en beide penalties weg, die in de quickstart als vast genoemd worden. Zelfs een éénzinsantwoord zoals dit besteedt het grootste deel van zijn completion tokens aan redeneren, dus kies de cap met dat in gedachten.
Eén verzoek bevestigt sleutel en model. Afbeelding door auteur.
Als de Kimi-API nieuw voor je is, behandelt mijn eerdere Kimi K3-tutorial streaming, tool calling, caching en vision input.
Maak een referentie-CAD-model en vier testaanzichten
Een referentie-CAD-model is je antwoordmodel, zodat elke score iets exacts heeft om mee te vergelijken. Ik legde de mijne vast vóór het eerste verzoek, van de camera’s tot de beoordelingsregels, en ik veranderde niets nadat ik resultaten had gezien.
Definieer de afmetingen van de beugel
De beugel is een L, met het opstaande deel aan de achterkant van de voetplaat verbonden. De oorsprong ligt in het midden van het onderste vlak, met X over de breedte, de voorkant richting −Y en Z omhoog:
|
Feature |
Waarde |
Getoond aan Kimi? |
|
Totale breedte (X) |
60 mm |
Ja |
|
Diepte voetplaat (Y) |
40 mm |
Nee |
|
Totale hoogte (Z) |
45 mm |
Nee |
|
Plaatdikte |
6 mm |
Nee |
|
Montagegaten |
2 × Ø6,5 mm, 34 mm uit elkaar, op Y = −3 mm |
Nee |
|
Opstaande sleuf |
6 mm breed, 20 mm van uiteinde tot uiteinde, gecentreerd op X = 0, Z = 25,5 mm |
Nee |
Ik plaatste de rij gaten en de sleuf midden op hun vlakken en gebruikte 6,5 mm gaten, een gangbare M6-spelingmaat, omdat een echte beugel dat zou hebben. Die keuze bleek het zwakke punt van deze beugel, en we komen zo op het waarom.
In de build-functie bewaren w, dep, h en t de breedte, diepte, hoogte en dikte. Hij voegt de twee platen samen en snijdt de features uit:
base = cq.Workplane("XY").box(w, dep, t, centered=(True, True, False))
upright = cq.Workplane("XY").center(0, dep / 2 - t / 2).box(w, t, h, centered=(True, True, False))
holes = cq.Workplane("XY").pushPoints([(-17, -3), (17, -3)]).circle(3.25).extrude(t)
slot = (cq.Workplane("XZ", origin=(0, dep / 2 - t / 2, 0)).center(0, 25.5)
.slot2D(20, 6, 90) # end-to-end length, width, angle
.extrude(t, both=True))
result = base.union(upright).cut(holes).cut(slot)Het script controleert op één geldige solid van de verwachte maat voordat het een STEP-bestand exporteert.
Render vier aanzichten met vaste camera’s
Een kleine NumPy-renderer tekent voor-, boven-, rechter- en isometrische aanzichten met exact dezelfde framing voor de referentie en elke kandidaat. Op 512 px dekt één pixel ongeveer 0,19 mm, al kan een aflezing uit het beeld meer afwijken. Vaste framing zorgt er ook voor dat een kandidaat die te groot is of verkeerd gepositioneerd direct niet klopt, in plaats van opnieuw gecentreerd te worden.
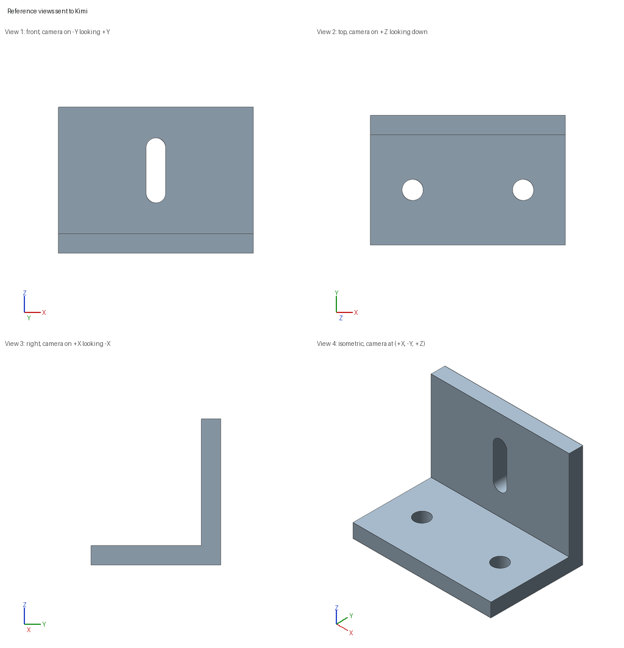
De vier afbeeldingen die naar Kimi zijn gestuurd. Afbeelding door auteur.
Stel de beoordelingsregels vast vóór het draaien van de agent
De evaluator meet de geëxporteerde solid, dus parameternamen kunnen hem niet misleiden. Hij snijdt elk STEP-bestand om de gaten, de sleuf en beide plaatdiktes te vinden, en berekent voxel-IoU, het aandeel volume dat twee solids gemeen hebben, op een raster van 0,5 mm op ware grootte. Toleranties volgen de pixelschaal: ±0,5 mm voor diktes, gatdiameters en sleufbreedte, en ±1 tot ±1,5 mm voor lengtes en posities die uit beelden worden afgelezen.
IoU alleen is niet genoeg. Ik vind het een bot getal, en ik blijf het gebruiken omdat niets eenvoudigers twee solids vergelijkt. Een kale L zonder gaten en sleuf scoort nog steeds boven 0,96, en het juiste onderdeel dat 20% te groot is gemaakt, scoort een perfecte 1,0 zodra beide naar dezelfde maat zijn geschaald.
Daarom komt elke score hier met 13 checks die slagen of falen. Zelfs een perfecte 1,0 betekent alleen dat twee solids op dat raster overeenkomen, niet tot op elke micron, en geen van deze cijfers is een fabricagegarantie.
Genereer CadQuery-code uit afbeeldingen met Kimi K3.1 Pro
De eerste kandidaat komt uit één verzoek zonder tools, en draait precies zoals teruggestuurd.
Stuur vier referentieaanzichten naar de Kimi K3.1 Pro API
Kimi’s vision input accepteert base64 data-URL’s binnen een content-array, en accepteert geen publieke afbeeldings-URL’s. De systeemprompt bevat de framing- en naamgevingsregels die ik eerder beschreef, en het user-bericht draagt de vier PNG’s en deze prompt:
These four images show one mechanical part, a bracket. Each view uses orthographic
projection, and all four use the same scale. The camera for each view is written at the
top of the image, and a small axis triad sits in the lower-left corner.
The overall width of the part along X is 60 mm. No other dimension is given, so estimate
the rest from the images.
Write one CadQuery program that rebuilds this part as an editable parametric model.
Return the complete program in a single python code block.Het verzoek zelf is kort:
images = [image_part(path) for path in view_paths] # four PNGs as base64 data URLs
messages.append({"role": "user", "content": images + [{"type": "text", "text": BASELINE_PROMPT}]})
response = client.chat.completions.create(
model="kimi-k3.1-pro", reasoning_effort="high",
max_completion_tokens=32_768, messages=messages,
)Om de invoergrootte te controleren voordat je betaalt, stuur je dezelfde berichten naar de tokenraming-endpoint, waarvan de schatting vrijwel exact overeenkwam met de rekening. Vier afbeeldingen van 512 px komen uit op minder dan 2.000 inputtokens.
Draai het eerste CadQuery-programma in een sandbox
De runner schrijft de code naar een tijdelijke map en start een wegwerpcontainer met het docker run-commando:
cmd = ["docker", "run", "--rm", "--network", "none", "--read-only",
"--tmpfs", "/tmp:size=64m", "--cap-drop", "ALL",
"--security-opt", "no-new-privileges",
"--memory", "1g", "--cpus", "1", "--pids-limit", "128",
"-v", f"{work}:/work", "cad-sandbox:2.8.0"]
subprocess.run(cmd, capture_output=True, text=True, timeout=60)In de eerste proef duurde Kimi’s antwoord ongeveer een minuut. Het programma benoemde elke afmeting in de verborgen referentie, van bracket_depth = 40.0 tot slot_center_z = 25.5. Het produceerde een geldige solid en slaagde voor elke check.
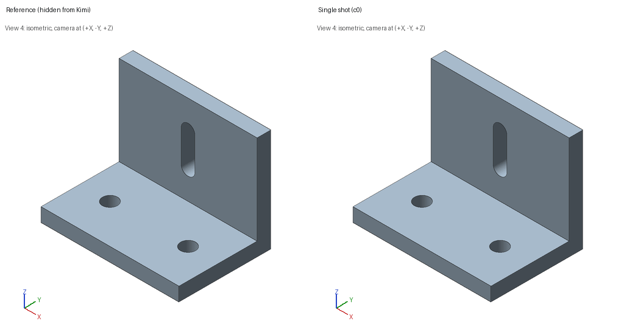
Zelfde camera, zelfde schaal, overeenkomende onderdelen. Afbeelding door auteur.
Een perfecte eerste poging liet me controleren op een lek, maar de PNG’s dragen geen metadata en geen enkele prompt bevat een verborgen waarde. Kimi’s code verklaart het resultaat. Zoals ik bij het definiëren van de beugel al zei, zitten de features waar een ontwerper ze zou plaatsen, en Kimi deed dat ook.
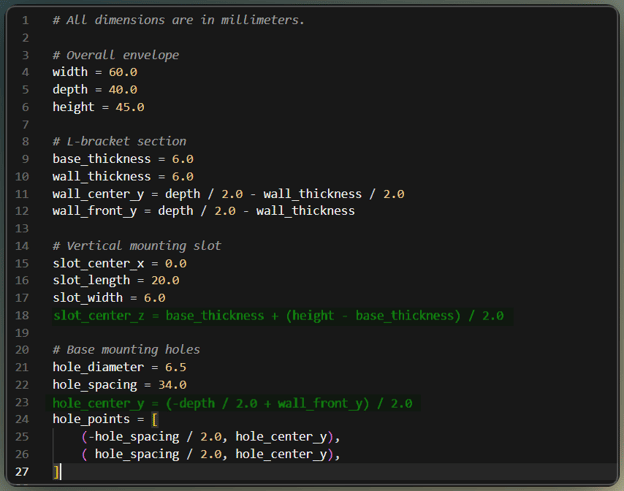
Kimi leidt featureposities af uit middenpunten. Afbeelding door auteur.
Bouw een zelfcontrolerende tool-calling agent met Kimi K3.1 Pro
Een tool-calling-agent draait in een lus. Kimi vraagt om een tool, jouw code draait die, en het resultaat gaat terug als een toolbericht totdat Kimi klaar is.
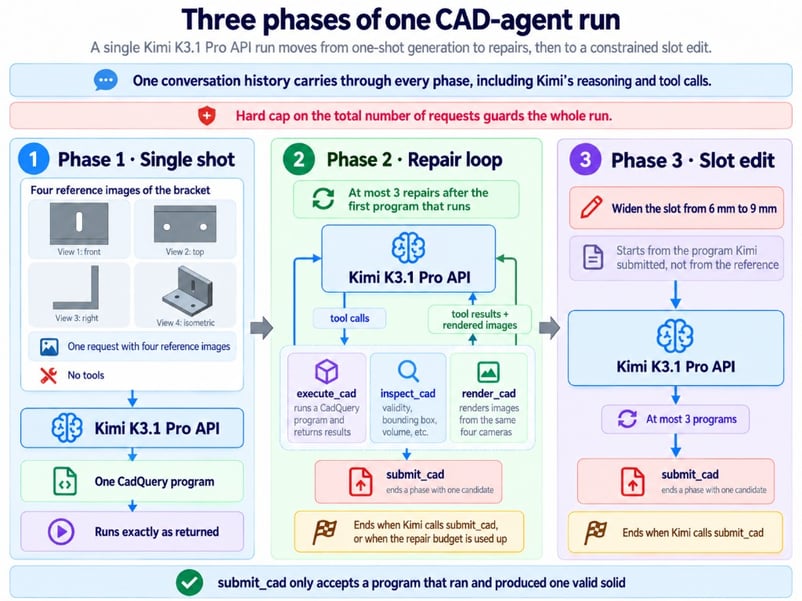
Drie fasen, elk met harde limieten. Afbeelding door auteur.
Definieer tools om CAD uit te voeren, te inspecteren en te renderen
Hier is execute_cad als schema. Het retourneert een kort resultaat in een vast formaat, met de laatste paar traceback-regels wanneer een programma faalt:
{"type": "function", "function": {
"name": "execute_cad",
"description": "Run a complete CadQuery program in an isolated sandbox. Returns a "
"candidate id, whether it ran, and a short error if it did not.",
"parameters": {"type": "object", "properties": {
"code": {"type": "string",
"description": "The complete program. It must assign the final solid to result."}},
"required": ["code"]}}}render_cad retourneert zijn vier afbeeldingen binnen het toolbericht zelf, hetzelfde nog-eens-kijken-patroon als in onze agentische vision-tutorial met Gemini. Kimi’s docs tonen hier geen voorbeeld van, dus beschouw het als geobserveerd gedrag. In alle drie de proeven droeg een role: "tool"-bericht image_url-delen, en het model las ze.
Houd het volledige assistant-bericht in de toollus
Drie details zijn hier belangrijk, en de eerste twee komen uit Kimi’s gids voor denkende modellen en quickstart:
-
Stuur bij elke beurt het volledige assistant-bericht terug, inclusief
reasoning_contententool_calls -
Voeg één toolbericht toe per toolaanroep, met de bijbehorende
tool_call_id -
Serialiseer het bericht met
model_dump(), omdat de OpenAI SDK geen getypt veldreasoning_contentheeft
De onderstaande lus volgt alle drie:
message = response.choices[0].message.model_dump(exclude_none=True)
messages.append(message) # all of it, or the next turn quietly loses its reasoning
for call in message.get("tool_calls") or []:
content = run_tool(call["function"]["name"], json.loads(call["function"]["arguments"]))
messages.append({"role": "tool", "tool_call_id": call["id"], "content": content})Reken er niet op dat de API hier een fout opvangt. Een verzoek met reasoning_content verwijderd uit de geschiedenis slaagt nog steeds, al vereisen de docs het veld en kan het weglaten ervan beïnvloeden hoe latere beurten verdergaan. Ik heb liever een 400 dan een bug die stilletjes faalt.
Het budget leeft in de luscode, waar Kimi het niet kan veranderen. Zodra de 3 reparaties zijn verbruikt, antwoordt execute_cad met een fout, en submit_cad weigert alles wat niet één geldige solid is.
Wat er gebeurde in de reparatiefase
Niet veel, en ik overwoog dit onderdeel bijna te schrappen om die reden. Ik bouwde de reparatielus met de verwachting dat die het meeste werk zou doen, en Kimi raakte hem amper aan. Het inspecteerde zijn eerste kandidaat, renderde die, schreef een zelfverzekerde samenvatting dat hij alle vier de referentieaanzichten matchte, en diende hetzelfde programma in waarmee het begon.
Die samenvatting klopte niet altijd. In één proef meldde inspect_cad een gatstraal van 3,0 mm, dus 6,0 mm gaten waar de referentie 6,5 mm heeft, en Kimi diende toch in. Een halve millimeter is minder dan 3 pixels in deze aanzichten (ik zou mijn eigen ogen op die schaal ook niet vertrouwen), en niets in de feedback noemde wat de juiste diameter was.
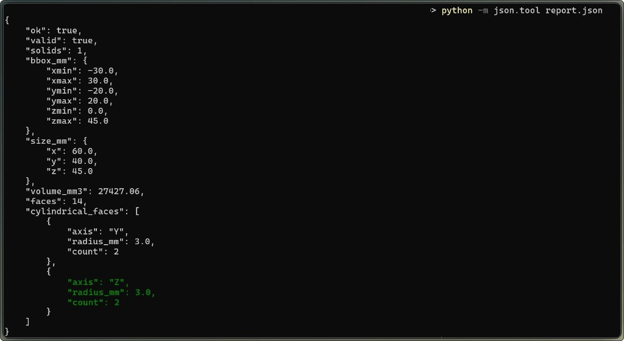
De tool rapporteerde stralen van 3,0 mm. Afbeelding door auteur.
Bewerk een parametrisch CAD-model met Kimi K3.1 Pro
Met de reparatielus op non-actief werd de ontwerpwijziging de meerzeggende test. Het is een milde test, overigens; een wijziging die twee features tegelijk verplaatst, zou veel zwaarder drukken.
Vraag Kimi om de sleuf te verbreden
De bewerking gaat door in hetzelfde gesprek en start vanaf de kandidaat die Kimi indiende, niet vanaf mijn referentiecode:
Increase the width of the vertical slot in the upright plate from 6 mm to 9 mm.
Keep the slot's center position and its end-to-end length as they are in your model.
Do not change the mounting holes, the plate thickness, or the outer dimensions.Kimi gebruikte één van zijn 3 toegestane programma’s. De diff is één regel, slot_width = 6.0 naar slot_width = 9.0, daarna één beurt om te inspecteren en renderen en een submit.
Controleer de bewerking op de geëxporteerde geometrie
Een nieuw getal in de code bewijst niet dat de solid is veranderd. De evaluator vergeleek de solids voor en na de bewerking voxel voor voxel, waarbij alleen de ruimte die de bredere sleuf mag innemen werd genegeerd:
- De sleuf is 9 mm breed, met dezelfde lengte en hetzelfde centrum
- Gaten, plaatdikte en buitengrootte zijn ongewijzigd
- Er veranderde geen materiaal buiten het sleufgebied
Elke bewerkingscheck slaagde, elke keer.
De bewerking werkte netjes omdat slot2D() zijn lengte opvat als van uiteinde tot uiteinde, dus bleef de sleuf 20 mm lang en werd het rechte deel korter. Een programma dat de afstand tussen de twee boogcentra opslaat, had de sleuf 3 mm langer gemaakt.
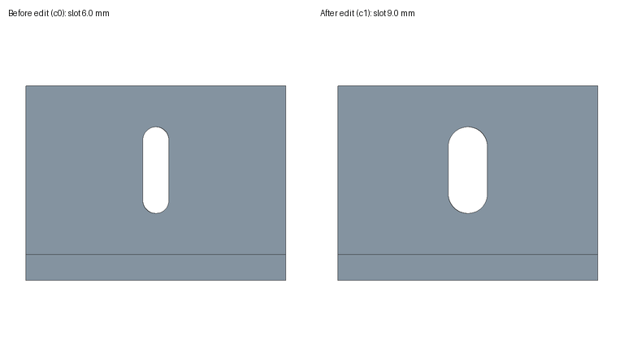
De bewerking wijzigde alleen de sleuf. Afbeelding door auteur.
Hoe nauwkeurig was de Kimi K3.1 Pro CAD-agent?
De agent slaagde voor elke verborgen check in alle drie de proeven, binnen de toleranties die ik vooraf had vastgelegd. Lees de tabel als een samenvatting:
|
Check |
Resultaat over drie proeven |
|
Verborgen geometriechecks geslaagd |
13 van 13, elke keer |
|
Voxel-IoU tegenover de referentie (0,5 mm raster) |
0,998 tot 1,0 |
|
Gatdiameter (ware waarde 6,5 mm) |
Twee keer 6,5 mm, één keer 6,0 mm, wat Kimi’s review doorliet |
|
Gebruikte reparaties (3 toegestaan) |
0 |
|
Bewerkingschecks geslaagd |
8 van 8, elke keer |
Drie proefen zijn geen succesratio, alleen een teken dat het resultaat standhield bij één beugel. De 6,0 mm-gaten uit de reparatiefase slaagden alleen omdat ze precies op de tolerantielimiet van ±0,5 mm zaten; een strakker limiet had die proef laten falen.
Zelfcorrectie had niets te herstellen
De test die zou laten zien of de lus een model verbetert, is een foutinjectierun, die de agent start vanuit een programma met een bekende fout. Ik zou dat los van deze proeven rapporteren.
Tokencost en looptijd per proef
Elke proef kostte 6,3 tot 7,3 cent voor zes verzoeken en zeven tool-calls. Dat zijn alleen API-kosten, want renderen en Docker draaiden op mijn machine.
Prijs elk verzoek af op basis van de usage-velden tegen de gepubliceerde tarieven voor kimi-k3.1-pro. Per miljoen tokens is dat $2,00 voor input, $10,00 voor output, $0,20 voor cache-hits, en $2,00 voor 5-minuten-cachewrites.
|
Fase |
Verzoeken |
Aandeel van de kosten |
|
Eerste verzoek |
1 |
Ongeveer de helft |
|
Reparatiereview |
2 |
Ongeveer een kwart |
|
Bewerking |
3 |
Ongeveer een kwart |
Het eerste verzoek kost het meest, omdat Kimi daar redeneert. Output is meer dan de helft van de rekening en cachewrites 23% tot 35%, terwijl cache-hits bijna niets kosten. Zo tellen de drie inputvelden op, volgens de Chat Completions-referentie die ik eerder linkte; je kunt dit overslaan als je tracker cachewrites al apart bijhoudt:
uncached = u.prompt_tokens - cached - written # the three parts sum to prompt_tokens
cost = (uncached * 2.00 + cached * 0.20 + written * 2.00 + u.completion_tokens * 10.00) / 1e6Reasoning-tokens zitten al in completion_tokens, dus tel ze niet nogmaals mee. Een 5-minuten-cachewrite kost hetzelfde als ongecachete input, dus prompt caching loont alleen uit wanneer een prefix wordt teruggelezen. Tool-lussen sturen elke beurt dezelfde geschiedenis opnieuw, en hier bracht caching de inputrekening terug tot onder 40% van het platte tarief.
Een proef duurt ongeveer drie minuten, vooral wachtend, omdat de client verzoeken 21 seconden uit elkaar zet voor de rate limit die ik in de FAQ behandel.
Waar AI-CAD-generatie uit afbeeldingen tekortschiet
De belangrijkste beperking is dat beelden niet elke maat kunnen dragen. Mijn test voegt er nog een paar toe:
- Renders tonen geen details kleiner dan een pixel. Als een afmeting ertoe doet, geef die dan als tekst of meet hem met een tool.
- De beugel was gemakkelijk te raden. Gaten uit het midden en ongewone maten zouden testen of Kimi de pixels leest of de ontwerptradities.
- Docker-flags blokkeren alleen wat ze benoemen. Ze stopten het misdragende programma uit de setup-sectie, maar modelcode kan nog steeds zijn volle minuut CPU verbranden. Onze gids over het beveiligen van AI-agents in containers behandelt de volgende lagen.
- Het slagen voor deze checks zegt niets over sterkte. Belasting, materiaal, de afgeronde binnenhoek die een echt onderdeel nodig zou hebben, boutpassing en hoe toleranties optellen vallen buiten deze test.
De makkelijke beugel is eerder een beperking van mijn test dan van Kimi.
Slotgedachten
We bouwden een agent die parametrische CadQuery-code schrijft uit vier afbeeldingen, zijn eigen solid met tools controleert en op verzoek één feature bewerkt. Voor deze beugel is het antwoord op mijn openingsvraag: ja. Alle drie de proeven slaagden bij het eerste verzoek binnen de door mij ingestelde toleranties, en de sleufbewerking liet de rest van het onderdeel met rust.
De reparatielus is het onderdeel waar ik niet voor kan instaan, omdat Kimi niets vond om te repareren. Zijn review liet de ene fout van 0,5 mm door omdat hij pixels zag, nooit de ware diameter. Ik zou het resultaat niet veralgemeniseren naar een onderdeel met ongewone maten of naar foto’s van een echt exemplaar.
Wat overeind blijft, is de methode om de referentie te verbergen, de beoordelingsregels vóór het eerste verzoek vast te zetten en de geëxporteerde solid te scoren in plaats van de code. Kimi zei drie keer dat zijn kandidaat overeenkwam, en alleen de evaluator kon zien dat het twee keer goed was en één keer dichtbij. Die evaluator is wat ik zou behouden, en een foutinjectierun zou mijn eerste uitbreiding zijn.
Wil je meer weten over het koppelen van modellen aan je eigen tools, onze Developing AI Systems with the OpenAI API-cursus behandelt function calling met dezelfde SDK die deze agent gebruikt.
FAQs
Welke afbeeldingsformaten en -groottes kan ik naar de Kimi K3.1 Pro API sturen?
PNG, JPEG, GIF, WebP, BMP, HEIC en HEIF werken als base64 data-URL’s, terwijl SVG wordt geweigerd, zelfs wanneer gecodeerd, dus stuur de XML van een SVG-tekening als tekst. Een verzoek kan elk aantal afbeeldingen bevatten binnen een body van 100 MB, en de vision-gids die ik eerder linkte raadt aan onder 4096×2160 te blijven. Ik zou geanimeerde GIF- en WebP-bestanden vermijden, die Kimi mogelijk als video decodeert en factureert.
Kan Kimi’s 3D Make een CAD-agent zoals deze vervangen?
Niet voor parametrisch werk, afgaand op de launch-blog. 3D Make leeft in de Kimi-app en -website, waar je een model bewerkt en het downloadt voor 3D-printen. De blog noemt geen API-toegang of STEP-export, dus een slot_width die je kunt veranderen vereist nog steeds je eigen toollus.
Waarom krijgt mijn Kimi K3.1 Pro-agent HTTP 429-fouten?
Lees eerst error.type , want Kimi gebruikt 429 voor drie verschillende problemen. rate_limit_reached_error betekent dat je de rate limits van je tier overschreed, die oplopen van 3 verzoeken per minuut bij $1 tot 200 bij $10. exceeded_current_quota_error betekent dat je saldo op is, terwijl engine_overloaded_error drukke servers aanduidt — dus vertraag en probeer opnieuw in plaats van meteen op te waarderen.
Hoe kan ik de kosten van een Kimi K3.1 Pro CAD-agent verlagen?
De standaardcache van 5 minuten past al bij deze lus, aangezien elke hit hem gratis vernieuwt en mijn verzoeken 21 seconden uit elkaar lagen. Als iemand renders beoordeelt tussen beurten en er gaten van meer dan 5 minuten vallen, laat de context caching-gids zien hoe je een TTL van 1 uur instelt, en zijn write van $4,00 per miljoen tokens betaalt zich na twee hits terug. Ik zou Highspeed overslaan als kosten de zorg zijn, omdat die beide prijzen verdubbelt voor 2 tot 3 keer de snelheid.
Moet ik high of max reasoning effort gebruiken voor CAD-reconstructie?
Begin met high, wat ik overal gebruikte. Als je max probeert (ik deed dat niet op deze beugel), stream dan het antwoord, want de gateway geeft een 504 terug als een niet-streamend verzoek 900 seconden stil blijft. De completion cap is standaard 131.072 tokens en omvat redenering, dus mijn cap van 32.768 hield elk enkel antwoord onder ongeveer 33 cent aan output.
Ik ben een data-engineer en communitybouwer die werkt aan datapijplijnen, cloud en AI-tools, en tegelijkertijd praktische, impactvolle tutorials schrijft voor DataCamp en beginnende developers.


Stel: je hebt vier foto’s van een metalen hoekbeugel, zo’n L-vormige die een plank aan de muur vastzet, maar geen computer-aided design (CAD)-bestand ervan. Engineers bewerken CAD-bestanden en sturen die naar werkplaatsen, omdat een CAD-bestand exacte maten bevat. Je kunt er een gat in verplaatsen of een sleuf verbreden en nog steeds een correct onderdeel krijgen — iets wat niet kan met alleen een foto.
Wat je wilt, is een kort Python-programma dat de beugel opbouwt uit benoemde afmetingen, zoals
hole_diameter = 6.5, en het opslaat als een STEP-bestand, het standaardformaat dat CAD-tools delen. Moonshots technische blog zegt dat Kimi K3.1 Pro goed is in dit soort ruimtelijk werk, dus ik zette dat op de proef. Kan Kimi K3.1 Pro vier beelden omzetten in een bewerkbaar CAD-model, zijn eigen werk met tools controleren en vervolgens één feature aanpassen zonder de rest te breken?Om het eerlijk te houden, bouwde ik de beugel zelf in CadQuery, een Python-bibliotheek voor het bouwen van CAD-modellen. Ik renderde er vier beelden uit en hield het oorspronkelijke CAD-bestand bij Kimi weg. In deze Kimi K3.1 Pro API-tutorial schrijft Kimi het programma op basis van die beelden, en voert mijn code het uit en meet wat er gebouwd is.
Je hebt geen CAD-ervaring nodig om mee te doen, al gaat de code ervan uit dat je vertrouwd bent met Python en Docker. Ik leg de geometrie uit zodra die relevant wordt. We behandelen hoe je:
Ons overzicht van Kimi K3.1 Pro behandelt de lancering, benchmarks, prijzen en toegang, dus hier focus ik op de agent.
TL;DR
Ik vroeg Kimi K3.1 Pro drie keer om vier foto’s van een metalen beugel om te zetten in een bewerkbaar 3D-model met
reasoning_effort="high", en het gaf elke keer hetzelfde resultaat, met één kleine uitzondering: