

Cursus
LLM-toepassingen ontwikkelen met LangChain
3 uur
51.8K
Oefen en volg je voortgang.
Ga Verder Met GoogleStel je voor dat je exact hetzelfde large language model (LLM) twee keer draait, maar elk een totaal ander harnas geeft. De ene run rondt een complexe refactoropdracht netjes af. De tweede run stopt en faalt volledig. Het model veranderde niet, maar de steiger rond het model wel.
Kort gezegd is agent-harnasengineering de praktijk van het bouwen van de omliggende logica, bestandssysteentoegang, geheugen en regels waarmee een LLM betrouwbaar kan handelen.
In deze tutorial over agent-harnasengineering leer ik je hoe je een minimale Python-setup maakt met een Reason and Act (ReAct)-loop, tools en hooks. Je hebt Python 3, pip op je machine geïnstalleerd en basiskennis van het doen van LLM-API-calls nodig.
Agent-harnasengineering is de praktijk van het bouwen van de infrastructuur, configuraties en uitvoerlogica die om een large language model heen zit, en het zo verandert van een statische LLM tekstgenerator naar een autonome AI-agent
Agent-harnasengineering is de structurele configuratie die een statische tekstgenerator verandert in een autonome werker.
De kernformule is simpel: agent = model + harnas. Het harnas omvat systemprompts, tooldefinities, filesystem-workspaces, orkestratielogica en observability-hooks.
Addy Osmani codificeerde dit concept in zijn O'Reilly-stuk over AI-workflows van april 2026. Hij definieerde het harnas als alle code, configuratie en uitvoerlogica die niet het model zelf is: jouw surface area als developer, los van de API van de provider.
Toen ik net begon met het bouwen van machinelearning-workflows, gaf ik het model de schuld telkens als een agent een Python-dependency hallucineerde. Ik leerde op de harde manier dat de meeste fouten configuratieproblemen zijn.
Exact dezelfde versie van een model met een beter harnas presteert meetbaar beter dan met een slecht harnas.
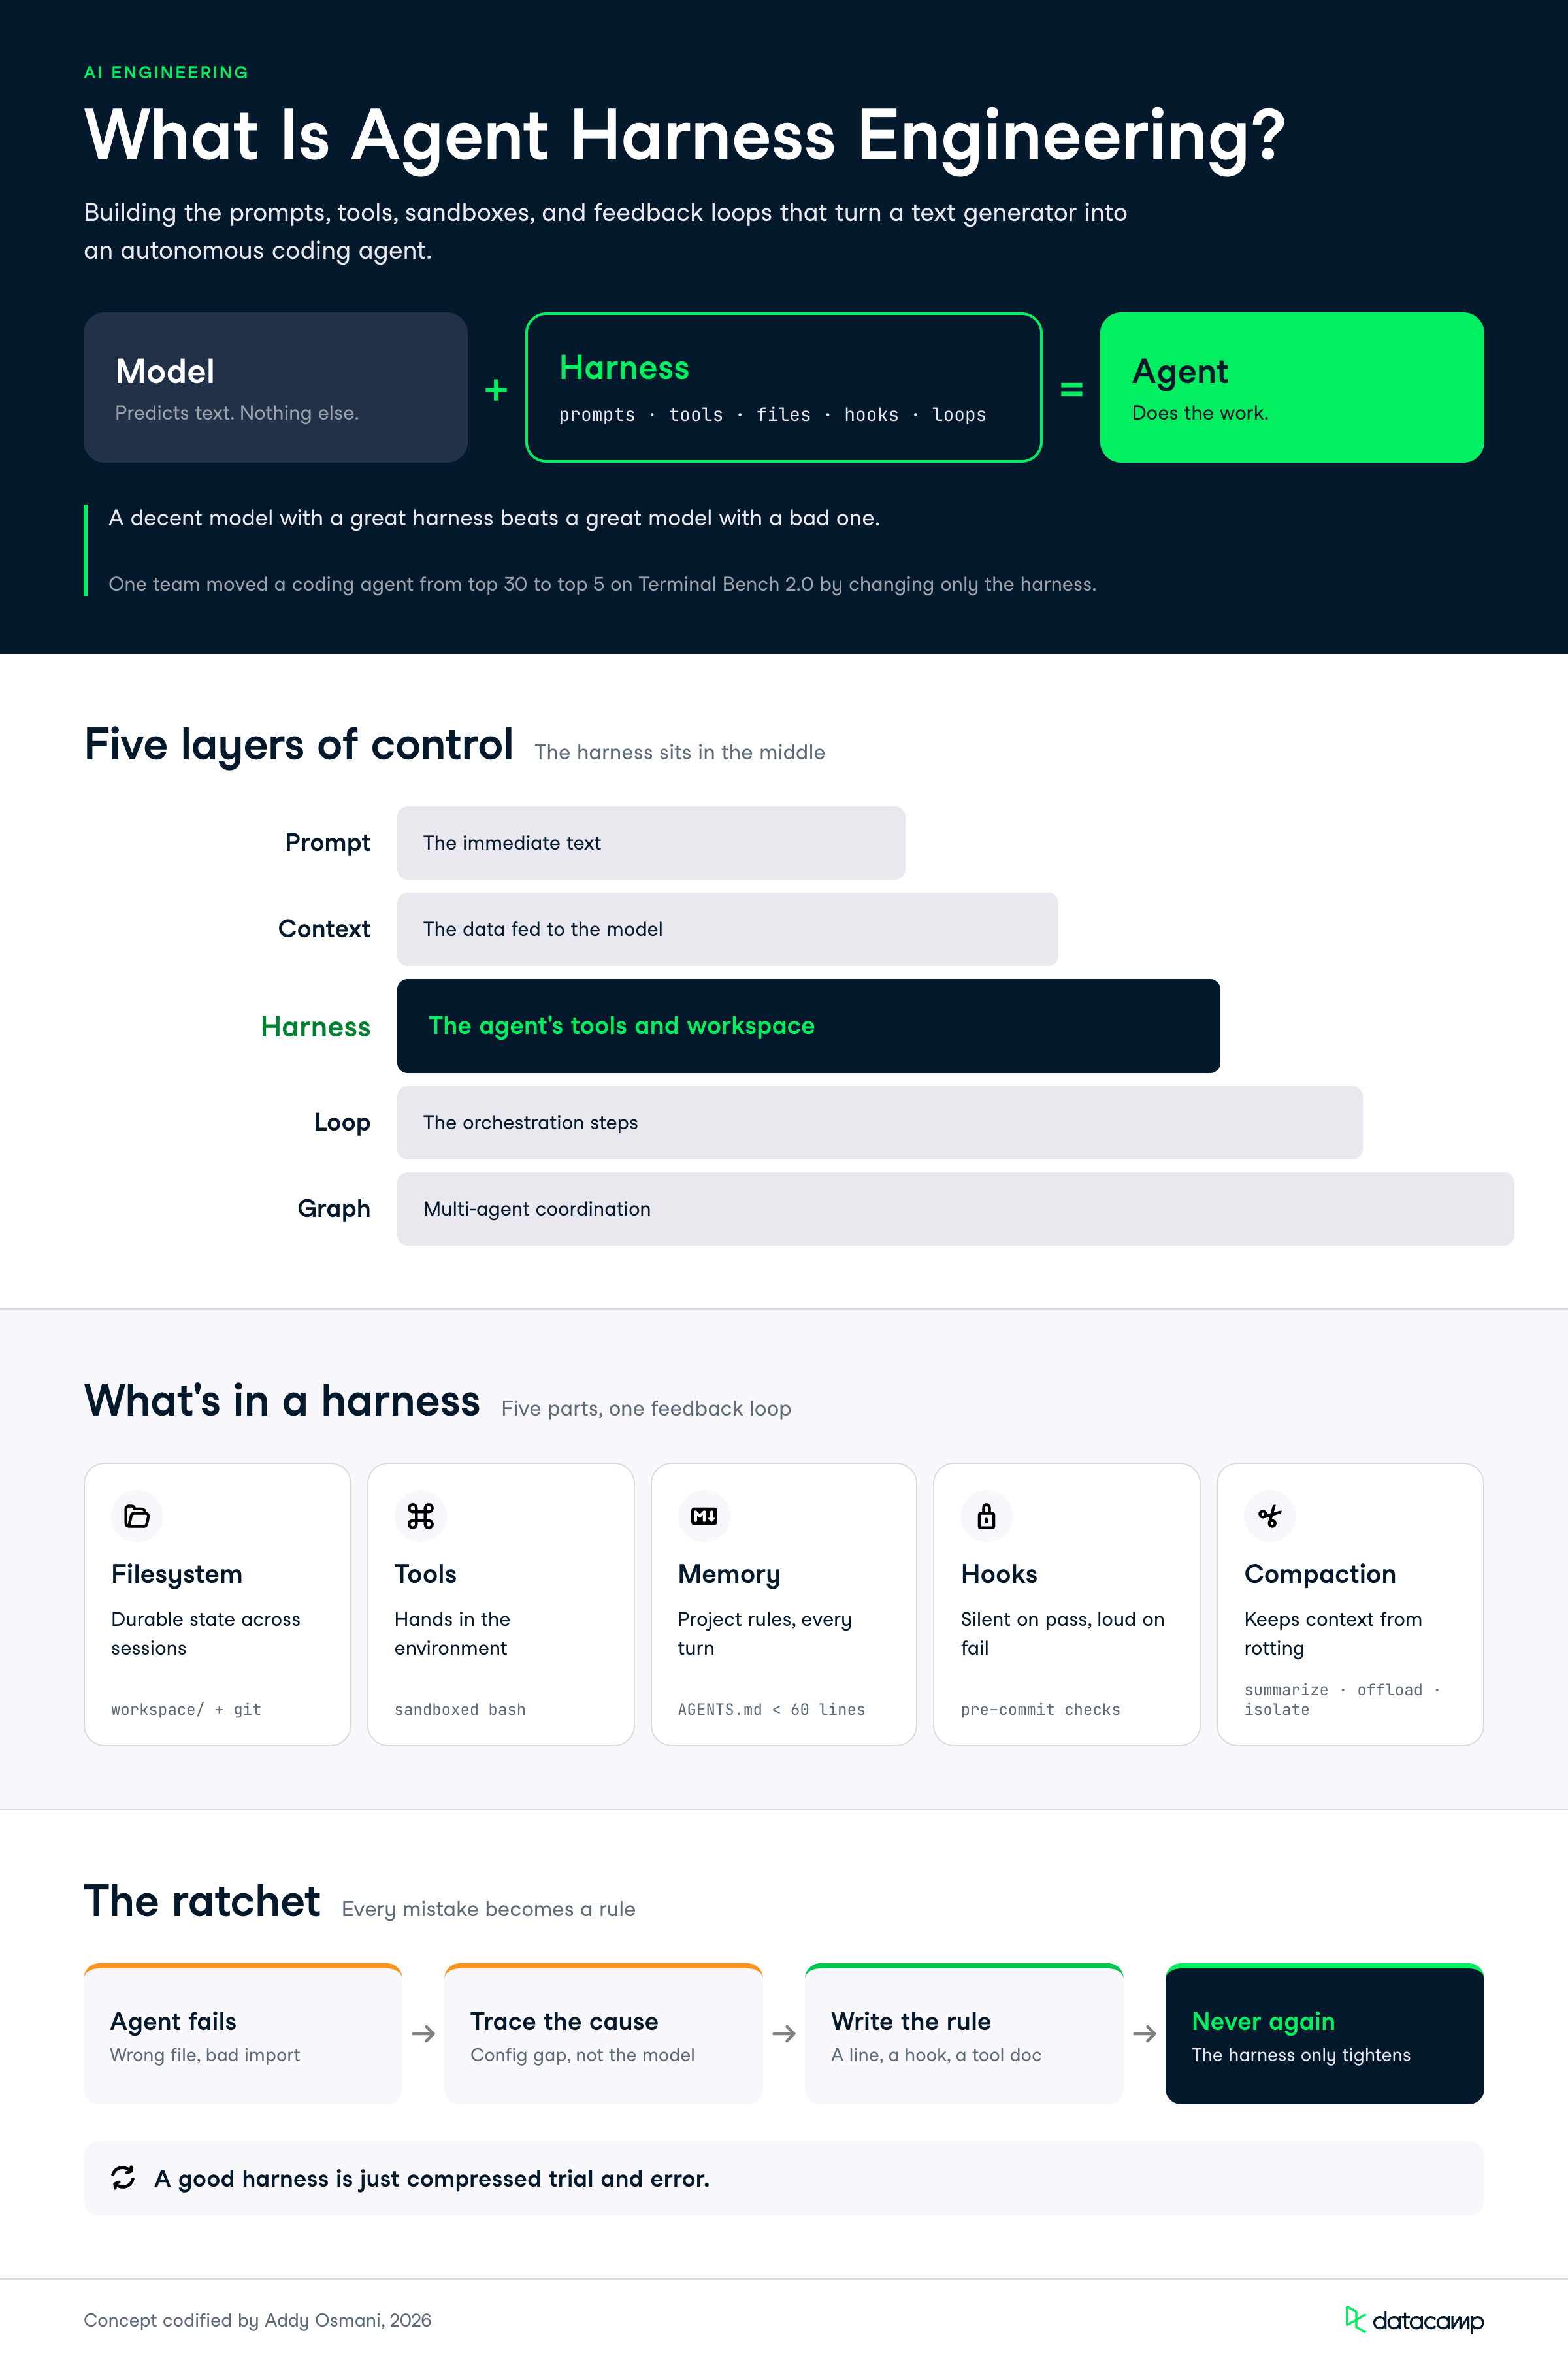
We kunnen AI-ontwikkeling opdelen in afzonderlijke lagen van controle.
Harnasengineering zit precies in het midden van deze hiërarchie.
|
Laag |
Wat het bestuurt |
Voorbeeldactie |
|
Prompt engineering |
De directe tekst |
Instructies bijstellen |
|
Context engineering |
De data die aan het model wordt gevoerd |
RAG-pijplijn tunen |
|
Harnasengineering |
De fysieke tools van de agent |
Een Bash-tool toevoegen |
|
Loop engineering |
De orkestratiestappen |
ReAct-flow wijzigen |
|
Graph engineering |
Coördinatie tussen meerdere agents |
Routernodes bouwen |
pandas-script uitvoert of een lokale CSV leest. De bepalende mindset van agent-harnasengineering is het ratchet-effect.
Als een agent een fout maakt, maak je een fix zodat die fout nooit meer voorkomt. Een goed harnas is gecomprimeerde trial-and-error.
In plaats van de agent fouten te laten herhalen, voeg je een regel toe aan je AGENTS.md, schrijf je een nieuwe hook of scherpt je een toolbeschrijving aan.
Je grijpt niet reflexmatig naar een nieuw model; je bouwt een corpus waarmee je specifieke failures kunt traceren en hoe je daartegen gehard bent.
De kerncomponenten van een AI-agentharnas zijn het filesystem, de tools, het geheugen, de hooks en systemen voor contextbeheer die het model laten opereren.
Deze onderdelen werken samen om geïsoleerde API-calls te veranderen in een doorlopende feedbackloop. Ik geef je graag een duidelijke kaart voordat we code gaan schrijven.
|
Component |
Taak |
Python-implementatie |
|
Filesystem |
Duurzame state |
Lokale workspace/-map |
|
Tools |
Handelen in de omgeving |
Python-functies voor Bash |
|
Geheugen |
Projectcontext |
Een AGENTS.md-bestand |
|
Hooks |
Handhaving |
Pre-commit-validatiescripts |
|
Compaction |
Contextbeheer |
Samenvattingslogica |
Een model kan alleen informatie verwerken binnen zijn beperkte contextvenster. Een filesystem biedt een stabiele werkruimte om data te lezen, tussentijdse resultaten te schrijven en sessies te overbruggen.
Git-versiebeheer toevoegen geeft een noodzakelijke veiligheidsnet. De agent kan voortgang tracken, aftakken voor experimenten met verschillende hyperparameters en gebroken code automatisch terugdraaien.
De ReAct-loop werkt in een cyclus van redeneren, handelen via een toolcall en het resultaat observeren. Toolbeschrijvingen vormen de directe interface tussen het model en de omgeving. Vage beschrijvingen leveren vaag gedrag op.
Bash is een uitstekende algemene tool. In plaats van voor elke mogelijke actie een specifieke Python-functie vooraf te bouwen, laat Bash de agent on-the-fly de exacte commando's samenstellen die nodig zijn. Je moet deze commando's zorgvuldig sandboxen om systeemschade te voorkomen.
AGENTS.md en kennisinjectieJe agent heeft project-specifiek geheugen nodig om lokale conventies te begrijpen. Een AGENTS.md-bestand is een vlak markdown-document in de root van de repository dat bij elke beurt in de systemprompt terechtkomt. Het definieert je techstack, opmaakregels en verboden acties.
Houd dit bestand onder de 60 regels. Behandel het als de checklist van een piloot in plaats van als een allesomvattende stijlgids. Je kunt een volledige AGENTS.md-tutorial lezen voor diepere voorbeelden. Overweeg ook Model Context Protocol (MCP)-tools voor kennis na de cutoff.
Hooks zijn kleine scripts die op specifieke momenten in de levenscyclus draaien.
Je kunt bijvoorbeeld een hook draaien vóór een toolcall, na een bewerking aan een bestand of vóór een Git-commit. Bekijk deze gids over Claude Code Hooks voor geavanceerde hookpatronen.
Het belangrijkste ontwerpbeginsel voor hooks is dat succes stil is, maar failures spraakzaam. Een geslaagde typecheck produceert nul output.
Een failure injecteert de exacte fouttekst terug in de agentloop voor zelfcorrectie.
Contextrot ontstaat wanneer het opvolgen van instructies achteruitgaat naarmate het contextvenster volloopt met lange gespreksgeschiedenissen. Een degelijke AI-agentsteiger moet dit actief beheren. Lees meer over het contextvenster om deze limieten te begrijpen.
Je kunt context verminderen door oudere berichten samen te vatten. Je kunt grote tooloutputs naar schijf offloaden en alleen een korte referentie in de prompt houden.
Tot slot kun je token-zware subtaken isoleren naar een subagent met een eigen frisse context.
Een AI-agentharnas bouwen houdt in dat je de Python-orkestratiecode schrijft die de ReAct-loop, tools en hooks samenbrengt.
Wees helder over de relatie voordat je code schrijft: harnas.py is de agent, en je start hem zelf met python harness.py zoals elk ander script.
Het model is een externe API die dit bestand nooit ziet; het ontvangt alleen de systemprompt, berichtgeschiedenis en toolschema's die jouw script verstuurt.
Elk snippet in deze sectie is een onderdeel van één bestand, harness.py, en de eerste 4 secties bouwen het van boven naar beneden. De laatste 2 secties (hooks en compactie) upgraden het, en omdat de loop begint te draaien zodra Python hem bereikt, moeten hun functiedefinities boven de loop staan; elke sectie vertelt je exact waar de code terechtkomt.
Om dit te bouwen heb je een developeraccount bij je gekozen provider nodig. Standaard consumentabonnementen (zoals ChatGPT Plus of Claude Pro) geven geen API-toegang.
ANTHROPIC_API_KEY (of OPENAI_API_KEY).In dit voorbeeld gebruiken we Anthropic, dus zorg dat je het Anthropic Python-pakket installeert met pip install anthropic.
Maak daarna het projectskelet. Bestanden vooraf benoemen is belangrijk: onze loop leest AGENTS.md bij de start, dus dat bestand moet bestaan vóórdat de loop draait.
agent-harness/
├── AGENTS.md        # Project memory (we write this first)
├── harness.py       # The ReAct loop, tools, and hooks
└── workspace/       # The only directory the agent may touch
De map workspace/ is de sandbox van de agent. Alles wat de agent leest, schrijft of uitvoert gebeurt hierin, nooit in je projectroot.
We schrijven AGENTS.md vóór de loop omdat de loop ervan afhankelijk is.
Maak het bestand in de projectroot en voeg je specifieke stackdetails en architectuurgrenzen toe:
# Project Context
Stack: Python 3.11, Pytest
Workspace: All commands run inside the workspace/ directory.

# Rules
1. Never use rm -rf. Use standard rm with specific file names.
2. Never write tests inside the main application file.
3. When you finish the task, reply with a plain-text summary and no tool call.
Onze loop behandelt "het model reageerde zonder een tool te vragen" als het signaal dat de taak klaar is, dus we vertellen het model expliciet hoe afronding te signaleren.
Regels die verwijzen naar je eigen loopmechaniek zijn de sleutel tot harnasengineering. Het geheugenbestand en de orkestratiecode zijn samen ontworpen.
Begin nu aan harness.py door dit bestand als systemprompt te lezen en de workspace voor te bereiden:
import subprocess
from pathlib import Path

import anthropic

client = anthropic.Anthropic()

WORKSPACE = Path("workspace")
WORKSPACE.mkdir(exist_ok=True)

# Project memory: AGENTS.md lands in the system prompt on every turn
system_prompt = Path("AGENTS.md").read_text()
Omdat de SDK system_prompt bij elke API-call meestuurt, worden de regels in AGENTS.md bij elke beurt opnieuw geïnjecteerd. Het model kan ze niet "vergeten" zoals het midden in een gesprek instructies vergeet.
We definiëren 2 tools: run_bash voor algemene uitvoering en write_file voor het maken van bestanden.
De tweede tool lijkt misschien overbodig omdat Bash met heredocs bestanden kan schrijven, maar een aparte write_file geeft ons een schoon bewerkingsevent waar onze post-edit-hook later op kan inhaken.
Beslissingen in harnasdesign gaan altijd over wat je wilt observeren en handhaven.
Toolbeschrijvingen zijn de interface, en hun kwaliteit stuurt het gedrag van de agent direct aan:
We gaan verder in ons harness.py-bestand en definiëren nu de toolschema's op de volgende regel:
TOOLS = [
    {
        "name": "run_bash",
        "description": (
            "Run a bash command inside the workspace/ directory and return "
            "its stdout, stderr, and exit code. Use it to list files, run "
            "scripts, and run tests. Do not use it to create Python files; "
            "use write_file instead."
        ),
        "input_schema": {
            "type": "object",
            "properties": {
                "command": {"type": "string", "description": "The bash command to run."}
            },
            "required": ["command"],
        },
    },
    {
        "name": "write_file",
        "description": (
            "Create or overwrite a file inside the workspace/ directory. "
            "Provide a path relative to workspace/ and the full file content."
        ),
        "input_schema": {
            "type": "object",
            "properties": {
                "path": {"type": "string", "description": "Path relative to workspace/."},
                "content": {"type": "string", "description": "Full file content."},
            },
            "required": ["path", "content"],
        },
    },
]
Dit volgende blok definieert de daadwerkelijke Python-functies die deze commands uitvoeren.
Let op de ingebouwde veiligheidsfeatures: een harde timeout zodat een vastgelopen commando het harnas niet kan hangen, een exitcode in elk resultaat zodat de agent succes van falen kan onderscheiden, en een padcheck zodat write_file() niet uit de sandbox ontsnapt.
def run_bash(command: str) -> str:
    result = subprocess.run(
        command,
        shell=True,
        capture_output=True,
        text=True,
        cwd=WORKSPACE,
        timeout=60,
    )
    output = (result.stdout + result.stderr).strip()
    return f"exit code: {result.returncode}\n{output or '(no output)'}"


def write_file(path: str, content: str) -> str:
    target = (WORKSPACE / path).resolve()
    if WORKSPACE.resolve() not in target.parents:
        return "Error: path escapes the workspace/ directory."
    target.parent.mkdir(parents=True, exist_ok=True)
    target.write_text(content)
    return f"Wrote {len(content)} characters to {path}."


TOOL_EXECUTORS = {"run_bash": run_bash, "write_file": write_file}
De fallback or '(no output)' is niet cosmetisch.
Een commando als touch data.csv slaagt stilletjes, en een lege string teruggeven geeft het model niets om te observeren.
Geef de agent altijd een expliciet signaal, zelfs voor stilte.
De kern van ons harnas is een standaard Python-for-loop met een iteratielimiet.
Elke beurt roept de API aan, checkt of het model een tool vroeg, voert elke gevraagde tool uit en geeft de resultaten terug als één bericht.
Dit blok staat onderaan harness.py, omdat het gaat uitvoeren zodra Python het bereikt.
	messages = [
	    {
	        "role": "user",
	        "content": "Create a fizzbuzz.py script in the workspace, "
	                   "then run it to verify the output.",
	    }
	]

	MAX_STEPS = 15

	for step in range(MAX_STEPS):
	    print(f"--- Iteration {step + 1} ---")

	    response = client.messages.create(
	        model="claude-sonnet-5",
	        max_tokens=2000,
	        system=system_prompt,
	        messages=messages,
	        tools=TOOLS,
	    )

	    # Append the model's turn to the history
	    messages.append({"role": "assistant", "content": response.content})

	    # Stop condition: the model answered without requesting a tool
	    if response.stop_reason != "tool_use":
	        final_text = "".join(b.text for b in response.content if b.type == "text")
	        print(f"Task complete: {final_text}")
	        break

	    # Execute EVERY tool call in this turn, collecting the results
	    tool_results = []
	    for block in response.content:
	        if block.type != "tool_use":
	            continue
	        print(f"Agent calling {block.name}: {block.input}")
	        output = TOOL_EXECUTORS[block.name](**block.input)
	        tool_results.append(
	            {"type": "tool_result", "tool_use_id": block.id, "content": output}
	        )

	    # All tool results for one assistant turn go back in ONE user message
	    messages.append({"role": "user", "content": tool_results})
	else:
	    print("Stopped: hit the maximum iteration cap without finishing.")
Twee details in deze loop voorkomen echte crashes.
Ten eerste kan één modelbeurt meerdere toolcalls bevatten, en de Anthropic-API vereist dat alle resultaten terugkomen in één user-bericht.
Ten tweede meldt de for/else-constructie wanneer de agent de iteratielimiet raakt, zodat een vastgelopen run luid faalt in plaats van in stilte te eindigen.
Deze expliciete structuur laat je precies zien waar het model stopt met nadenken, waar Python het overneemt om het commando te draaien, en hoe de output terug de loop in gaat.
Hooks vangen fouten af voordat ze uitgroeien tot grotere structurele problemen.
In ons harnas is een hook een functie die een voltooide toolcall inspecteert en extra tekst teruggeeft om aan het toolresultaat toe te voegen.
Succes geeft een lege string terug; falen levert een uitgebreide rapportage op.
Voeg deze functie toe aan harness.py boven de ReAct-loop, naast de toolexecutors. De loop start zodra Python hem bereikt, dus alles wat hij aanroept moet al gedefinieerd zijn.
def post_edit_hook(tool_name: str, tool_input: dict) -> str:
    """Run pytest after any edit to a Python file. Silent on success."""
    edited_python = (
        tool_name == "write_file" and tool_input.get("path", "").endswith(".py")
    )
    if not edited_python:
        return ""

    tests = subprocess.run(
        ["pytest", "--tb=short", "-q"],
        capture_output=True,
        text=True,
        cwd=WORKSPACE,
        timeout=120,
    )
    # Exit code 5 means "no tests collected", which is fine for our purposes
    if tests.returncode in (0, 5):
        return ""
    return f"\n\n[HOOK] pytest failed after this edit:\n{tests.stdout}"
Inbedden in de loop is een wijziging van één regel binnen het toolexecutieblok:
output = TOOL_EXECUTORS[block.name](**block.input)
output += post_edit_hook(block.name, block.input)  # hooks run after every tool call
Zonder de hook schrijft de agent een gebroken bestand, ziet Wrote 412 characters to fizzbuzz.py, en gaat zelfverzekerd verder.
Met de hook draagt hetzelfde toolresultaat de exacte pytest-traceback. In de volgende iteratie leest de agent de fout en fixt zelf de bug, zonder extra prompting.
Om contextrot tegen te gaan, monitor je de lengte van je messages-lijst en vat je de oudste beurten samen wanneer die te lang wordt.
Er is één valkuil: je kunt de geschiedenis niet op een willekeurig punt afkappen, omdat een tool_use-blok van de assistant en zijn gekoppelde tool_result-bericht bij elkaar moeten blijven. Een paar splitsen levert direct een API-fout op.
Onze compactiefunctie schuift het afkappunt naar voren totdat het op een veilige grens landt. Bouw dit boven harness.py:
COMPACTION_THRESHOLD = 20
KEEP_RECENT = 6


def is_tool_result(message: dict) -> bool:
    return (
        message["role"] == "user"
        and isinstance(message["content"], list)
        and any(
            isinstance(b, dict) and b.get("type") == "tool_result"
            for b in message["content"]
        )
    )


def compact(messages: list) -> list:
    if len(messages) <= COMPACTION_THRESHOLD:
        return messages

    # Never orphan a tool_result from its tool_use: slide the cut forward
    cut = len(messages) - KEEP_RECENT
    while cut < len(messages) and is_tool_result(messages[cut]):
        cut += 1

    old, recent = messages[1:cut], messages[cut:]
    transcript = "\n".join(f"{m['role']}: {str(m['content'])[:500]}" for m in old)

    summary = client.messages.create(
        model="claude-haiku-4-5",
        max_tokens=500,
        messages=[{
            "role": "user",
            "content": "Summarize this agent transcript. Preserve the task, "
                       "decisions made, files created, and any unresolved "
                       f"errors:\n\n{transcript}",
        }],
    )

    return [
        messages[0],  # always keep the original task verbatim
        {
            "role": "user",
            "content": f"[Earlier progress, summarized by the harness]\n"
                       f"{summary.content[0].text}",
        },
        *recent,
    ]
Voeg één regel toe bovenaan de ReAct-loop, vóór de API-call:
messages = compact(messages)We gebruiken een kleiner, goedkoper model voor de samenvatting omdat compactie vaak draait en snelheid nodig heeft.
We behouden ook het oorspronkelijke taakbericht letterlijk in plaats van erop te vertrouwen dat de samenvatting het bewaart.
Het harnas is nu compleet.
Controleer voordat je verdergaat dat je harness.py in deze volgorde van boven naar beneden staat:
client, WORKSPACE en system_promptTOOLS-schema'srun_bash(), write_file() en TOOL_EXECUTORSpost_edit_hook()COMPACTION_THRESHOLD, KEEP_RECENT, is_tool_result() en compact()Om je een idee te geven hoe de uiteindelijke API-loop eruit zou moeten zien nu we de hook- en compactiesecties hebben toegevoegd, staat hier de volledige, afgeronde loop:
messages = [
    {
        "role": "user",
        "content": "Create a fizzbuzz.py script in the workspace, "
                   "then run it to verify the output.",
    }
]

MAX_STEPS = 15

for step in range(MAX_STEPS):
    print(f"--- Iteration {step + 1} ---")

    # Compaction: summarize old turns before they rot the context
    messages = compact(messages)

    # The API call: model, memory, history, and tools travel together
    response = client.messages.create(
        model="claude-sonnet-5",
        max_tokens=2000,
        system=system_prompt,   # AGENTS.md text, re-injected every turn
        messages=messages,      # the full (possibly compacted) history
        tools=TOOLS,            # the schemas from the tools section
    )

    # Append the model's turn to the history
    messages.append({"role": "assistant", "content": response.content})

    # Stop condition: the model answered without requesting a tool
    if response.stop_reason != "tool_use":
        final_text = "".join(b.text for b in response.content if b.type == "text")
        print(f"Task complete: {final_text}")
        break

    # Execute EVERY tool call in this turn, collecting the results
    tool_results = []
    for block in response.content:
        if block.type != "tool_use":
            continue
        print(f"Agent calling {block.name}: {block.input}")
        output = TOOL_EXECUTORS[block.name](**block.input)
        output += post_edit_hook(block.name, block.input)  # hooks run after every tool call
        tool_results.append(
            {"type": "tool_result", "tool_use_id": block.id, "content": output}
        )

    # All tool results for one assistant turn go back in ONE user message
    messages.append({"role": "user", "content": tool_results})
else:
    print("Stopped: hit the maximum iteration cap without finishing.")
Draai nu de agent vanuit de projectroot met python harness.py.
Het script stuurt de taak uit de messages-lijst naar de API.
Het harnas doet het werk en je zou elke iteratie in je terminal moeten zien printen:
--- Iteration 1 ---
Agent calling write_file: {'path': 'fizzbuzz.py', 'content': 'def fizz(n):...'}
--- Iteration 2 ---
Agent calling run_bash: {'command': 'python fizzbuzz.py'}
--- Iteration 3 ---
Task complete: fizzbuzz.py is written and prints the correct sequence.
Het programma stopt wanneer het model antwoordt zonder toolcall, of wanneer de limiet van 15 iteraties wordt bereikt.
Wil je de agent een andere taak geven, verander dan de content-string in de initiële messages-lijst; een productieharnas zou dit inlezen via input() of een commandoregelargument.
De ratchet is het continue proces van het diagnosticeren van agentfailures en het updaten van je harnas om ze te voorkomen.
Een harnas verbetert uitsluitend door blootstelling aan edge-cases uit de echte wereld.
Laten we een volledige cyclus van falen en fixen doorlopen op basis van een echt route-optimalisatieproject.
Stel dat je agent steeds een verouderde interne routingbibliotheek genaamd legacy_route_math importeert in plaats van de geüpdatete versie.
De agent schrijft het script, de tests falen, en hij blijft hangen in een loop waarin hij probeert de syntax te fixen in plaats van de bibliotheek te wijzigen.
De diagnose is hier eenvoudig.
De agent weet simpelweg niet dat de bibliotheek verouderd is. Dit is een ontbrekende regel, niet een failure van het onderliggende neurale netwerk.
Fix 1 werkt de geheugenlaag bij, voeg deze ene regel toe aan AGENTS.md:
# Rules
1. Never use rm -rf. Use standard rm with specific file names.
2. Never write tests inside the main application file.
3. When you finish the task, reply with a plain-text summary and no tool call.
4. Do not import legacy_route_math; it is deprecated. Use routes_v2 instead.
Fix 2 voegt een permanente handhavingshook toe.
Regels zijn advies aan de agent, hooks zijn commando's. Deze fix is een paar regels en kan worden toegevoegd naast post_edit_hook(), zolang het maar vóór de ReAct-loop staat.
def deprecated_import_hook(tool_name: str, tool_input: dict) -> str:
    if tool_name != "write_file":
        return ""
    if "import legacy_route_math" in tool_input.get("content", ""):
        return (
            "\n\n[HOOK] Blocked pattern: legacy_route_math is deprecated. "
            "Rewrite this file using routes_v2 instead."
        )
    return ""
Registreer hem naast de pytest-hook in het toolexecutieblok:
output += post_edit_hook(block.name, block.input)
output += deprecated_import_hook(block.name, block.input)
Zo ziet zelfcorrectie eruit in de transcriptie nadat beide fixes zijn doorgevoerd.
De agent schrijft het bestand, de hook vuurt, en in de daaropvolgende beurt fixt hij de import zonder mens in de loop:
--- Iteration 3 ---
Agent calling write_file: {'path': 'optimizer.py', ...}
  [HOOK] Blocked pattern: legacy_route_math is deprecated...
--- Iteration 4 ---
Agent calling write_file: {'path': 'optimizer.py', ...}   # now imports routes_v2
--- Iteration 5 ---
Task complete: Rewrote optimizer.py using routes_v2 and verified the tests pass.
Dit is belangrijk omdat het terugkoppelt naar de contextrot. Zeer lange sessies met gedegradeerde context zullen geheugenregels uiteindelijk negeren.
De AGENTS.md-regel voorkomt de fout meestal, en de hook garandeert dat wanneer de regel toch glipt, de fout geen schade veroorzaakt.
Elke failure die je diagnosticeert moet je twee vragen laten stellen: welke regel ontbrak, en welke check had het toch opgevangen?
Best practices voor agent-harnasengineering richten zich op slanke configuraties en ontwerpen voor toekomstige modelupgrades.
Het doel is een steiger te bouwen die het model ondersteunt zonder het te overladen.
Ik heb een paar harde lessen geleerd tijdens het bouwen van verschillende agentvaardigheden en architecturen.
Streef naar maximaal 60 regels voor je contextbestand.
Elke regel moet terug te voeren zijn op een echte, gedocumenteerde failure die je hebt meegemaakt. Als je je het incident bij de regel niet kunt herinneren, is hij het waard om te verwijderen.
Deze discipline is belangrijk omdat AGENTS.md bij elke beurt betaald wordt.
Een stijlgids van 300 regels kost je tokens bij elke API-call en verwatert de regels die ertoe doen, omdat modellen 10 scherpe regels veel beter volgen dan 80 vage.
Een datumstempel toevoegen kan zelfs helpen bij de volgende praktijk die ik aanbeveel.
Harnassen hebben voortdurende rearchitectuur nodig naarmate basismodellen hun native capaciteiten verbeteren.
Bouw je componenten zo dat je ze makkelijk kunt weghalen.
Het hookpatroon in deze tutorial is om die reden bewust modulair.
Elke hook is een aparte functie die vervolgens met één regel wordt toegevoegd. Als je de hook uitfaseert, verwijder je één regel in de loop.
Verder verandert er niets in de loop.
Vergelijk dat met validatielogica die direct in je ReAct-loop is verweven, waar het verwijderen van een verouderde check betekent dat je het hele orkestratiepad opnieuw moet testen.
Wat vandaag als een noodzakelijke kruk voelt, wordt volgend kwartaal onnodige overhead.
Wanneer een nieuw model uitkomt, draai je je oude failure-cases opnieuw met elke hook één voor één uitgeschakeld, en behandel je elke hook die niets meer vangt als kandidaat voor verwijdering.
Bekijk Claude Code Best Practices voor meer architectuurtips.
Een kale ReAct-loop met een filesystem en één Bash-tool is al heel praktisch.
Weersta de neiging om vooraf een complex graafsysteem te bouwen met zware frameworks. De ratchet werkt maar in één richting: van geobserveerde failure naar gerichte fix. Speculatieve fixes keren dit om.
Voeg pas custom hooks toe nadat je de exacte failure hebt gezien die ze rechtvaardigt. Voor meer over de structuur van basale systemen, bekijk deze gids over LLM-agents.
Je kunt niet ratcheten wat je niet ziet.
Onze loop print al elke toolcall, en dat is de minimaal haalbare observability: als een run faalt, is de geprinte transcriptie je diagnosetool.
Schrijf naarmate je harnas volwassener wordt de volledige berichtgeschiedenis van elke sessie aan het einde van de run naar een JSON-bestand met tijdstempel.
Mislukte transcripties worden je regressieset; na elke harnaswijziging speel je de oude falende taken opnieuw af en bevestig je dat de fix nog steeds standhoudt.
Dit is het equivalent van een testsuite voor de harnasengineer, en het onderscheidt een harnas dat verbetert van een harnas dat alleen verandert.
Agent-harnasengineering is de praktische realiteit van AI-modellen nuttig werk laten doen.
De kloof tussen wat modellen vandaag theoretisch kunnen en wat je ze in productie daadwerkelijk ziet doen, is grotendeels een harnas-kloof.
Deze discipline gaat niet over het leren van een specifiek framework.
Het juiste AI-agentharnas voor jouw codebase wordt volledig gevormd door jouw unieke failure-historie, incrementeel opgebouwd via de ratchet-methode.
Klaar om deze concepten in de praktijk te brengen?
Bekijk DataCamps AI Agent Fundamentals skills track om verder te bouwen aan production-ready systemen. Je kunt ook de Claude Agent SDK-tutorial verkennen voor meer hands-on codevoorbeelden.
Je wilt misschien ook kijken naar de AI for Software Engineering skills track.
Topcursussen op DataCamp
Cursus
Cursus
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

