

Cursus
Werken met Hugging Face
2 uur
40K
Oefen en volg je voortgang.
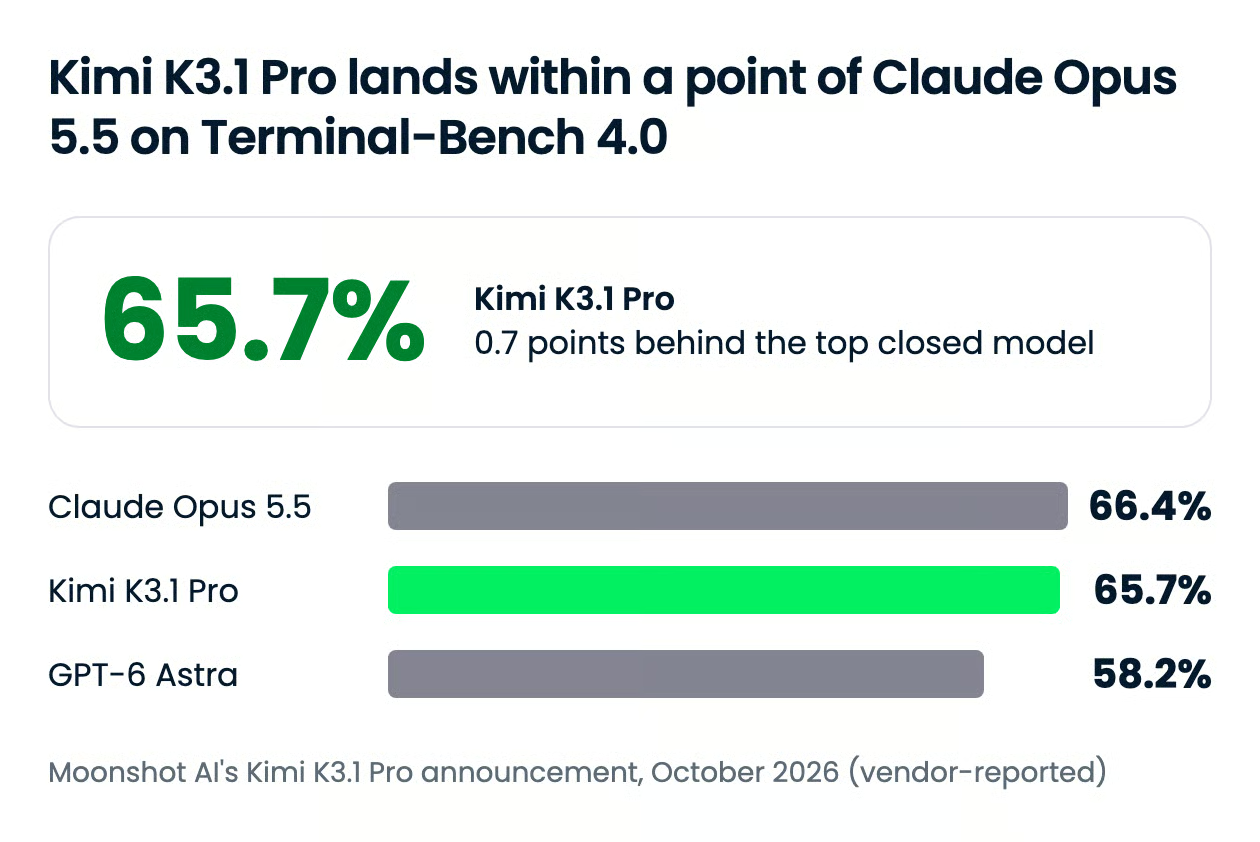
Ga Verder Met GoogleOpen-weight labs hebben in 2026 de kloof met Anthropic en OpenAI op het gebied van coderen kleiner gemaakt, en Moonshot AI heeft die net weer verkleind. Afgelopen vrijdag bracht Moonshot Kimi K3.1 Pro uit, dat het zijn meest capabele open-weight model in de 3T-klasse tot nu toe noemt, en het binnen een punt brengt van Claude Opus 5.5 op agentisch coderen.
K3.1 Pro is een zwaar nageschoolde versie van Kimi K3 met een contextvenster van 1 miljoen tokens. Het wordt geleverd naast een snellere variant, K3.1 Pro Highspeed, en is vanaf vandaag beschikbaar in de Kimi-apps, Kimi Code en de Kimi API. De volledige weights volgen uiterlijk 4 november 2026.
In dit artikel behandel ik alles wat nieuw is aan Kimi K3.1 Pro: de nieuwe features, de benchmarks en hoe de prijzen zich verhouden tot Kimi K3. Wil je de basis inhalen, bekijk dan onze gidsen voor Kimi K3 en onze praktische Kimi K3-tutorial.
Kimi K3.1 Pro is het vlaggenschip van Moonshot AI onder de large language models (LLM) en het eerste model in de nieuwe K3.1-serie. Het behoudt de basis van Kimi K3, een model met 2,8T parameters en een contextvenster van 1M tokens, en voegt daar veel meer natrainingscompute aan toe.
De verandering zit in de training, niet in de architectuur: Moonshot draaide gezamenlijke reinforcement learning (RL) over wat het "honderden downstream-domeinen" noemt, en bouwde zijn RL-framework, sandbox-infrastructuur en rollout-planning opnieuw op zodat extra compute stabiele winst opleverde. Het resultaat, volgens Moonshot, is verbetering in elk gemeten domein, met coderen, 3D-creatie en financieel onderzoek als uitschieters.
De headlineclaim is pariteit in agentisch coderen met de beste propriëtaire modellen. Moonshots eigen tabel zet K3.1 Pro binnen een punt van Claude Opus 5.5 op terminalgebaseerde coderingstaken, terwijl het slechts een fractie van de prijs van Anthropic rekent. Het model is open-weight, maar de weights zijn nog niet openbaar.
K3.1 Pro is een brede upgrade en geen enkel nieuw trucje. De volgende vier capaciteiten zijn degenen waarvoor ik mijn workflow echt zou aanpassen.
K3.1 Pro kan bij een lange, meerstaps coderingstaak blijven en zijn eigen mislukkingen diagnosticeren in plaats van alleen te retrypen. Moonshots showcase is een menselijke loopsimulator gebouwd op het open-source human-atlas anatomische model, met 296 skelet- en 402 spiercomponenten.
Over 167 missies en 420 onafhankelijke reviews nam het model de gesimuleerde mens mee van binnen enkele seconden instorten naar 11,2 seconden lopen met afwisselende passen. Het interessante deel kwam toen reward shaping de armbalans niet meer verbeterde: K3.1 Pro draaide open-loop probes van de simulator, vond 36 fouten in de moment-armberekeningen van de schouderspieren, fixte die en trainde opnieuw.
Dat is één interne demo, dus zie het als een illustratie van de beoogde use case, niet als bewijs. Toch laat het zien waarop Moonshot optimaliseert: agents die onderzoeken en itereren.
Volgens Moonshot levert K3.1 Pro front-end pagina’s, Three.js-scènes en 3D-assets met "sterkere compositie, typografie, animatie en afwerking". Het werkt met Unity, Unreal Engine en Godot, en kan die combineren met websearch en 3D-generatie om een compleet project te assembleren.
Aan de modelleringkant schrijft en draait K3.1 Pro scripts voor Blender en CAD-software direct, zonder MCP-connectors, om parametrische modellen te bouwen zoals mechanische onderdelen, architectuurmodellen en configureerbaar meubilair. Moonshot lanceerde ook 3D Make op kimi.ai en in de Kimi-app, waar je modellen kunt previewen, bewerken en downloaden, klaar voor 3D-printing.
De claim over visuele kwaliteit is ook het lastigst te toetsen aan een benchmarktabel, dus zie Moonshots demo’s als de beste voorbeelden van de leverancier, niet als typische output.
K3.1 Pro kan een financiële workflow dragen van screening tot een afgeronde workbook, en Moonshot heeft gerichte fixes gedaan voor feitelijke nauwkeurigheid bij dit soort werk. Op interne finance-benchmarks verbetert K3.1 Pro Kimi K3 met 7,2 punten op Financial Modeling en 11,6 punten op Financial Research, en haalt het ongeveer 4,2× K3’s score op Business Operation, een langetermijn gesimuleerde business-taak.
Het nauwkeurigheidswerk zie je terug in Moonshots hallucinatiestress-test. Op Kimi Hallu Bench Hard daalde het hallucinatiepercentage op claimniveau van 23,4% voor K3 naar 8,3% voor K3.1 Pro. Moonshot benadrukt dat de test is ontworpen om fouten uit te lokken, dus die percentages zijn geen alledaagse foutpercentages.
Kimi K3.1 Pro is competitief met Claude Opus 5.5 en GPT-6 Astra op agentisch coderen en tool-intensief werk, maar duidelijk achter op puur redeneren. Alle cijfers hieronder komen uit Moonshots aankondiging, met K3.1 Pro op max inspanning.
Agentisch coderen is waar K3.1 Pro het sterkst oogt. Op Terminal-Bench 4.0, die codeeragents beoordeelt op realistische, resource-beperkte terminaltaken, scoort K3.1 Pro 65,7%. Dat is maar net achter Claude Opus 5.5 met 66,4% en duidelijk voor op GPT-6 Astra met 58,2%.
De rest van de coderesultaten is gemengder dan die headline suggereert. Alle scores zijn door de leverancier gerapporteerd, met de beste score per rij vet:
| Benchmark | Wat het meet | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | Codeeragents op realistische terminaltaken | 65.7% | 66.4% | 58.2% | 42.3% |
| SWE-Marathon v1.1 | 20 meer-uur durende engineeringtaken, geen internet | 51.7% | 46.3% | 42.5% | 40.0% |
| DeepSWE v1.1 | 113 langetermijntaken, beoordeeld op gedrag | 75.5% | 74.2% | 74.1% | 77.0% |
| Kimi Code Bench 3.0 Long-horizon (Moonshot intern) | Meerstapsexecutie en toolgebruik | 61.2% | 58.5% | 66.5% | 51.5% |
| ProgramBench | Een programma herbouwen vanuit de binary en spec (taken die minstens 95% van de tests halen) | 31.5% | 65.0% | 50.0% | 29.1% |
| Terminal-Bench Science 0.1 | Agents op wetenschappelijke onderzoeksworkflows | 38.1% | 63.3% | 68.1% | 15.7% |
K3.1 Pro ligt gelijk met de beste gesloten modellen op lange engineeringtaken en leidt Moonshots SWE-Marathon-vergelijking. Op DeepSWE draaide elk lab zijn eigen setup, dus een spreiding van 3 punten is eerder een gelijkspel dan een winst. Het blijft ver achter wanneer het een programma puur vanuit waargenomen gedrag moet herbouwen, of een wetenschappelijke onderzoeksworkflow moet doorlopen.
Vergeleken met zijn voorganger is de duidelijkste winst op Moonshots eigen long-horizon benchmark, waar Kimi K3 55,95% scoorde.
Bij tool-intensief agentwerk leidt K3.1 Pro of zit het binnen enkele punten van Opus 5.5:
| Benchmark | Wat het meet | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full met tools | 2.500 moeilijke kennis- en redeneervragen, tools toegestaan | 70.0% | 67.7% | 57.2% | 58.8% |
| BrowseComp | Moeilijk te vinden informatie op het web opsporen | 92.1% | 90.8% | 91.5% | n/a |
| OfficeQA Pro v2 | Numerieke analyse over echte financiële pdf’s | 64.4 | 62.2 | 54.4 | 40.4 |
| Frontier Finance | Investeringsworkflows van screening tot winstgevendheidsanalyse | 58.6 | 56.7 | 45.0 | 54.5 |
| OSWorld V2.1 | Een desktopcomputer bedienen om taken af te ronden | 79.6% | 81.8% | 75.8% | 69.3% |
De duidelijke uitzondering in Moonshots tabel is computergebruik, waar Opus 5.5 voor blijft. Op Frontier Finance is Claude Fable 5.1 (60,8) de overall leider, vóór alle vier de hier getoonde modellen.
Zonder tools valt K3.1 Pro duidelijk achter de gesloten modellen terug:
| Benchmark | Wat het meet | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | DeepSeek-V4.1-Flash-1017 |
|---|---|---|---|---|---|
| HLE-Full | 2.500 moeilijke kennis- en redeneervragen | 51.1% | 59.8% | 53.6% | 42.6% |
| HLE-Diamond | 1.000-vragen, moeilijkste subset van HLE | 39.4% | 60.9% | 65.8% | 21.6% |
| GPQA-Diamond | Vragen op masterniveau in de natuurwetenschappen | 94.2% | 93.9% | 96.1% | 92.2% |
| MMMU-Pro | Vragen die afbeeldingen en tekst combineren | 84.1% | 87.7% | 86.9% | 80.6% |
| Kimi Hallu Bench (Moonshot intern, lager is beter) | Aandeel feitelijke beweringen dat onjuist is | 5.4% | 6.8% | 4.2% | 13.1% |
De kloof is het grootst op HLE-Diamond, terwijl GPQA-Diamond bijna verzadigd is, dus het verschil van 2 punten zegt weinig. Als jouw werk hard closed-book redeneren is, is dit niet het model om naar over te stappen.
Moonshot deed iets ongebruikelijks voor een open-weight release: het publiceerde hoeveel capaciteit het doelbewust verwijderde. Het bleek dat cybergerelateerde content in zijn mid-training data en RL-omgevingen de vaardigheid in kwetsbaarheidsonderzoek gestaag verhoogde, dus werden die data uit beide fasen verwijderd voor de open-weight release.
Op xdev-bench-hard, Moonshots interne exploit-ontwikkelbenchmark, loste een checkpoint zonder dataverwijdering 90,5% van de problemen op (pass@3). De uitgeleverde K3.1 Pro lost 81,0% op, wat nog steeds ver boven Kimi K3’s 33,3% ligt. Op publieke cyberbenchmarks zit het onder elk gesloten model waarmee Moonshot vergeleek, met 74,7 op ExploitBench tegenover 91,0 voor Opus 5.5.
Moonshots uitgangspunt is om geen open weights uit te brengen die de absolute frontier van offensieve cybercapaciteit verleggen, terwijl de open-weight lat geleidelijk wordt verhoogd. Of een knip van 9,5 punt genoeg is, is een oordeel, maar het publiceren van het getal is al meer dan veel andere labs doen.
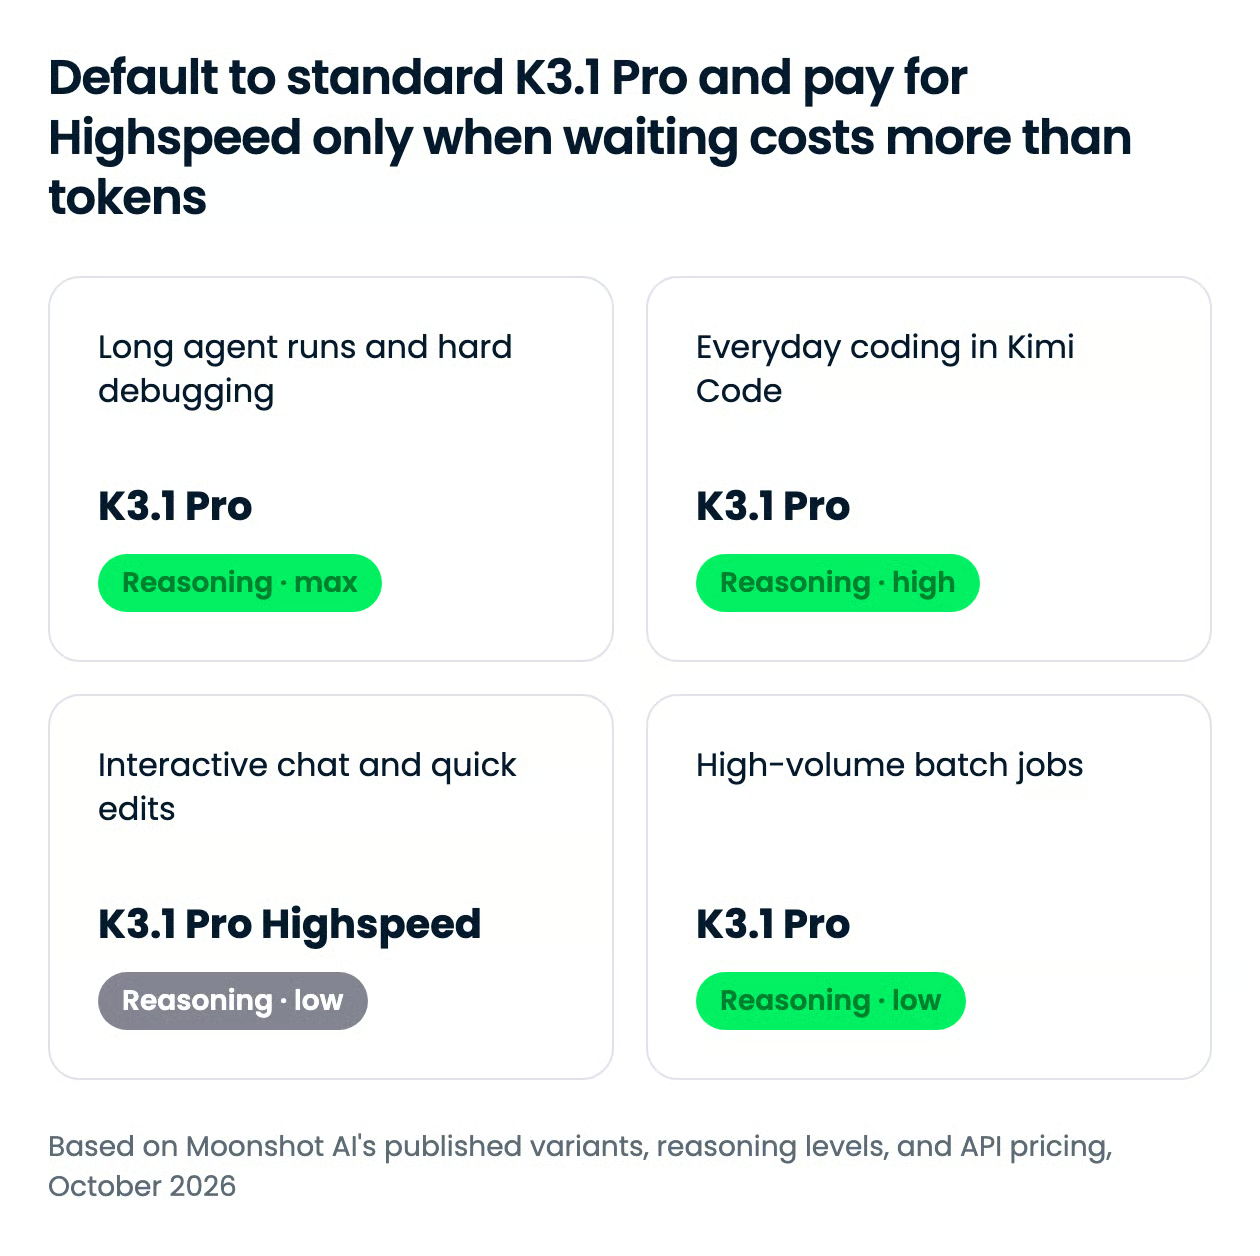
Standaard K3.1 Pro is voor bijna iedereen de juiste keuze. De Highspeed-variant verdient zijn hogere prijs alleen wanneer iemand voor het scherm op de output zit te wachten.
Moonshot verkoopt Highspeed puur op snelheid: het draait 2–3× sneller, kost twee keer zoveel per input- en outputtoken, en heeft geen aparte benchmarkresultaten.
Beide varianten denken altijd na vóór ze antwoorden, en je kunt dat niet uitzetten. Je stelt de intensiteit in met drie redeneerniveaus: max voor het zwaarste agentwerk, high als verstandige middenweg, en low wanneer de standaard denktijd meer is dan de taak nodig heeft. De API staat standaard op max, de instelling achter elke score in Moonshots benchmarktabel, dus zet die op high of low tenzij de taak volledige diepgang vereist.
| Use case | Variant | Reasoning level | Waarom |
|---|---|---|---|
| Lange agent-runs, zwaar debuggen | K3.1 Pro | max |
De instelling achter Moonshots codingscores; snelheid telt minder over uren |
| Dagelijks coderen in Kimi Code | K3.1 Pro | high |
Het grootste deel van de kwaliteit tegen een lagere tokenrekening |
| Interactieve chat en snelle edits | K3.1 Pro Highspeed | low |
Latency is de bottleneck, en korte prompts houden de 2× prijs beperkt |
| High-volume batchjobs | K3.1 Pro | low |
Niemand wacht, dus betaal het lagere tarief en begrens het denken |
Eén belangrijk praktisch punt uit de Kimi Code-docs: het wisselen van redeneerniveau midden in een sessie maakt de contextcache ongeldig, dus kies één niveau per sessie in plaats van heen en weer te schakelen.
Kimi K3.1 Pro kost $2,00 per miljoen inputtokens en $10,00 per miljoen outputtokens via de Kimi API, wat minder is dan Kimi K3. De prijs is vlak over de volledige 1M-tokencontext, zonder toeslag voor lange context.
| Model | Input | Output | Gecachte input | Cache write 5 minuten | Cache write 1 uur |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $2.00 | $4.00 |
| Kimi K3.1 Pro Highspeed | $4.00 | $20.00 | $0.20 | $4.00 | $8.00 |
| Kimi K3 (vorige generatie) | $3.00 | $15.00 | $0.30 | $3.00 | $6.00 |
Prijzen zijn per miljoen tokens en exclusief btw. Caching is automatisch met 5 minuten als standaard, en je kunt per call de 1-uurstier aanvragen.
Een paar toegangsdetails zijn handig om te weten voordat je erop gaat plannen:
Als je nog op K2-serie modellen zit: volgens Moonshots documentatie zijn die vanaf 31 oktober 2026 niet meer beschikbaar voor nieuwe gebruikers en worden ze tegen eind december 2026 uitgefaseerd.
Je kunt Kimi K3.1 Pro vandaag gebruiken via de Kimi API, OpenRouter en Kimi’s eigen apps, maar nog niet als downloadbare weights. Moonshot zegt dat de volledige weights uiterlijk 4 november 2026 worden vrijgegeven, en de aankondiging noemt geen licentievoorwaarden, dus check de modelkaart zodra de weights beschikbaar zijn.
kimi-k3.1-pro en kimi-k3.1-pro-highspeed, op een OpenAI-compatibele endpoint.moonshotai/kimi-k3.1-pro./model-commando. Moonshots docs behandelen ook de koppeling met Codex via de Kimi Responses API.Een minimale call met de OpenAI Python-client ziet er zo uit:
from openai import OpenAI

client = OpenAI(api_key="YOUR_MOONSHOT_API_KEY", base_url="https://api.moonshot.ai/v1")
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    reasoning_effort="high",
    messages=[{"role": "user", "content": "Find the bug in this function..."}],
)
print(response.choices[0].message.content)
Zodra de weights er zijn, behandelt onze gids over LLM’s lokaal draaien de serveeropties, en onze uitleg over OpenCode laat zien hoe je een model als dit in een open-source codeeragent plugt.
Kimi K3.1 Pro is tot nu toe het sterkste bewijs dat open-weight modellen de gesloten frontier kunnen evenaren op agentisch coderen, tegen een prijs onder zijn eigen voorganger. Het is geen leider in algemeen redeneren, maar voor lange coding en tool-intensief agentwerk staat het pal naast Claude Opus 5.5 en voor GPT-6 Astra op verschillende taken.
Moonshot gokt er ook op dat het publiceren van zijn cybertrade-offs goodwill oplevert voor zijn open releases. Als je met agents codeert, zou ik het nu via de API proberen en zelfhosting opnieuw bekijken zodra de weights en de modelkaart in november landen.
Ben je enthousiast om met dit soort open modellen te werken, bekijk dan zeker onze skill track Hugging Face Fundamentals.
Leer AI met DataCamp!
Cursus
Leerpad
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

