
Leerpad
AI-toepassingen ontwikkelen
21 uur
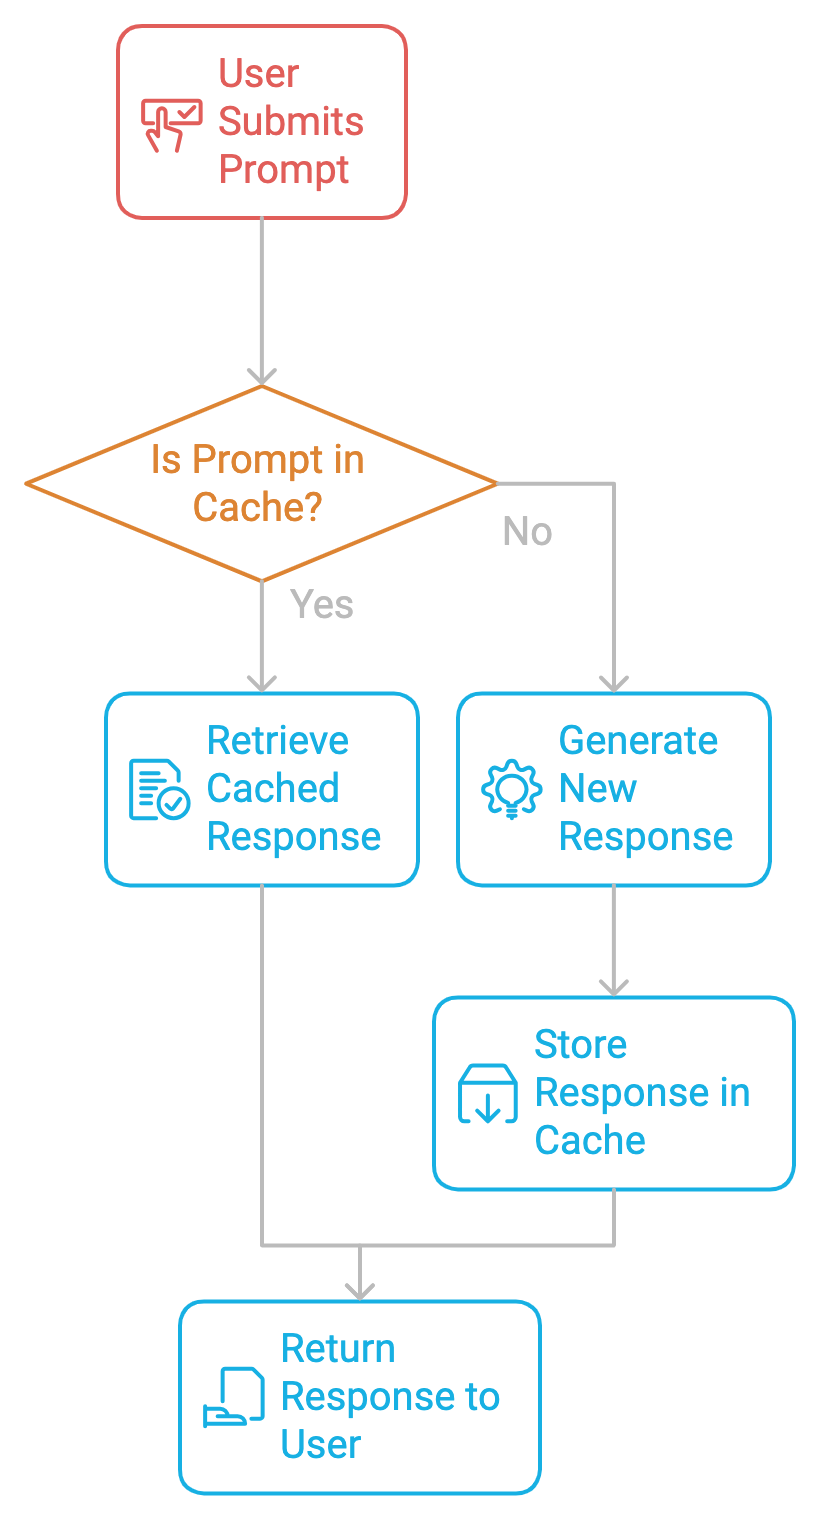
In de kern werkt prompt caching door prompts en de bijbehorende antwoorden in een cache op te slaan. Wanneer dezelfde of een vergelijkbare prompt opnieuw wordt ingediend, haalt het systeem het gecachte antwoord op in plaats van een nieuw antwoord te genereren. Dit voorkomt repetitieve berekeningen, versnelt reactietijden en verlaagt de kosten.
Prompt caching heeft verschillende voordelen:
Voordat we dieper ingaan op de implementatie van prompt caching, moeten we met een paar zaken rekening houden.
Om gegevens actueel te houden, zou elk gecacht antwoord een Time-to-Live (TTL) in het geheugen moeten hebben. De TTL bepaalt hoe lang een gecacht antwoord geldig is. Zodra de TTL verloopt, wordt het cache-item verwijderd of bijgewerkt en wordt de bijbehorende prompt opnieuw berekend wanneer deze weer wordt opgevraagd.
Dit mechanisme zorgt ervoor dat de cache geen verouderde informatie bevat. Bij statische of minder vaak bijgewerkte content, zoals juridische documenten of producthandleidingen, kan een langere TTL herberekening verminderen zonder het risico op verouderde data. Het juist afstemmen van TTL-waarden is dus essentieel om een balans te bewaren tussen actualiteit en rekenefficiëntie.
Soms zijn twee prompts vergelijkbaar maar niet identiek. Bepalen hoe dicht een nieuwe prompt bij een bestaande gecachte prompt ligt, is cruciaal voor effectieve caching. Het bepalen van promptovereenkomst vereist technieken zoals fuzzy matching of semantisch zoeken, waarbij het systeem vector-embeddings gebruikt om prompts te representeren en hun overeenkomst te vergelijken.
Door antwoorden voor vergelijkbare prompts te cachen, kunnen systemen herberekening verminderen en toch een hoge nauwkeurigheid behouden. Stel je drempel echter niet te ruim in, want dat kan tot mismatches leiden; te streng instellen kan cachingkansen missen.
Strategieën zoals Least Recently Used (LRU) helpen de cachegrootte te beheren. De LRU-methode verwijdert de minst geraadpleegde data wanneer de cache zijn capaciteit bereikt. Dit werkt goed in scenario’s waar bepaalde prompts populairder zijn en in de cache moeten blijven, terwijl minder voorkomende vragen kunnen worden verwijderd om ruimte te maken voor nieuwe verzoeken.
Prompt caching implementeren bestaat uit twee stappen.
De eerste stap is het identificeren van vaak herhaalde prompts in het systeem. Of je nu een chatbot, code-assistent of documentverwerker bouwt, je moet bijhouden welke prompts regelmatig terugkomen. Als die eenmaal zijn geïdentificeerd, kun je ze cachen om dubbele berekening te voorkomen.
Zodra een prompt is geïdentificeerd, wordt het antwoord in de cache opgeslagen met metadata zoals time-to-live (TTL), cache hit/miss-ratio’s en meer. Telkens wanneer een gebruiker dezelfde prompt opnieuw indient, haalt het systeem het gecachte antwoord op en slaat het dure generatieproces over.
Met alle theorie op zak duiken we in een praktische hands-on demo met Ollama om het effect van caching versus geen caching in een lokale omgeving te verkennen. We gebruiken data uit een online deep-learningboek en lokale modellen om de eerste pagina’s te samenvatten. We experimenteren met meerdere LLM’s, waaronder Gemma2, Llama2 en Llama3, om hun prestaties te vergelijken.
Voor dit hands-on voorbeeld gebruiken we BeautifulSoup, een Python-pakket dat HTML- en XML-documenten parseert, ook wanneer de markup niet helemaal netjes is. Installeer BeautifulSoup met:
!pip install BeautifulSoupEen ander hulpmiddel is Ollama. Dit vereenvoudigt de installatie en het beheer van grote taalmodellen op lokale systemen.
Download en installeer Ollama op je desktop om te beginnen. We kunnen de modelnaam variëren afhankelijk van onze behoeften. Bekijk de bibliotheek op de officiële website van Ollama om te zien welke modellen beschikbaar zijn. Voer de volgende code uit in de terminal:
ollama run llama3.1 We zijn er klaar voor. Aan de slag!
We beginnen met de volgende imports:
time om de inferentietijd bij te houden voor code met en zonder cachingrequests om HTTP-verzoeken te doen en data van webpagina’s op te halenBeautifulSoup voor het parsen en opschonen van HTML-inhoudOllama om lokaal LLM’s te gebruikenimport time
import requests
from bs4 import BeautifulSoup
import ollamaIn de onderstaande code definiëren we een functie fetch_article_content die de tekstinhoud van een opgegeven URL ophaalt en opschoont. De functie probeert de webpagina op te halen met de bibliotheek requests, met maximaal drie pogingen bij fouten zoals netwerkproblemen of serverissues.
De functie gebruikt BeautifulSoup om de HTML te parsen en verwijdert onnodige <script>- en <style>-tags. De tekst wordt verder opgeschoond door spaties aan het begin en eind te strippen, regels te splitsen en opnieuw samen te voegen tot nette alinea’s. Als een limiet is opgegeven, wordt de tekst tot die lengte ingekort. Als alle pogingen mislukken, geeft de functie een uitzondering, na een korte wachttijd tussen de pogingen.
Hier zijn enkele belangrijke parameters:
BeautifulSoup om overbodige elementen zoals <script> en <style> te verwijderen.def fetch_article_content(url, retries=3, content_limit=None):
attempt = 0
while attempt < retries:
try:
response = requests.get(url, timeout=30) # Add timeout to prevent hanging
response.raise_for_status() # Raise an error for bad responses (4xx, 5xx)
soup = BeautifulSoup(response.content, 'html.parser')
# Remove script and style elements
for script in soup(["script", "style"]):
script.decompose()
# Get text
text = soup.get_text()
# Break into lines and remove leading and trailing space on each
lines = (line.strip() for line in text.splitlines())
chunks = (phrase.strip() for line in lines for phrase in line.split(" "))
text = '\n'.join(chunk for chunk in chunks if chunk)
# Limit content if specified
if content_limit:
text = text[:content_limit]
return text
except (requests.exceptions.RequestException, requests.exceptions.ChunkedEncodingError) as e:
attempt += 1
print(f"Attempt {attempt} failed: {e}")
if attempt >= retries:
raise
time.sleep(2) # Wait before retryingVervolgens halen we de content van een boek op voor inferentie. We gebruiken een URL naar een deep-learningboek van Ian Goodfellow, Yoshua Bengio en Aaron Courville en passen de functie fetch_article_content toe om de eerste 200.000 tekens te extraheren. We printen de eerste 500 tekens als voorvertoning.
book_url = "https://www.deeplearningbook.org/contents/intro.html"
book_content = fetch_article_content(book_url, content_limit=200000)
print(f"Fetched {len(book_content)} characters from the book.")
print("First 500 characters:")
print(book_content[:500])Nu we de data hebben opgehaald en opgeschoond, voeren we inferentie zonder caching uit met Llama3 via Ollama. Via Ollama zijn lokaal verschillende taalmodellen beschikbaar om mee te experimenteren.
Voor inferentie zonder caching genereren we een samenvatting van het boek zonder cache. We starten met het vastleggen van de starttijd en genereren een antwoord met de functie ollama.generate(). Zodra het antwoord is gegenereerd, gebruiken we response.get() om de respons te controleren en de samenvatting te extraheren.
Let op: we kijken alleen naar de tijd die nodig is om de respons te genereren (dus vóór en na de functie generate()).
def make_non_cached_inference(prompt):
    start_time = time.time()
    response = ollama.generate(model="llama3", prompt=prompt)
    end_time = time.time()
    # Print the response to inspect its structure
    print(f"Full response: {response}")
    # Access the generated summary
    generated_summary = response.get('response', 'No summary found in response')
    return generated_summary, end_time - start_time
Enkele kernpunten bij de bovenstaande code:
llama3) en ontvangt de respons..get() om KeyError te voorkomen).Na inferentie zonder caching experimenteren we met inferentie mét caching. De volgende functie genereert een boeksamenvatting met een gecacht resultaat als dat beschikbaar is. Net als in de vorige stap produceren we de respons met dezelfde code. Het enige verschil is een vroege controle of de prompt al in de cache staat. Zo ja, dan voert het model geen inferentie uit maar gebruikt het het bestaande gecachte antwoord; anders wordt het resultaat in de cache opgeslagen voor toekomstig gebruik.
def make_cached_inference(prompt, cache):
    if prompt in cache:
        print("Using cached result...")
        return cache[prompt], 0  # Return cached response with 0 latency
    start_time = time.time()
    response = ollama.generate(model="llama3", prompt=prompt)
    end_time = time.time()
    # Print the response to inspect its structure (if needed)
    print(f"Full response (cached call): {response}")
    # Access the generated summary
    generated_summary = response.get('response', 'No summary found in response')
    cache[prompt] = generated_summary  # Store result in cache
    return generated_summary, end_time - start_time
Belangrijke punten uit de bovenstaande code:
Nu alle functies klaarstaan, is dit de prompt waarmee we werken. Experimenteer er gerust mee. Hij gebruikt de eerste 10.000 tekens van het boek en vraagt het model om een samenvatting te genereren.
prompt = f"<book>{book_content[:10000]}</book>\nPlease provide a summary of this book."We voeren nu zowel de aanroep zonder als met caching uit om de samenvatting te genereren en tonen de benodigde tijd en de samenvatting voor elke techniek. Als het resultaat is gecached, retourneert het de gecachte samenvatting met nul latentie; anders wordt het resultaat opgeslagen voor toekomstig gebruik.
non_cached_response, non_cached_time = make_non_cached_inference(prompt)
print(f"Non-cached inference time: {non_cached_time:.2f} seconds")
print(f"Non-cached summary: {non_cached_response}")
cache = {}

# Cached inference to generate a summary
cached_response, cached_time = make_cached_inference(prompt, cache)
print(f"Cached inference time: {cached_time:.2f} seconds")
print(f"Cached summary: {cached_response}")
De code laat zien hoe caching dubbele berekeningen voorkomt door het resultaat op te slaan voor toekomstige queries. Gecachte resultaten leiden tot aanzienlijk lagere latentie voor herhaalde prompts, wat we in de volgende sectie zullen zien.
Met de bovenstaande code hebben we met vier verschillende modellen op de gedefinieerde data geëxperimenteerd.
|
Model |
Inferentietijd zonder caching |
Inferentietijd met caching |
|
Llama2 |
143,98 seconden |
65,84 seconden |
|
Llama3 |
151,79 seconden |
42,48 seconden |
|
Gemma2 |
170,43 seconden |
61,84 seconden |
|
Phi3 |
239,55 seconden |
100,86 seconden |
Op basis van de inferentietijden uit onze experimenten met deze vier modellen is het duidelijk dat gecachte inferentie de inferentietijd sterk vermindert.
Omdat caching het geheugen van je systeem gebruikt, is het belangrijk om enkele werkwijzen te overwegen die kosten en geheugengebruik helpen beperken.
Breng delen van je toepassing in kaart waar dezelfde of vergelijkbare prompts herhaaldelijk voorkomen. Denk aan veelgestelde klantenservicetrajes zoals “Hoe verander ik mijn pincode?”, frequente codevragen zoals “Hoe schrijf ik Hello World in Python?”, of terugkerende delen van lange documenten zoals “summarize this book/paper”. Door deze te cachen maximaliseer je de efficiëntie.
Een consistente structuur bij het indienen van prompts aan een LLM helpt de cache-hitratio te verhogen. Een goede formatstructuur kan bestaan uit beknopte gebruikersinvoer gevolgd door voorbeelden. Hoe consistenter je instructies, hoe groter de kans op overeenkomende of vergelijkbare gecachte prompts.
Een goed beheerde cache balanceert geheugenbeperkingen en prestatiebehoeften zonder onnodige overhead. Afhankelijk van de eisen van de toepassing zorgt een optimale cachegrootte en een uitzetbeleid (zoals LRU) voor efficiënte prestaties zonder het geheugen onnodig te belasten.
Het monitoren van cache-hitratio’s is cruciaal om de effectiviteit van je cachingstrategie te beoordelen. Als de hitratio laag is, overweeg dan de similariteitsdrempels aan te passen, de cache te vergroten of je promptstructuur consistenter te maken.
De bovenstaande cachingpraktijken kun je combineren met beproefde opslagpraktijken om toepassingen optimaal te laten draaien. Vervolgens verkennen we enkele technieken voor cache-opslag en -deling.
Gecachte prompts kunnen lokaal (op één machine) of gedistribueerd over meerdere servers worden opgeslagen. Lokale caches zijn eenvoudiger te beheren maar kunnen moeite hebben met grootschalige toepassingen. Gedistribueerde caches kunnen een veel grotere gebruikersbasis bedienen en hogere loads aan, maar brengen extra complexiteit en kosten met zich mee.
Voor organisaties met meerdere gebruikers of applicaties kan het delen van gecachte prompts over systemen heen de kosten verlagen en de prestaties verbeteren door gecentraliseerde toegang te bieden tegen minimale kosten. Door de cache te centraliseren, profiteren alle gebruikers van eerder opgeslagen antwoorden en worden dubbele berekeningen voorkomen.
Privacy is een belangrijk aandachtspunt bij het cachen van data, zeker bij gebruikersinvoer en -antwoorden. Versleutel gevoelige gegevens en stel toegangscontrole in zodat alleen geautoriseerde gebruikers bij de cache kunnen. Meerdere versleutelingsalgoritmen worden gebruikt om de data van de gebruiker te beschermen. Een andere veelgebruikte praktijk is berekeningen lokaal uit te voeren zodat de data het apparaat nooit verlaat.
In omgevingen waar gecachte prompts door meerdere gebruikers of applicaties worden gedeeld, helpen technieken zoals cache warm-up en keep-alive pings de beschikbaarheid en versheid van gedeelde data te behouden. Dit verkleint de kans op cachemisses en zorgt voor een consistente, snelle gebruikerservaring op het netwerk. Laten we deze technieken beter begrijpen.
Een manier om te zorgen dat de cache altijd relevante data bevat, is de cache "op te warmen" door deze vooraf te vullen met veelgebruikte prompts. Dit is nuttig om de latentie in de eerste interacties na het opstarten te verlagen. In een e-commercechatbot kun je bijvoorbeeld veelgestelde vragen zoals “Wat is jullie retourbeleid?” of “Waar is mijn bestelling?” vooraf cachen om vanaf het begin directe reacties te geven. Cache warm-up is ook handig na herstarts, updates of deploys om een koude start te vermijden waarbij de cache leeg is en reacties aanvankelijk trager zijn.
Om te voorkomen dat cache-items verlopen door inactiviteit, kunnen periodieke keep-alive pings worden verstuurd om ervoor te zorgen dat populaire gecachte prompts langer vers en beschikbaar blijven. Keep-alive pings verversen periodiek specifieke cache-items, met name die gekoppeld zijn aan veelgevraagde prompts, zodat deze beschikbaar blijven, ook als ze recent niet zijn gebruikt.
Dit is vooral nuttig bij toepassingen met cyclische verkeerspatronen, zoals seizoenspieken in e-commerce of piekuren in klantenondersteuning.
Kostenoptimalisatie staat centraal bij elke AI-toepassing, van het aantal API-calls tot het totale geheugengebruik.
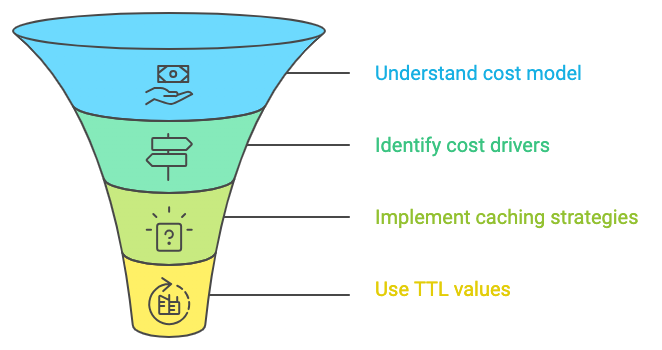
Bij het werken met tal van cachingvoorbeelden kun je enkele problemen tegenkomen die eenvoudig te verhelpen zijn. Enkele daarvan:
Een cache miss treedt op wanneer een prompt niet in de cache wordt gevonden. Dit kan komen door inconsistente promptstructuren of te strikte similariteitsdrempels. Om dit te verhelpen, beoordeel je de prompts op consistentie en pas je de drempel aan zodat kleine variaties worden toegestaan. Stel dat een klantenservicebot vaak de prompt “What is your refund policy?” krijgt en het antwoord cachet. Als een gebruiker dan vraagt: “Can you tell me about your return policy?” en de similariteitsdrempel te streng is, ziet het systeem dit niet als gelijksoortig, met een cache miss tot gevolg.
Cache-invalidering is nodig wanneer de onderliggende data of het model verandert. Je kunt automatische invalideringsregels instellen om cache-items te verversen, of handmatig specifieke items ongeldig maken wanneer dat nodig is. Stel dat een financiële app antwoorden over belastingregels cachet. Als de wetgeving wijzigt, raken de gecachte antwoorden verouderd. Het systeem kan dan een automatisch invalideringsbeleid hanteren dat de cache ververst of leegt na een regelgevingsupdate.
In dit artikel hebben we het concept van prompt caching en de implementatie met Ollama verkend. We hebben laten zien hoe prompt caching de inferentietijd en de kosten van LLM’s aanzienlijk kan verlagen.
Leer AI met deze cursussen!
Leerpad
Cursus
Cursus
blog
Adel Nehme
15 min

