
Leerpad
Basisprincipes van AI-agenten
6 uur
Autonome AI-agents zijn krachtige systemen, maar precies die kracht kan ze ook gevaarlijk maken.
OpenClaw en vergelijkbare agentframeworks gaan verder dan alleen tekst genereren. Ze voeren code uit, wijzigen bestanden, roepen API’s aan en communiceren direct met andere systemen. Dat betekent dat er een verschuiving plaatsvindt van "denken" naar "doen", wat het beveiligingsmodel fundamenteel verandert.
Elke fout kan echte gevolgen hebben. Alle systeemacties die door OpenClaw worden uitgevoerd, lijken meer op back-endservices met echte operationele rechten dan op een simpele conversatie-interface.
In deze gids behandel ik de beveiligingsaspecten van het draaien van OpenClaw en best practices om ervoor te zorgen dat je implementatie rekening houdt met potentiële risico’s.
Als je nog niet bekend bent met de concepten achter tools zoals OpenClaw, raad ik onze cursus Introduction to AI Agents aan.
OpenClaw (voorheen bekend als Clawdbot en kort Moltbot) is een open-source framework voor autonome agents dat een large language model (LLM) koppelt aan een set uitvoerbare tools. Deze tools kunnen onder meer bestaan uit:
In tegenstelling tot een simpele chatbot die alleen tekst retourneert, stelt OpenClaw het model in staat echte acties te ondernemen binnen jouw omgeving. In de praktijk lijkt het daardoor meer op een automatiseringsengine of DevOps-hulpmiddel dan op een basisconversatie-assistent.
Het kernrisico volgt logisch uit die mogelijkheid: tekst is meestal onschadelijk, maar acties niet.
Acties die door een agent worden uitgevoerd, kunnen zijn:
Als de agent wordt beïnvloed door kwaadaardige input of slecht gestructureerde prompts, kunnen die acties ongewenste gevolgen hebben. Simpele LLM-veiligheidsmaatregelen zoals trefwoordfiltering of moderatie van reacties zijn in deze context niet voldoende.
Een prompt injection-aanval kan het model bijvoorbeeld misleiden om gevoelige bestanden op te halen of een API-token verkeerd te gebruiken.
Als je alternatieve frameworks voor OpenClaw evalueert, bekijk dan onze vergelijkingsgids hier.
Laten we eens kijken wat je kunt doen om de beveiliging van je implementatie te verbeteren.
Begin met duidelijkheid creëren rond je OpenClaw-instantie. Zonder helder beeld van wat er is en waartoe het toegang heeft, is zinvolle bescherming onmogelijk.
Voordat je firewallregels of containerinstellingen wijzigt, neem de tijd om de huidige omgeving in kaart te brengen. Veel beveiligingsincidenten ontstaan niet door geavanceerde exploits, maar door vergeten testservers of te ruime toegangsrechten die zijn blijven staan.
Begin met het identificeren van elke draaiende instantie van OpenClaw:
Het komt vaak voor dat je vergeten cloudservers ontdekt, containers die zijn blootgesteld met -p 0.0.0.0:3000:3000, of tijdelijke tunnels zoals Ngrok die nooit zijn afgesloten. Dergelijke experimentele setups overleven vaak hun oorspronkelijke doel en zouden niet in leven gehouden moeten worden.
Vervolgens identificeer je je "kroonjuwelen". Dit zijn de gevoelige assets waartoe de agent toegang kan hebben, zoals:
Beoordeel voor elk credential het bereik en de privileges. Zo brengt toegang op beheerdersniveau aanzienlijk meer risico met zich mee dan alleen-lezen toegang. Een helder beeld van deze privileges helpt de potentiële schade te kwantificeren.
Een vraag die ik nuttig vind om jezelf te stellen: “Als de agent vandaag volledig wordt gecompromitteerd, wat zou er dan realistisch kunnen gebeuren?”
Noteer ook onmiddellijke risico’s, waaronder:
Door deze bevindingen vast te leggen, creëer je een nulmeting en worden verbeteringen meetbaar.
Voor meer volwassen implementaties is het verstandig een model met beveiligingstiers te hanteren.
Een getierd model biedt structuur en duidelijkheid. Niet elke implementatie heeft enterprise-controles nodig, maar elke implementatie moet wel bewust gecategoriseerd worden.
Dit zijn de 3 hoofdtiers:
Deze tier is geschikt voor experimenten en leeromgevingen waar geen gevoelige data bij betrokken is.
Op dit niveau kan de agent met gedeelde repositories of interne API’s werken, wat sterkere vangrails vereist.
Deze tier is ontworpen voor omgevingen die gereguleerde data of financiële operaties afhandelen.
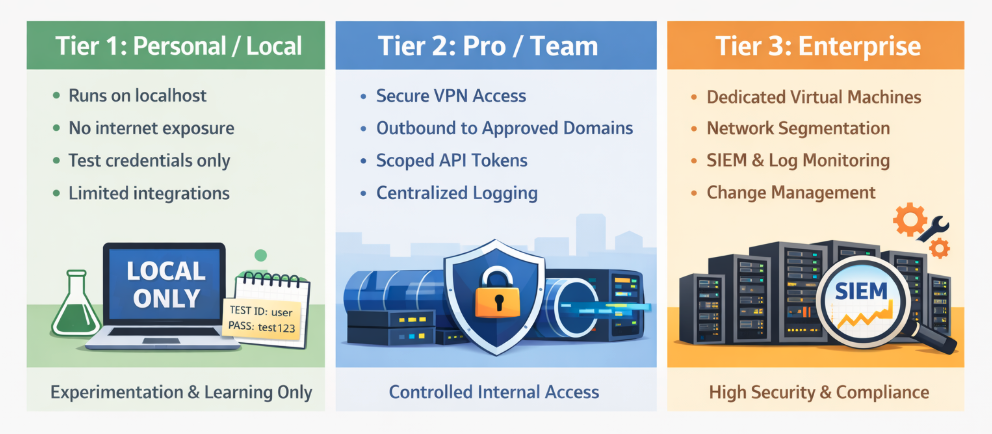
De sleutel is niet om standaard het hoogste tier te kiezen, maar om duidelijk te begrijpen welk tier van toepassing is en waarom.
Een staging- of “safe lab”-omgeving biedt ruimte om beveiligingswijzigingen te testen zonder productiesystemen te riskeren. Dit zou een eenvoudige testomgeving moeten zijn waar wijzigingen geen gevolgen in de echte wereld hebben.
Deze omgeving moet echter wel de productiearchitectuur weerspiegelen, maar dan met sandbox- of dummy-credentials. Denk aan test-cloudaccounts, mock-API’s en interne e-mail-sandboxes voor realistische tests zonder echt risico.
Een gedocumenteerde “break glass”-procedure is ook aan te raden. Een “break glass”-procedure is een herstelplan dat uitlegt hoe je de toegang herstelt als firewallregels of containerrestricties per ongeluk beheerders blokkeren.
Als een agent van buitenaf bereikbaar is, kan hij worden aangevallen. Daarom moet je inkomende toegang beheren. Dit is je eerste zichtbare verdedigingslaag.
De veiligste standaardconfiguratie bindt de applicatie aan het localhost-IP 127.0.0.1, zodat deze alleen toegankelijk is vanaf de lokale machine.
app.listen(3000, "127.0.0.1");Daarnaast is verificatie belangrijk. Een poortscan vanaf een ander apparaat met nmap moet bevestigen dat er geen poorten zijn blootgesteld.
sudo nmap -p- -sS <target_IP>Houd er ook rekening mee dat Docker UFW op Linux-hosts of andere hostfirewalls kan omzeilen, omdat het netwerkinstellingen rechtstreeks wijzigt.
Wanneer je een poort publiceert met -p 0.0.0.0:3000:3000, kan Docker die poort blootstellen, zelfs als je hostfirewall hem ogenschijnlijk blokkeert. Met andere woorden: alleen op firewalls vertrouwen is niet genoeg als Docker in het spel is.
Een snelle manier om te verifiëren wat Docker daadwerkelijk blootstelt, is de gepubliceerde poorten controleren:
docker port <container_name>
Look for 0.0.0.0:3000->3000/tcp (exposed publicly) versus 127.0.0.1:3000->3000/tcp (localhost-only).
Linux users can also inspect active Docker iptables rules:
```bash
sudo iptables -L DOCKER -n -v
Als je 0.0.0.0:PORT-bindings of ACCEPT-regels in de DOCKER-keten ziet, is die poort extern bereikbaar tenzij expliciet beperkt.
Je kunt dit ook extern bevestigen vanaf een andere machine met nmap:
nmap -p 3000 <target_IP>Dit commando scant je doel van buitenaf om te bevestigen dat poort 3000 daadwerkelijk gesloten/gefilterd is, wat bewijst dat er geen externe toegang is.
De best practice is om expliciet te binden aan localhost (127.0.0.1) in het Docker run-commando:
docker run -p 127.0.0.1:3000:3000 openclawBevestig dit vervolgens met zowel docker port als een externe nmap-scan vanaf een andere machine.
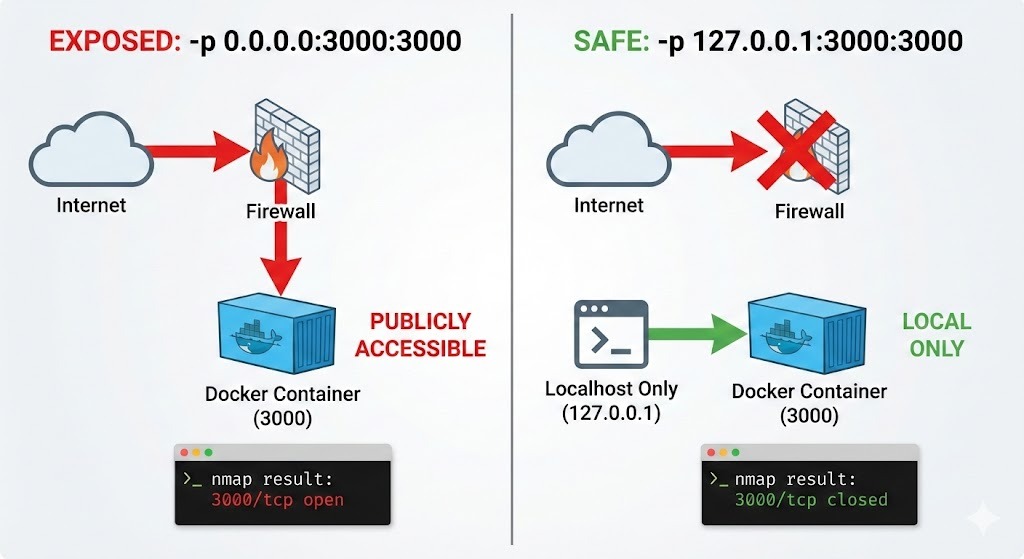
Wanneer externe toegang nodig is, is het zelden gerechtvaardigd om de applicatie rechtstreeks aan het publieke internet bloot te stellen.
Een VPN zoals Tailscale of WireGuard kan worden gebruikt om versleutelde, geauthenticeerde connectiviteit tussen vertrouwde apparaten tot stand te brengen. Deze aanpak vermindert de blootstelling drastisch in vergelijking met het openlaten van poorten.
Waar browsertoegang vereist is, kan een reverse proxy zoals Nginx HTTPS-verbindingen termineren en authenticatie afdwingen voordat verkeer de applicatie bereikt.
Sessiebeheer vraagt ook om zorgvuldige aandacht. Zwakke sessiecontroles kunnen anders sterke perimetrische verdediging ondermijnen.
Sterke wachtwoorden gebruiken, regelmatig credentials roteren en rate limiting op login-endpoints helpt tegen brute-force-aanvallen. Korte sessieduur verkleint bovendien de bruikbaarheid van gestolen tokens.
Beveiligde cookies, SameSite-attributen en CSRF-bescherming blijven relevant, ook als de backend een AI-gestuurde agent is. De omliggende webinfrastructuur moet net zo hard worden gehard als elke andere applicatie.
Zelfs met sterke perimetercontroles blijft misbruik mogelijk. Containment- en isolatiestrategieën zijn cruciaal om te bepalen hoe ver een incident zich kan verspreiden.
De container als niet-rootgebruiker draaien verkleint de impact van mogelijke escape-kwetsbaarheden.
Onnodige Linux-capabilities moeten ook worden verwijderd om het aanvalsoppervlak te verkleinen. Containers draaien vaak met meer privileges dan nodig, en het verwijderen van ongebruikte capabilities beperkt wat een aanvaller kan doen.
Al deze maatregelen versterken hetzelfde idee: zelfs als de agent zich misdraagt, mag hij het hostsysteem niet kunnen overnemen.
Hieronder staat een eenvoudig docker run-voorbeeld dat de syntaxis laat zien voor het instellen van een niet-rootgebruiker, zonder specifieke Linux-capabilities, en met een alleen-lezen bestandssysteem.
docker run \
  --name openclaw-secure \
  --user 1000:1000 \
  --read-only \
  --cap-drop=CAP_SYS_ADMIN \
  --cap-drop=CAP_NET_RAW \
  -v openclaw-workspace:/app/workspace \
  -p 127.0.0.1:3000:3000 \
  openclaw:latest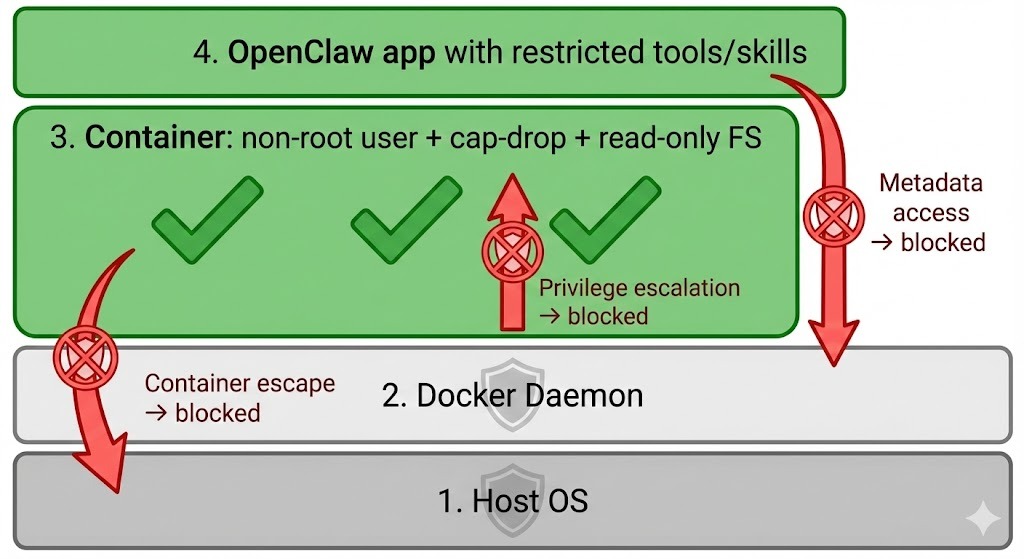
Voor teams die Docker Compose gebruiken gelden dezelfde principes. Een minimale geharde docker-compose.yml-snippet kan er zo uitzien:
version: "3.9"

services:
  openclaw:
    image: openclaw:latest
    user: "1000:1000"
    read_only: true
    cap_drop:
      - CAP_SYS_ADMIN
      - CAP_NET_RAW
    ports:
      - "127.0.0.1:3000:3000"
    volumes:
      - openclaw-workspace:/app/workspace

volumes:
  openclaw-workspace:
Belangrijk om te verduidelijken is dat deze Linux-capabilitybeperkingen ook verplicht blijven wanneer je Docker op macOS of Windows draait. Hoewel die systemen geen Linux zijn, draaien Docker Desktop-containers binnen een verborgen Linux-VM.
Met andere woorden: op macOS of Windows vervalt de noodzaak voor containerhardening niet.
Uitgaande filtering wordt vaak over het hoofd gezien, maar is cruciaal. Ernstige incidenten, zoals data-exfiltratie, verlopen via zulke uitgaande kanalen.
Een standaard “deny all” voor uitgaand verkeer dwingt beheerders om expliciet goedgekeurde domeinen toe te staan. Verkeer beperken tot noodzakelijke eindpunten, zoals API-providers en interne services, verkleint dit risico drastisch.
Toegang tot cloud-metadata-services blokkeren voorkomt ook onbedoelde blootstelling van instance-credentials.
Linux-cloudinstances (AWS/GCP/Azure) stellen tijdelijke credentials beschikbaar via het link-local IP 169.254.169.254. OpenClaw kan dit endpoint per ongeluk bevragen en instancemetadata lekken. Je kunt uitgaand verkeer naar het metadata-IP expliciet droppen:
sudo iptables -A OUTPUT -d 169.254.169.254 -j DROPOm te verifiëren, voer je het volgende uit:
sudo iptables -L -n -vDit zorgt ervoor dat zelfs als de agent de metadataservice probeert te bereiken, het verkeer de host nooit verlaat.
Als je de regel specifiek wilt toespitsen op Docker-verkeer, kun je hem blokkeren in de DOCKER-USER-keten (die wordt geëvalueerd vóór Docker’s eigen regels):
sudo iptables -I DOCKER-USER -d 169.254.169.254 -j DROPDeze aanpak is vaak veiliger omdat Docker iptables-regels dynamisch wijzigt. De DOCKER-USER-keten is specifiek bedoeld voor door de gebruiker gedefinieerde beperkingen.
Je kunt bevestigen dat de regel actief is met:
sudo iptables -L DOCKER-USER -n -vGevoelige hostmappen zoals ~/.ssh of /etc mogen nooit worden gemount, tenzij het absoluut noodzakelijk is.
Gebruik ook vluchtige containers voor een extra beschermingslaag.
Die functioneren als een schone container voor elke taak en worden daarna vernietigd. Dat maakt langdurige persistentie veel moeilijker. Dit soort tijdelijke omgevingen verkleint de kans dat een aanvaller voet aan de grond krijgt.
Elke extra tool breidt de mogelijkheden uit. Maar met die extra mogelijkheden komt ook extra risico.
Secrets moeten tijdens runtime worden geïnjecteerd via omgevingsvariabelen of een secretmanagementsysteem. Het inbedden van inloggegevens in broncode, prompts of containerimages creëert onnodige blootstelling.
Periodieke audits van gekoppelde integraties helpen ook om ongebruikte credentials te verwijderen. Credentials zonder doel vergroten alleen het aanvalsoppervlak.
Autonome agents kunnen worden uitgebreid met skills en extra componenten. Met die uitbreiding komt extra risico. Het beveiligen van de skill-supplychain betekent dat je extensies van derden met dezelfde voorzichtigheid behandelt als productiedependencies in een backendapplicatie.
Plugins automatisch laten updaten zonder controle introduceert supplychainrisico.
In zo’n scenario kan een nieuwe release onbedoeld kwetsbaarheden introduceren, of in het slechtste geval kan een gecompromitteerd pakket kwaadaardig gedrag bevatten.
Om dit risico te verkleinen, moet je skills vastzetten op specifieke versies en, waar mogelijk, op exacte hashes.
Bijvoorbeeld:
"web-browser-skill": "1.4.2#sha256:abc123"Vastpinnen zorgt ervoor dat precies de code die je in staging hebt getest, ook in productie draait. Het voorkomt stille upgrades en verkleint de kans op supplychainvergiftiging via dependency-hijacking of kwaadaardige updates.
Deze aanpak weerspiegelt best practices in softwareontwikkeling, waar productiesystemen afhankelijkheidsversies vergrendelen om onvoorspelbaar gedrag te vermijden.
Voordat je een nieuwe skill inschakelt, moet je de broncode even doornemen. Autonome agents werken vaak met API-tokens, bestands toegang of netwerkrechten.
Als de broncode van de skill slecht is geschreven, kan een kwaadaardige plugin die privileges stilletjes misbruiken.
Let goed op gedrag zoals:
Zelfs een ogenschijnlijk onschuldige browsingtool kan data exfiltreren als er verborgen netwerkcalls in zitten. Een snelle code review kan duidelijke rode vlaggen blootleggen en het risico aanzienlijk verkleinen.
Veel agentframeworks worden geleverd met meerdere ingebouwde tools, zoals shelltoegang, Python-uitvoering, bestandseditors of webbrowsers. Flexibiliteit is handig tijdens experimenten, maar productie-implementaties moeten minimaal blijven.
Elke ingeschakelde tool vertegenwoordigt een capaciteit die kan worden misbruikt. Onnodige tools verwijderen verkleint het aanvalsoppervlak en beperkt wat de agent kan doen als hij wordt gecompromitteerd.
AI-systemen introduceren nieuwe en unieke gedragsrisico’s die verschillen van traditionele softwarekwetsbaarheden. Laten we kijken naar enkele potentiële risico’s en oplossingen bij OpenClaw.
Omdat OpenClaw voor zijn output afhankelijk is van prompt engineering, moet externe content altijd als onbetrouwbare input worden behandeld. Webpagina’s, e-mails en documenten kunnen bijvoorbeeld verborgen instructies bevatten die het model proberen te beïnvloeden. Dat kan tot een kwaadaardig resultaat leiden.
Prompt injection maakt misbruik van de instructievolgende aard van het model. Verborgen HTML-comments of zorgvuldig geformuleerde tekst kunnen proberen systeemregels te overschrijven of gevoelige data te extraheren.
We kunnen enkele verdedigingsmaatregelen nemen om dit te voorkomen, waaronder:
Geheugen wissen tussen niet-gerelateerde taken kan de kans op onbedoelde datalekken verder verkleinen.
Voor implementaties op langere termijn heb je meer observability en monitoring nodig om zeker te zijn dat je modellen presteren zoals verwacht.
Uitgebreide logging moet prompts, modeluitvoer, tool-calls, bestandswijzigingen en API-interacties vastleggen. Gecentraliseerde opslag van logs helpt ook tegen manipulatie en ondersteunt incidentonderzoek.
Ik raad aan om alerts in te stellen voor ongebruikelijk gedrag (zoals onverwacht uitgaand verkeer of toegang tot systeem bestanden) om sneller te kunnen reageren.
Omdat beveiliging geen eenmalige configuratie is, moet je OpenClaw waar nodig ook bijwerken naar de nieuwste versie.
OpenClaw biedt veel potentieel voor lokale implementatie van LLM’s. Omdat de meeste op lokale machines draaien, is de beveiliging van je eigen machine belangrijk.
Zo moet een geharde OpenClaw-implementatie onbereikbaar blijven voor het publieke internet, werken binnen een beperkte runtime, smal gescope credentials gebruiken en uitgebreide logging bijhouden.
Wil je dit zelf implementeren, bepaal dan jouw specifieke tierstatus en werk de bijbehorende beveiligingsmaatregelen uit.
Meer ontdekken over de nieuwste AI-, LLM- en agenttechnologieën? Onze AI Agent Fundamentals-track is de beste start.
AI-cursussen
Leerpad
Cursus
Cursus
blog
Adel Nehme
15 min

