
Ga naar hoofdinhoud
Kunstmatige intelligentie
Large Language Models

Wat is Meta's Llama 3.3 70B? Werking, use cases en meer

Meta introduceert Llama 3.3, een model met 70 miljard parameters dat prestaties levert vergelijkbaar met Llama 3.1 405B, maar met aanzienlijk lagere rekenvereisten.
Alex Olteanu's photo
Josef Waples's photo
Alex Olteanu, Josef Waples
Bijgewerkt · 8 min lezen

Verken met AI

ChatGPTClaudePerplexity

Maak je gratis account aan

Oefen en volg je voortgang.

Ga Verder Met Google
Door verder te gaan accepteer je onze Gebruiksvoorwaarden, ons Privacybeleid en dat je gegevens worden opgeslagen in de VS.

Meta AI heeft zojuist Llama 3.3 geïntroduceerd, een model met 70 miljard parameters dat prestaties levert die vergelijkbaar zijn met de veel grotere Llama 3.1 405B, maar met veel lagere rekenvereisten.

We vinden dit vooral interessant omdat het hoogwaardige AI toegankelijker maakt voor ontwikkelaars die geen toegang hebben tot dure hardware.

Ontworpen voor tekstgebaseerde taken zoals meertalige chat, hulp bij coderen en synthetische datageneratie, richt Llama 3.3 zich uitsluitend op tekstinvoer en -uitvoer—het is niet gebouwd om afbeeldingen of audio te verwerken.

In deze blog lopen we door wat dit model onderscheidt en helpen we je bepalen of het goed past bij jouw projecten.

Wat is Llama 3.3?

Llama 3.3 is het nieuwste large language model van Meta AI, en wij zien het als een stap richting het toegankelijker maken van geavanceerde AI voor allerlei projecten. Met 70 miljard parameters biedt het prestaties die op één lijn liggen met de veel grotere Llama 3.1 405B, maar met aanzienlijk lagere hardware-eisen. Dit betekent dat we geavanceerde AI-toepassingen kunnen verkennen zonder dure, gespecialiseerde setups nodig te hebben.

Het model is specifiek ontworpen voor tekstinvoer en -uitvoer, dus het verwerkt geen beelden, audio of andere media. Wij hebben gemerkt dat het bijzonder effectief is voor taken zoals meertalige chat, hulp bij coderen en synthetische datageneratie. Met ondersteuning voor acht talen, waaronder Engels, Spaans, Hindi en Duits, is het een sterke optie voor projecten die meertalige mogelijkheden vereisen.

Wat voor ons opvalt, is de focus op efficiëntie. Llama 3.3 is geoptimaliseerd om te draaien op gangbare GPU’s, waardoor lokale implementaties praktisch zijn en experimenteren makkelijker wordt. Het model bevat ook alignment-technieken om ervoor te zorgen dat de antwoorden behulpzaam en veilig zijn, wat essentieel is voor gevoelige toepassingen.
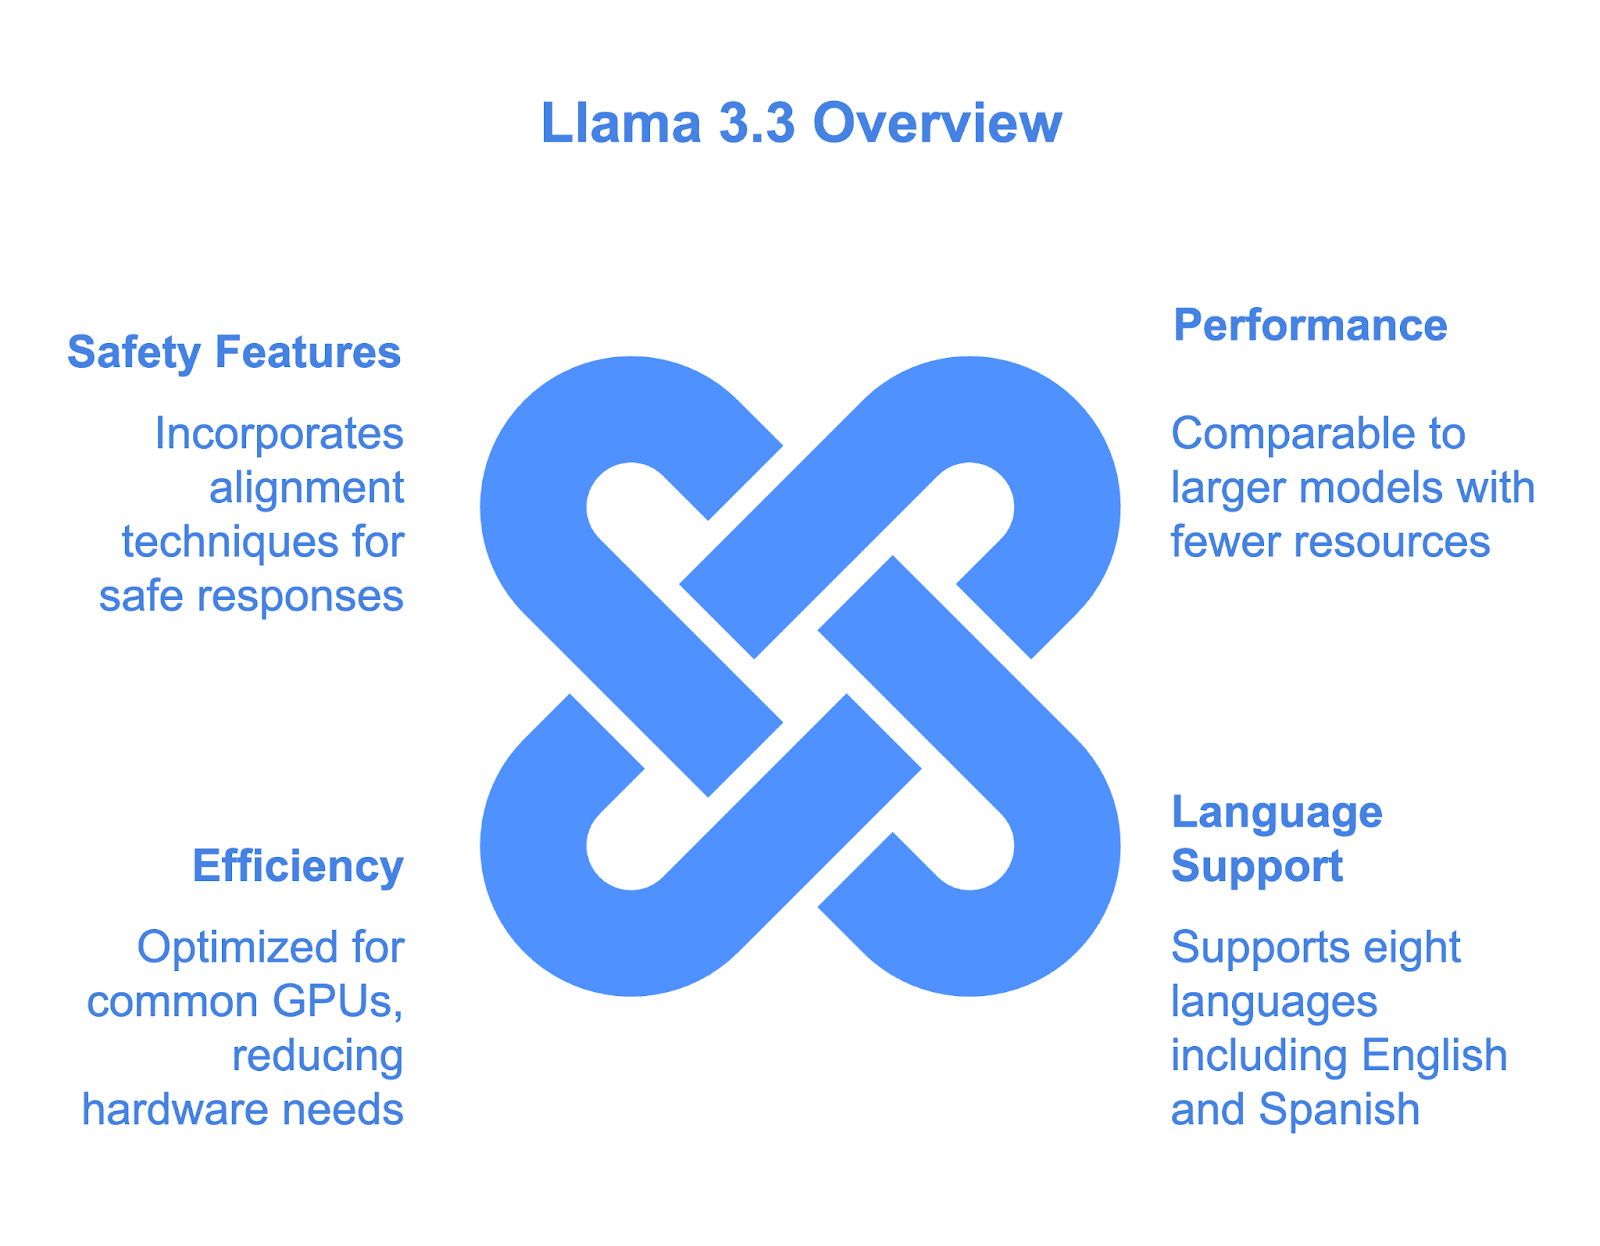
Llama 3.3 70b functies en ondersteuning

In deze sectie hebben we de basis uiteengezet van wat Llama 3.3 is, maar we gaan in de volgende secties dieper. We behandelen hoe het werkt, hoe je ermee begint en hoe het presteert in benchmarks, zodat je kunt bepalen of het past bij jouw werk.

Hoe werkt Llama 3.3?

Zo werkt Llama 3.3, opgesplitst op een manier die hopelijk logisch is, of je nu vertrouwd bent met large language models of ze net begint te verkennen.

Architectuur: efficiënt en schaalbaar

In de kern heeft Llama 3.3 een transformer-gebaseerde architectuur met 70 miljard parameters. Als je er niet bekend mee bent: parameters zijn in feite de “knoppen” die het model tijdens training bijstelt om patronen en relaties in tekst te leren. Daardoor kan Llama 3.3 samenhangende, contextueel relevante antwoorden genereren.

Wat Llama 3.3 anders maakt, is het gebruik van Grouped-Query Attention (GQA). Dit maakt het model efficiënter doordat het tekst sneller kan verwerken met minder rekenkracht. Daarom kan het prestaties behalen die vergelijkbaar zijn met de veel grotere Llama 3.1 405B, terwijl het veel minder veeleisend is voor hardware.

Training en fine-tuning

Het trainen van een model als Llama 3.3 begint met het blootstellen aan een enorme dataset—15 biljoen tokens tekst uit openbaar beschikbare bronnen. Dit geeft het model een brede taal- en kennisbasis.

Maar we weten dat ruwe training niet genoeg is om een model bruikbaar te maken in praktijksituaties. Daar komt fine-tuning om de hoek kijken:

  • Supervised fine-tuning (SFT): hierbij leert het model van zorgvuldig geselecteerde voorbeelden van goede antwoorden. Zie dit als het bieden van een “gouden standaard” voor het gewenste gedrag.
  • Reinforcement learning met menselijke feedback (RLHF): hierbij wordt feedback van mensen verzameld over hoe het model presteert en wordt die feedback gebruikt om het gedrag te verfijnen.

Deze dubbele aanpak zorgt ervoor dat Llama 3.3 aansluit bij menselijke verwachtingen, zowel qua bruikbaarheid als veiligheid.

Ontworpen voor toegankelijke hardware

Llama 3.3 is ontworpen om lokaal te draaien op gangbare ontwikkelwerkstations, waardoor het toegankelijk is voor ontwikkelaars zonder infrastructuur op enterprise-niveau. In tegenstelling tot grotere modellen zoals Llama 3.1 405B vereist het aanzienlijk minder rekenkracht, terwijl de prestaties sterk blijven.

Deze efficiëntie is grotendeels te danken aan Grouped-Query Attention (GQA), dat optimaliseert hoe het model tekst verwerkt door het geheugenverbruik te verlagen en de inferentiesnelheid te verhogen.

Het model ondersteunt ook kwantisatietechnieken, s zoals 8-bit en 4-bit precisie, via tools als bitsandbytes. Deze technieken verlagen de geheugenvraag aanzienlijk zonder veel prestatieverlies.

Daarnaast schaalt het goed over verschillende hardwareopstellingen, van enkele GPU’s tot gedistribueerde systemen, wat flexibiliteit biedt voor zowel lokale experimenten als grotere implementaties.

In de praktijk betekent dit dat we met Llama 3.3 kunnen experimenteren of het kunnen uitrollen op betaalbaardere hardware, waardoor we de hoge kosten vermijden die doorgaans samengaan met geavanceerde AI-modellen. Dit maakt het een praktische keuze voor ontwikkelaars en teams die prestaties willen balanceren met toegankelijkheid.
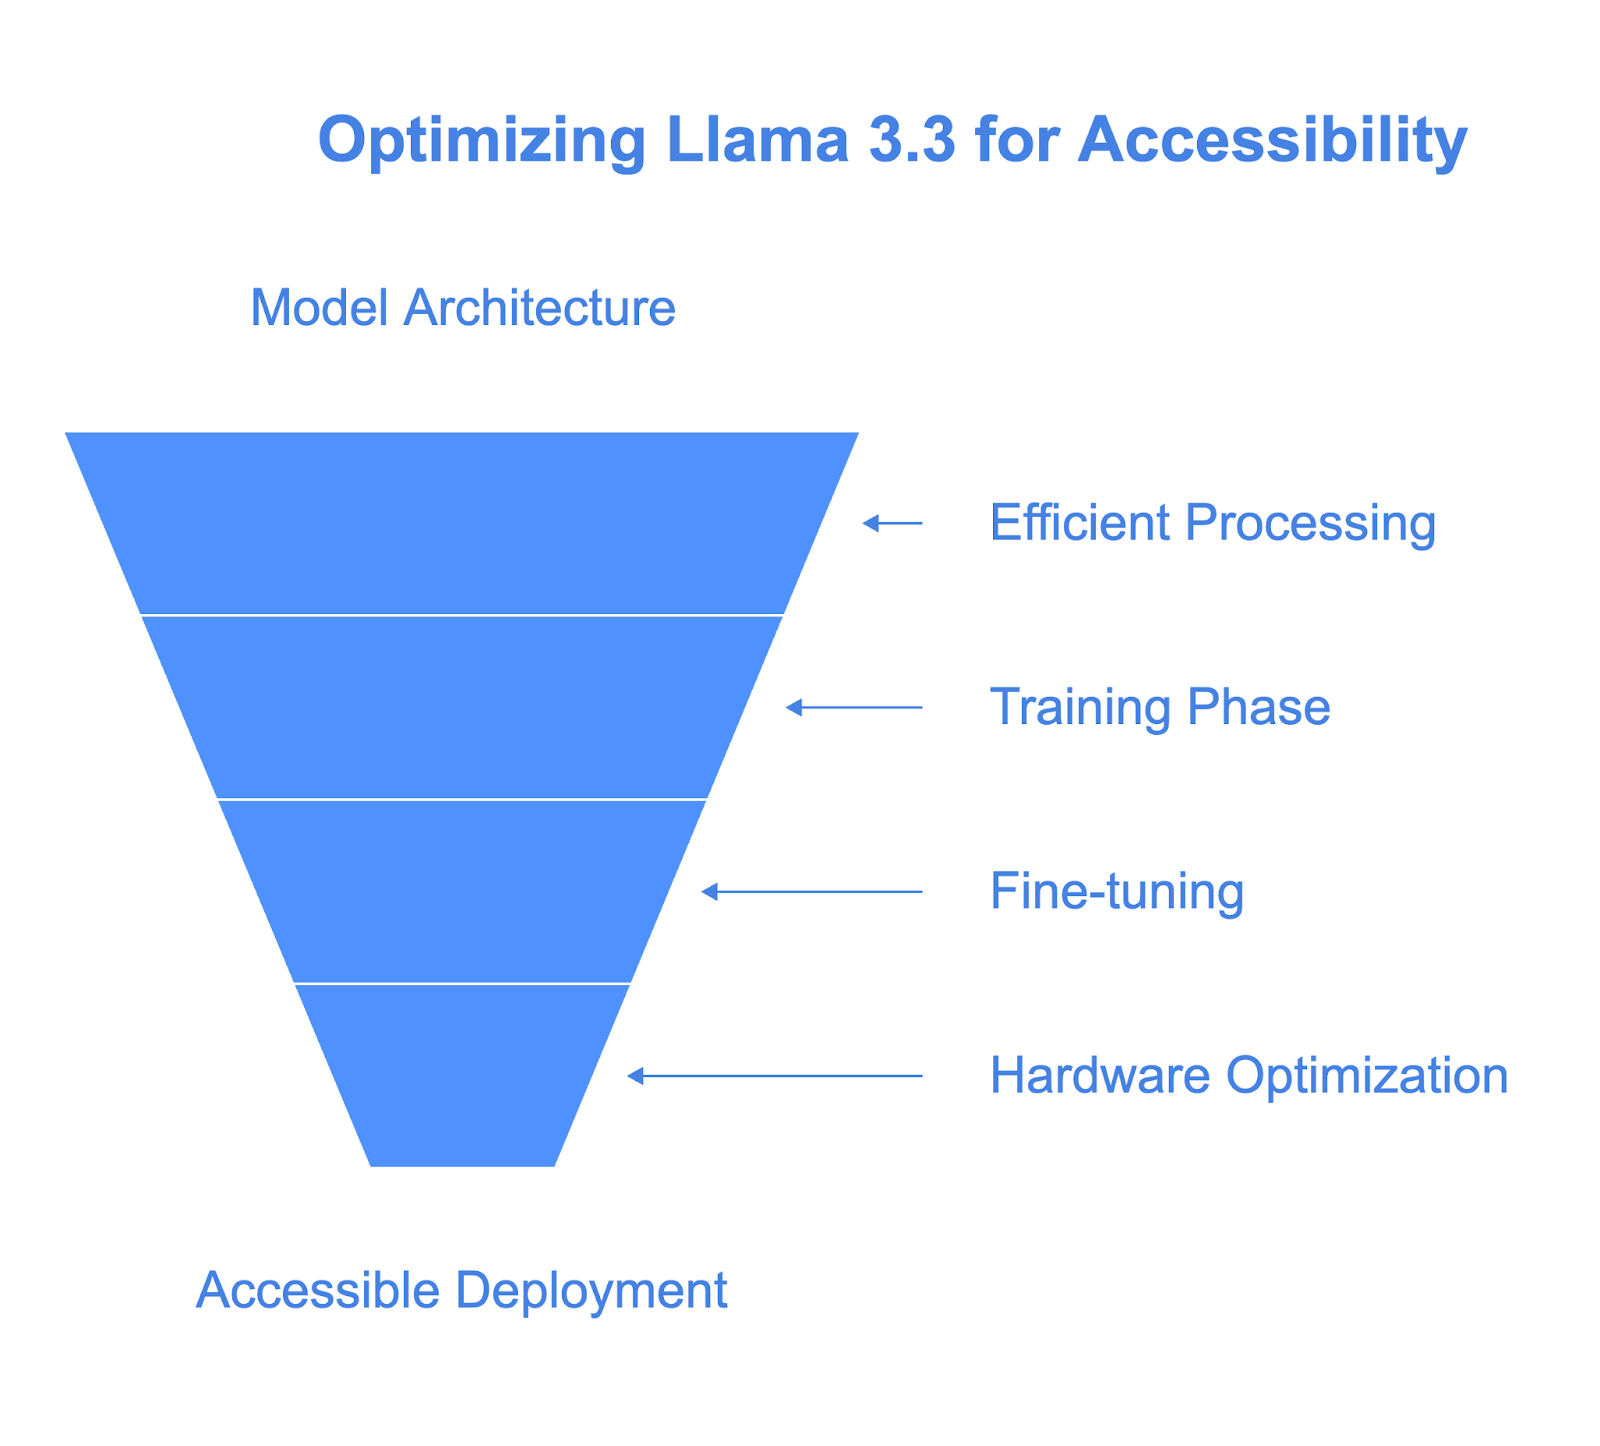
optimaliseren van de Llama 3.3-modelarchitectuur

Llama 3.3-benchmarks

Llama 3.3 presteert goed op uiteenlopende benchmarks, met uitschieters in instructieopvolging, coderen en meertalige redenering. Hoewel het niet consequent beter presteert dan grotere modellen zoals Llama 3.1 405B of Claude 3.5 Sonnet, levert het in de meeste categorieën betrouwbare en concurrerende resultaten. Voor ontwikkelaars die een gebalanceerd model zoeken dat diverse taken effectief aankan, is Llama 3.3 een sterke optie.
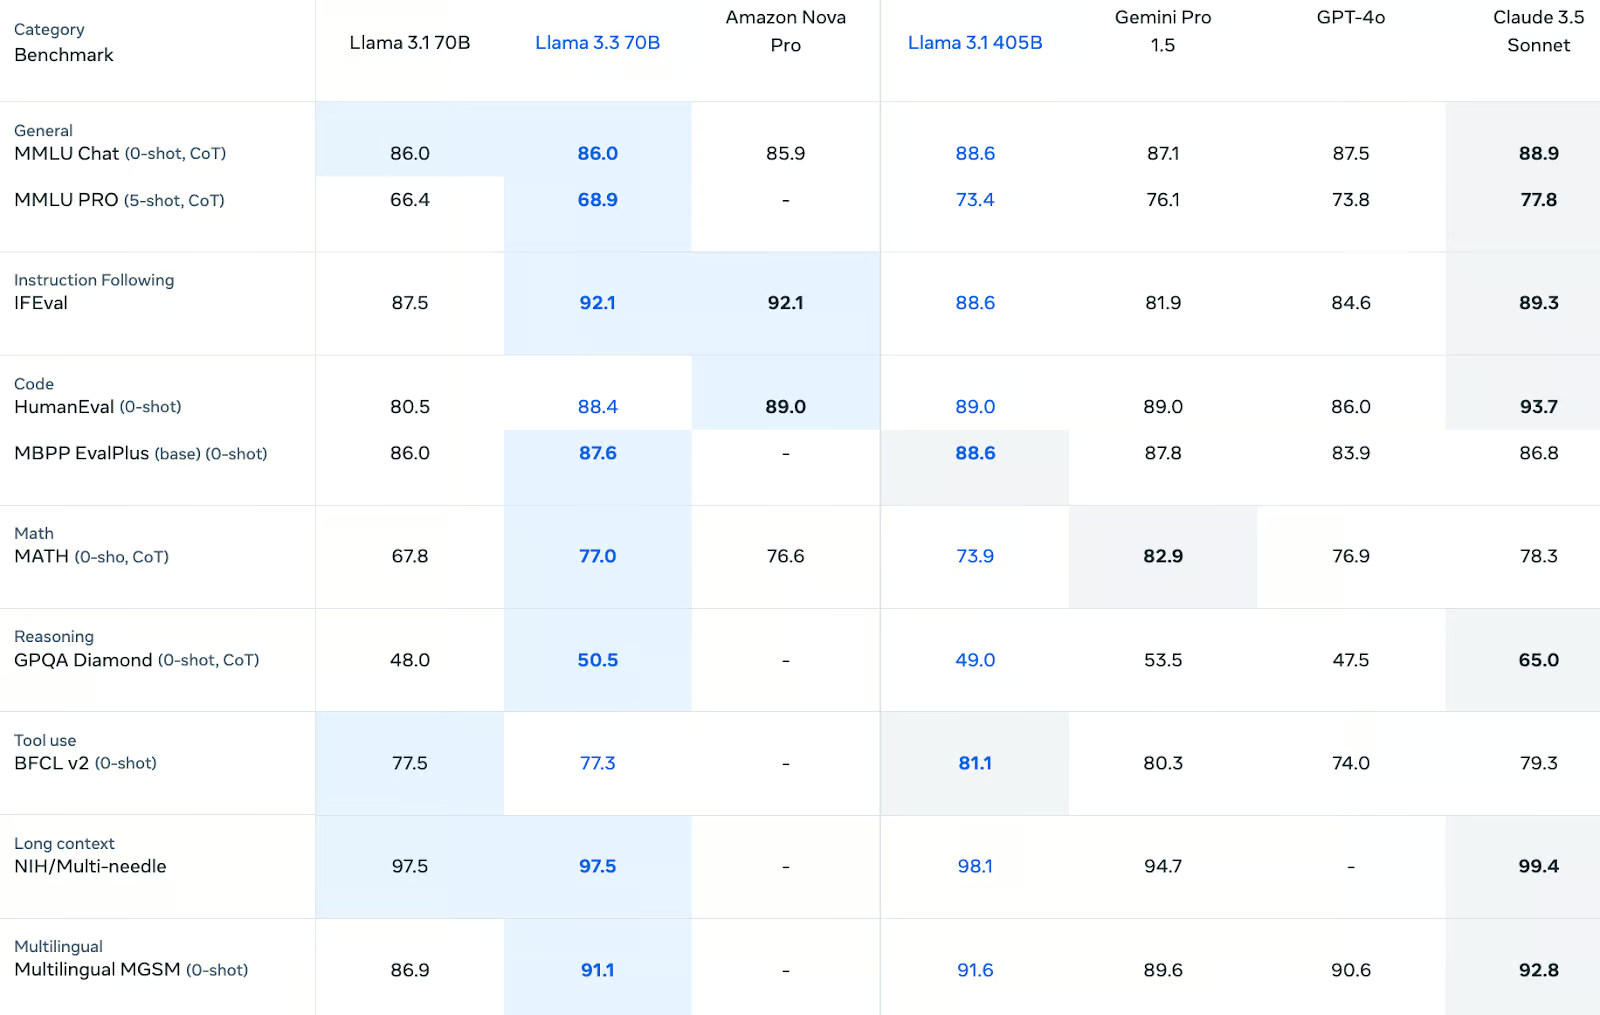
Llama 3.3 70b benchmarks op MMLU, IfEval, GPQA en meertalige MGSM

Algemene kennis en redeneren

Bij taken rond algemene kennis levert Llama 3.3 solide resultaten. Het behaalt een score van 86,0 op MMLU Chat (0-shot, CoT), gelijk aan zijn voorganger Llama 3.1 70B en concurrerend met Amazon Nova Pro (85,9). Het blijft echter net achter bij de grotere Llama 3.1 405B (88,6) en Claude 3.5 Sonnet (88,9).

Op de uitdagendere MMLU PRO (5-shot, CoT)-benchmark verbetert Llama 3.3 ten opzichte van Llama 3.1 70B met een score van 68,9, maar het blijft achter bij zowel Llama 3.1 405B (73,4) als Claude 3.5 Sonnet (77,8).

Voor redeneertaken scoort Llama 3.3 50,5 op GPQA Diamond (0-shot, CoT), een lichte verbetering ten opzichte van Llama 3.1 70B (48,0). Hoewel dit het achter enkele concurrenten zoals Claude 3.5 Sonnet (65,0) plaatst, laat het vooruitgang zien in gestructureerd redeneren.

Instructieopvolging

Llama 3.3 blinkt uit in taken rond instructieopvolging en scoort 92,1 op IFEval, wat meet hoe goed een model zich aan gebruikersinstructies houdt. Dit resultaat plaatst het boven Llama 3.1 405B (88,6) en GPT-4o (84,6), en dicht bij Claude 3.5 Sonnet (89,3). De prestaties in deze categorie benadrukken de alignment-capaciteiten, die cruciaal zijn voor toepassingen zoals chatbots en taakgerichte assistenten.

Codeercapaciteiten

Coding-benchmarks zijn een sterk punt voor Llama 3.3. Op HumanEval (0-shot) scoort het 88,4, net onder Llama 3.1 405B (89,0) en vergelijkbaar met Gemini Pro 1.5. Evenzo behaalt het in MBPP EvalPlus (base) 87,6, een lichte verbetering ten opzichte van Llama 3.1 70B (86,0). Deze resultaten bevestigen de effectiviteit bij het genereren van code en het oplossen van programmeertaken.

Wiskunde en symbolisch redeneren

Bij symbolisch redeneren laat Llama 3.3 aanzienlijke vooruitgang zien. Het scoort 77,0 op de MATH (0-shot, CoT)-benchmark en presteert daarmee beter dan Llama 3.1 70B (67,8) en Amazon Nova Pro (76,6). Het blijft echter achter bij Gemini Pro 1.5 (82,9). Hoewel het niet de koploper in deze categorie is, presteert het goed genoeg voor veel gestructureerde redeneertaken.

Meertalige capaciteiten

Llama 3.3 toont aanzienlijke kracht in meertalige redenering en scoort 91,1 op MGSM (0-shot). Dit is een substantiële verbetering ten opzichte van Llama 3.1 70B (86,9) en plaatst het dicht bij Claude 3.5 Sonnet (92,8). De prestaties in deze categorie maken het een uitstekende keuze voor meertalige toepassingen zoals vertaling en wereldwijde klantenondersteuning.

Toolgebruik en long-contextprestaties

Voor toolgebruik behaalt Llama 3.3 77,3 op BFCL v2 (0-shot), vergelijkbaar met Llama 3.1 70B (77,5) maar onder Llama 3.1 405B (81,1). Bij het verwerken van long-contextinvoer scoort het 97,5 op NIH/Multi-Needle, gelijk aan Llama 3.1 70B en net onder Llama 3.1 405B (98,1). Deze resultaten duiden op sterke capaciteiten voor tool-ondersteunde workflows en scenario’s met uitgebreide input.

Use cases voor Llama 3.3

Llama 3.3 opent een breed scala aan mogelijkheden voor ontwikkelaars en onderzoekers, dankzij de balans tussen sterke prestaties en hardware-efficiëntie. We waarderen hoe effectief het draait op standaard ontwikkelwerkstations, waardoor het een toegankelijke optie is voor wie geen infrastructuur op enterprise-niveau heeft. Hier zijn enkele gebieden waar het nuttig kan zijn.
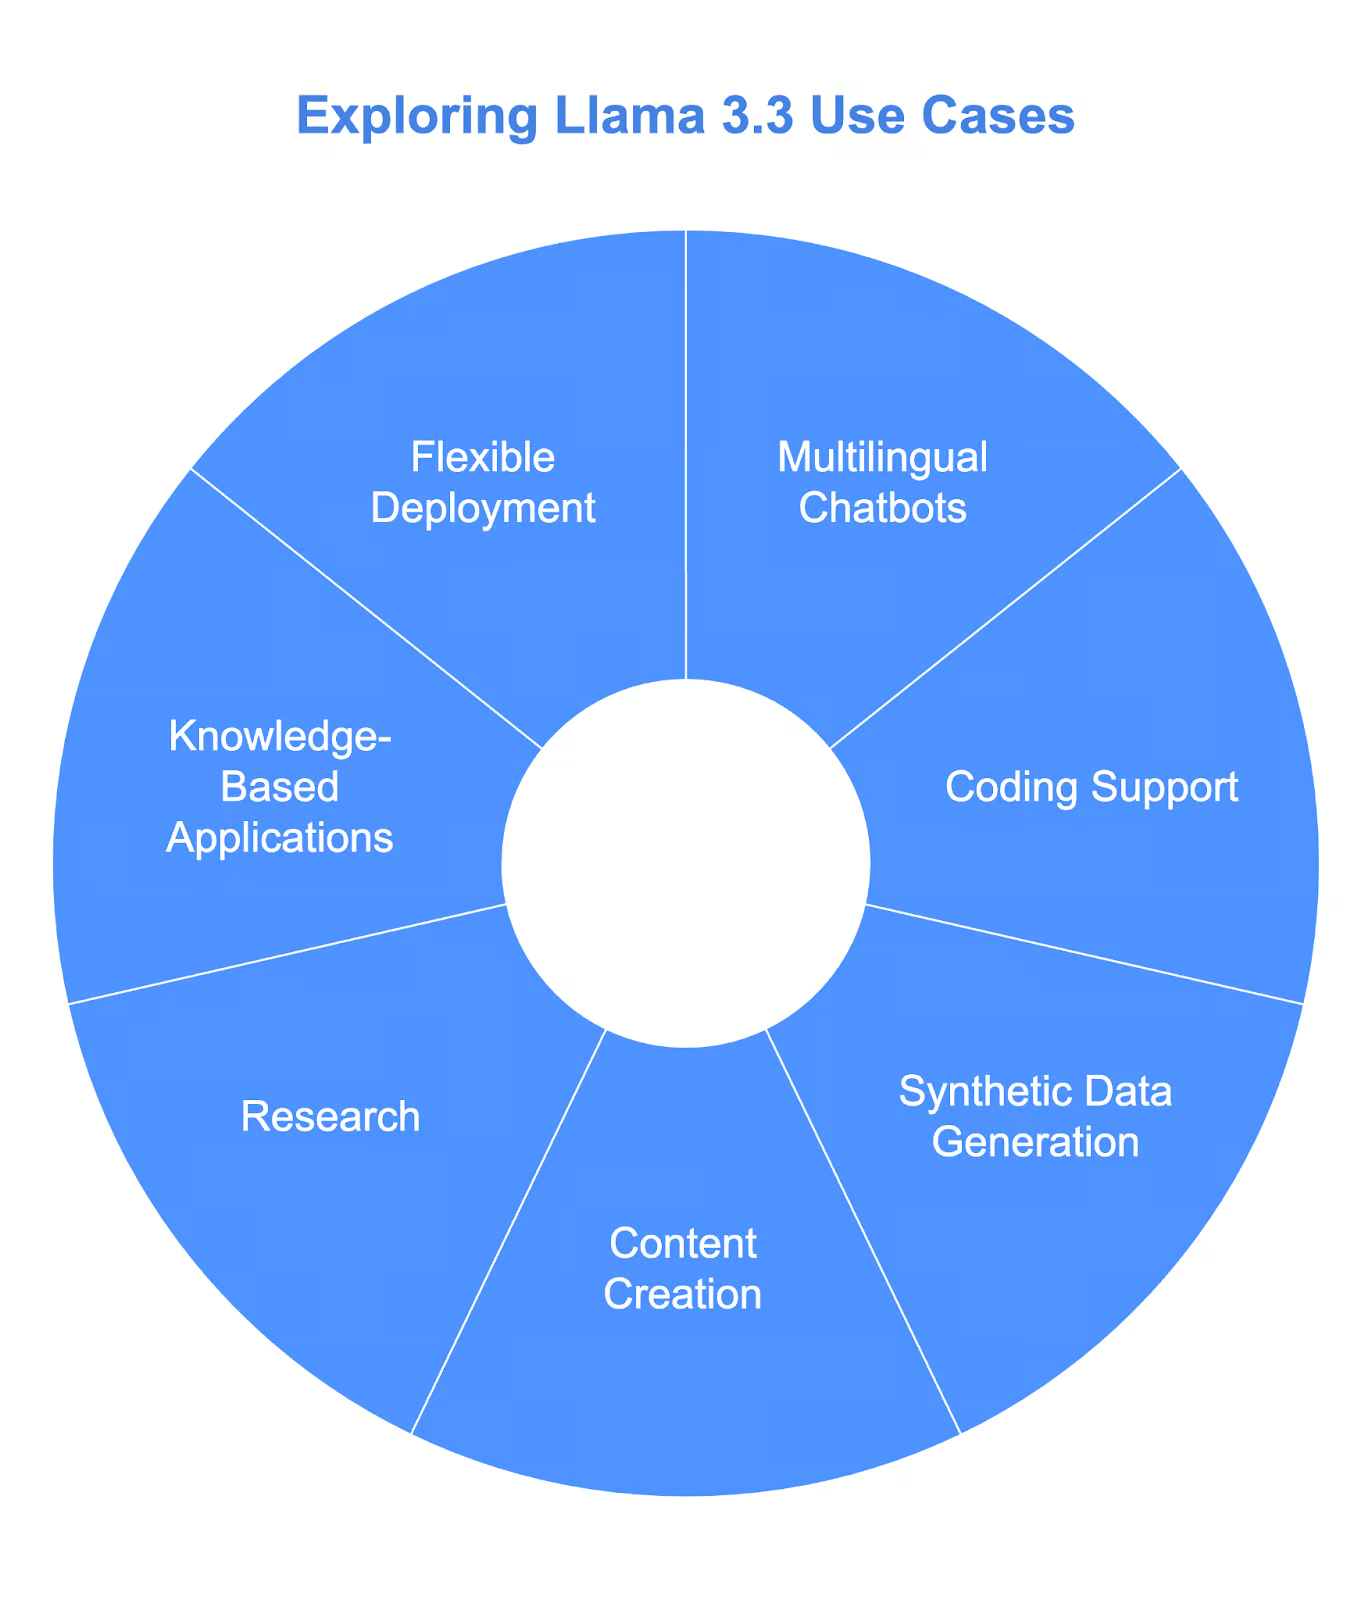
Llama 3.3 70b toepassingen, waaronder contentcreatie, chatbots, coderingsondersteuning en onderzoek

1. Meertalige chatbots en assistenten

Een van de sterke punten van Llama 3.3 is de mogelijkheid om meerdere talen te verwerken. Met ondersteuning voor acht kern­talen—waaronder Engels, Spaans, Frans en Hindi—is het ideaal voor het bouwen van meertalige chatbots of virtuele assistenten.

Wat voor ons opvalt, is dat je geen datacenter nodig hebt om te beginnen. Ontwikkelaars kunnen deze systemen prototypen en uitrollen op hun eigen hardware, of het nu gaat om klantenondersteuning, educatieve tools of andere conversationele toepassingen.

Zo zouden we Llama 3.3 kunnen gebruiken om een klantenservicechatbot te maken die vragen in meerdere talen beantwoordt, en daarbij efficiënt draait op een enkele GPU.

2. Ondersteuning bij coderen en softwareontwikkeling

Met sterke scores op coding-benchmarks zoals HumanEval en MBPP EvalPlus is Llama 3.3 een betrouwbare assistent voor het genereren van code, debuggen of het aanvullen van gedeeltelijk geschreven scripts.

Wat wij bijzonder waardevol vinden, is hoe goed het werkt op persoonlijke hardware. In plaats van te vertrouwen op dure cloudsystemen kun je Llama 3.3 lokaal draaien om repetitieve taken te automatiseren, boilerplatecode te genereren of unittests te creëren. Voor teams of solistische ontwikkelaars maakt dit geavanceerde AI-ondersteuning bij coderen zowel praktisch als betaalbaar.

3. Synthetische datageneratie

Een ander gebied waarin Llama 3.3 uitblinkt, is het genereren van synthetische datasets. Of je nu een chatbot bouwt, een classifier traint of aan een NLP-project werkt, de mogelijkheid om hoogwaardige, gelabelde data te genereren kan veel tijd en moeite besparen.

Wij vinden deze use case vooral waardevol voor kleinere teams die domeinspecifieke data nodig hebben maar niet de middelen hebben om die handmatig te verzamelen. Omdat Llama 3.3 op ontwikkelaars­hardware draait, kun je lokaal data genereren, wat kosten verlaagt en de workflow vereenvoudigt.

4. Meertalige contentcreatie en lokalisatie

De meertalige capaciteiten van Llama 3.3 maken het ook een sterke kandidaat voor contentcreatie. Wij zien potentieel bij het produceren van gelokaliseerd marketingmateriaal, het vertalen van technische documenten of het maken van meertalige blogs. Ontwikkelaars kunnen het model fine-tunen om toon of stijl aan te passen, zodat de output aansluit bij de beoogde doelgroep.

Je zou Llama 3.3 bijvoorbeeld kunnen gebruiken om een productbeschrijving in meerdere talen te schrijven, waardoor het lokalisatieproces verbetert zonder dat je een volledig vertaalteam nodig hebt.

5. Onderzoek en experimentatie

Voor onderzoekers biedt Llama 3.3 een solide platform om taalmodellering, alignment of fine-tuningtechnieken te verkennen. Wat het bijzonder aantrekkelijk maakt, is de efficiëntie—je hebt geen toegang tot enorme cloudinfrastructuur nodig om met geavanceerde AI te experimenteren.

Dit maakt het een uitstekend hulpmiddel voor academische projecten of industrieel onderzoek, vooral bij het verkennen van onderwerpen zoals safety alignment of het trainen van kleinere, gespecialiseerde modellen via distillatie.

6. Kennisgebaseerde toepassingen

De sterke tekstverwerkingscapaciteiten van Llama 3.3 lenen zich ook voor toepassingen zoals vraagbeantwoording, samenvatten en rapportage. Deze taken vereisen vaak het efficiënt verwerken van grote hoeveelheden tekst, iets wat Llama 3.3 zelfs op persoonlijke hardware goed aankan.

Zo zouden we het kunnen gebruiken om klantfeedback automatisch samen te vatten of interne documentatie te genereren, wat tijd bespaart met behoud van nauwkeurigheid.

7. Flexibele implementatie voor kleine teams

Tot slot denken we dat Llama 3.3 een geweldige optie is voor startups, solistische ontwikkelaars of kleine teams die geavanceerde AI-capaciteiten willen zonder de kosten van infrastructuur op enterprise-niveau. Doordat het op lokale servers of zelfs één werkstation kan draaien, is het een praktische oplossing voor lichte productiesystemen.

Toegang krijgen tot Llama 3.3

Meta biedt toegang tot Llama 3.3 via hun speciale website: Llama Downloads. Hier vind je links naar de officiële modelkaart, licentiegegevens en aanvullende documentatie om je op weg te helpen.

Voor diepgaande begeleiding raden we aan de officiële resources te verkennen:

Deze platforms bieden gedetailleerde documentatie en communityforums waar je vragen kunt stellen of problemen kunt oplossen.

Prijzen van Llama 3.3

Wat ons betreft maken deze prijzen Llama 3.3 bijzonder aantrekkelijk voor ontwikkelaars met een beperkt budget of voor het opschalen van projecten met hoge tokenbehoeften. Of je het nu lokaal draait of via een platform, deze concurrerende tarieven zorgen ervoor dat hoogwaardige AI toegankelijk is zonder de bank te breken.

Kosten voor inputtokens

Voor het verwerken van 1 miljoen inputtokens kost Llama 3.3 $0,1, wat overeenkomt met zijn voorganger, Llama 3.1 70B. In vergelijking met andere modellen is dit een van de laagste tarieven:

  • Amazon Nova Pro rekent $0,80 en is daarmee acht keer zo duur voor hetzelfde volume.
  • GPT-4o en Claude 3.5 Sonnet kosten respectievelijk $2,5 en $3,0, wat ze aanzienlijk hoger plaatst dan Llama 3.3.

Deze lage inputkosten maken Llama 3.3 bijzonder geschikt voor toepassingen die grote hoeveelheden tekst moeten verwerken, zoals chatbots of tekstanalysetools.

Kosten voor outputtokens

Voor 1 miljoen outputtokens kost Llama 3.3 $0,4, opnieuw gelijk aan de kosten van Llama 3.1 70B. Zo verhoudt het zich:

  • Amazon Nova Pro kost $1,8, ruim vier keer hoger dan Llama 3.3.
  • GPT-4o rekent $10,0 en Claude 3.5 Sonnet $15,0, waardoor Llama 3.3 met afstand een voordelige optie is.

Voor toepassingen die grote hoeveelheden tekst genereren, zoals synthetische datacreatie of contentproductie, biedt Llama 3.3 aanzienlijke kostenbesparingen.

Conclusie

Wij zien Llama 3.3 als een overtuigend voorbeeld van hoe large language models capaciteit en toegankelijkheid in balans kunnen brengen.

Als model met 70 miljard parameters levert het prestaties die vergelijkbaar zijn met de veel grotere Llama 3.1 405B, maar met veel lagere rekenvereisten.

Voor ontwikkelaars zonder toegang tot hardware op enterprise-niveau biedt dit model een praktische manier om hoogwaardige AI in hun workflows te integreren.

Veelgestelde vragen

Hoe verschilt Llama 3.3 van Llama 3.2?

Llama 3.3 verbetert ten opzichte van Llama 3.2 met betere fine-tuning (SFT en RLHF), uitgebreidere veiligheidsfuncties, meertalige ondersteuning (8 talen), een langere contextwindow (128k tokens) en sterkere benchmarkprestaties. Het voegt ook toolgebruik-capaciteiten toe, verbeterde energie-efficiëntie en een robuust verantwoord AI-framework, waardoor het krachtiger en veelzijdiger is.

Hoe verschilt Llama 3.3 van Llama 405B?

Llama 3.3 levert prestaties die vergelijkbaar zijn met Llama 3.1 405B, maar is aanzienlijk efficiënter en vereist veel minder rekenkracht om te draaien.

Welke talen ondersteunt Llama 3.3?

Llama 3.3 ondersteunt van nature Engels, Frans, Duits, Hindi, Italiaans, Portugees, Spaans en Thais. Ontwikkelaars kunnen het fine-tunen voor andere talen, maar extra waarborgen zijn dan vereist.

In welke benchmarks blinkt Llama 3.3 uit?

Llama 3.3 behaalt hoge scores op benchmarks zoals MMLU, HumanEval en MGSM, en presteert beter dan veel andere modellen in categorieën zoals redeneren, coderen en meertalige capaciteiten.

Kan Llama 3.3 draaien op standaard ontwikkelaarshardware?

Ja, Llama 3.3 is ontworpen om te draaien op gangbare GPU’s en ontwikkelwerkstations, waardoor het toegankelijk is voor ontwikkelaars zonder infrastructuur op enterprise-niveau.


Alex Olteanu's photo
Author
Alex Olteanu
LinkedIn

Ik ben redacteur en schrijver van AI-blogs, tutorials en nieuws, en zorg ervoor dat alles past binnen een sterke contentstrategie en SEO-best practices. Ik heb datascience-cursussen geschreven over Python, statistiek, kansrekening en datavisualisatie. Ook heb ik een bekroonde roman gepubliceerd en besteed ik mijn vrije tijd aan scenarioschrijven en filmregie.


Josef Waples's photo
Author
Josef Waples

Ik ben een schrijver en editor op het gebied van data science en heb bijgedragen aan onderzoeksartikelen in wetenschappelijke tijdschriften. Ik ben vooral geïnteresseerd in lineaire algebra, statistiek, R en dergelijke. Ik speel ook best wat schaak! 

Onderwerpen
Kunstmatige intelligentie
Large Language Models

Leer AI met DataCamp

Cursus

Werken met Llama 3

2 uur
15.7K
Check de nieuwste manieren om Llama LLM lokaal te draaien en in je stack te integreren.
Bekijk detailsStart Cursus

Maak je gratis account aan

Oefen en volg je voortgang.

Ga Verder Met Google
Door verder te gaan accepteer je onze Gebruiksvoorwaarden, ons Privacybeleid en dat je gegevens worden opgeslagen in de VS.
Meer bekijken
Gerelateerd

blog

AI vanaf nul leren in 2026: een complete gids van de experts

Ontdek alles wat je moet weten om in 2026 AI te leren, van tips om te beginnen tot handige resources en inzichten van industrie-experts.
Adel Nehme's photo

Adel Nehme

15 min

Meer bekijken

