Cursus
Inzicht in Machine Learning
2 uur
313.7K
Voor deze tutorial werk je met een tekstdataset, het Deceptive Opinion Spam Corpus, als voorbeeld.
Kort samengevat behandel je in deze tutorial het volgende:
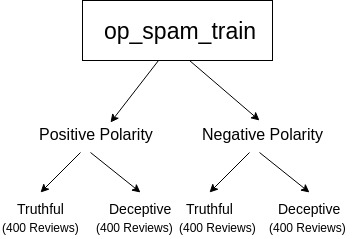
Voordat je de data laadt, is het goed om te kijken waar je precies mee gaat werken! Het Deceptive opinion spam-dataset is een corpus met waarheidsgetrouwe en misleidende hotelreviews van 20 hotels in Chicago. De data wordt beschreven in twee papers op basis van de sentimenten in de review. Specifiek bespreken de artikelen positieve sentimentreviews in 1 en negatieve sentimentreviews in 2. Raadpleeg de papers gerust voor meer diepgang.
Het corpus bevat:
In totaal heb je 1600 reviews. Jouw taak is om de waarheidsgetrouwe en misleidende hotelreviews te classificeren met een machinelearning-algoritme.
Laten we beginnen!
Je begint met het importeren van alle benodigde modules zoals os, pandas, nltk, regex en vooral Sklearn, want in deze tutorial gebruik je een machinelearning-algoritme, de Support Vector Machine, dat wordt geleverd door de Sklearn-bibliotheek!
Je hebt os nodig om te itereren over de mappen en submappen waarin de tekstbestanden staan, fnmatch is handig om alleen de tekstbestanden te filteren en de rest te negeren, pandas helpt je om je data in de vorm van rijen en kolommen te zetten en allerlei bewerkingen uit te voeren. Regex helpt je om data te extraheren op basis van het patroon dat je opgeeft, dus dat heb je ook nodig! Nltk is een natural language toolkit die je helpt om stopwoorden te verwijderen die je model niet hoeft te leren. En het belangrijkst: je importeert Sklearn, dat een reeks libraries biedt waarmee je de data kunt manipuleren, vectoriseren, de grens tussen datapunten kunt leren met een machinelearning-algoritme en ten slotte de nauwkeurigheid kunt plotten.
import os
import fnmatch
from textblob import TextBlob
import pandas as pd
from sklearn.feature_extraction.text import TfidfVectorizer
from nltk.corpus import stopwords
from nltk import pos_tag,pos_tag_sents
import regex as re
import operator
from sklearn.svm import SVC, LinearSVC
from sklearn.metrics import classification_report, accuracy_score, confusion_matrix
from sklearn.cross_validation import train_test_split
from sklearn import metrics
from sklearn import svm
from sklearn.grid_search import GridSearchCV
import pickle
from nltk.corpus import stopwords
Na het importeren van de libraries is je volgende taak het extraheren van de labels van de data. De labels helpen het model onderscheid te maken tussen reviews: of een bepaalde review tot de waarheidsgetrouwe of misleidende klasse behoort.
Je itereert eerst over alle tekstbestanden en haalt het absolute pad van alle tekstbestanden op, waaruit je vervolgens de bijbehorende labels extraheert.
path = 'op_spam_train/'

label = []

configfiles = [os.path.join(subdir,f)
for subdir, dirs, files in os.walk(path)
    for f in fnmatch.filter(files, '*.txt')]
Er zouden 1600 paden moeten zijn, elk voor een nieuw tekstbestand. Laten we dat snel controleren!
len(configfiles)
1600
Laten we ook een van de paden naar een tekstbestand printen.
configfiles[1]
'op_spam_train/negative_polarity/deceptive_from_MTurk/fold4/d_swissotel_14.txt'
Uit de bovenstaande output kun je opmaken dat we een soort filter nodig hebben om de labels te extraheren. Daarvoor gebruik je Regex, oftewel reguliere expressies.
for f in configfiles:
    c = re.search('(trut|deceptiv)\w',f)
    label.append(c.group())
Zodra de labels zijn geëxtraheerd in een list genaamd label, maken we er een dataframe van.
labels = pd.DataFrame(label, columns = ['Labels'])
Laten we de eerste vijf rijen van het labels-dataframe printen.
labels.head(5)
| Labels | |
|---|---|
| 0 | deceptive |
| 1 | deceptive |
| 2 | deceptive |
| 3 | deceptive |
| 4 | deceptive |
Nadat je alle labels hebt geëxtraheerd, is het tijd om de reviews uit de tekstbestanden te halen!
review = []
directory =os.path.join("op_spam_train")
for subdir,dirs ,files in os.walk(directory):
   # print (subdir)
    for file in files:
        if fnmatch.filter(files, '*.txt'):
            f=open(os.path.join(subdir, file),'r')
            a = f.read()
            review.append(a)
Zoals hiervoor, maak je nu een dataframe van de lijst review.
reviews = pd.DataFrame(review, columns = ['HotelReviews'])
Laten we de eerste vijf rijen van het reviews-dataframe printen.
reviews.head(5)
| HotelReviews | |
|---|---|
| 0 | Grant it, this hotel seems very nice, but I wa... |
| 1 | I recently stayed at the Swissotel Chicago wit... |
| 2 | I was sorely disappointed with the Sheraton Ch... |
| 3 | My family and I stayed at the Sheraton Chicago... |
| 4 | I recently stayed at the Homewood Suites by Hi... |
Top! Tot nu toe was het vrij intuïtief, toch?
Laten we nu de dataframes labels en reviews samenvoegen!
result = pd.merge(reviews, labels,right_index=True,left_index = True)


result['HotelReviews'] = result['HotelReviews'].map(lambda x: x.lower())
Nadat ze zijn samengevoegd, heb je een nieuw dataframe met de naam result. Laten we ook hier een paar rijen van printen.
result.head()
| HotelReviews | Labels | |
|---|---|---|
| 0 | grant it, this hotel seems very nice, but i wa... | deceptive |
| 1 | i recently stayed at the swissotel chicago wit... | deceptive |
| 2 | i was sorely disappointed with the sheraton ch... | deceptive |
| 3 | my family and i stayed at the sheraton chicago... | deceptive |
| 4 | i recently stayed at the homewood suites by hi... | deceptive |
Bij tekstdata is het essentieel om stopwoorden te verwijderen. Stopwoorden zijn niet informatief en helpen het model niet om patronen in de data te leren.
Je maakt een nieuwe kolom in het dataframe met de naam review_without_stopwords. De lambda-functie verwerkt alle rijen van de kolom HotelReviews. Je gebruikt een list comprehension en slaat alleen die woorden op in de nieuwe kolom die niet in de variabele stop voorkomen.
import ntlk
nltk.download('stopwords')
Let op: Om onderstaande cel uit te voeren, moet je mogelijk de bovenstaande code in je terminal draaien.
stop = stopwords.words('english')

result['review_without_stopwords'] = result['HotelReviews'].apply(lambda x: ' '.join([word for word in x.split() if word not in (stop)]))
Laten we snel het dataframe zonder stopwoorden printen!
result.head()
| HotelReviews | Labels | review_without_stopwords | |
|---|---|---|---|
| 0 | grant it, this hotel seems very nice, but i wa... | deceptive | grant it, hotel seems nice, pleased stay here.... |
| 1 | i recently stayed at the swissotel chicago wit... | deceptive | recently stayed swissotel chicago husband two ... |
| 2 | i was sorely disappointed with the sheraton ch... | deceptive | sorely disappointed sheraton chicago. outside ... |
| 3 | my family and i stayed at the sheraton chicago... | deceptive | family stayed sheraton chicago hotel towers be... |
| 4 | i recently stayed at the homewood suites by hi... | deceptive | recently stayed homewood suites hilton chicago... |
Volgens 1 kunnen waarheidsgetrouwe en misleidende meningen respectievelijk worden geclassificeerd als informatieve en imaginaire genres. Er is een sterk verschil in distributie tussen informatieve en imaginaire teksten: de eerste bevat doorgaans meer zelfstandige naamwoorden, bijvoeglijke naamwoorden, voorzetsels, lidwoorden en nevenschikkende voegwoorden, terwijl de laatste meer werkwoorden, bijwoorden, voornaamwoorden en pre-determiners bevat. Dat misleidende meningen meer overtreffende trappen bevatten, is echter niet onverwacht, omdat misleidend schrijven (maar niet noodzakelijkerwijs imaginaire teksten in het algemeen) vaak overdreven taal gebruikt.
Laten we daarom voor elk woord in de rij van het dataframe de bijbehorende woordsoort extraheren, die je vervolgens als featurevector aan je model doorgeeft.
Voor pos-tagging gebruik je TextBlob, een Python-bibliotheek voor het verwerken van tekstuele data. Het biedt een eenvoudige API voor alledaagse NLP-taken zoals part-of-speech-tagging, zelfstandige naamwoordgroep-extractie, sentimentanalyse, classificatie, vertaling en meer.
Let op: Om de cel met de pos-functie te draaien, moet je mogelijk de volgende regels in je terminal uitvoeren.
import nltk
nltk.download('punkt')
nltk.download('averaged_perceptron_tagger')
def pos(review_without_stopwords):
    return TextBlob(review_without_stopwords).tags
os = result.review_without_stopwords.apply(pos)
os1 = pd.DataFrame(os)
Elke rij van het os1-dataframe zal bestaan uit een lijst van woorden met hun respectieve woordsoort. Je kunt geen lijst vectoriseren om in het model te voeren. Je zult deze lijsten dus moeten omzetten naar strings.
os1.head()
| review_without_stopwords | |
|---|---|
| 0 | [(grant, NN), (it, PRP), (hotel, NN), (seems, ... |
| 1 | [(recently, RB), (stayed, VBN), (swissotel, NN... |
| 2 | [(sorely, RB), (disappointed, JJ), (sheraton, ... |
| 3 | [(family, NN), (stayed, VBD), (sheraton, JJ), ... |
| 4 | [(recently, RB), (stayed, VBN), (homewood, NN)... |
Laten we elke rij omzetten naar een string, waarbij elk woord wordt gekoppeld aan de bijbehorende pos met een slash en woorden onderling worden gescheiden door een spatie.
os1['pos'] = os1['review_without_stopwords'].map(lambda x:" ".join(["".join(x) for x in x ]) )
Ten slotte voegen we de kolom pos samen met het hoofddataframe result en printen we de eerste paar rijen!
result = result = pd.merge(result, os1,right_index=True,left_index = True)
result.head()

Nu de features zijn geëxtraheerd, is het tijd om de data te splitsen in training en test. In deze tutorial splits je 80% van de data voor training en de overige 20% voor testen.
review_train, review_test, label_train, label_test = train_test_split(result['pos'],result['Labels'], test_size=0.2,random_state=13)
Laten we TfidfVectorizer in detail begrijpen
Tfidf heeft twee componenten:
De wegingsmethode helpt het machinelearningmodel bij classificatie, omdat we expliciet aangeven welk woord zwaarder/licht zwaarder weegt.
Nu je weet wat het is, gaan we het toepassen op de train- en testdata.
tf_vect = TfidfVectorizer(lowercase = True, use_idf=True, smooth_idf=True, sublinear_tf=False)

X_train_tf = tf_vect.fit_transform(review_train)
X_test_tf = tf_vect.transform(review_test)
Je implementeert nu een machinelearningmodel genaamd Support Vector Machines (SVM). Voor meer uitleg kun je deze link volgen.
Om de beste hyperparameters voor je ML-algoritme te kiezen, gebruik je GridSearchCV, dat op basis van je trainingsdata en labels de beste hyperwaarden voorstelt uit de waarden die je als lijst opgeeft. Je kiest vijf verschillende waarden voor Cs en gammas en op basis van je data krijg je de beste hyperparametergwaarden.
def svc_param_selection(X, y, nfolds):
    Cs = [0.001, 0.01, 0.1, 1, 10]
    gammas = [0.001, 0.01, 0.1, 1]
    param_grid = {'C': Cs, 'gamma' : gammas}
    grid_search = GridSearchCV(svm.SVC(kernel='linear'), param_grid, cv=nfolds)
    grid_search.fit(X, y)
    return grid_search.best_params_
svc_param_selection(X_train_tf,label_train,5)
{'C': 10, 'gamma': 0.001}
clf = svm.SVC(C=10,gamma=0.001,kernel='linear')
clf.fit(X_train_tf,label_train)
pred = clf.predict(X_test_tf)
Laten we het model dat je zojuist hebt getraind samen met de Tfidf-vectorizer opslaan met de pickle-bibliotheek die je aan het begin hebt geïmporteerd, zodat je later eenvoudig de data kunt laden, vectoriseren en met het ML-model kunt voorspellen.
with open('vectorizer.pickle', 'wb') as fin:
    pickle.dump(tf_vect, fin)
with open('mlmodel.pickle','wb') as f:
    pickle.dump(clf,f)
pkl = open('mlmodel.pickle', 'rb')
clf = pickle.load(pkl)
vec = open('vectorizer.pickle', 'rb')
tf_vect = pickle.load(vec)
/home/naveksha/.local/lib/python3.5/site-packages/sklearn/base.py:311: UserWarning: Trying to unpickle estimator SVC from version pre-0.18 when using version 0.19.1. This might lead to breaking code or invalid results. Use at your own risk.
  UserWarning)
/home/naveksha/.local/lib/python3.5/site-packages/sklearn/base.py:311: UserWarning: Trying to unpickle estimator TfidfTransformer from version pre-0.18 when using version 0.19.1. This might lead to breaking code or invalid results. Use at your own risk.
  UserWarning)
/home/naveksha/.local/lib/python3.5/site-packages/sklearn/base.py:311: UserWarning: Trying to unpickle estimator TfidfVectorizer from version pre-0.18 when using version 0.19.1. This might lead to breaking code or invalid results. Use at your own risk.
  UserWarning)
X_test_tf = tf_vect.transform(review_test)
pred = clf.predict(X_test_tf)
print(metrics.accuracy_score(label_test, pred))
0.96875
print (confusion_matrix(label_test, pred))
[[149   6]
 [  4 161]]
Bovenstaande confusion matrix is een matrix van 2 x 2, waarin het eerste element van de eerste rij True Positive (TP) is, het tweede element van de eerste rij False Negative (FN), het eerste element van de tweede rij False Positive (FP) en het tweede element van de tweede rij True Negative (TN).
Uit de confusion matrix kun je concluderen dat slechts 10 testsamples van de 320 verkeerd zijn geclassificeerd.
print (classification_report(label_test, pred))
             precision    recall  f1-score   support

  deceptive       0.97      0.96      0.97       155
      truth       0.96      0.98      0.97       165

avg / total       0.97      0.97      0.97       320
review_train, review_test, label_train, label_test = train_test_split(result['pos'],result['Labels'], test_size=0.2,random_state=1)
X_test_tf = tf_vect.transform(review_test)
pred = clf.predict(X_test_tf)
print(metrics.accuracy_score(label_test, pred))
0.978125
print (confusion_matrix(label_test, pred))
[[146   5]
 [  2 167]]
print (classification_report(label_test, pred))
             precision    recall  f1-score   support

  deceptive       0.99      0.97      0.98       151
      truth       0.97      0.99      0.98       169

avg / total       0.98      0.98      0.98       320
review_train, review_test, label_train, label_test = train_test_split(result['pos'],result['Labels'], test_size=0.2,random_state=10)
X_test_tf = tf_vect.transform(review_test)
pred = clf.predict(X_test_tf)
print(metrics.accuracy_score(label_test, pred))
0.98125
print (confusion_matrix(label_test, pred))
[[155   5]
 [  1 159]]
print (classification_report(label_test, pred))
             precision    recall  f1-score   support

  deceptive       0.99      0.97      0.98       160
      truth       0.97      0.99      0.98       160

avg / total       0.98      0.98      0.98       320
review_train, review_test, label_train, label_test = train_test_split(result['pos'],result['Labels'], test_size=0.2,random_state=42)
X_test_tf = tf_vect.transform(review_test)
pred = clf.predict(X_test_tf)
print(metrics.accuracy_score(label_test, pred))
0.984375
print (confusion_matrix(label_test, pred))
[[165   3]
 [  2 150]]
print (classification_report(label_test, pred))
             precision    recall  f1-score   support

  deceptive       0.99      0.98      0.99       168
      truth       0.98      0.99      0.98       152

avg / total       0.98      0.98      0.98       320
Uit de bovenstaande voorspellingen kun je opmaken dat het model het Fantastisch heeft gedaan en niet overfit, omdat je het model meerdere keren hebt getest met telkens anders gesplitste data.
def test_string(s):
    X_test_tf = tf_vect.transform([s])
    y_predict = clf.predict(X_test_tf)
    return y_predict
test_string("The hotel was good.The room had a 27-inch Samsung led tv, a microwave.The room had a double bed")
array(['truth'], dtype=object)
test_string("My family and I are huge fans of this place. The staff is super nice, and the food is great. The chicken is very good, and the garlic sauce is perfect. Ice cream topped with fruit is delicious too. Highly recommended!")
array(['deceptive'], dtype=object)
Het model heeft de bovenstaande twee reviews correct voorspeld. De eerste review is waarheidsgetrouw, terwijl de tweede misleidend is!
Let op
De prestaties van het model variëren wanneer het wordt geïmplementeerd op een ander systeem met andere specificaties; dit is een ongebruikelijke observatie. Als de community kan helpen dit probleem te achterhalen, zou dat veel mensen helpen, inclusief de auteur van deze post. Met community worden de lezers bedoeld die deze tutorial doornemen!
Veel leerplezier!
Hopelijk was deze tutorial nuttig en voegt hij iets toe aan je skillset.
Als je meer wilt leren over Machine Learning, volg dan DataCamp’s cursus Building Chatbots in Python.
Meer leren over Python en Machine Learning
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

