Kurs
Machine Learning verstehen
2 Std.
308.6K
In diesem Tutorial arbeitest du beispielhaft mit dem Textdatensatz Deceptive Opinion Spam Corpus.
Kurz gesagt, du behandelst heute folgende Themen:
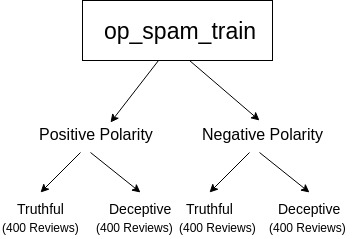
Bevor du die Daten lädst, lohnt sich ein Blick darauf, womit du genau arbeitest. Das Deceptive Opinion Spam Dataset ist ein Korpus mit wahrheitsgemäßen und irreführenden Hotelbewertungen zu 20 Hotels in Chicago. Die Daten werden in zwei Arbeiten je nach Sentiment der Bewertung beschrieben: Positive Bewertungen in 1 und negative Bewertungen in 2. Für tiefere Einblicke kannst du die Paper heranziehen.
Der Korpus enthält:
Insgesamt sind es 1.600 Bewertungen. Deine Aufgabe ist es, wahrheitsgemäße und irreführende Hotelbewertungen mit einem Machine-Learning-Algorithmus zu klassifizieren.
Also, legen wir los!
Du startest mit dem Import aller benötigten Module wie os, pandas, nltk, regex und vor allem scikit-learn, denn in diesem Tutorial verwendest du den Machine-Learning-Algorithmus Support Vector Machine aus der scikit-learn-Bibliothek.
os brauchst du, um durch Ordner und Unterordner mit den Textdateien zu iterieren, fnmatch hilft dir, gezielt nur Textdateien zu filtern, pandas bringt die Daten in ein tabellarisches Format und ermöglicht vielseitige Transformationen. Regex unterstützt dich beim Extrahieren von Informationen anhand von Mustern. Nltk (Natural Language Toolkit) nutzt du, um Stopwörter zu entfernen, die dein Modell nicht lernen soll. Und mit scikit-learn bekommst du hilfreiche Bibliotheken zum Aufbereiten und Vektorisieren der Daten, zum Trainieren eines Modells zur Trennlinienfindung zwischen Datenpunkten und zum Auswerten der Genauigkeit.
import os
import fnmatch
from textblob import TextBlob
import pandas as pd
from sklearn.feature_extraction.text import TfidfVectorizer
from nltk.corpus import stopwords
from nltk import pos_tag,pos_tag_sents
import regex as re
import operator
from sklearn.svm import SVC, LinearSVC
from sklearn.metrics import classification_report, accuracy_score, confusion_matrix
from sklearn_cross_validation import train_test_split
from sklearn import metrics
from sklearn import svm
from sklearn.grid_search import GridSearchCV
import pickle
from nltk.corpus import stopwords
Nach dem Import der Bibliotheken extrahierst du als Nächstes die Labels. Die Labels helfen dem Modell, zwischen Bewertungen zu unterscheiden, also ob eine Bewertung wahrheitsgemäß oder irreführend ist.
Dafür iterierst du zunächst über alle Textdateien, holst dir deren absolute Pfade und leitest daraus die zugehörigen Labels ab.
path = 'op_spam_train/'

label = []

configfiles = [os.path.join(subdir,f)
for subdir, dirs, files in os.walk(path)
    for f in fnmatch.filter(files, '*.txt')]
Es sollten 1.600 Pfade sein, jeweils zu einer Textdatei. Lass uns das schnell prüfen!
len(configfiles)
1600
Drucken wir auch einen Beispielpfad.
configfiles[1]
'op_spam_train/negative_polarity/deceptive_from_MTurk/fold4/d_swissotel_14.txt'
Aus dieser Struktur siehst du: Um die Labels zu extrahieren, brauchen wir einen Filter. Dafür nutzt du Regex, also reguläre Ausdrücke.
for f in configfiles:
    c = re.search('(trut|deceptiv)\w',f)
    label.append(c.group())
Sind die Labels in einer List namens label gesammelt, erstellst du daraus ein DataFrame.
labels = pd.DataFrame(label, columns = ['Labels'])
Lass uns die ersten fünf Zeilen des DataFrames labels ansehen.
labels.head(5)
| Labels | |
|---|---|
| 0 | deceptive |
| 1 | deceptive |
| 2 | deceptive |
| 3 | deceptive |
| 4 | deceptive |
Nachdem du die Labels extrahiert hast, holst du dir nun die Texte aus den Dateien!
review = []
directory =os.path.join("op_spam_train")
for subdir,dirs ,files in os.walk(directory):
   # print (subdir)
    for file in files:
        if fnmatch.filter(files, '*.txt'):
            f=open(os.path.join(subdir, file),'r')
            a = f.read()
            review.append(a)
Wie zuvor erstellst du daraus ein DataFrame der Liste review.
reviews = pd.DataFrame(review, columns = ['HotelReviews'])
Drucke die ersten fünf Zeilen des DataFrames reviews.
reviews.head(5)
| HotelReviews | |
|---|---|
| 0 | Grant it, this hotel seems very nice, but I wa... |
| 1 | I recently stayed at the Swissotel Chicago wit... |
| 2 | I was sorely disappointed with the Sheraton Ch... |
| 3 | My family and I stayed at the Sheraton Chicago... |
| 4 | I recently stayed at the Homewood Suites by Hi... |
Super! Bis hierhin war es recht eingängig, oder?
Jetzt führen wir die DataFrames labels und reviews zusammen.
result = pd.merge(reviews, labels,right_index=True,left_index = True)


result['HotelReviews'] = result['HotelReviews'].map(lambda x: x.lower())
Nach dem Merge liegt das neue DataFrame result vor. Schau dir ein paar Zeilen an.
result.head()
| HotelReviews | Labels | |
|---|---|---|
| 0 | grant it, this hotel seems very nice, but i wa... | deceptive |
| 1 | i recently stayed at the swissotel chicago wit... | deceptive |
| 2 | i was sorely disappointed with the sheraton ch... | deceptive |
| 3 | my family and i stayed at the sheraton chicago... | deceptive |
| 4 | i recently stayed at the homewood suites by hi... | deceptive |
Bei Textdaten ist es wichtig, Stopwörter zu entfernen. Sie sind wenig aussagekräftig und helfen dem Modell nicht dabei, Muster zu lernen.
Du legst eine neue Spalte namens review_without_stopwords an. Die lambda-Funktion verarbeitet alle Zeilen der Spalte HotelReviews. Mit einer List Comprehension speicherst du nur die Wörter, die nicht in der Variablen stop enthalten sind.
import ntlk
nltk.download('stopwords')
Hinweis: Um die folgende Zelle auszuführen, musst du die obigen Zeilen ggf. im Terminal laufen lassen.
stop = stopwords.words('english')

result['review_without_stopwords'] = result['HotelReviews'].apply(lambda x: ' '.join([word for word in x.split() if word not in (stop)]))
Drucken wir schnell das DataFrame ohne Stopwörter!
result.head()
| HotelReviews | Labels | review_without_stopwords | |
|---|---|---|---|
| 0 | grant it, this hotel seems very nice, but i wa... | deceptive | grant it, hotel seems nice, pleased stay here.... |
| 1 | i recently stayed at the swissotel chicago wit... | deceptive | recently stayed swissotel chicago husband two ... |
| 2 | i was sorely disappointed with the sheraton ch... | deceptive | sorely disappointed sheraton chicago. outside ... |
| 3 | my family and i stayed at the sheraton chicago... | deceptive | family stayed sheraton chicago hotel towers be... |
| 4 | i recently stayed at the homewood suites by hi... | deceptive | recently stayed homewood suites hilton chicago... |
Laut 1 lassen sich wahrheitsgemäße und irreführende Meinungen grob als informativ bzw. imaginativ einordnen. Zwischen beiden gibt es deutliche Verteilungsunterschiede: Informative Texte enthalten typischerweise mehr Nomen, Adjektive, Präpositionen, Determinierer und nebenordnende Konjunktionen, während imaginative Texte häufiger Verben, Adverbien, Pronomen und Prädeterminierer aufweisen. Dass irreführende Bewertungen mehr Superlative enthalten, ist wenig überraschend, denn übertreibende Sprache ist dort häufig.
Wir extrahieren daher für jedes Wort in einer Zeile seine Wortart und geben diese Information als Feature-Vektor an das Modell weiter.
Für das POS-Tagging verwendest du TextBlob, eine Python-Bibliothek zur Verarbeitung von Textdaten. Sie bietet eine einfache API für gängige NLP-Aufgaben wie Part-of-Speech-Tagging, Extraktion von Nominalphrasen, Sentimentanalyse, Klassifikation, Übersetzung u. v. m.
Hinweis: Um die Zelle mit der pos-Funktion auszuführen, musst du vorher folgende Zeilen im Terminal ausführen.
import nltk
nltk.download('punkt')
nltk.download('averaged_perceptron_tagger')
def pos(review_without_stopwords):
    return TextBlob(review_without_stopwords).tags
os = result.review_without_stopwords.apply(pos)
os1 = pd.DataFrame(os)
Jede Zeile des DataFrames os1 enthält eine Liste aus Wörtern mit ihrer jeweiligen Wortart. Eine Liste kannst du nicht direkt vektorisieren, um sie dem Modell zu übergeben. Deshalb wandelst du die Zeilen in Strings um.
os1.head()
| review_without_stopwords | |
|---|---|
| 0 | [(grant, NN), (it, PRP), (hotel, NN), (seems, ... |
| 1 | [(recently, RB), (stayed, VBN), (swissotel, NN... |
| 2 | [(sorely, RB), (disappointed, JJ), (sheraton, ... |
| 3 | [(family, NN), (stayed, VBD), (sheraton, JJ), ... |
| 4 | [(recently, RB), (stayed, VBN), (homewood, NN)... |
Jetzt wandelst du jede Zeile in einen String um, in dem jedes Wort mit seinem POS per Slash verbunden ist und die Wort-Paare durch ein Leerzeichen getrennt sind.
os1['pos'] = os1['review_without_stopwords'].map(lambda x:" ".join(["".join(x) for x in x ]) )
Zum Schluss mergest du die Spalte pos in das Haupt-DataFrame result und gibst die ersten Zeilen aus.
result = result = pd.merge(result, os1,right_index=True,left_index = True)
result.head()

Nachdem die Features extrahiert sind, teilst du die Daten in Training und Test. In diesem Tutorial nimmst du 80% für das Training und 20% für den Test.
review_train, review_test, label_train, label_test = train_test_split(result['pos'],result['Labels'], test_size=0.2,random_state=13)
Schauen wir uns TfidfVectorizer genauer an.
TF‑IDF besteht aus zwei Teilen:
Diese Gewichtung hilft dem ML‑Modell bei der Klassifikation, da wir explizit festlegen, welche Wörter mehr bzw. weniger ins Gewicht fallen.
Jetzt implementieren wir das für Trainings- und Testdaten.
tf_vect = TfidfVectorizer(lowercase = True, use_idf=True, smooth_idf=True, sublinear_tf=False)

X_train_tf = tf_vect.fit_transform(review_train)
X_test_tf = tf_vect.transform(review_test)
Als Nächstes setzt du ein Modell vom Typ Support Vector Machines (SVM) ein. Eine gute Einführung findest du hier.
Um die besten Hyperparameter für dein ML‑Modell zu wählen, verwendest du GridSearchCV. Basierend auf Trainingsdaten und Labels ermittelt es aus deinen Vorgabewerten die beste Kombination. Du gibst je fünf Werte für C und gamma vor und erhältst die beste Kombination für deine Daten.
def svc_param_selection(X, y, nfolds):
    Cs = [0.001, 0.01, 0.1, 1, 10]
    gammas = [0.001, 0.01, 0.1, 1]
    param_grid = {'C': Cs, 'gamma' : gammas}
    grid_search = GridSearchCV(svm.SVC(kernel='linear'), param_grid, cv=nfolds)
    grid_search.fit(X, y)
    return grid_search.best_params_
svc_param_selection(X_train_tf,label_train,5)
{'C': 10, 'gamma': 0.001}
clf = svm.SVC(C=10,gamma=0.001,kernel='linear')
clf.fit(X_train_tf,label_train)
pred = clf.predict(X_test_tf)
Speichere das trainierte Modell zusammen mit dem TF‑IDF‑Vektorisierer mit der Bibliothek pickle, damit du später einfach Daten laden, vektorisieren und mit dem ML‑Modell vorhersagen kannst.
with open('vectorizer.pickle', 'wb') as fin:
    pickle.dump(tf_vect, fin)
with open('mlmodel.pickle','wb') as f:
    pickle.dump(clf,f)
pkl = open('mlmodel.pickle', 'rb')
clf = pickle.load(pkl)
vec = open('vectorizer.pickle', 'rb')
tf_vect = pickle.load(vec)
/home/naveksha/.local/lib/python3.5/site-packages/sklearn/base.py:311: UserWarning: Trying to unpickle estimator SVC from version pre-0.18 when using version 0.19.1. This might lead to breaking code or invalid results. Use at your own risk.
  UserWarning)
/home/naveksha/.local/lib/python3.5/site-packages/sklearn/base.py:311: UserWarning: Trying to unpickle estimator TfidfTransformer from version pre-0.18 when using version 0.19.1. This might lead to breaking code or invalid results. Use at your own risk.
  UserWarning)
/home/naveksha/.local/lib/python3.5/site-packages/sklearn/base.py:311: UserWarning: Trying to unpickle estimator TfidfVectorizer from version pre-0.18 when using version 0.19.1. This might lead to breaking code or invalid results. Use at your own risk.
  UserWarning)
X_test_tf = tf_vect.transform(review_test)
pred = clf.predict(X_test_tf)
print(metrics.accuracy_score(label_test, pred))
0.96875
print (confusion_matrix(label_test, pred))
[[149   6]
 [  4 161]]
Die obige Confusion-Matrix ist 2 × 2 aufgebaut: Erstes Zeilen‑, erstes Spaltenelement ist True Positive (TP), erstes Zeilen‑, zweites Spaltenelement ist False Negative (FN), zweite Zeile, erste Spalte ist False Positive (FP) und zweite Zeile, zweite Spalte ist True Negative (TN).
Daraus lässt sich ablesen, dass nur 10 von 320 Testsamples falsch klassifiziert wurden.
print (classification_report(label_test, pred))
             precision    recall  f1-score   support

  deceptive       0.97      0.96      0.97       155
      truth       0.96      0.98      0.97       165

avg / total       0.97      0.97      0.97       320
review_train, review_test, label_train, label_test = train_test_split(result['pos'],result['Labels'], test_size=0.2,random_state=1)
X_test_tf = tf_vect.transform(review_test)
pred = clf.predict(X_test_tf)
print(metrics.accuracy_score(label_test, pred))
0.978125
print (confusion_matrix(label_test, pred))
[[146   5]
 [  2 167]]
print (classification_report(label_test, pred))
             precision    recall  f1-score   support

  deceptive       0.99      0.97      0.98       151
      truth       0.97      0.99      0.98       169

avg / total       0.98      0.98      0.98       320
review_train, review_test, label_train, label_test = train_test_split(result['pos'],result['Labels'], test_size=0.2,random_state=10)
X_test_tf = tf_vect.transform(review_test)
pred = clf.predict(X_test_tf)
print(metrics.accuracy_score(label_test, pred))
0.98125
print (confusion_matrix(label_test, pred))
[[155   5]
 [  1 159]]
print (classification_report(label_test, pred))
             precision    recall  f1-score   support

  deceptive       0.99      0.97      0.98       160
      truth       0.97      0.99      0.98       160

avg / total       0.98      0.98      0.98       320
review_train, review_test, label_train, label_test = train_test_split(result['pos'],result['Labels'], test_size=0.2,random_state=42)
X_test_tf = tf_vect.transform(review_test)
pred = clf.predict(X_test_tf)
print(metrics.accuracy_score(label_test, pred))
0.984375
print (confusion_matrix(label_test, pred))
[[165   3]
 [  2 150]]
print (classification_report(label_test, pred))
             precision    recall  f1-score   support

  deceptive       0.99      0.98      0.99       168
      truth       0.98      0.99      0.98       152

avg / total       0.98      0.98      0.98       320
Aus den obigen Ergebnissen siehst du: Das Modell leistet hervorragende Arbeit und overfittet nicht, da du es mehrfach mit unterschiedlichen Splits getestet hast.
def test_string(s):
    X_test_tf = tf_vect.transform([s])
    y_predict = clf.predict(X_test_tf)
    return y_predict
test_string("The hotel was good.The room had a 27-inch Samsung led tv, a microwave.The room had a double bed")
array(['truth'], dtype=object)
test_string("My family and I are huge fans of this place. The staff is super nice, and the food is great. The chicken is very good, and the garlic sauce is perfect. Ice cream topped with fruit is delicious too. Highly recommended!")
array(['deceptive'], dtype=object)
Das Modell hat beide Bewertungen korrekt klassifiziert. Die erste ist wahrheitsgemäß, die zweite ist irreführend.
Hinweis
Die Modellleistung kann auf unterschiedlichen Systemen mit abweichender Hardware- und Softwarekonfiguration variieren – ein ungewöhnliches, beobachtetes Verhalten. Wenn die Community helfen kann, die Ursache zu finden, profitieren viele, inklusive der Autorin bzw. des Autors dieses Beitrags. Mit Community sind hier die Leserinnen und Leser dieses Tutorials gemeint.
Viel Erfolg beim Lernen!
Hoffentlich war dieses Tutorial hilfreich und bringt dich fachlich weiter.
Wenn du mehr über Machine Learning lernen möchtest, schau dir den DataCamp‑Kurs Building Chatbots in Python an.
Mehr über Python und Machine Learning
Kurs
Kurs
Kurs
Tutorial
Sejal Jaiswal
9 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
DataCamp Team
4 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
DataCamp Team
3 Min.
Tutorial
DataCamp Team
5 Min.


