Corso
Capire il Machine Learning
2 ore
311.9K
Per questo tutorial, lavorerai con un dataset testuale, il Deceptive Opinion Spam Corpus, come esempio.
In sintesi, oggi affronterai i seguenti argomenti:
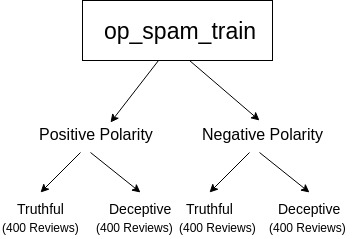
Prima di caricare i dati, è utile dare un'occhiata a cosa userai esattamente! Il Deceptive opinion spam dataset è un corpus composto da recensioni di hotel veritiere e ingannevoli relative a 20 hotel di Chicago. I dati sono descritti in due articoli a seconda del sentiment della recensione. In particolare, l’articolo discute le recensioni a sentiment positivo in 1 e quelle a sentiment negativo in 2; sentiti libero di consultare gli articoli per approfondire.
Il corpus contiene:
In totale ci sono 1600 recensioni; il tuo compito sarà classificare le recensioni di hotel veritiere e ingannevoli usando un algoritmo di machine learning.
Bene, iniziamo!
Inizia importando tutti i moduli richiesti, come os, pandas, nltk, regex e soprattutto Sklearn, dato che in questo tutorial userai un algoritmo di machine learning, il Support Vector Machine, fornito dalla libreria Sklearn!
Ti servirà os per iterare tra cartelle e sottocartelle in cui si trovano i file di testo; fnmatch torna utile per filtrare solo i file di testo e ignorare tutto il resto; pandas ti aiuta a mettere i dati in righe e colonne e a fare varie manipolazioni; Regex serve per estrarre dati in base a pattern; Nltk è un toolkit di linguistica computazionale che ti aiuta a rimuovere le stopword che non vuoi che il modello apprenda. Infine importerai Sklearn, che ti fornirà una serie di librerie per manipolare e vettorializzare i dati, apprendere il confine tra i punti usando un algoritmo di machine learning e, infine, calcolare l’accuratezza.
import os
import fnmatch
from textblob import TextBlob
import pandas as pd
from sklearn.feature_extraction.text import TfidfVectorizer
from nltk.corpus import stopwords
from nltk import pos_tag,pos_tag_sents
import regex as re
import operator
from sklearn.svm import SVC, LinearSVC
from sklearn.metrics import classification_report, accuracy_score, confusion_matrix
from sklearn.cross_validation import train_test_split
from sklearn import metrics
from sklearn import svm
from sklearn.grid_search import GridSearchCV
import pickle
from nltk.corpus import stopwords
Dopo aver importato le librerie, il prossimo compito è estrarre le etichette dei dati. Le etichette aiuteranno il modello a distinguere tra le recensioni, ovvero se una recensione appartiene alla classe veritiera o a quella ingannevole.
Per prima cosa itererai su tutti i file di testo e otterrai il percorso assoluto di ciascun file, dal quale poi estrarrai le etichette corrispondenti.
path = 'op_spam_train/'

label = []

configfiles = [os.path.join(subdir,f)
for subdir, dirs, files in os.walk(path)
    for f in fnmatch.filter(files, '*.txt')]
Dovrebbero essere 1600 percorsi, ciascuno rappresenta un nuovo file di testo. Verifichiamolo rapidamente!
len(configfiles)
1600
Stampiamo anche uno dei percorsi dei file di testo.
configfiles[1]
'op_spam_train/negative_polarity/deceptive_from_MTurk/fold4/d_swissotel_14.txt'
Dal risultato sopra puoi notare che, per estrarre le etichette, serve una sorta di filtro. Per questo userai le Regex, ovvero espressioni regolari.
for f in configfiles:
    c = re.search('(trut|deceptiv)\w',f)
    label.append(c.group())
Una volta estratte le etichette in una lista chiamata label, creiamo un dataframe da questa lista.
labels = pd.DataFrame(label, columns = ['Labels'])
Stampiamo le prime cinque righe del dataframe labels.
labels.head(5)
| Labels | |
|---|---|
| 0 | deceptive |
| 1 | deceptive |
| 2 | deceptive |
| 3 | deceptive |
| 4 | deceptive |
Una volta estratte le etichette, è il momento di estrarre le recensioni dai file di testo!
review = []
directory =os.path.join("op_spam_train")
for subdir,dirs ,files in os.walk(directory):
   # print (subdir)
    for file in files:
        if fnmatch.filter(files, '*.txt'):
            f=open(os.path.join(subdir, file),'r')
            a = f.read()
            review.append(a)
Come prima, ora creerai un dataframe dalla lista review.
reviews = pd.DataFrame(review, columns = ['HotelReviews'])
Stampiamo le prime cinque righe del dataframe reviews.
reviews.head(5)
| HotelReviews | |
|---|---|
| 0 | Grant it, this hotel seems very nice, but I wa... |
| 1 | I recently stayed at the Swissotel Chicago wit... |
| 2 | I was sorely disappointed with the Sheraton Ch... |
| 3 | My family and I stayed at the Sheraton Chicago... |
| 4 | I recently stayed at the Homewood Suites by Hi... |
Ottimo! Fin qui è stato abbastanza intuitivo, no?
Ora uniamo i dataframe labels e reviews!
result = pd.merge(reviews, labels,right_index=True,left_index = True)


result['HotelReviews'] = result['HotelReviews'].map(lambda x: x.lower())
Dopo l’unione, hai un nuovo dataframe chiamato result. Stampiamone anche alcune righe.
result.head()
| HotelReviews | Labels | |
|---|---|---|
| 0 | grant it, this hotel seems very nice, but i wa... | deceptive |
| 1 | i recently stayed at the swissotel chicago wit... | deceptive |
| 2 | i was sorely disappointed with the sheraton ch... | deceptive |
| 3 | my family and i stayed at the sheraton chicago... | deceptive |
| 4 | i recently stayed at the homewood suites by hi... | deceptive |
Quando lavori con dati testuali, è fondamentale rimuovere le stopword. Le stopword non sono significative e non forniscono informazioni utili per aiutare il modello a imparare un pattern nei dati.
Creerai una nuova colonna nel dataframe chiamata review_without_stopwords. La funzione lambda elaborerà tutte le righe della colonna HotelReviews. Userai una list comprehension e memorizzerai nella nuova colonna solo le parole che non sono presenti nella variabile stop.
import ntlk
nltk.download('stopwords')
Nota: per eseguire la cella seguente, potresti dover lanciare le righe di codice sopra nel tuo terminale.
stop = stopwords.words('english')

result['review_without_stopwords'] = result['HotelReviews'].apply(lambda x: ' '.join([word for word in x.split() if word not in (stop)]))
Stampiamo rapidamente il dataframe senza stopword!
result.head()
| HotelReviews | Labels | review_without_stopwords | |
|---|---|---|---|
| 0 | grant it, this hotel seems very nice, but i wa... | deceptive | grant it, hotel seems nice, pleased stay here.... |
| 1 | i recently stayed at the swissotel chicago wit... | deceptive | recently stayed swissotel chicago husband two ... |
| 2 | i was sorely disappointed with the sheraton ch... | deceptive | sorely disappointed sheraton chicago. outside ... |
| 3 | my family and i stayed at the sheraton chicago... | deceptive | family stayed sheraton chicago hotel towers be... |
| 4 | i recently stayed at the homewood suites by hi... | deceptive | recently stayed homewood suites hilton chicago... |
Secondo 1, le opinioni veritiere e ingannevoli potrebbero essere classificate rispettivamente in generi informativi e immaginativi. Esiste una forte differenza distributiva tra scrittura informativa e immaginativa: la prima contiene tipicamente più nomi, aggettivi, preposizioni, determinanti e congiunzioni coordinanti, mentre la seconda include più verbi, avverbi, pronomi e pre-determinanti. Tuttavia, che le opinioni ingannevoli contengano più superlativi non sorprende, poiché la scrittura ingannevole (ma non necessariamente quella immaginativa in generale) spesso usa un linguaggio esagerato.
Ora, per ogni parola in ciascuna riga del dataframe, estraiamo la relativa parte del discorso e useremo questo come vettore di feature per il modello.
Per il tagging pos userai TextBlob, una libreria Python per l’elaborazione del testo. Fornisce una semplice API per attività NLP comuni come part-of-speech tagging, estrazione di sintagmi nominali, analisi del sentiment, classificazione, traduzione e altro.
Nota: per eseguire la cella con la funzione pos, potresti dover eseguire le seguenti righe nel terminale.
import nltk
nltk.download('punkt')
nltk.download('averaged_perceptron_tagger')
def pos(review_without_stopwords):
    return TextBlob(review_without_stopwords).tags
os = result.review_without_stopwords.apply(pos)
os1 = pd.DataFrame(os)
Ogni riga del dataframe os1 conterrà un elenco di parole con la rispettiva parte del discorso. Non potrai vettorializzare un elenco da dare in pasto al modello. Quindi dovrai convertire queste righe di liste in stringhe.
os1.head()
| review_without_stopwords | |
|---|---|
| 0 | [(grant, NN), (it, PRP), (hotel, NN), (seems, ... |
| 1 | [(recently, RB), (stayed, VBN), (swissotel, NN... |
| 2 | [(sorely, RB), (disappointed, JJ), (sheraton, ... |
| 3 | [(family, NN), (stayed, VBD), (sheraton, JJ), ... |
| 4 | [(recently, RB), (stayed, VBN), (homewood, NN)... |
Convertiamo ogni riga in una stringa, dove ogni parola sarà unita al relativo pos con una barra e le parole saranno separate da uno spazio.
os1['pos'] = os1['review_without_stopwords'].map(lambda x:" ".join(["".join(x) for x in x ]) )
Infine, uniamo la colonna pos con il dataframe principale result e stampiamo le prime righe!
result = result = pd.merge(result, os1,right_index=True,left_index = True)
result.head()

Una volta estratte le feature, è il momento di dividere i dati in training e test. In questo tutorial, dividerai l’80% dei dati per il training e il restante 20% per il test.
review_train, review_test, label_train, label_test = train_test_split(result['pos'],result['Labels'], test_size=0.2,random_state=13)
Capiremo più in dettaglio il TfidfVectorizer
Tfidf ha due componenti:
Questa tecnica di pesatura aiuta il modello di machine learning (ML) in classificazione perché indichiamo esplicitamente quali parole pesano di più/di meno.
Ora che lo conosci, implementiamolo sui dati di training e test.
tf_vect = TfidfVectorizer(lowercase = True, use_idf=True, smooth_idf=True, sublinear_tf=False)

X_train_tf = tf_vect.fit_transform(review_train)
X_test_tf = tf_vect.transform(review_test)
Ora implementerai un modello di machine learning noto come Support Vector Machines (SVM). Per capirlo puoi seguire questo link.
Per selezionare i migliori iperparametri per il tuo algoritmo di ML userai GridSearchCV, che, in base ai dati e alle etichette di training, suggerisce i valori migliori dagli insiemi che specifichi come lista. Sceglierai cinque valori diversi per C e gamma e, in base ai tuoi dati, otterrai i valori migliori.
def svc_param_selection(X, y, nfolds):
    Cs = [0.001, 0.01, 0.1, 1, 10]
    gammas = [0.001, 0.01, 0.1, 1]
    param_grid = {'C': Cs, 'gamma' : gammas}
    grid_search = GridSearchCV(svm.SVC(kernel='linear'), param_grid, cv=nfolds)
    grid_search.fit(X, y)
    return grid_search.best_params_
svc_param_selection(X_train_tf,label_train,5)
{'C': 10, 'gamma': 0.001}
clf = svm.SVC(C=10,gamma=0.001,kernel='linear')
clf.fit(X_train_tf,label_train)
pred = clf.predict(X_test_tf)
Salviamo il modello che hai appena addestrato insieme al vettorizzatore Tfidf usando la libreria pickle che hai importato all’inizio, così più tardi potrai semplicemente caricare i dati, vettorializzarli e predire con il modello ML.
with open('vectorizer.pickle', 'wb') as fin:
    pickle.dump(tf_vect, fin)
with open('mlmodel.pickle','wb') as f:
    pickle.dump(clf,f)
pkl = open('mlmodel.pickle', 'rb')
clf = pickle.load(pkl)
vec = open('vectorizer.pickle', 'rb')
tf_vect = pickle.load(vec)
/home/naveksha/.local/lib/python3.5/site-packages/sklearn/base.py:311: UserWarning: Trying to unpickle estimator SVC from version pre-0.18 when using version 0.19.1. This might lead to breaking code or invalid results. Use at your own risk.
  UserWarning)
/home/naveksha/.local/lib/python3.5/site-packages/sklearn/base.py:311: UserWarning: Trying to unpickle estimator TfidfTransformer from version pre-0.18 when using version 0.19.1. This might lead to breaking code or invalid results. Use at your own risk.
  UserWarning)
/home/naveksha/.local/lib/python3.5/site-packages/sklearn/base.py:311: UserWarning: Trying to unpickle estimator TfidfVectorizer from version pre-0.18 when using version 0.19.1. This might lead to breaking code or invalid results. Use at your own risk.
  UserWarning)
X_test_tf = tf_vect.transform(review_test)
pred = clf.predict(X_test_tf)
print(metrics.accuracy_score(label_test, pred))
0.96875
print (confusion_matrix(label_test, pred))
[[149   6]
 [  4 161]]
La confusion matrix sopra è una matrice 2 x 2 in cui il primo elemento della prima riga è il True Positive (TP), il secondo elemento della prima riga è il False Negative (FN), il primo elemento della seconda riga è il False Positive (FP) e il secondo elemento della seconda riga è il True Negative (TN).
Dalla confusion matrix, puoi concludere che solo 10 campioni di test su 320 sono stati classificati in modo errato.
print (classification_report(label_test, pred))
             precision    recall  f1-score   support

  deceptive       0.97      0.96      0.97       155
      truth       0.96      0.98      0.97       165

avg / total       0.97      0.97      0.97       320
review_train, review_test, label_train, label_test = train_test_split(result['pos'],result['Labels'], test_size=0.2,random_state=1)
X_test_tf = tf_vect.transform(review_test)
pred = clf.predict(X_test_tf)
print(metrics.accuracy_score(label_test, pred))
0.978125
print (confusion_matrix(label_test, pred))
[[146   5]
 [  2 167]]
print (classification_report(label_test, pred))
             precision    recall  f1-score   support

  deceptive       0.99      0.97      0.98       151
      truth       0.97      0.99      0.98       169

avg / total       0.98      0.98      0.98       320
review_train, review_test, label_train, label_test = train_test_split(result['pos'],result['Labels'], test_size=0.2,random_state=10)
X_test_tf = tf_vect.transform(review_test)
pred = clf.predict(X_test_tf)
print(metrics.accuracy_score(label_test, pred))
0.98125
print (confusion_matrix(label_test, pred))
[[155   5]
 [  1 159]]
print (classification_report(label_test, pred))
             precision    recall  f1-score   support

  deceptive       0.99      0.97      0.98       160
      truth       0.97      0.99      0.98       160

avg / total       0.98      0.98      0.98       320
review_train, review_test, label_train, label_test = train_test_split(result['pos'],result['Labels'], test_size=0.2,random_state=42)
X_test_tf = tf_vect.transform(review_test)
pred = clf.predict(X_test_tf)
print(metrics.accuracy_score(label_test, pred))
0.984375
print (confusion_matrix(label_test, pred))
[[165   3]
 [  2 150]]
print (classification_report(label_test, pred))
             precision    recall  f1-score   support

  deceptive       0.99      0.98      0.99       168
      truth       0.98      0.99      0.98       152

avg / total       0.98      0.98      0.98       320
Dalle predizioni sopra, puoi osservare che il modello ha fatto un lavoro eccellente e non sta overfittando, dato che lo hai testato più volte dividendo i dati in modo diverso ogni volta.
def test_string(s):
    X_test_tf = tf_vect.transform([s])
    y_predict = clf.predict(X_test_tf)
    return y_predict
test_string("The hotel was good.The room had a 27-inch Samsung led tv, a microwave.The room had a double bed")
array(['truth'], dtype=object)
test_string("My family and I are huge fans of this place. The staff is super nice, and the food is great. The chicken is very good, and the garlic sauce is perfect. Ice cream topped with fruit is delicious too. Highly recommended!")
array(['deceptive'], dtype=object)
Il modello ha predetto correttamente le due recensioni sopra. La prima è una recensione veritiera, mentre la seconda è ingannevole!
Nota
Le prestazioni del modello variano quando è eseguito su sistemi di elaborazione diversi con specifiche differenti: è stato osservato questo comportamento anomalo. Se la community potesse aiutare a capire il problema, sarebbe utile a molte persone, incluso l’autore di questo post. Per community si intendono i lettori che seguiranno questo tutorial!
Buono studio!
Speriamo che questo tutorial ti sia stato utile e aggiunga valore alle tue competenze.
Se vuoi saperne di più sul Machine Learning, segui il corso di DataCamp Building Chatbots in Python.
Approfondisci Python e Machine Learning
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



