{count, plural, one {Kurs} other {Kurs}}
Machine Learning'i Anlamak
{hours} sa
311.9K
Bu ders için örnek olarak bir metin veri kümesi olan Deceptive Opinion Spam Corpus ile çalışacaksınız.
Kısaca, bugün şu konulara değineceksiniz:
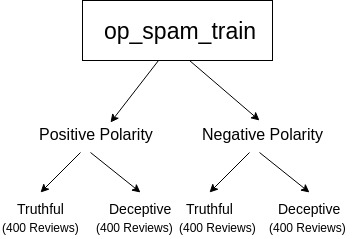
Veriyi yüklemeye geçmeden önce, tam olarak neyle çalışacağınıza göz atmak iyi olur! Deceptive opinion spam veri kümesi, Chicago’daki 20 otelin doğru ve aldatıcı yorumlarından oluşan bir derlemdir. Veriler, incelemenin duygu durumuna göre iki makalede açıklanmaktadır. Özellikle, olumlu duygu içeren yorumlar 1 numaralı ve olumsuz duygu içeren yorumlar 2 numaralı çalışmada tartışılmaktadır; daha derin bilgi için bu makalelere göz atabilirsiniz.
Derlem şunları içerir:
Toplamda 1600 yorum vardır; göreviniz, bir makine öğrenmesi algoritması kullanarak doğru ve aldatıcı otel yorumlarını sınıflandırmaktır.
Haydi başlayalım!
Bugünkü derste Sklearn kütüphanesinin sunduğu bir makine öğrenmesi algoritması olan Support Vector Machine’i kullanacağınız için os, pandas, nltk, regex ve en önemlisi Sklearn gibi gerekli tüm modülleri içe aktararak başlıyorsunuz!
Klasörler ve alt klasörler içinde yer alan metin dosyalarında gezinmek için os’a, yalnızca metin dosyalarını filtreleyip klasörlerdeki diğer her şeyi yok saymak için fnmatch’e ihtiyacınız olacak; pandas, verinizi satır ve sütunlar halinde düzenlemenize ve çeşitli veri işlemleri yapmanıza yardımcı olur. Regex, belirttiğiniz desene uyan verileri çıkarmaya yarar; buna da ihtiyacınız olacak! Nltk, modelinizin öğrenmesini istemediğiniz durak sözcükleri kaldırmanıza yardımcı olan bir doğal dil araç takımıdır. Ve en önemlisi, veriyi işlemek, vektörleştirmek, bir makine öğrenmesi algoritmasıyla veri noktaları arasındaki sınırı öğrenmek ve en sonunda doğruluğu çizdirmek için kullanacağınız bir dizi kütüphane sağlayan Sklearn’i içe aktaracaksınız.
import os
import fnmatch
from textblob import TextBlob
import pandas as pd
from sklearn.feature_extraction.text import TfidfVectorizer
from nltk.corpus import stopwords
from nltk import pos_tag,pos_tag_sents
import regex as re
import operator
from sklearn.svm import SVC, LinearSVC
from sklearn.metrics import classification_report, accuracy_score, confusion_matrix
from sklearn.cross_validation import train_test_split
from sklearn import metrics
from sklearn import svm
from sklearn.grid_search import GridSearchCV
import pickle
from nltk.corpus import stopwords
Kütüphaneleri içe aktardıktan sonra sıradaki göreviniz, verinin etiketlerini çıkarmaktır. Etiketler, bir yorumun doğru mu yoksa aldatıcı sınıfına mı ait olduğunu ayırt etmede modele yardımcı olacaktır.
Önce tüm metin dosyaları üzerinde yineleme yapacak ve ardından ilgili etiketleri çıkaracağınız tüm metin dosyalarının mutlak yolunu elde edeceksiniz.
path = 'op_spam_train/'

label = []

configfiles = [os.path.join(subdir,f)
for subdir, dirs, files in os.walk(path)
    for f in fnmatch.filter(files, '*.txt')]
Her biri yeni bir metin dosyasını temsil eden 1600 yol olmalı. Hızlıca doğrulayalım!
len(configfiles)
1600
Metin dosyası yollarından birini de yazdıralım.
configfiles[1]
'op_spam_train/negative_polarity/deceptive_from_MTurk/fold4/d_swissotel_14.txt'
Yukarıdaki çıktıya bakarak, etiketleri çıkarmak için bir tür filtreye ihtiyacımız olduğunu görebilirsiniz. Bunun için de düzenli ifade olarak bilinen Regex’i kullanacaksınız.
for f in configfiles:
    c = re.search('(trut|deceptiv)\w',f)
    label.append(c.group())
Etiketler label adlı bir listeye çıkarıldıktan sonra, bu listenin bir veri çerçevesini oluşturalım.
labels = pd.DataFrame(label, columns = ['Labels'])
labels veri çerçevesinin ilk beş satırını yazdıralım.
labels.head(5)
| Labels | |
|---|---|
| 0 | deceptive |
| 1 | deceptive |
| 2 | deceptive |
| 3 | deceptive |
| 4 | deceptive |
Tüm etiketleri çıkardıktan sonra, sıra metin dosyalarından yorumları çıkarmaya geldi!
review = []
directory =os.path.join("op_spam_train")
for subdir,dirs ,files in os.walk(directory):
   # print (subdir)
    for file in files:
        if fnmatch.filter(files, '*.txt'):
            f=open(os.path.join(subdir, file),'r')
            a = f.read()
            review.append(a)
Önceki gibi, şimdi de review listesinin bir veri çerçevesini oluşturacaksınız.
reviews = pd.DataFrame(review, columns = ['HotelReviews'])
reviews veri çerçevesinin ilk beş satırını yazdıralım.
reviews.head(5)
| HotelReviews | |
|---|---|
| 0 | Grant it, this hotel seems very nice, but I wa... |
| 1 | I recently stayed at the Swissotel Chicago wit... |
| 2 | I was sorely disappointed with the Sheraton Ch... |
| 3 | My family and I stayed at the Sheraton Chicago... |
| 4 | I recently stayed at the Homewood Suites by Hi... |
Harika! Şimdiye kadar oldukça sezgiseldi, değil mi?
Şimdi labels ve reviews veri çerçevelerini birleştirelim!
result = pd.merge(reviews, labels,right_index=True,left_index = True)


result['HotelReviews'] = result['HotelReviews'].map(lambda x: x.lower())
Birleştirildikten sonra, result adlı yeni bir veri çerçeveniz olur. Bu yeni veri çerçevesinden birkaç satır da yazdıralım.
result.head()
| HotelReviews | Labels | |
|---|---|---|
| 0 | grant it, this hotel seems very nice, but i wa... | deceptive |
| 1 | i recently stayed at the swissotel chicago wit... | deceptive |
| 2 | i was sorely disappointed with the sheraton ch... | deceptive |
| 3 | my family and i stayed at the sheraton chicago... | deceptive |
| 4 | i recently stayed at the homewood suites by hi... | deceptive |
Metin verisiyle çalışırken durak sözcükleri kaldırmak hayati önemdedir. Durak sözcükler anlamlı değildir ve modelin veride bir desen öğrenmesine yardımcı olacak bilgi vermez.
Veri çerçevesinde review_without_stopwords adlı yeni bir sütun oluşturacaksınız. lambda işlevi, HotelReviews sütununun tüm satırlarını işleyecek. Bir liste kavraması kullanacak ve stop değişkeninde yer almayan sözcükleri yeni sütunda saklayacaksınız.
import ntlk
nltk.download('stopwords')
Not: Aşağıdaki hücreyi çalıştırmak için, yukarıdaki kod satırlarını terminalinizde çalıştırmanız gerekebilir.
stop = stopwords.words('english')

result['review_without_stopwords'] = result['HotelReviews'].apply(lambda x: ' '.join([word for word in x.split() if word not in (stop)]))
Durak sözcükler çıkarılmış veri çerçevesini hızlıca yazdıralım!
result.head()
| HotelReviews | Labels | review_without_stopwords | |
|---|---|---|---|
| 0 | grant it, this hotel seems very nice, but i wa... | deceptive | grant it, hotel seems nice, pleased stay here.... |
| 1 | i recently stayed at the swissotel chicago wit... | deceptive | recently stayed swissotel chicago husband two ... |
| 2 | i was sorely disappointed with the sheraton ch... | deceptive | sorely disappointed sheraton chicago. outside ... |
| 3 | my family and i stayed at the sheraton chicago... | deceptive | family stayed sheraton chicago hotel towers be... |
| 4 | i recently stayed at the homewood suites by hi... | deceptive | recently stayed homewood suites hilton chicago... |
1 numaralı çalışmaya göre doğru ve aldatıcı görüşler sırasıyla bilgi verici ve hayal gücüne dayalı türlere ayrılabilir. Bilgi verici ve hayal gücüne dayalı yazılar arasında güçlü bir dağılımsal fark vardır: İlki tipik olarak daha fazla isim, sıfat, edat, belirteç (determiner) ve bağlaç içerirken, ikincisi daha fazla fiil, zarf, zamir ve ön-belirteç içerir. Bununla birlikte, aldatıcı görüşlerin daha çok aşırı derecelendirici (superlative) barındırması beklenmedik değildir; zira aldatıcı yazım (genel olarak hayal gücüne dayalı yazım olmasa da) sıklıkla abartılı bir dil içerir.
Öyleyse şimdi, veri çerçevesindeki her satırdaki her bir kelimenin söz dizimsel türünü çıkaralım ve bunu modelinize bir özellik vektörü olarak besleyelim.
pos etiketleme için, metinsel verileri işlemek üzere bir Python kütüphanesi olan TextBlob’u kullanacaksınız. Part-of-speech etiketleme, isim öbeği çıkarımı, duygu analizi, sınıflandırma, çeviri ve daha pek çok sıradan doğal dil işleme (NLP) görevi için basit bir API sağlar.
Not: pos işlevi hücresini çalıştırmak için terminal penceresinde aşağıdaki kod satırlarını çalıştırmanız gerekebilir.
import nltk
nltk.download('punkt')
nltk.download('averaged_perceptron_tagger')
def pos(review_without_stopwords):
    return TextBlob(review_without_stopwords).tags
os = result.review_without_stopwords.apply(pos)
os1 = pd.DataFrame(os)
os1 veri çerçevesinin her satırı, kelimelerin söz dizimsel türleriyle birlikte bir liste halinde olacaktır. Bu listeyi doğrudan modele beslemek üzere vektörleştiremezsiniz. Bu nedenle bu liste satırlarını dizeye dönüştürmeniz gerekir.
os1.head()
| review_without_stopwords | |
|---|---|
| 0 | [(grant, NN), (it, PRP), (hotel, NN), (seems, ... |
| 1 | [(recently, RB), (stayed, VBN), (swissotel, NN... |
| 2 | [(sorely, RB), (disappointed, JJ), (sheraton, ... |
| 3 | [(family, NN), (stayed, VBD), (sheraton, JJ), ... |
| 4 | [(recently, RB), (stayed, VBN), (homewood, NN)... |
Şimdi her satırı bir dizeye dönüştürelim; burada her kelime karşılık gelen pos etiketiyle eğik çizgi ile birleştirilecek ve kelimeler tek bir boşlukla ayrılacaktır.
os1['pos'] = os1['review_without_stopwords'].map(lambda x:" ".join(["".join(x) for x in x ]) )
Son olarak, pos sütununu ana result veri çerçevesiyle birleştirelim ve ilk birkaç satırını yazdıralım!
result = result = pd.merge(result, os1,right_index=True,left_index = True)
result.head()

Özellikleri çıkardıktan sonra, veriyi eğitim ve test olarak bölme zamanı geldi. Bu derste, verinin %80’ini eğitime, kalan %20’sini teste ayıracaksınız.
review_train, review_test, label_train, label_test = train_test_split(result['pos'],result['Labels'], test_size=0.2,random_state=13)
TfidfVectorizer’ı detaylıca anlayalım
Tfidf iki bölümden oluşur:
Bu ağırlıklandırma tekniği, hangi kelimenin daha fazla/az ağırlığa sahip olduğunu açıkça belirttiğimiz için sınıflandırma sırasında makine öğrenmesi (ML) modeline yardımcı olur.
Artık bunu bildiğinize göre, eğitim ve test verileri üzerinde uygulayalım.
tf_vect = TfidfVectorizer(lowercase = True, use_idf=True, smooth_idf=True, sublinear_tf=False)

X_train_tf = tf_vect.fit_transform(review_train)
X_test_tf = tf_vect.transform(review_test)
Şimdi, Support Vector Machines (SVM) olarak bilinen bir makine öğrenmesi modelini uygulayacaksınız. Anlamak için bu bağlantıyı takip edebilirsiniz.
ML algoritmanız için en iyi hiperparametreleri seçmek üzere, eğitim verileriniz ve etiketlerinize dayanarak belirttiğiniz değerler listesinden en iyi hiperparametreleri öneren GridSearchCV’yi kullanacaksınız. C ve gamma için beşer farklı değer seçecek ve verinize bağlı olarak en iyi hiperparametreleri elde edeceksiniz.
def svc_param_selection(X, y, nfolds):
    Cs = [0.001, 0.01, 0.1, 1, 10]
    gammas = [0.001, 0.01, 0.1, 1]
    param_grid = {'C': Cs, 'gamma' : gammas}
    grid_search = GridSearchCV(svm.SVC(kernel='linear'), param_grid, cv=nfolds)
    grid_search.fit(X, y)
    return grid_search.best_params_
svc_param_selection(X_train_tf,label_train,5)
{'C': 10, 'gamma': 0.001}
clf = svm.SVC(C=10,gamma=0.001,kernel='linear')
clf.fit(X_train_tf,label_train)
pred = clf.predict(X_test_tf)
Az önce eğittiğiniz modeli, başta içe aktardığınız pickle kütüphanesini kullanarak Tfidf vektörleyiciyle birlikte kaydedelim; böylece ileride sadece veriyi yükleyip vektörleştirerek ML modeliyle tahmin yapabilirsiniz.
with open('vectorizer.pickle', 'wb') as fin:
    pickle.dump(tf_vect, fin)
with open('mlmodel.pickle','wb') as f:
    pickle.dump(clf,f)
pkl = open('mlmodel.pickle', 'rb')
clf = pickle.load(pkl)
vec = open('vectorizer.pickle', 'rb')
tf_vect = pickle.load(vec)
/home/naveksha/.local/lib/python3.5/site-packages/sklearn/base.py:311: UserWarning: Trying to unpickle estimator SVC from version pre-0.18 when using version 0.19.1. This might lead to breaking code or invalid results. Use at your own risk.
  UserWarning)
/home/naveksha/.local/lib/python3.5/site-packages/sklearn/base.py:311: UserWarning: Trying to unpickle estimator TfidfTransformer from version pre-0.18 when using version 0.19.1. This might lead to breaking code or invalid results. Use at your own risk.
  UserWarning)
/home/naveksha/.local/lib/python3.5/site-packages/sklearn/base.py:311: UserWarning: Trying to unpickle estimator TfidfVectorizer from version pre-0.18 when using version 0.19.1. This might lead to breaking code or invalid results. Use at your own risk.
  UserWarning)
X_test_tf = tf_vect.transform(review_test)
pred = clf.predict(X_test_tf)
print(metrics.accuracy_score(label_test, pred))
0.96875
print (confusion_matrix(label_test, pred))
[[149   6]
 [  4 161]]
Yukarıdaki karışıklık matrisi 2 x 2 boyutundadır; birinci satır birinci eleman Doğru Pozitif (TP), birinci satır ikinci eleman Yanlış Negatif (FN), ikinci satır birinci eleman Yanlış Pozitif (FP) ve ikinci satır ikinci eleman Doğru Negatif’tir (TN).
Bu karışıklık matrisinden, 320 test örneğinden yalnızca 10’unun yanlış sınıflandığını çıkarabilirsiniz.
print (classification_report(label_test, pred))
             precision    recall  f1-score   support

  deceptive       0.97      0.96      0.97       155
      truth       0.96      0.98      0.97       165

avg / total       0.97      0.97      0.97       320
review_train, review_test, label_train, label_test = train_test_split(result['pos'],result['Labels'], test_size=0.2,random_state=1)
X_test_tf = tf_vect.transform(review_test)
pred = clf.predict(X_test_tf)
print(metrics.accuracy_score(label_test, pred))
0.978125
print (confusion_matrix(label_test, pred))
[[146   5]
 [  2 167]]
print (classification_report(label_test, pred))
             precision    recall  f1-score   support

  deceptive       0.99      0.97      0.98       151
      truth       0.97      0.99      0.98       169

avg / total       0.98      0.98      0.98       320
review_train, review_test, label_train, label_test = train_test_split(result['pos'],result['Labels'], test_size=0.2,random_state=10)
X_test_tf = tf_vect.transform(review_test)
pred = clf.predict(X_test_tf)
print(metrics.accuracy_score(label_test, pred))
0.98125
print (confusion_matrix(label_test, pred))
[[155   5]
 [  1 159]]
print (classification_report(label_test, pred))
             precision    recall  f1-score   support

  deceptive       0.99      0.97      0.98       160
      truth       0.97      0.99      0.98       160

avg / total       0.98      0.98      0.98       320
review_train, review_test, label_train, label_test = train_test_split(result['pos'],result['Labels'], test_size=0.2,random_state=42)
X_test_tf = tf_vect.transform(review_test)
pred = clf.predict(X_test_tf)
print(metrics.accuracy_score(label_test, pred))
0.984375
print (confusion_matrix(label_test, pred))
[[165   3]
 [  2 150]]
print (classification_report(label_test, pred))
             precision    recall  f1-score   support

  deceptive       0.99      0.98      0.99       168
      truth       0.98      0.99      0.98       152

avg / total       0.98      0.98      0.98       320
Yukarıdaki tahminlerden, modeli veriyi her seferinde farklı şekilde bölerek defalarca test ettiğiniz için Aşırı Öğrenme yapmadığını ve Harika Bir İş çıkardığını gözlemleyebilirsiniz.
def test_string(s):
    X_test_tf = tf_vect.transform([s])
    y_predict = clf.predict(X_test_tf)
    return y_predict
test_string("The hotel was good.The room had a 27-inch Samsung led tv, a microwave.The room had a double bed")
array(['truth'], dtype=object)
test_string("My family and I are huge fans of this place. The staff is super nice, and the food is great. The chicken is very good, and the garlic sauce is perfect. Ice cream topped with fruit is delicious too. Highly recommended!")
array(['deceptive'], dtype=object)
Model, yukarıdaki iki yorumu doğru bir şekilde tahmin etti. İlk yorum Doğru bir yorumken, ikinci yorum aldatıcıdır!
Not
Modelin performansı, farklı özelliklere sahip farklı bir işlem sisteminde uygulandığında değişmektedir; bu, gözlemlenen alışılmadık bir davranıştır. Topluluk bu sorunu çözmeye yardımcı olabilirse, bu gönderinin yazarının da dahil olduğu birçok kişiye faydası dokunacaktır. Topluluktan kasıt, bu eğitimi okuyacak olan siz değerli okurlardır!
İyi öğrenmeler!
Umarız bu ders gerçekten faydalı olmuştur ve yeteneklerinize değer katar.
Daha fazla Makine Öğrenmesi öğrenmek isterseniz, DataCamp’in Building Chatbots in Python kursunu alın.
Python ve Makine Öğrenmesi hakkında daha fazlasını öğrenin
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {blog} other {blog}}
Dario Radečić
15 dk.
{count, plural, one {blog} other {blog}}
Abid Ali Awan
14 dk.
{count, plural, one {Eğitim} other {Eğitim}}
Adel Nehme
{count, plural, one {Eğitim} other {Eğitim}}
Kurtis Pykes
8 dk.




