Curso
Entendendo Machine Learning
2 h
308K
Neste tutorial, você vai trabalhar com um dataset de texto, o Deceptive Opinion Spam Corpus, como exemplo.
Em resumo, vamos abordar os seguintes tópicos hoje:
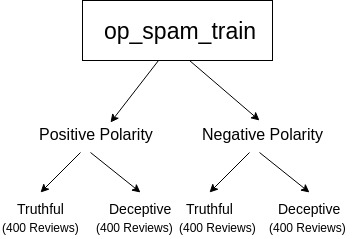
Antes de carregar os dados, vale conferir exatamente com o que você vai trabalhar. O Deceptive Opinion Spam é um corpus com avaliações verdadeiras e enganosas de 20 hotéis em Chicago. Os dados são descritos em dois artigos, de acordo com o sentimento da avaliação. Em particular, avaliações com sentimento positivo são discutidas em 1 e avaliações negativas em 2. Fique à vontade para consultar os artigos para um mergulho mais profundo.
O corpus contém:
No total, são 1600 avaliações. Sua tarefa é classificar avaliações verdadeiras e enganosas usando um algoritmo de machine learning.
Vamos começar!
Você começa importando módulos como os, pandas, nltk, regex e, principalmente, scikit-learn, já que vamos usar o algoritmo de machine learning Support Vector Machine fornecido por essa biblioteca!
Você vai precisar de os para iterar pelas pastas e subpastas onde estão os arquivos de texto; fnmatch ajuda a filtrar apenas os arquivos .txt; pandas organiza seus dados em linhas e colunas e permite várias manipulações. Regex ajuda a extrair dados com base em padrões que você definir — vamos precisar disso também! Nltk é um toolkit de linguagem natural que vai ajudar a remover stopwords que não queremos que o modelo aprenda. E, por fim, scikit-learn traz um conjunto de bibliotecas para manipular dados, vetorizá-los, aprender a fronteira entre pontos com um algoritmo de ML e, por fim, avaliar a acurácia.
import os
import fnmatch
from textblob import TextBlob
import pandas as pd
from sklearn.feature_extraction.text import TfidfVectorizer
from nltk.corpus import stopwords
from nltk import pos_tag,pos_tag_sents
import regex as re
import operator
from sklearn.svm import SVC, LinearSVC
from sklearn.metrics import classification_report, accuracy_score, confusion_matrix
from sklearn_cross_validation import train_test_split
from sklearn import metrics
from sklearn import svm
from sklearn.grid_search import GridSearchCV
import pickle
from nltk.corpus import stopwords
Depois de importar as bibliotecas, a próxima tarefa é extrair os rótulos dos dados. Os rótulos ajudam o modelo a diferenciar se uma avaliação pertence à classe verdadeira ou enganosa.
Primeiro, vamos iterar por todos os arquivos de texto e obter o caminho absoluto de cada um, a partir do qual extrairemos os rótulos correspondentes.
path = 'op_spam_train/'

label = []

configfiles = [os.path.join(subdir,f)
for subdir, dirs, files in os.walk(path)
    for f in fnmatch.filter(files, '*.txt')]
Devem existir 1600 caminhos, cada um representando um novo arquivo de texto. Vamos conferir rapidamente!
len(configfiles)
1600
Vamos também imprimir um dos caminhos.
configfiles[1]
'op_spam_train/negative_polarity/deceptive_from_MTurk/fold4/d_swissotel_14.txt'
Pelo resultado acima, dá para notar que precisamos de algum tipo de filtro para extrair os rótulos. Para isso, vamos usar Regex, as famosas expressões regulares.
for f in configfiles:
    c = re.search('(trut|deceptiv)\w',f)
    label.append(c.group())
Depois que os rótulos forem extraídos para a lista label, vamos criar um dataframe a partir dela.
labels = pd.DataFrame(label, columns = ['Labels'])
Vamos imprimir as cinco primeiras linhas do dataframe labels.
labels.head(5)
| Labels | |
|---|---|
| 0 | deceptive |
| 1 | deceptive |
| 2 | deceptive |
| 3 | deceptive |
| 4 | deceptive |
Com os rótulos em mãos, é hora de extrair as avaliações dos arquivos de texto!
review = []
directory =os.path.join("op_spam_train")
for subdir,dirs ,files in os.walk(directory):
   # print (subdir)
    for file in files:
        if fnmatch.filter(files, '*.txt'):
            f=open(os.path.join(subdir, file),'r')
            a = f.read()
            review.append(a)
Como antes, vamos criar um dataframe a partir da lista review.
reviews = pd.DataFrame(review, columns = ['HotelReviews'])
Vamos imprimir as cinco primeiras linhas do dataframe reviews.
reviews.head(5)
| HotelReviews | |
|---|---|
| 0 | Grant it, this hotel seems very nice, but I wa... |
| 1 | I recently stayed at the Swissotel Chicago wit... |
| 2 | I was sorely disappointed with the Sheraton Ch... |
| 3 | My family and I stayed at the Sheraton Chicago... |
| 4 | I recently stayed at the Homewood Suites by Hi... |
Perfeito! Até aqui, tudo bem intuitivo, não é?
Agora vamos unir os dataframes de labels e reviews!
result = pd.merge(reviews, labels,right_index=True,left_index = True)


result['HotelReviews'] = result['HotelReviews'].map(lambda x: x.lower())
Depois da união, você terá um novo dataframe chamado result. Vamos imprimir algumas linhas.
result.head()
| HotelReviews | Labels | |
|---|---|---|
| 0 | grant it, this hotel seems very nice, but i wa... | deceptive |
| 1 | i recently stayed at the swissotel chicago wit... | deceptive |
| 2 | i was sorely disappointed with the sheraton ch... | deceptive |
| 3 | my family and i stayed at the sheraton chicago... | deceptive |
| 4 | i recently stayed at the homewood suites by hi... | deceptive |
Ao trabalhar com texto, é fundamental remover stopwords. Elas não carregam significado relevante e não ajudam o modelo a aprender padrões úteis.
Vamos criar uma nova coluna chamada review_without_stopwords. A função lambda vai processar todas as linhas da coluna HotelReviews. Usaremos uma list comprehension para manter apenas as palavras que não estão na variável stop.
import ntlk
nltk.download('stopwords')
Observação: para executar a célula abaixo, talvez você precise rodar as linhas acima no seu terminal.
stop = stopwords.words('english')

result['review_without_stopwords'] = result['HotelReviews'].apply(lambda x: ' '.join([word for word in x.split() if word not in (stop)]))
Vamos imprimir rapidamente o dataframe sem stopwords!
result.head()
| HotelReviews | Labels | review_without_stopwords | |
|---|---|---|---|
| 0 | grant it, this hotel seems very nice, but i wa... | deceptive | grant it, hotel seems nice, pleased stay here.... |
| 1 | i recently stayed at the swissotel chicago wit... | deceptive | recently stayed swissotel chicago husband two ... |
| 2 | i was sorely disappointed with the sheraton ch... | deceptive | sorely disappointed sheraton chicago. outside ... |
| 3 | my family and i stayed at the sheraton chicago... | deceptive | family stayed sheraton chicago hotel towers be... |
| 4 | i recently stayed at the homewood suites by hi... | deceptive | recently stayed homewood suites hilton chicago... |
Segundo 1, opiniões verdadeiras e enganosas podem se dividir, respectivamente, em gêneros informativos e imaginativos. Há uma forte diferença de distribuição: textos informativos tendem a ter mais substantivos, adjetivos, preposições, determinantes e conjunções coordenativas; já os imaginativos incluem mais verbos, advérbios, pronomes e pré-determinantes. Além disso, não surpreende que opiniões enganosas contenham mais superlativos, já que esse tipo de escrita costuma usar linguagem exagerada.
Então, para cada palavra nas linhas do dataframe, vamos extrair sua classe gramatical e alimentar isso como vetor de features no modelo.
Para o pos tagging, vamos usar o TextBlob, uma biblioteca Python para processamento de texto. Ela oferece uma API simples para tarefas comuns de PLN, como marcação de classes gramaticais, extração de sintagmas nominais, análise de sentimento, classificação, tradução e mais.
Observação: para rodar a célula da função pos, talvez seja necessário executar as linhas abaixo no seu terminal.
import nltk
nltk.download('punkt')
nltk.download('averaged_perceptron_tagger')
def pos(review_without_stopwords):
    return TextBlob(review_without_stopwords).tags
os = result.review_without_stopwords.apply(pos)
os1 = pd.DataFrame(os)
Cada linha do dataframe os1 terá uma lista de palavras com suas respectivas classes gramaticais. Você não vai conseguir vetorizar uma lista diretamente para alimentar o modelo, então precisamos converter essas listas em strings.
os1.head()
| review_without_stopwords | |
|---|---|
| 0 | [(grant, NN), (it, PRP), (hotel, NN), (seems, ... |
| 1 | [(recently, RB), (stayed, VBN), (swissotel, NN... |
| 2 | [(sorely, RB), (disappointed, JJ), (sheraton, ... |
| 3 | [(family, NN), (stayed, VBD), (sheraton, JJ), ... |
| 4 | [(recently, RB), (stayed, VBN), (homewood, NN)... |
Vamos converter cada linha em uma string, unindo cada palavra à sua pos com uma barra e separando termos por espaço.
os1['pos'] = os1['review_without_stopwords'].map(lambda x:" ".join(["".join(x) for x in x ]) )
Por fim, vamos unir a coluna pos ao dataframe principal result e imprimir as primeiras linhas!
result = result = pd.merge(result, os1,right_index=True,left_index = True)
result.head()

Com as features extraídas, é hora de dividir os dados em treino e teste. Neste tutorial, vamos usar 80% para treino e 20% para teste.
review_train, review_test, label_train, label_test = train_test_split(result['pos'],result['Labels'], test_size=0.2,random_state=13)
Vamos entender o TfidfVectorizer em mais detalhes.
O Tfidf tem duas partes:
Essa ponderação ajuda o modelo de ML na classificação, pois indica explicitamente quais palavras pesam mais/menos.
Agora que você entendeu, vamos aplicar nos dados de treino e teste.
tf_vect = TfidfVectorizer(lowercase = True, use_idf=True, smooth_idf=True, sublinear_tf=False)

X_train_tf = tf_vect.fit_transform(review_train)
X_test_tf = tf_vect.transform(review_test)
Agora vamos implementar o Support Vector Machines (SVM). Para entender melhor, confira este link.
Para selecionar os melhores hiperparâmetros, vamos usar o GridSearchCV, que, com base nos seus dados de treino e rótulos, sugere os melhores valores dentre os que você fornecer como lista. Vamos escolher cinco valores para C e gamma e, com base nos dados, obter os melhores.
def svc_param_selection(X, y, nfolds):
    Cs = [0.001, 0.01, 0.1, 1, 10]
    gammas = [0.001, 0.01, 0.1, 1]
    param_grid = {'C': Cs, 'gamma' : gammas}
    grid_search = GridSearchCV(svm.SVC(kernel='linear'), param_grid, cv=nfolds)
    grid_search.fit(X, y)
    return grid_search.best_params_
svc_param_selection(X_train_tf,label_train,5)
{'C': 10, 'gamma': 0.001}
clf = svm.SVC(C=10,gamma=0.001,kernel='linear')
clf.fit(X_train_tf,label_train)
pred = clf.predict(X_test_tf)
Vamos salvar o modelo que você acabou de treinar, junto com o vetorizar Tfidf, usando a biblioteca pickle, para que depois seja possível apenas carregar, vetorizar os dados e prever com o modelo.
with open('vectorizer.pickle', 'wb') as fin:
    pickle.dump(tf_vect, fin)
with open('mlmodel.pickle','wb') as f:
    pickle.dump(clf,f)
pkl = open('mlmodel.pickle', 'rb')
clf = pickle.load(pkl)
vec = open('vectorizer.pickle', 'rb')
tf_vect = pickle.load(vec)
/home/naveksha/.local/lib/python3.5/site-packages/sklearn/base.py:311: UserWarning: Trying to unpickle estimator SVC from version pre-0.18 when using version 0.19.1. This might lead to breaking code or invalid results. Use at your own risk.
  UserWarning)
/home/naveksha/.local/lib/python3.5/site-packages/sklearn/base.py:311: UserWarning: Trying to unpickle estimator TfidfTransformer from version pre-0.18 when using version 0.19.1. This might lead to breaking code or invalid results. Use at your own risk.
  UserWarning)
/home/naveksha/.local/lib/python3.5/site-packages/sklearn/base.py:311: UserWarning: Trying to unpickle estimator TfidfVectorizer from version pre-0.18 when using version 0.19.1. This might lead to breaking code or invalid results. Use at your own risk.
  UserWarning)
X_test_tf = tf_vect.transform(review_test)
pred = clf.predict(X_test_tf)
print(metrics.accuracy_score(label_test, pred))
0.96875
print (confusion_matrix(label_test, pred))
[[149   6]
 [  4 161]]
A matriz de confusão acima é 2 x 2, na qual o primeiro elemento da primeira linha é o verdadeiro positivo (TP), o segundo é o falso negativo (FN), o primeiro elemento da segunda linha é o falso positivo (FP) e o segundo é o verdadeiro negativo (TN).
Pela matriz, dá para concluir que apenas 10 amostras de teste, dentre 320, foram classificadas incorretamente.
print (classification_report(label_test, pred))
             precision    recall  f1-score   support

  deceptive       0.97      0.96      0.97       155
      truth       0.96      0.98      0.97       165

avg / total       0.97      0.97      0.97       320
review_train, review_test, label_train, label_test = train_test_split(result['pos'],result['Labels'], test_size=0.2,random_state=1)
X_test_tf = tf_vect.transform(review_test)
pred = clf.predict(X_test_tf)
print(metrics.accuracy_score(label_test, pred))
0.978125
print (confusion_matrix(label_test, pred))
[[146   5]
 [  2 167]]
print (classification_report(label_test, pred))
             precision    recall  f1-score   support

  deceptive       0.99      0.97      0.98       151
      truth       0.97      0.99      0.98       169

avg / total       0.98      0.98      0.98       320
review_train, review_test, label_train, label_test = train_test_split(result['pos'],result['Labels'], test_size=0.2,random_state=10)
X_test_tf = tf_vect.transform(review_test)
pred = clf.predict(X_test_tf)
print(metrics.accuracy_score(label_test, pred))
0.98125
print (confusion_matrix(label_test, pred))
[[155   5]
 [  1 159]]
print (classification_report(label_test, pred))
             precision    recall  f1-score   support

  deceptive       0.99      0.97      0.98       160
      truth       0.97      0.99      0.98       160

avg / total       0.98      0.98      0.98       320
review_train, review_test, label_train, label_test = train_test_split(result['pos'],result['Labels'], test_size=0.2,random_state=42)
X_test_tf = tf_vect.transform(review_test)
pred = clf.predict(X_test_tf)
print(metrics.accuracy_score(label_test, pred))
0.984375
print (confusion_matrix(label_test, pred))
[[165   3]
 [  2 150]]
print (classification_report(label_test, pred))
             precision    recall  f1-score   support

  deceptive       0.99      0.98      0.99       168
      truth       0.98      0.99      0.98       152

avg / total       0.98      0.98      0.98       320
Pelos resultados acima, dá para ver que o modelo mandou muito bem e não está com overfitting, já que você o testou várias vezes com diferentes divisões de dados.
def test_string(s):
    X_test_tf = tf_vect.transform([s])
    y_predict = clf.predict(X_test_tf)
    return y_predict
test_string("The hotel was good.The room had a 27-inch Samsung led tv, a microwave.The room had a double bed")
array(['truth'], dtype=object)
test_string("My family and I are huge fans of this place. The staff is super nice, and the food is great. The chicken is very good, and the garlic sauce is perfect. Ice cream topped with fruit is delicious too. Highly recommended!")
array(['deceptive'], dtype=object)
O modelo previu corretamente as duas avaliações acima. A primeira é verdadeira, enquanto a segunda é enganosa.
Observação
O desempenho do modelo pode variar quando implementado em máquinas com especificações diferentes; esse é um comportamento incomum observado. Se a comunidade puder ajudar a entender o problema, isso vai ajudar muita gente — inclusive a autora deste post. Por comunidade, entendemos quem está lendo e acompanhando este tutorial!
Bons estudos!
Esperamos que este tutorial tenha sido útil e agregue valor às suas habilidades.
Se você quer aprender mais sobre Machine Learning, faça o curso da DataCamp Building Chatbots in Python.
Aprenda mais sobre Python e machine learning
Curso
Curso
Curso
Tutorial
Moez Ali
14 min
Tutorial
Moez Ali
13 min
Tutorial
Moez Ali
9 min
Tutorial
Moez Ali
12 min
Tutorial
Avinash Navlani
10 min
Tutorial
Kurtis Pykes
12 min



