Cours
Comprendre le Machine Learning
2 h
308.2K
Pour ce tutoriel, vous allez travailler sur un jeu de données textuelles intitulé Deceptive Opinion Spam Corpus, à titre d’exemple.
En résumé, voici les thèmes abordés aujourd’hui :
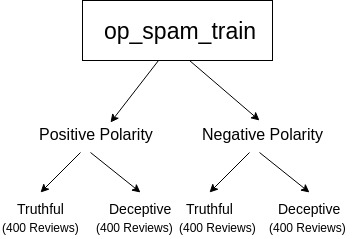
Avant de charger les données, il est utile de savoir précisément sur quoi vous allez travailler. Le jeu de données Deceptive Opinion Spam est un corpus composé d’avis d’hôtels véridiques et trompeurs portant sur 20 hôtels de Chicago. Les données sont décrites dans deux articles selon le sentiment de l’avis : les avis à sentiment positif sont présentés dans 1 et les avis à sentiment négatif dans 2. N’hésitez pas à vous y référer pour aller plus loin.
Le corpus contient :
Au total, vous disposez de 1 600 avis. Votre mission sera de classer les avis d’hôtels en deux catégories, véridiques ou trompeurs, à l’aide d’un algorithme de machine learning.
C’est parti !
Commencez par importer les modules requis : os, pandas, nltk, regex et, surtout, scikit‑learn, puisque dans ce tutoriel vous utiliserez un algorithme de machine learning, la machine à vecteurs de support (SVM), fournie par la bibliothèque scikit‑learn.
Vous aurez besoin de os pour itérer sur les dossiers et sous‑dossiers contenant les fichiers texte, fnmatch pour filtrer uniquement les fichiers .txt et ignorer le reste, pandas pour organiser vos données en lignes et colonnes et effectuer différentes manipulations. Regex permet d’extraire des informations à partir de motifs, ce qui sera également utile. NLTK (Natural Language Toolkit) vous aidera à supprimer les stopwords que vous ne souhaitez pas voir apprendre par le modèle. Enfin, scikit‑learn vous fournira tout un ensemble d’outils pour manipuler et vectoriser les données, apprendre la frontière de décision avec un algorithme de machine learning et, pour finir, évaluer l’exactitude.
import os
import fnmatch
from textblob import TextBlob
import pandas as pd
from sklearn.feature_extraction.text import TfidfVectorizer
from nltk.corpus import stopwords
from nltk import pos_tag,pos_tag_sents
import regex as re
import operator
from sklearn.svm import SVC, LinearSVC
from sklearn.metrics import classification_report, accuracy_score, confusion_matrix
from sklearn.cross_validation import train_test_split
from sklearn import metrics
from sklearn import svm
from sklearn.grid_search import GridSearchCV
import pickle
from nltk.corpus import stopwords
Après l’import des bibliothèques, votre prochaine tâche est d’extraire les étiquettes des données. Ces étiquettes permettront au modèle de distinguer les avis, c’est‑à‑dire d’indiquer si un avis appartient à la classe « véridique » ou « trompeur ».
Commencez par itérer sur tous les fichiers texte pour récupérer le chemin absolu de chacun, à partir duquel vous pourrez ensuite extraire les étiquettes correspondantes.
path = 'op_spam_train/'

label = []

configfiles = [os.path.join(subdir,f)
for subdir, dirs, files in os.walk(path)
    for f in fnmatch.filter(files, '*.txt')]
Vous devriez obtenir 1 600 chemins, chacun représentant un fichier texte. Vérifions rapidement.
len(configfiles)
1600
Affichons également l’un des chemins de fichier.
configfiles[1]
'op_spam_train/negative_polarity/deceptive_from_MTurk/fold4/d_swissotel_14.txt'
À partir de cette sortie, vous constatez que pour extraire les étiquettes, il nous faut un filtre. Pour cela, vous utiliserez les expressions régulières (Regex).
for f in configfiles:
    c = re.search('(trut|deceptiv)\w',f)
    label.append(c.group())
Une fois les étiquettes extraites dans une liste nommée label, créez un dataframe à partir de cette liste.
labels = pd.DataFrame(label, columns = ['Labels'])
Affichons les cinq premières lignes du dataframe labels.
labels.head(5)
| Labels | |
|---|---|
| 0 | deceptive |
| 1 | deceptive |
| 2 | deceptive |
| 3 | deceptive |
| 4 | deceptive |
Après avoir extrait toutes les étiquettes, il est temps d’extraire les avis depuis les fichiers texte.
review = []
directory =os.path.join("op_spam_train")
for subdir,dirs ,files in os.walk(directory):
   # print (subdir)
    for file in files:
        if fnmatch.filter(files, '*.txt'):
            f=open(os.path.join(subdir, file),'r')
            a = f.read()
            review.append(a)
Comme précédemment, créez maintenant un dataframe à partir de la liste review.
reviews = pd.DataFrame(review, columns = ['HotelReviews'])
Affichons les cinq premières lignes du dataframe reviews.
reviews.head(5)
| HotelReviews | |
|---|---|
| 0 | Grant it, this hotel seems very nice, but I wa... |
| 1 | I recently stayed at the Swissotel Chicago wit... |
| 2 | I was sorely disappointed with the Sheraton Ch... |
| 3 | My family and I stayed at the Sheraton Chicago... |
| 4 | I recently stayed at the Homewood Suites by Hi... |
Parfait, jusque‑là tout est assez intuitif, n’est‑ce pas ?
Fusionnons maintenant les dataframes labels et reviews.
result = pd.merge(reviews, labels,right_index=True,left_index = True)


result['HotelReviews'] = result['HotelReviews'].map(lambda x: x.lower())
Après fusion, vous obtenez un nouveau dataframe nommé result. Affichons‑en quelques lignes.
result.head()
| HotelReviews | Labels | |
|---|---|---|
| 0 | grant it, this hotel seems very nice, but i wa... | deceptive |
| 1 | i recently stayed at the swissotel chicago wit... | deceptive |
| 2 | i was sorely disappointed with the sheraton ch... | deceptive |
| 3 | my family and i stayed at the sheraton chicago... | deceptive |
| 4 | i recently stayed at the homewood suites by hi... | deceptive |
Avec des données textuelles, il est essentiel de supprimer les stopwords. Ils sont peu informatifs et n’apportent rien d’utile à l’apprentissage d’un motif par le modèle.
Créez une nouvelle colonne dans le dataframe, nommée review_without_stopwords. La fonction lambda traitera toutes les lignes de la colonne HotelReviews. À l’aide d’une compréhension de liste, vous ne conserverez dans la nouvelle colonne que les mots qui ne figurent pas dans la variable stop.
import ntlk
nltk.download('stopwords')
Remarque : pour exécuter la cellule ci‑dessous, vous devrez peut‑être lancer les lignes ci‑dessus dans votre terminal.
stop = stopwords.words('english')

result['review_without_stopwords'] = result['HotelReviews'].apply(lambda x: ' '.join([word for word in x.split() if word not in (stop)]))
Affichons rapidement le dataframe sans stopwords.
result.head()
| HotelReviews | Labels | review_without_stopwords | |
|---|---|---|---|
| 0 | grant it, this hotel seems very nice, but i wa... | deceptive | grant it, hotel seems nice, pleased stay here.... |
| 1 | i recently stayed at the swissotel chicago wit... | deceptive | recently stayed swissotel chicago husband two ... |
| 2 | i was sorely disappointed with the sheraton ch... | deceptive | sorely disappointed sheraton chicago. outside ... |
| 3 | my family and i stayed at the sheraton chicago... | deceptive | family stayed sheraton chicago hotel towers be... |
| 4 | i recently stayed at the homewood suites by hi... | deceptive | recently stayed homewood suites hilton chicago... |
Comme indiqué dans 1, les avis véridiques et trompeurs peuvent se répartir respectivement dans les genres informatif et imaginatif. On observe une forte différence de distribution : l’écrit informatif contient généralement davantage de noms, adjectifs, prépositions, déterminants et conjonctions de coordination, tandis que l’écrit imaginatif comprend plus de verbes, adverbes, pronoms et prédéterminants. Il n’est toutefois pas surprenant que les avis trompeurs contiennent davantage de superlatifs, l’écriture trompeuse recourant souvent à un langage exagéré (ce qui n’est pas forcément le cas de l’écrit imaginatif en général).
Pour chaque mot de chaque ligne du dataframe, nous allons donc extraire sa partie du discours et utiliser ce signal comme vecteur de caractéristiques dans le modèle.
Pour l’étiquetage POS, vous utiliserez TextBlob, une bibliothèque Python pour le traitement de texte. Elle propose une API simple pour des tâches de NLP courantes : étiquetage morpho‑syntaxique, extraction de syntagmes nominaux, analyse de sentiment, classification, traduction, etc.
Remarque : pour exécuter la cellule de la fonction pos, vous devrez peut‑être lancer les lignes suivantes dans votre terminal.
import nltk
nltk.download('punkt')
nltk.download('averaged_perceptron_tagger')
def pos(review_without_stopwords):
    return TextBlob(review_without_stopwords).tags
os = result.review_without_stopwords.apply(pos)
os1 = pd.DataFrame(os)
Chaque ligne du dataframe os1 contiendra une liste de mots avec leur partie du discours. Vous ne pourrez pas vectoriser une liste telle quelle en entrée du modèle ; il faut donc convertir ces listes en chaînes de caractères.
os1.head()
| review_without_stopwords | |
|---|---|
| 0 | [(grant, NN), (it, PRP), (hotel, NN), (seems, ... |
| 1 | [(recently, RB), (stayed, VBN), (swissotel, NN... |
| 2 | [(sorely, RB), (disappointed, JJ), (sheraton, ... |
| 3 | [(family, NN), (stayed, VBD), (sheraton, JJ), ... |
| 4 | [(recently, RB), (stayed, VBN), (homewood, NN)... |
Convertissons chaque ligne en une chaîne : chaque mot sera joint à son étiquette POS avec un slash, et les paires seront séparées par un espace.
os1['pos'] = os1['review_without_stopwords'].map(lambda x:" ".join(["".join(x) for x in x ]) )
Enfin, fusionnez la colonne pos avec le dataframe principal result et affichez‑en les premières lignes.
result = result = pd.merge(result, os1,right_index=True,left_index = True)
result.head()

Une fois les variables dérivées prêtes, il est temps de scinder les données en ensembles d’entraînement et de test. Dans ce tutoriel, 80 % des données seront utilisées pour l’entraînement et 20 % pour le test.
review_train, review_test, label_train, label_test = train_test_split(result['pos'],result['Labels'], test_size=0.2,random_state=13)
Voyons plus en détail ce qu’est le TfidfVectorizer.
TF‑IDF comporte deux volets :
Ce schéma de pondération aide les modèles de machine learning en classification en indiquant explicitement quels mots doivent peser plus ou moins.
Maintenant que le principe est clair, implémentons‑le sur les données d’entraînement et de test.
tf_vect = TfidfVectorizer(lowercase = True, use_idf=True, smooth_idf=True, sublinear_tf=False)

X_train_tf = tf_vect.fit_transform(review_train)
X_test_tf = tf_vect.transform(review_test)
Vous allez maintenant implémenter un modèle de machine learning appelé Support Vector Machines (SVM). Pour en savoir plus, consultez ce lien.
Pour choisir les meilleurs hyperparamètres, vous utiliserez GridSearchCV qui, à partir de vos données et étiquettes d’entraînement, sélectionne les meilleures valeurs parmi celles que vous fournissez. Nous testerons cinq valeurs différentes pour C et gamma et, selon vos données, vous obtiendrez la meilleure combinaison.
def svc_param_selection(X, y, nfolds):
    Cs = [0.001, 0.01, 0.1, 1, 10]
    gammas = [0.001, 0.01, 0.1, 1]
    param_grid = {'C': Cs, 'gamma' : gammas}
    grid_search = GridSearchCV(svm.SVC(kernel='linear'), param_grid, cv=nfolds)
    grid_search.fit(X, y)
    return grid_search.best_params_
svc_param_selection(X_train_tf,label_train,5)
{'C': 10, 'gamma': 0.001}
clf = svm.SVC(C=10,gamma=0.001,kernel='linear')
clf.fit(X_train_tf,label_train)
pred = clf.predict(X_test_tf)
Sauvegardons le modèle que vous venez d’entraîner ainsi que le vectoriseur TF‑IDF avec la bibliothèque pickle importée au début. Vous pourrez ainsi recharger le tout, vectoriser de nouvelles données et prédire avec le modèle.
with open('vectorizer.pickle', 'wb') as fin:
    pickle.dump(tf_vect, fin)
with open('mlmodel.pickle','wb') as f:
    pickle.dump(clf,f)
pkl = open('mlmodel.pickle', 'rb')
clf = pickle.load(pkl)
vec = open('vectorizer.pickle', 'rb')
tf_vect = pickle.load(vec)
/home/naveksha/.local/lib/python3.5/site-packages/sklearn/base.py:311: UserWarning: Trying to unpickle estimator SVC from version pre-0.18 when using version 0.19.1. This might lead to breaking code or invalid results. Use at your own risk.
  UserWarning)
/home/naveksha/.local/lib/python3.5/site-packages/sklearn/base.py:311: UserWarning: Trying to unpickle estimator TfidfTransformer from version pre-0.18 when using version 0.19.1. This might lead to breaking code or invalid results. Use at your own risk.
  UserWarning)
/home/naveksha/.local/lib/python3.5/site-packages/sklearn/base.py:311: UserWarning: Trying to unpickle estimator TfidfVectorizer from version pre-0.18 when using version 0.19.1. This might lead to breaking code or invalid results. Use at your own risk.
  UserWarning)
X_test_tf = tf_vect.transform(review_test)
pred = clf.predict(X_test_tf)
print(metrics.accuracy_score(label_test, pred))
0.96875
print (confusion_matrix(label_test, pred))
[[149   6]
 [  4 161]]
La matrice de confusion ci‑dessus est une matrice 2 × 2 : premier élément de la première ligne = vrais positifs (TP), deuxième élément = faux négatifs (FN), premier élément de la seconde ligne = faux positifs (FP) et second élément = vrais négatifs (TN).
On en déduit que seuls 10 échantillons sur 320 ont été mal classés.
print (classification_report(label_test, pred))
             precision    recall  f1-score   support

  deceptive       0.97      0.96      0.97       155
      truth       0.96      0.98      0.97       165

avg / total       0.97      0.97      0.97       320
review_train, review_test, label_train, label_test = train_test_split(result['pos'],result['Labels'], test_size=0.2,random_state=1)
X_test_tf = tf_vect.transform(review_test)
pred = clf.predict(X_test_tf)
print(metrics.accuracy_score(label_test, pred))
0.978125
print (confusion_matrix(label_test, pred))
[[146   5]
 [  2 167]]
print (classification_report(label_test, pred))
             precision    recall  f1-score   support

  deceptive       0.99      0.97      0.98       151
      truth       0.97      0.99      0.98       169

avg / total       0.98      0.98      0.98       320
review_train, review_test, label_train, label_test = train_test_split(result['pos'],result['Labels'], test_size=0.2,random_state=10)
X_test_tf = tf_vect.transform(review_test)
pred = clf.predict(X_test_tf)
print(metrics.accuracy_score(label_test, pred))
0.98125
print (confusion_matrix(label_test, pred))
[[155   5]
 [  1 159]]
print (classification_report(label_test, pred))
             precision    recall  f1-score   support

  deceptive       0.99      0.97      0.98       160
      truth       0.97      0.99      0.98       160

avg / total       0.98      0.98      0.98       320
review_train, review_test, label_train, label_test = train_test_split(result['pos'],result['Labels'], test_size=0.2,random_state=42)
X_test_tf = tf_vect.transform(review_test)
pred = clf.predict(X_test_tf)
print(metrics.accuracy_score(label_test, pred))
0.984375
print (confusion_matrix(label_test, pred))
[[165   3]
 [  2 150]]
print (classification_report(label_test, pred))
             precision    recall  f1-score   support

  deceptive       0.99      0.98      0.99       168
      truth       0.98      0.99      0.98       152

avg / total       0.98      0.98      0.98       320
Ces prédictions montrent que le modèle fait un excellent travail et ne surapprend pas, puisque vous l’avez testé à plusieurs reprises en scindant les données différemment à chaque fois.
def test_string(s):
    X_test_tf = tf_vect.transform([s])
    y_predict = clf.predict(X_test_tf)
    return y_predict
test_string("The hotel was good.The room had a 27-inch Samsung led tv, a microwave.The room had a double bed")
array(['truth'], dtype=object)
test_string("My family and I are huge fans of this place. The staff is super nice, and the food is great. The chicken is very good, and the garlic sauce is perfect. Ice cream topped with fruit is delicious too. Highly recommended!")
array(['deceptive'], dtype=object)
Le modèle a correctement prédit ces deux avis. Le premier est véridique, le second est trompeur.
Remarque
Les performances du modèle peuvent varier selon la machine et sa configuration. Un comportement inhabituel a été observé. Si la communauté peut aider à éclaircir ce point, cela serait utile à de nombreuses personnes, y compris l’autrice ou l’auteur de ce billet. Par « communauté », on entend les lectrices et lecteurs de ce tutoriel.
Bon apprentissage !
Nous espérons que ce tutoriel vous a été utile et qu’il enrichit vos compétences.
Pour aller plus loin en machine learning, découvrez le cours DataCamp Building Chatbots in Python.
Approfondissez Python et le machine learning
Cours
Cours
Cours