Khóa học
Tìm hiểu Machine Learning
2 giờ
313.7K
Trong hướng dẫn này, bạn sẽ làm việc với bộ dữ liệu văn bản Deceptive Opinion Spam Corpus làm ví dụ.
Tóm lại, hôm nay bạn sẽ đi qua các nội dung sau:
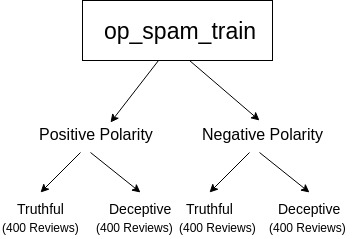
Trước khi tải dữ liệu, sẽ tốt hơn nếu bạn xem qua chính xác bạn sẽ làm việc với cái gì! Bộ dữ liệu đánh giá ý kiến lừa đảo (Deceptive opinion spam) là một corpus gồm các đánh giá khách sạn trung thực và giả mạo của 20 khách sạn ở Chicago. Dữ liệu được mô tả trong hai bài báo theo cảm xúc của đánh giá. Cụ thể, bài viết thảo luận các đánh giá cảm xúc tích cực trong 1 và các đánh giá cảm xúc tiêu cực trong 2, bạn có thể tham khảo các bài báo để hiểu sâu hơn.
Corpus này bao gồm:
Tổng cộng bạn có 1600 đánh giá, nhiệm vụ của bạn là phân loại các đánh giá khách sạn trung thực và giả mạo bằng một thuật toán học máy.
Bắt đầu thôi!
Bạn bắt đầu bằng cách nhập tất cả các mô-đun cần thiết như os, pandas, nltk, regex và quan trọng nhất là Sklearn vì trong hướng dẫn hôm nay bạn sẽ dùng thuật toán học máy Support Vector Machine do thư viện Sklearn cung cấp!
Bạn sẽ cần os để lặp qua các thư mục và thư mục con chứa các tệp văn bản, fnmatch sẽ hữu ích để lọc chỉ các tệp văn bản và bỏ qua những thứ khác trong thư mục, pandas sẽ giúp bạn đưa dữ liệu về dạng hàng và cột và có thể thực hiện nhiều thao tác dữ liệu với pandas. Regex giúp trích xuất dữ liệu dựa trên mẫu bạn chỉ định nên bạn cũng sẽ cần nó! Nltk là bộ công cụ xử lý ngôn ngữ tự nhiên sẽ giúp bạn loại bỏ các stopword mà bạn không muốn mô hình học. Sau cùng và quan trọng nhất, bạn sẽ nhập Sklearn cung cấp cho bạn một loạt thư viện để thao tác dữ liệu, vector hóa dữ liệu, học ranh giới giữa các điểm dữ liệu bằng thuật toán học máy và cuối cùng là vẽ độ chính xác.
import os
import fnmatch
from textblob import TextBlob
import pandas as pd
from sklearn.feature_extraction.text import TfidfVectorizer
from nltk.corpus import stopwords
from nltk import pos_tag,pos_tag_sents
import regex as re
import operator
from sklearn.svm import SVC, LinearSVC
from sklearn.metrics import classification_report, accuracy_score, confusion_matrix
from sklearn_cross_validation import train_test_split
from sklearn import metrics
from sklearn import svm
from sklearn.grid_search import GridSearchCV
import pickle
from nltk.corpus import stopwords
Sau khi nhập thư viện, nhiệm vụ tiếp theo là trích xuất nhãn của dữ liệu. Các nhãn sẽ giúp mô hình phân biệt giữa các đánh giá, liệu một đánh giá cụ thể thuộc lớp trung thực hay giả mạo.
Đầu tiên bạn sẽ lặp qua tất cả các tệp văn bản và lấy đường dẫn tuyệt đối của tất cả các tệp văn bản, từ đó bạn sẽ trích xuất các nhãn tương ứng.
path = 'op_spam_train/'

label = []

configfiles = [os.path.join(subdir,f)
for subdir, dirs, files in os.walk(path)
    for f in fnmatch.filter(files, '*.txt')]
Nên có 1600 đường dẫn, mỗi đường dẫn đại diện cho một tệp văn bản mới. Hãy kiểm tra nhanh nhé!
len(configfiles)
1600
Hãy in ra một trong các đường dẫn tệp văn bản.
configfiles[1]
'op_spam_train/negative_polarity/deceptive_from_MTurk/fold4/d_swissotel_14.txt'
Vậy, từ kết quả trên, bạn có thể thấy rằng để trích xuất nhãn, chúng ta cần một kiểu bộ lọc nào đó. Và cho việc này, bạn sẽ dùng Regex, còn gọi là biểu thức chính quy.
for f in configfiles:
    c = re.search('(trut|deceptiv)\w',f)
    label.append(c.group())
Khi các nhãn đã được trích xuất vào một list tên là label, hãy tạo một dataframe từ list này.
labels = pd.DataFrame(label, columns = ['Labels'])
Hãy in 5 hàng đầu tiên của dataframe labels.
labels.head(5)
| Labels | |
|---|---|
| 0 | deceptive |
| 1 | deceptive |
| 2 | deceptive |
| 3 | deceptive |
| 4 | deceptive |
Sau khi đã trích xuất tất cả nhãn, đến lúc trích xuất nội dung đánh giá từ các tệp văn bản!
review = []
directory =os.path.join("op_spam_train")
for subdir,dirs ,files in os.walk(directory):
   # print (subdir)
    for file in files:
        if fnmatch.filter(files, '*.txt'):
            f=open(os.path.join(subdir, file),'r')
            a = f.read()
            review.append(a)
Giống như trước, giờ bạn sẽ tạo một dataframe từ danh sách review.
reviews = pd.DataFrame(review, columns = ['HotelReviews'])
Hãy in 5 hàng đầu tiên của dataframe reviews.
reviews.head(5)
| HotelReviews | |
|---|---|
| 0 | Grant it, this hotel seems very nice, but I wa... |
| 1 | I recently stayed at the Swissotel Chicago wit... |
| 2 | I was sorely disappointed with the Sheraton Ch... |
| 3 | My family and I stayed at the Sheraton Chicago... |
| 4 | I recently stayed at the Homewood Suites by Hi... |
Tuyệt! Đến đây khá trực quan đúng không?
Giờ hãy gộp cả hai dataframe labels và reviews lại!
result = pd.merge(reviews, labels,right_index=True,left_index = True)


result['HotelReviews'] = result['HotelReviews'].map(lambda x: x.lower())
Sau khi gộp, bạn có một dataframe mới tên là result. Hãy in vài hàng đầu tiên của dataframe này.
result.head()
| HotelReviews | Labels | |
|---|---|---|
| 0 | grant it, this hotel seems very nice, but i wa... | deceptive |
| 1 | i recently stayed at the swissotel chicago wit... | deceptive |
| 2 | i was sorely disappointed with the sheraton ch... | deceptive |
| 3 | my family and i stayed at the sheraton chicago... | deceptive |
| 4 | i recently stayed at the homewood suites by hi... | deceptive |
Khi xử lý dữ liệu văn bản, việc loại bỏ stopword là rất quan trọng. Stopword không mang nhiều ý nghĩa, và chúng không cung cấp thông tin giúp mô hình học được mẫu trong dữ liệu.
Bạn sẽ tạo một cột mới trong dataframe tên là review_without_stopwords. Hàm lambda sẽ xử lý tất cả các hàng của cột HotelReviews. Bạn sẽ dùng list comprehension và chỉ lưu những từ không xuất hiện trong biến stop vào cột mới.
import ntlk
nltk.download('stopwords')
Lưu ý: Để chạy được ô bên dưới, bạn có thể cần chạy các dòng lệnh trên trong terminal.
stop = stopwords.words('english')

result['review_without_stopwords'] = result['HotelReviews'].apply(lambda x: ' '.join([word for word in x.split() if word not in (stop)]))
Hãy in nhanh dataframe sau khi loại bỏ stopword!
result.head()
| HotelReviews | Labels | review_without_stopwords | |
|---|---|---|---|
| 0 | grant it, this hotel seems very nice, but i wa... | deceptive | grant it, hotel seems nice, pleased stay here.... |
| 1 | i recently stayed at the swissotel chicago wit... | deceptive | recently stayed swissotel chicago husband two ... |
| 2 | i was sorely disappointed with the sheraton ch... | deceptive | sorely disappointed sheraton chicago. outside ... |
| 3 | my family and i stayed at the sheraton chicago... | deceptive | family stayed sheraton chicago hotel towers be... |
| 4 | i recently stayed at the homewood suites by hi... | deceptive | recently stayed homewood suites hilton chicago... |
Theo 1 gợi ý rằng ý kiến trung thực và giả mạo có thể lần lượt được phân vào thể loại thông tin (informative) và tưởng tượng (imaginative). Có sự khác biệt phân bố mạnh giữa văn bản thông tin và tưởng tượng, cụ thể là loại thứ nhất thường có nhiều danh từ, tính từ, giới từ, mạo từ và liên từ đẳng lập hơn, trong khi loại sau bao gồm nhiều động từ, trạng từ, đại từ và tiền mạo từ. Tuy nhiên, việc ý kiến giả mạo chứa nhiều dạng so sánh nhất không phải điều bất ngờ, vì văn viết lừa đảo (nhưng không nhất thiết là văn tưởng tượng nói chung) thường dùng ngôn ngữ phóng đại.
Vậy nên, giờ với mỗi từ trong một hàng của dataframe, hãy trích xuất loại từ tương ứng và bạn sẽ đưa phần này vào mô hình như một vector đặc trưng.
Để gán nhãn pos, bạn sẽ dùng TextBlob, một thư viện Python để xử lý dữ liệu văn bản. Nó cung cấp API đơn giản cho các tác vụ NLP phổ biến như gán loại từ, trích xuất cụm danh từ, phân tích cảm xúc, phân loại, dịch, v.v.
Lưu ý: Để chạy ô hàm pos bên dưới, bạn có thể cần chạy các dòng lệnh sau trong cửa sổ terminal.
import nltk
nltk.download('punkt')
nltk.download('averaged_perceptron_tagger')
def pos(review_without_stopwords):
    return TextBlob(review_without_stopwords).tags
os = result.review_without_stopwords.apply(pos)
os1 = pd.DataFrame(os)
Mỗi hàng của dataframe os1 sẽ gồm một danh sách các từ cùng loại từ tương ứng. Bạn sẽ không thể vector hóa một danh sách để đưa vào mô hình. Vì vậy, bạn sẽ phải chuyển các hàng dạng danh sách này thành chuỗi.
os1.head()
| review_without_stopwords | |
|---|---|
| 0 | [(grant, NN), (it, PRP), (hotel, NN), (seems, ... |
| 1 | [(recently, RB), (stayed, VBN), (swissotel, NN... |
| 2 | [(sorely, RB), (disappointed, JJ), (sheraton, ... |
| 3 | [(family, NN), (stayed, VBD), (sheraton, JJ), ... |
| 4 | [(recently, RB), (stayed, VBN), (homewood, NN)... |
Hãy chuyển mỗi hàng thành một chuỗi, trong đó mỗi từ sẽ được nối với thẻ pos tương ứng bằng dấu gạch chéo, và các từ được phân tách bằng một khoảng trắng.
os1['pos'] = os1['review_without_stopwords'].map(lambda x:" ".join(["".join(x) for x in x ]) )
Cuối cùng, hãy gộp cột pos với dataframe chính result và in vài hàng đầu tiên!
result = result = pd.merge(result, os1,right_index=True,left_index = True)
result.head()

Khi đã trích xuất đặc trưng, giờ là lúc chia dữ liệu thành huấn luyện và kiểm tra. Trong hướng dẫn này, bạn sẽ chia 80% dữ liệu để huấn luyện và 20% còn lại để kiểm tra.
review_train, review_test, label_train, label_test = train_test_split(result['pos'],result['Labels'], test_size=0.2,random_state=13)
Hãy tìm hiểu chi tiết về TfidfVectorizer
Tfidf có hai phần:
Kỹ thuật gán trọng số này giúp mô hình học máy trong phân loại vì ta chỉ rõ từ nào nặng/nhẹ hơn.
Bây giờ bạn đã biết về nó, hãy triển khai trên dữ liệu huấn luyện và kiểm tra.
tf_vect = TfidfVectorizer(lowercase = True, use_idf=True, smooth_idf=True, sublinear_tf=False)

X_train_tf = tf_vect.fit_transform(review_train)
X_test_tf = tf_vect.transform(review_test)
Giờ bạn sẽ triển khai một mô hình học máy gọi là Support Vector Machines (SVM). Để hiểu rõ hơn bạn có thể xem liên kết này.
Để chọn siêu tham số tốt nhất cho thuật toán ML, bạn sẽ dùng GridSearchCV, dựa trên dữ liệu huấn luyện và nhãn sẽ gợi ý cho bạn giá trị siêu tham số tốt nhất trong số các giá trị bạn chỉ định dưới dạng danh sách. Bạn sẽ chọn năm giá trị khác nhau cho C và gamma và dựa trên dữ liệu, bạn sẽ nhận được bộ siêu tham số tối ưu.
def svc_param_selection(X, y, nfolds):
    Cs = [0.001, 0.01, 0.1, 1, 10]
    gammas = [0.001, 0.01, 0.1, 1]
    param_grid = {'C': Cs, 'gamma' : gammas}
    grid_search = GridSearchCV(svm.SVC(kernel='linear'), param_grid, cv=nfolds)
    grid_search.fit(X, y)
    return grid_search.best_params_
svc_param_selection(X_train_tf,label_train,5)
{'C': 10, 'gamma': 0.001}
clf = svm.SVC(C=10,gamma=0.001,kernel='linear')
clf.fit(X_train_tf,label_train)
pred = clf.predict(X_test_tf)
Hãy lưu mô hình bạn vừa huấn luyện cùng với bộ vector hóa Tfidf bằng thư viện pickle mà bạn đã nhập ở đầu, để sau này bạn chỉ cần tải dữ liệu, vector hóa và dự đoán bằng mô hình ML.
with open('vectorizer.pickle', 'wb') as fin:
    pickle.dump(tf_vect, fin)
with open('mlmodel.pickle','wb') as f:
    pickle.dump(clf,f)
pkl = open('mlmodel.pickle', 'rb')
clf = pickle.load(pkl)
vec = open('vectorizer.pickle', 'rb')
tf_vect = pickle.load(vec)
/home/naveksha/.local/lib/python3.5/site-packages/sklearn/base.py:311: UserWarning: Trying to unpickle estimator SVC from version pre-0.18 when using version 0.19.1. This might lead to breaking code or invalid results. Use at your own risk.
  UserWarning)
/home/naveksha/.local/lib/python3.5/site-packages/sklearn/base.py:311: UserWarning: Trying to unpickle estimator TfidfTransformer from version pre-0.18 when using version 0.19.1. This might lead to breaking code or invalid results. Use at your own risk.
  UserWarning)
/home/naveksha/.local/lib/python3.5/site-packages/sklearn/base.py:311: UserWarning: Trying to unpickle estimator TfidfVectorizer from version pre-0.18 when using version 0.19.1. This might lead to breaking code or invalid results. Use at your own risk.
  UserWarning)
X_test_tf = tf_vect.transform(review_test)
pred = clf.predict(X_test_tf)
print(metrics.accuracy_score(label_test, pred))
0.96875
print (confusion_matrix(label_test, pred))
[[149   6]
 [  4 161]]
Ma trận nhầm lẫn trên là ma trận 2 x 2, trong đó, phần tử hàng đầu cột đầu là Dương tính thật (TP), hàng đầu cột thứ hai là Âm tính giả (FN), hàng thứ hai cột đầu là Dương tính giả (FP) và hàng thứ hai cột thứ hai là Âm tính thật (TN).
Từ ma trận trên, bạn có thể kết luận chỉ có 10 mẫu kiểm tra trong số 320 bị phân loại sai.
print (classification_report(label_test, pred))
             precision    recall  f1-score   support

  deceptive       0.97      0.96      0.97       155
      truth       0.96      0.98      0.97       165

avg / total       0.97      0.97      0.97       320
review_train, review_test, label_train, label_test = train_test_split(result['pos'],result['Labels'], test_size=0.2,random_state=1)
X_test_tf = tf_vect.transform(review_test)
pred = clf.predict(X_test_tf)
print(metrics.accuracy_score(label_test, pred))
0.978125
print (confusion_matrix(label_test, pred))
[[146   5]
 [  2 167]]
print (classification_report(label_test, pred))
             precision    recall  f1-score   support

  deceptive       0.99      0.97      0.98       151
      truth       0.97      0.99      0.98       169

avg / total       0.98      0.98      0.98       320
review_train, review_test, label_train, label_test = train_test_split(result['pos'],result['Labels'], test_size=0.2,random_state=10)
X_test_tf = tf_vect.transform(review_test)
pred = clf.predict(X_test_tf)
print(metrics.accuracy_score(label_test, pred))
0.98125
print (confusion_matrix(label_test, pred))
[[155   5]
 [  1 159]]
print (classification_report(label_test, pred))
             precision    recall  f1-score   support

  deceptive       0.99      0.97      0.98       160
      truth       0.97      0.99      0.98       160

avg / total       0.98      0.98      0.98       320
review_train, review_test, label_train, label_test = train_test_split(result['pos'],result['Labels'], test_size=0.2,random_state=42)
X_test_tf = tf_vect.transform(review_test)
pred = clf.predict(X_test_tf)
print(metrics.accuracy_score(label_test, pred))
0.984375
print (confusion_matrix(label_test, pred))
[[165   3]
 [  2 150]]
print (classification_report(label_test, pred))
             precision    recall  f1-score   support

  deceptive       0.99      0.98      0.99       168
      truth       0.98      0.99      0.98       152

avg / total       0.98      0.98      0.98       320
Từ các dự đoán trên, bạn có thể thấy Mô hình hoạt động rất tốt và không bị overfit vì bạn đã kiểm thử nhiều lần bằng cách chia dữ liệu theo các cách khác nhau.
def test_string(s):
    X_test_tf = tf_vect.transform([s])
    y_predict = clf.predict(X_test_tf)
    return y_predict
test_string("The hotel was good.The room had a 27-inch Samsung led tv, a microwave.The room had a double bed")
array(['truth'], dtype=object)
test_string("My family and I are huge fans of this place. The staff is super nice, and the food is great. The chicken is very good, and the garlic sauce is perfect. Ice cream topped with fruit is delicious too. Highly recommended!")
array(['deceptive'], dtype=object)
Mô hình đã dự đoán đúng hai đánh giá trên. Đánh giá đầu tiên là trung thực còn đánh giá thứ hai là giả mạo!
Lưu ý
Hiệu năng mô hình có thể thay đổi khi triển khai trên hệ thống xử lý khác với thông số kỹ thuật khác nhau, đây là hành vi bất thường đã được quan sát. Nếu cộng đồng có thể giúp tìm ra nguyên nhân, điều đó sẽ giúp ích rất nhiều cho mọi người, bao gồm cả tác giả bài viết này. Ở đây “cộng đồng” là các độc giả sẽ đọc hướng dẫn này!
Chúc bạn học tốt!
Hy vọng hướng dẫn này thực sự hữu ích và bổ sung giá trị cho bộ kỹ năng của bạn.
Nếu bạn muốn học thêm về Machine Learning, hãy học khóa Building Chatbots in Python của DataCamp.
Tìm hiểu thêm về Python và Machine Learning
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
