Cursus
Introductie tot functies in Python
3 uur
472.5K
Python-applicaties, vooral die met grote datasets of complexe berekeningen, kunnen veel geheugen verbruiken, wat leidt tot vertragingen, crashes of out-of-memory-fouten. Geheugenprofilering is een techniek waarmee je het geheugengebruik van je Python-code kunt analyseren, geheugenlekken en knelpunten kunt identificeren en het geheugengebruik kunt optimaliseren voor betere prestaties en stabiliteit.
In deze tutorial verkennen we geheugenprofilering, de beschikbare tools en praktische voorbeelden van hoe je deze tools gebruikt om je Python-code te profileren.
Geheugenprofilering is de techniek om het geheugengebruik van een programma tijdens het uitvoeren te monitoren en te evalueren. Deze methode helpt ontwikkelaars om geheugenlekken te vinden, het geheugengebruik te optimaliseren en inzicht te krijgen in de patronen van het geheugengebruik van hun programma's. Geheugenprofilering is cruciaal om te voorkomen dat applicaties meer geheugen gebruiken dan nodig is, wat trage prestaties of crashes kan veroorzaken.
Geheugenprofilering biedt verschillende belangrijke voordelen die essentieel zijn voor het onderhouden van efficiënte en robuuste applicaties:
Laten we enkele populaire tools voor geheugenprofilering verkennen, met hun functies, installatie en gebruik. We bekijken specifiek tools zoals memory_profiler voor geheugenanalyse per regel, tracemalloc voor het nemen en vergelijken van geheugensnapshots en objgraph voor het visualiseren van objectrelaties.
memory_profiler is een krachtige tool in Python die gedetailleerd inzicht geeft in het geheugengebruik van je code. Het werkt door een fijne, regel-voor-regel uitsplitsing van het geheugengebruik te bieden, wat handig is om de exacte codelijnen aan te wijzen die verantwoordelijk zijn voor hoog geheugengebruik. Door het geheugengebruik op dit detailniveau te begrijpen, kunnen ontwikkelaars weloverwogen beslissingen nemen over waar ze hun optimalisatie-inspanningen op moeten richten.
Volg deze stappen om memory_profiler en eventuele aanvullende pakketten te installeren:
Met het volgende commando installeer je het pakket memory_profiler:
pip install memory_profilerAls je het geheugengebruik met grafieken wilt visualiseren, kun je matplotlib installeren met:
pip install matplotlibVolg deze stappen om memory_profiler te gebruiken:
Voorzie de functies die je wilt profileren van een decorator.
Open je Python-script in een teksteditor of IDE.
Importeer de profile-decorator uit memory_profiler en pas deze toe op de functies die je wilt profileren.
Hier is een voorbeeldscript:
from memory_profiler import profile
@profile

def allocate_memory():
    # Allocate a list with a range of numbers
    a = [i for i in range(10000)]
    # Allocate another list with squares of numbers
    b = [i ** 2 for i in range(10000)]
    return a, b

if __name__ == "__main__":
allocate_memory()Ik importeer hier de profile-decorator uit het pakket memory_profiler. Deze decorator helpt ons het geheugengebruik van de gedecoreerde functie te monitoren.
from memory_profiler import profileIk pas de @profile-decorator toe op de functie allocate_memory(). Dit betekent dat wanneer allocate_memory() wordt uitgevoerd, memory_profiler het geheugengebruik bijhoudt en een gedetailleerd rapport geeft.
@profileBinnen de functie allocate_memory() maak ik twee lijsten. De eerste lijst bevat de getallen van 0 tot en met 9999; de tweede lijst bevat de kwadraten van de getallen van 0 tot en met 9999.
a = [i for i in range(10000)]  # List of numbers from 0 to 9999

b = [i**2 for i in range(10000)]  # List of squares of numbers from 0 to 9999
Het volgende blok zorgt ervoor dat de functie allocate_memory() alleen wordt aangeroepen wanneer het script direct wordt uitgevoerd en niet wanneer het als module wordt geïmporteerd. Wanneer je dit script draait, zal memory_profiler het geheugengebruik van de functie allocate_memory() weergeven, zodat je ziet hoeveel geheugen wordt gebruikt bij het maken van de twee lijsten, a en b.
if __name__ == "__main__":

   allocate_memory()
Ga in je terminal of opdrachtprompt naar de map waar je script staat. Voer je script uit met de optie -m memory_profiler.
-m memory_profiler your_script.py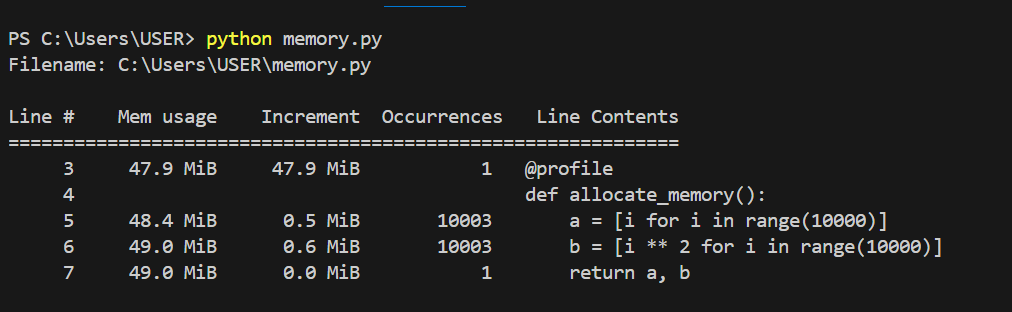
Geheugengebruik per codelijn. Afbeelding door de auteur.
In de bovenstaande grafiek zien we het geheugengebruik van elke codelijn en de toenames per regel. De onderstaande grafiek laat in meer detail zien hoe elke regel geheugen gebruikt en hoe dit toeneemt bij elke iteratie.
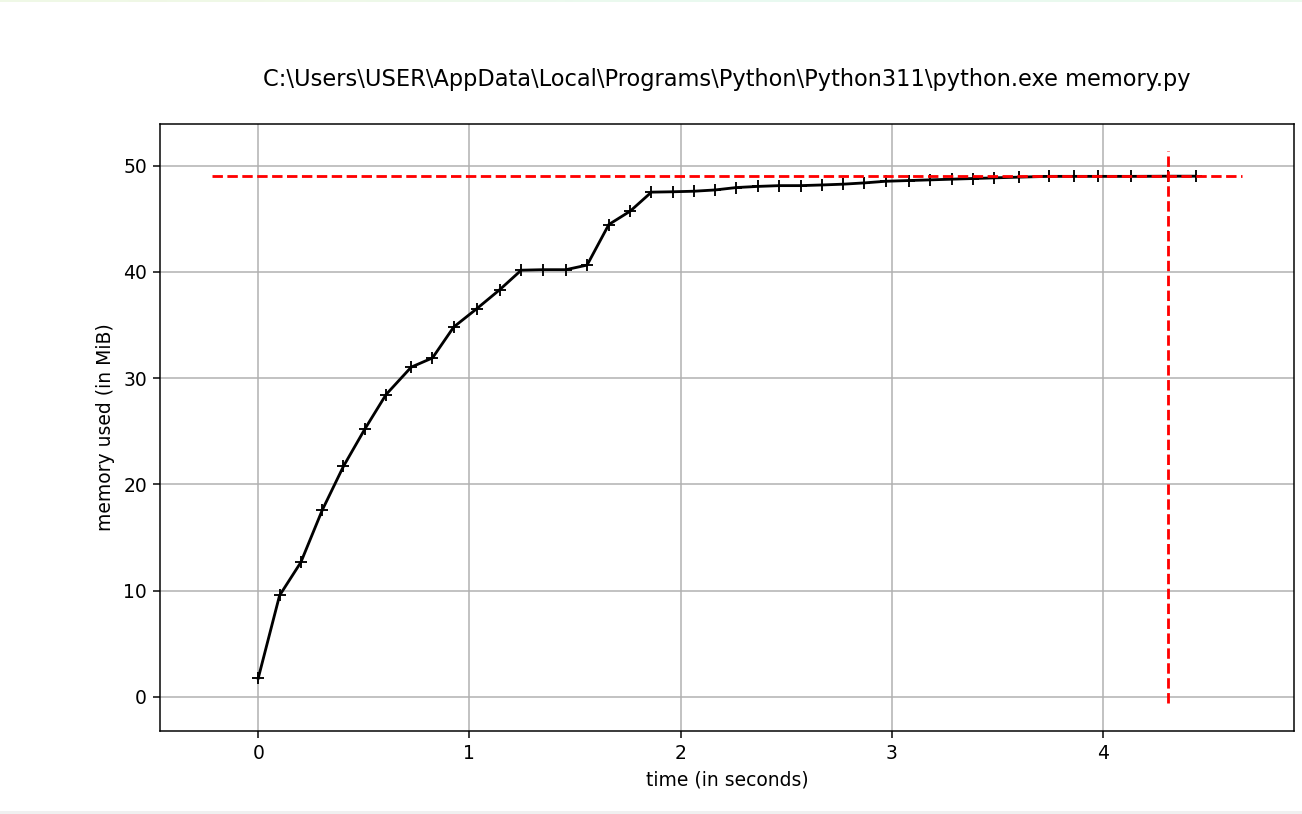
Geheugengebruik in de tijd. Afbeelding door de auteur.
tracemalloc is een krachtige ingebouwde module in Python die geheugenallocaties en -vrijgaven bijhoudt. Begrijpen hoe je applicatie geheugen gebruikt is cruciaal voor het optimaliseren van prestaties en het identificeren van geheugenlekken. Tracemalloc biedt een gebruiksvriendelijke interface voor het vastleggen en analyseren van snapshots van geheugengebruik en is daarmee een onmisbare tool voor elke Python-ontwikkelaar.
Laten we bekijken hoe tracemalloc snapshots van geheugengebruik maakt, die snapshots vergelijkt om geheugenlekken te identificeren en vervolgens de grootste geheugenverbruikers analyseert
tracemalloc laat je snapshots van het geheugengebruik nemen op specifieke punten in je programma. Een snapshot legt de staat van geheugenallocaties vast en geeft een gedetailleerd beeld van waar geheugen wordt gebruikt.
Zo neem je een snapshot met tracemalloc:
import tracemalloc

# Start tracing memory allocations
tracemalloc.start()

# Code block for which memory usage is to be tracked
def allocate_memory():
    a = [i for i in range(10000)]  # List of numbers from 0 to 9999
    b = [i**2 for i in range(10000)]  # List of squares of numbers from 0 to 9999
    return a, b

# Keep the allocated lists in scope
allocated_lists = allocate_memory()

# Take a snapshot
snapshot = tracemalloc.take_snapshot()

# Stop tracing memory allocations
tracemalloc.stop()

# Analyze the snapshot to see memory usage
top_stats = snapshot.statistics('lineno')

# Write the memory usage data to a text file
with open('memory_usage.txt', 'w') as f:
    f.write("[ Top 10 memory consumers ]\n")
    for stat in top_stats[:10]:
        f.write(f"{stat}\n")
    # Detailed traceback for the top memory consumer
    f.write("\n[ Detailed traceback for the top memory consumer ]\n")
    for stat in top_stats[:1]:
        f.write('\n'.join(stat.traceback.format()) + '\n')

print("Memory usage details saved to 'memory_usage.txt'")
Ik heb met de module tracemalloc het geheugengebruik in mijn Python-applicatie gevolgd en onderzocht. Door een snapshot van geheugenallocaties te nemen en te kijken naar de grootste geheugenverbruikers, kon ik bepalen welke delen van mijn code het meeste geheugen gebruikten. Deze analyse heb ik vervolgens in een tekstbestand gezet voor later lezen en referentie.
Een van de krachtigste functies van tracemalloc is de mogelijkheid om snapshots die op verschillende momenten in je programma zijn genomen te vergelijken om geheugenlekken te identificeren. Door de verschillen tussen snapshots te analyseren, kun je aanwijzen waar extra geheugen wordt gealloceerd en niet wordt vrijgegeven.
Zo vergelijk je snapshots:
import tracemalloc

# Start tracing memory allocations
tracemalloc.start()

# Function to allocate memory
def allocate_memory():
    a = [i for i in range(10000)]  # List of numbers from 0 to 9999
    b = [i**2 for i in range(10000)]  # List of squares of numbers from 0 to 9999
    return a, b

# Initial memory usage snapshot
snapshot1 = tracemalloc.take_snapshot()

# Perform memory allocations
allocated_lists = allocate_memory()

# Memory usage snapshot after allocations
snapshot2 = tracemalloc.take_snapshot()

# Further memory allocations (simulate more work to find potential leaks)
allocated_lists += allocate_memory()

# Memory usage snapshot after additional allocations
snapshot3 = tracemalloc.take_snapshot()

# Stop tracing memory allocations
tracemalloc.stop()

# Compare the snapshots
stats1_vs_2 = snapshot2.compare_to(snapshot1, 'lineno')
stats2_vs_3 = snapshot3.compare_to(snapshot2, 'lineno')

# Save the comparison results to a text file
with open('memory_leak_analysis.txt', 'w') as f:
    f.write("[ Memory usage increase from snapshot 1 to snapshot 2 ]\n")
    for stat in stats1_vs_2[:10]:
        f.write(f"{stat}\n")

    f.write("\n[ Memory usage increase from snapshot 2 to snapshot 3 ]\n")
    for stat in stats2_vs_3[:10]:
        f.write(f"{stat}\n")

    # Detailed traceback for the top memory consumers
    f.write("\n[ Detailed traceback for the top memory consumers ]\n")
    for stat in stats2_vs_3[:1]:
        f.write('\n'.join(stat.traceback.format()) + '\n')

print("Memory leak analysis saved to 'memory_leak_analysis.txt'")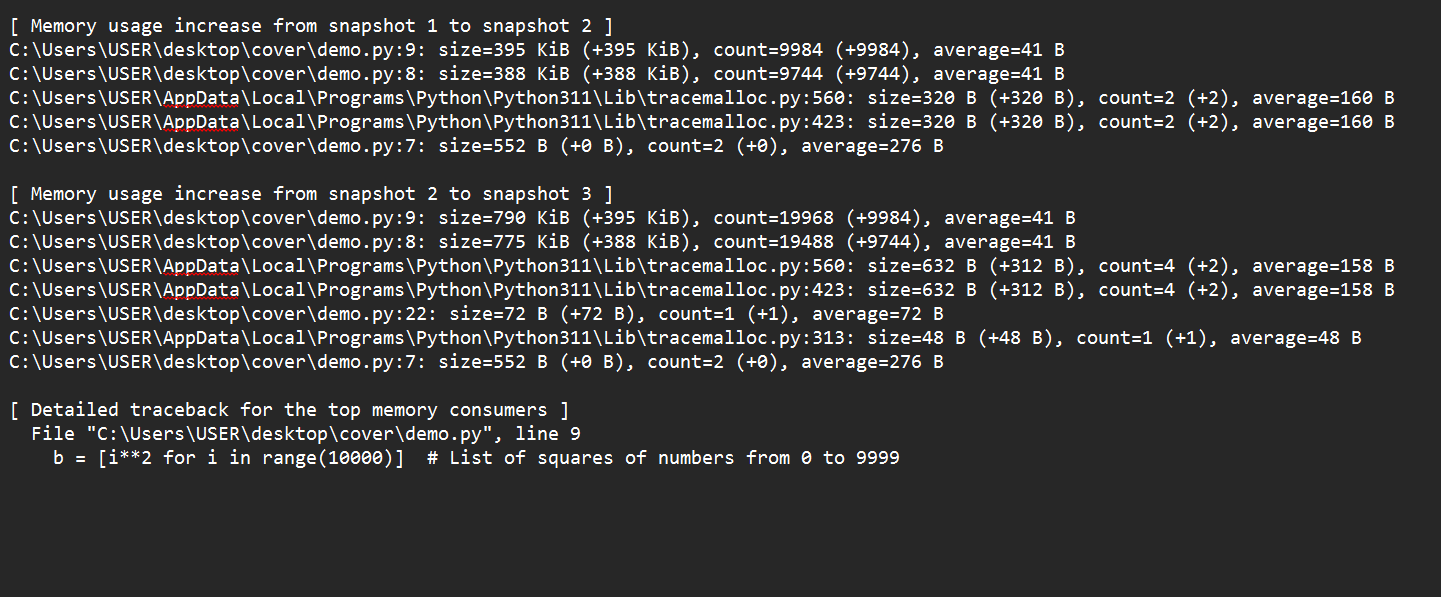
Van snapshot 1 naar snapshot 2 zien we dat het aanmaken van de lijsten a en b de belangrijkste oorzaak was van een piek in het geheugengebruik. Van snapshot 2 naar snapshot 3 zien we ook dat extra allocaties van de lijsten a en b het geheugengebruik verder verhoogden.
Door deze snapshots te vergelijken, ontdekken we dat de voornaamste oorzaak van toenemend geheugengebruik de herhaalde allocatie van grote lijsten is. Als deze allocaties in realistische toepassingen onnodig zijn, kan dit wijzen op een geheugenlek. Een uitgebreide traceback kan de precieze codelijnen aanwijzen die deze allocaties veroorzaken.
tracemalloc biedt ook tools om de grootste geheugenverbruikers van je applicatie te analyseren. Dit helpt je je te richten op het optimaliseren van de delen van je code die het meeste geheugen gebruiken.
Zo analyseer je de grootste geheugenverbruikers:
import tracemalloc

# Start tracing memory allocations
tracemalloc.start()

# Code block for which memory usage is to be tracked
def allocate_memory():
    a = [i for i in range(10000)]
    b = [i**2 for i in range(10000)]

allocate_memory()

# Take a snapshot
snapshot = tracemalloc.take_snapshot()

# Analyze top memory consumers
top_stats = snapshot.statistics('lineno')
print("[ Top 10 memory consumers ]")
for stat in top_stats[:10]:
    print(stat)

# Stop tracing memory allocations
tracemalloc.stop()
In dit voorbeeld gebruik ik na het nemen van een snapshot snapshot.statistics('lineno') om statistieken over geheugengebruik te krijgen, gegroepeerd per regelniveau. Deze output helpt je snel vast te stellen welke delen van je code het meeste geheugen gebruiken, zodat je die gericht kunt optimaliseren.
Objgraph is een Python-bibliotheek die ontwikkelaars helpt objectreferenties in hun code te visualiseren en te analyseren. Het biedt tools om visuele grafen te maken die laten zien hoe objecten in het geheugen naar elkaar verwijzen. Deze visualisatie is nuttig om de structuur en relaties binnen je programma te begrijpen, geheugenlekken te identificeren en het geheugengebruik te optimaliseren.
Laten we eerst de bibliotheek objgraph installeren. Je kunt deze installeren met pip:
pip install objgraphobjgraphobjgraph biedt verschillende cruciale functies voor geheugenprofilering en visualisatie:
objgraph kun je visuele representaties maken van objecten en hun referenties. Dit helpt je te begrijpen hoe objecten met elkaar verbonden zijn, waardoor debuggen en optimaliseren van je code makkelijker wordt.Laten we in enkele voorbeelden duiken om te zien hoe objgraph in de praktijk kan worden gebruikt.
Voorbeeld 1: Een objectreferentiegrafiek genereren
Stel dat we een eenvoudige klasse hebben en enkele instanties maken:
class Node:
    def __init__(self, value):
        self.value = value
        self.children = []

# Create some nodes
node1 = Node(1)
node2 = Node(2)
node3 = Node(3)

# Establish relationships
node1.children.append(node2)
node2.children.append(node3)

import Objgraph

# Generate a graph of object references
objgraph.show_refs([node1], filename='object_refs.png')
In dit voorbeeld definiëren we een klasse Node en maken we instanties van nodes met relaties. De functie objgraph.show_refs() genereert een visuele grafiek van de objectreferenties vanaf node1 en slaat deze op als object_refs.png. Deze grafiek helpt ons te begrijpen hoe de nodes met elkaar verbonden zijn.
Voorbeeld 2: Circulaire referenties detecteren
Om circulaire referenties te detecteren, kunnen we de functie objgraph.find_backref_chain() gebruiken:
# Create a circular reference
node 3.children.append(node1)

# Detect circular references
chain = objgraph.find_backref_chain(node1, objgraph.is_proper_module)
objgraph.show_chain(chain, filename='circular_refs.png')
Hier maken we een circulaire referentie door node1 toe te voegen aan de children van node3. De functie objgraph.find_backref_chain() detecteert deze circulaire referentie en objgraph.show_chain visualiseert deze, waarbij de output wordt opgeslagen als circular_refs.png.
Voorbeeld 3: Objecttypen en -groottes analyseren
Om de typen en groottes van objecten te analyseren, kunnen we objgraph.show_most_common_types en objgraph.by_type gebruiken:
# Show the most common object types
objgraph.show_most_common_types()

# Get the details of a specific object type
objs = objgraph.by_type('Node')
objgraph.show_refs(objs[:3], refcounts=True, filename='node_details.png')
In dit voorbeeld toont objgraph.show_most_common_types de meest voorkomende objecttypen die momenteel in het geheugen staan. De functie objgraph.by_type() haalt alle instanties van de klasse Node op, en we visualiseren hun referenties, inclusief referentietellingen, door een andere grafiek te genereren die wordt opgeslagen als node_details.png.
Laten we nu kijken naar verschillende technieken om tools voor geheugenprofilering effectief te gebruiken. We richten ons op het profileren van specifieke functies, het volgen van het totale geheugengebruik en het visualiseren van objectgrafen.
Richt je op specifieke functies met memory_profiler of tracemalloc.
memory_profilermemory_profiler biedt een eenvoudige manier om het geheugengebruik regel-voor-regel binnen je functies te monitoren, zodat je precies kunt aanwijzen waar het geheugengebruik kan worden verminderd.
from memory_profiler import profile

@profile

def allocate_memory():
    a = [i for i in range(10000)]
    b = [i ** 2 for i in range(10000)]
    return a, b

if __name__ == "__main__":
allocate_memory()tracemallocimport tracemalloc
tracemalloc.start()
def allocate_memory():
a = [i for i in range(10000)]
b = [i ** 2 for i in range(10000)]
return a, b
allocate_memory()
snapshot = tracemalloc.take_snapshot()
top_stats = snapshot.statistics('lineno')
for stat in top_stats[:10]:
print(stat)Om het totale geheugengebruik van ons programma in de tijd te monitoren, kunnen we de ingebouwde module tracemalloc gebruiken. Zo kunnen we het algemene geheugengebruik volgen en de resultaten interpreteren om trends te identificeren.
Stappen om tracemalloc te gebruiken
We beginnen met het initialiseren van geheugentracering aan het begin van ons script.
import tracemalloc

tracemalloc.start()
Vervolgens voeren we onze code uit door de delen te draaien die we willen monitoren.
def run_heavy_computation():
   a = [i for i in range(10000)]
   b = [i**2 for i in range(10000)]
   return a, b

run_heavy_computation()
We nemen snapshots van het geheugengebruik. Zo leggen we de staat van geheugenallocaties op verschillende momenten vast.
snapshot1 = tracemalloc.take_snapshot()

run_heavy_computation()

snapshot2 = tracemalloc.take_snapshot()
Tot slot vergelijken we snapshots om patronen in het geheugengebruik te begrijpen en lekken te detecteren.
stats = snapshot2.compare_to(snapshot1, 'lineno')

for stat in stats[:10]:
   print(stat)
Voorbeeld
import tracemalloc

# Start tracing memory allocations
tracemalloc.start()

# Function to run heavy computation
def run_heavy_computation():
    a = [i for i in range(10000)]
    b = [i**2 for i in range(10000)]
    return a, b

# Initial memory usage snapshot
snapshot1 = tracemalloc.take_snapshot()

# Perform memory allocations
run_heavy_computation()

# Memory usage snapshot after allocations
snapshot2 = tracemalloc.take_snapshot()

# Compare the snapshots
stats = snapshot2.compare_to(snapshot1, 'lineno')

# Print the top 10 memory-consuming lines of code
print("[ Top 10 memory consumers ]")
for stat in stats[:10]:
    print(stat)

# Stop tracing memory allocations
tracemalloc.stop()Hier zijn enkele tips om je te helpen je profileringsdata te duiden:
Met de bibliotheek objgraph kunnen we visualisaties van objectrelaties maken. Dit helpt ons het geheugengebruik te analyseren, lekken te detecteren en de levensduur van objecten te begrijpen.
Hier is het stapsgewijze proces om objectgrafen te visualiseren. Eerst genereren we een grafiek van objectreferenties; vervolgens detecteren we circulaire referenties; tot slot analyseren we de grafieken.
import objgraph

class Node:
   def __init__(self, value):
       self.value = value
       self.children = []

# Create some nodes and establish relationships
node1 = Node(1)
node2 = Node(2)
node3 = Node(3)
node1.children.append(node2)
node2.children.append(node3)

# Generate a graph of object references
objgraph.show_refs([node1], filename='object_refs.png')# Create a circular reference
node3.children.append(node1)
# Detect circular references
chain = objgraph.find_backref_chain(node1, objgraph.is_proper_module)
objgraph.show_chain(chain, filename='circular_refs.png')# Show the most common object types
objgraph.show_most_common_types()
# Get details of a specific object type
nodes = objgraph.by_type('Node')
objgraph.show_refs(nodes[:3], refcounts=True, filename='node_details.png')Voorbeeld
import objgraph
class Node:
def __init__(self, value):
self.value = value
self.children = []
# Create some nodes and establish relationships
node1 = Node(1)
node2 = Node(2)
node3 = Node(3)
node1.children.append(node2)
node2.children.append(node3)
# Generate a graph of object references
objgraph.show_refs([node1], filename='object_refs.png')
# Create a circular reference
node3.children.append(node1)

# Detect circular references
chain = objgraph.find_backref_chain(node1, objgraph.is_proper_module)

objgraph.show_chain(chain, filename='circular_refs.png')
# Show the most common object types
objgraph.show_most_common_types()

# Get details of a specific object type
nodes = objgraph.by_type('Node')

objgraph.show_refs(nodes[:3], refcounts=True, filename='node_details.png')Als laatste stap analyseren we de grafieken. We nemen daarbij de volgende stappen in acht:
Hier zijn enkele belangrijke tips en best practices om alles uit je profileringsinspanningen te halen:
In deze tutorial hebben we essentiële tools en technieken verkend om het geheugengebruik in je Python-applicaties te begrijpen en te optimaliseren. Deze technieken omvatten memory_profiler, dat een eenvoudige manier biedt om het geheugengebruik regel-voor-regel binnen je functie te monitoren, en objgraph, dat krachtige visualisatiemogelijkheden biedt waarmee je objectrelaties kunt analyseren, circulaire referenties kunt detecteren en de structuur van je geheugengebruik kunt begrijpen.
Door tools voor geheugenprofilering te integreren in je ontwikkelworkflow krijg je waardevolle inzichten in hoe je code met geheugen omgaat, kun je weloverwogen optimalisatiebeslissingen nemen en verbeter je de algehele prestaties en betrouwbaarheid van je applicaties. Of je nu aan kleine scripts of grootschalige systemen werkt, geheugenprofilering is een essentiële praktijk voor elke Python-ontwikkelaar die efficiënte en robuuste code wil schrijven.
Wil je je begrip en vaardigheden in geheugenprofilering en het schrijven van efficiënte code verdiepen? Overweeg dan de Writing Efficient Code in Python Course. Daarnaast biedt onze cursus Python Programming een uitgebreid overzicht van best practices en geavanceerde technieken om je te helpen een bekwame ontwikkelaar te worden.
Leer Python met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

