Kurs
Einführung in Funktionen in Python
3 Std.
470.3K
Python-Anwendungen, besonders solche mit großen Datensätzen oder komplexen Berechnungen, können viel Arbeitsspeicher verbrauchen – mit der Folge von Verlangsamungen, Abstürzen oder Out-of-Memory-Fehlern. Memory-Profiling hilft dir, die Speichernutzung deines Python-Codes zu analysieren, Leaks und Engpässe aufzuspüren und den Verbrauch zu optimieren – für bessere Performance und Stabilität.
In diesem Tutorial schauen wir uns Memory-Profiling an, stellen geeignete Tools vor und zeigen anhand praktischer Beispiele, wie du deinen Python-Code profilierst.
Memory-Profiling bezeichnet das Überwachen und Bewerten der Speichernutzung eines Programms zur Laufzeit. Damit finden Entwickler Speicherlecks, optimieren die Speicherauslastung und verstehen Nutzungsmuster ihrer Anwendungen. Memory-Profiling ist entscheidend, um zu verhindern, dass Apps mehr Speicher nutzen als nötig – was träge Performance oder Abstürze verursachen kann.
Memory-Profiling bietet zentrale Vorteile, die für effiziente und robuste Anwendungen wichtig sind:
Schauen wir uns einige verbreitete Tools fürs Memory-Profiling samt Features, Installation und Einsatz an. Konkret behandeln wir memory_profiler für eine zeilenweise Analyse, tracemalloc für Speicher-Snapshots und deren Vergleich sowie objgraph zur Visualisierung von Objektbeziehungen.
memory_profiler ist ein leistungsstarkes Python-Tool, das dir detaillierte Einblicke in die Speichernutzung deines Codes gibt. Es liefert eine fein granulare, zeilenweise Aufschlüsselung und zeigt dir genau, welche Codezeilen für hohen Speicherverbrauch verantwortlich sind. Mit diesem Detailgrad kannst du Optimierungen gezielt ansetzen.
So installierst du memory_profiler und ggf. zusätzliche Pakete:
Mit folgendem Befehl installierst du memory_profiler:
pip install memory_profilerWenn du die Speichernutzung als Diagramm visualisieren möchtest, installiere zusätzlich matplotlib:
pip install matplotlibSo setzt du memory_profiler ein:
Dekoriere die Funktionen, die du profilieren willst.
Öffne dein Python-Skript in einem Editor oder deiner IDE.
Importiere den Decorator aus memory_profiler und versieh die Ziel-Funktionen damit.
Ein Beispielskript:
from memory_profiler import profile
@profile

def allocate_memory():
    # Allocate a list with a range of numbers
    a = [i for i in range(10000)]
    # Allocate another list with squares of numbers
    b = [i ** 2 for i in range(10000)]
    return a, b

if __name__ == "__main__":
allocate_memory()Ich importiere den Decorator profile aus dem Paket memory_profiler. Damit überwachen wir die Speichernutzung der dekorierten Funktion.
from memory_profiler import profileIch wende den @profile-Decorator auf die Funktion allocate_memory() an. Beim Ausführen von allocate_memory() protokolliert memory_profiler die Speichernutzung und liefert einen detaillierten Bericht.
@profileInnerhalb von allocate_memory() erstelle ich zwei Listen. Die erste enthält Zahlen von 0 bis 9999, die zweite die Quadrate von 0 bis 9999.
a = [i for i in range(10000)]  # List of numbers from 0 to 9999

b = [i**2 for i in range(10000)]  # List of squares of numbers from 0 to 9999
Der folgende Block stellt sicher, dass allocate_memory() nur aufgerufen wird, wenn das Skript direkt ausgeführt wird – nicht beim Import als Modul. Beim Ausführen gibt memory_profiler die Speichernutzung der Funktion aus, sodass du siehst, wie viel Speicher beim Erstellen der beiden Listen a und b belegt wird.
if __name__ == "__main__":

   allocate_memory()
Navigiere im Terminal zur Ordnerstruktur deines Skripts und führe es mit der Option -m memory_profiler aus.
-m memory_profiler your_script.py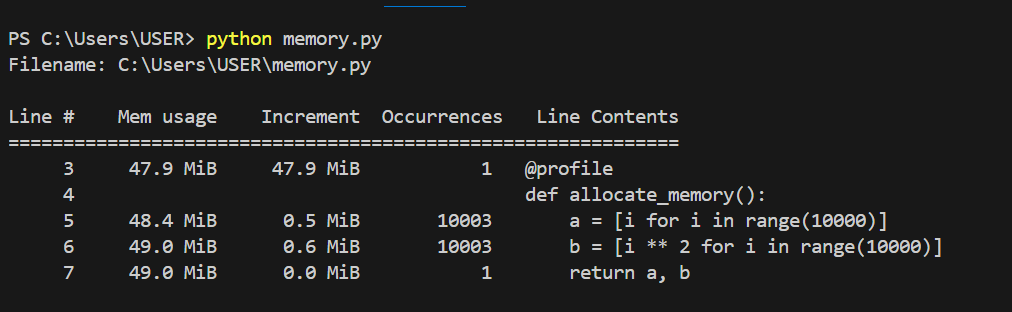
Speichernutzung pro Codezeile. Bild: Autor.
In der Grafik oben siehst du die Speichernutzung jeder Codezeile und die jeweiligen Zuwächse. Das folgende Diagramm zeigt im Zeitverlauf, wie sich die Speichernutzung pro Zeile entwickelt und mit jeder Iteration steigt.
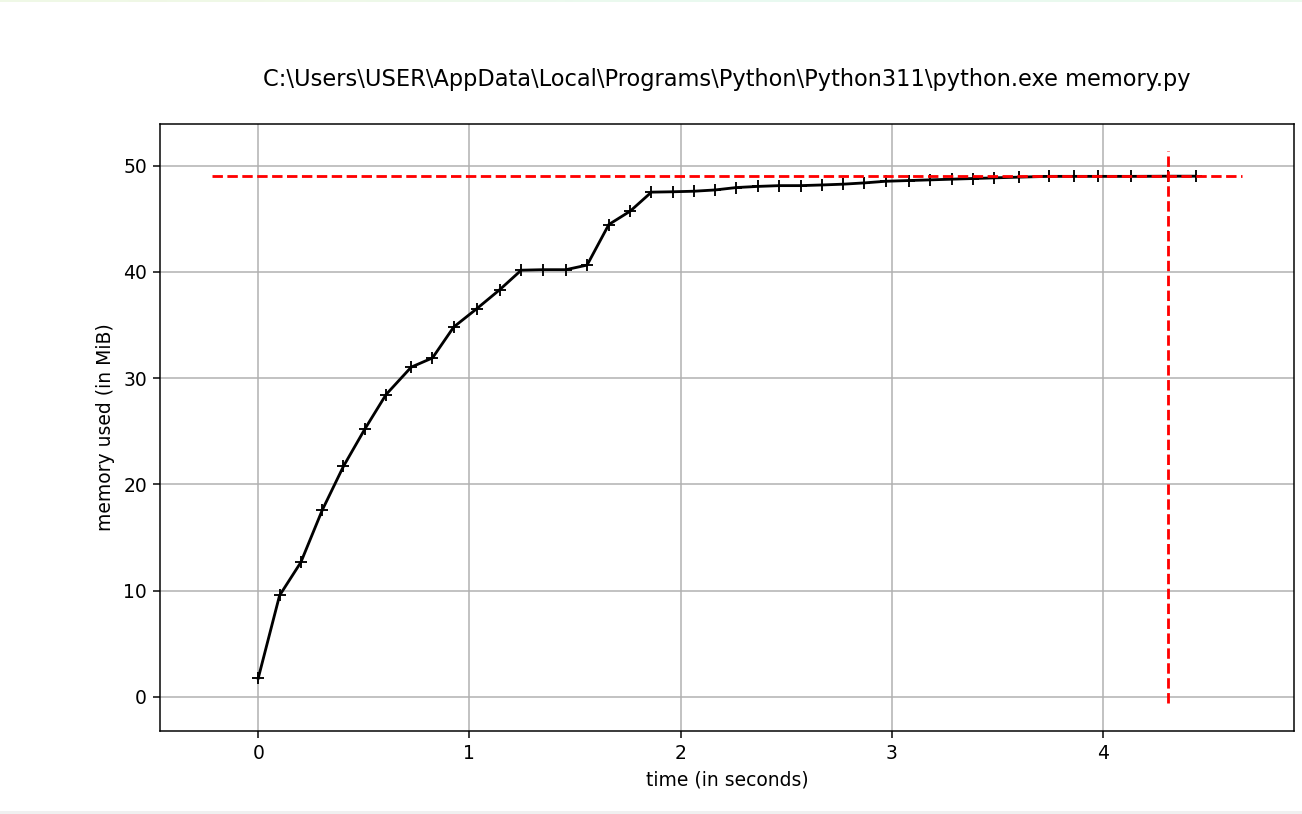
Speichernutzung im Zeitverlauf. Bild: Autor.
tracemalloc ist ein leistungsfähiges, in Python eingebautes Modul, das Speicherallokationen und -freigaben nachverfolgt. Zu verstehen, wie deine Anwendung Speicher nutzt, ist entscheidend, um Performance zu optimieren und Memory-Leaks zu identifizieren. Tracemalloc bietet eine einfache Schnittstelle, um Snapshots der Speichernutzung aufzunehmen und zu analysieren – ein unverzichtbares Werkzeug für Python-Entwickler.
Wir sehen uns an, wie tracemalloc Snapshots der Speichernutzung erstellt, diese vergleicht, um Leaks aufzudecken, und anschließend die größten Speicherfresser analysiert.
tracemalloc ermöglicht es dir, an definierten Punkten im Programmverlauf Snapshots der Speichernutzung zu machen. Ein Snapshot hält den Zustand der Speicherallokationen fest und zeigt detailliert, wo Speicher belegt wird.
So erstellst du einen Snapshot mit tracemalloc:
import tracemalloc

# Start tracing memory allocations
tracemalloc.start()

# Code block for which memory usage is to be tracked
def allocate_memory():
    a = [i for i in range(10000)]  # List of numbers from 0 to 9999
    b = [i**2 for i in range(10000)]  # List of squares of numbers from 0 to 9999
    return a, b

# Keep the allocated lists in scope
allocated_lists = allocate_memory()

# Take a snapshot
snapshot = tracemalloc.take_snapshot()

# Stop tracing memory allocations
tracemalloc.stop()

# Analyze the snapshot to see memory usage
top_stats = snapshot.statistics('lineno')

# Write the memory usage data to a text file
with open('memory_usage.txt', 'w') as f:
    f.write("[ Top 10 memory consumers ]\n")
    for stat in top_stats[:10]:
        f.write(f"{stat}\n")
    # Detailed traceback for the top memory consumer
    f.write("\n[ Detailed traceback for the top memory consumer ]\n")
    for stat in top_stats[:1]:
        f.write('\n'.join(stat.traceback.format()) + '\n')

print("Memory usage details saved to 'memory_usage.txt'")
Ich habe mit tracemalloc die Speichernutzung meiner Python-Anwendung verfolgt und untersucht. Durch einen Snapshot der Allokationen und die Analyse der größten Speicherfresser ließ sich schnell erkennen, welche Codestellen am meisten Speicher beanspruchen. Die Ergebnisse habe ich zur weiteren Auswertung in eine Textdatei geschrieben.
Eine der stärksten Funktionen von tracemalloc ist der Vergleich von Snapshots an unterschiedlichen Zeitpunkten, um Memory-Leaks aufzuspüren. Über die Differenzen zwischen Snapshots siehst du, wo zusätzlicher Speicher belegt und nicht wieder freigegeben wird.
So vergleichst du Snapshots:
import tracemalloc

# Start tracing memory allocations
tracemalloc.start()

# Function to allocate memory
def allocate_memory():
    a = [i for i in range(10000)]  # List of numbers from 0 to 9999
    b = [i**2 for i in range(10000)]  # List of squares of numbers from 0 to 9999
    return a, b

# Initial memory usage snapshot
snapshot1 = tracemalloc.take_snapshot()

# Perform memory allocations
allocated_lists = allocate_memory()

# Memory usage snapshot after allocations
snapshot2 = tracemalloc.take_snapshot()

# Further memory allocations (simulate more work to find potential leaks)
allocated_lists += allocate_memory()

# Memory usage snapshot after additional allocations
snapshot3 = tracemalloc.take_snapshot()

# Stop tracing memory allocations
tracemalloc.stop()

# Compare the snapshots
stats1_vs_2 = snapshot2.compare_to(snapshot1, 'lineno')
stats2_vs_3 = snapshot3.compare_to(snapshot2, 'lineno')

# Save the comparison results to a text file
with open('memory_leak_analysis.txt', 'w') as f:
    f.write("[ Memory usage increase from snapshot 1 to snapshot 2 ]\n")
    for stat in stats1_vs_2[:10]:
        f.write(f"{stat}\n")

    f.write("\n[ Memory usage increase from snapshot 2 to snapshot 3 ]\n")
    for stat in stats2_vs_3[:10]:
        f.write(f"{stat}\n")

    # Detailed traceback for the top memory consumers
    f.write("\n[ Detailed traceback for the top memory consumers ]\n")
    for stat in stats2_vs_3[:1]:
        f.write('\n'.join(stat.traceback.format()) + '\n')

print("Memory leak analysis saved to 'memory_leak_analysis.txt'")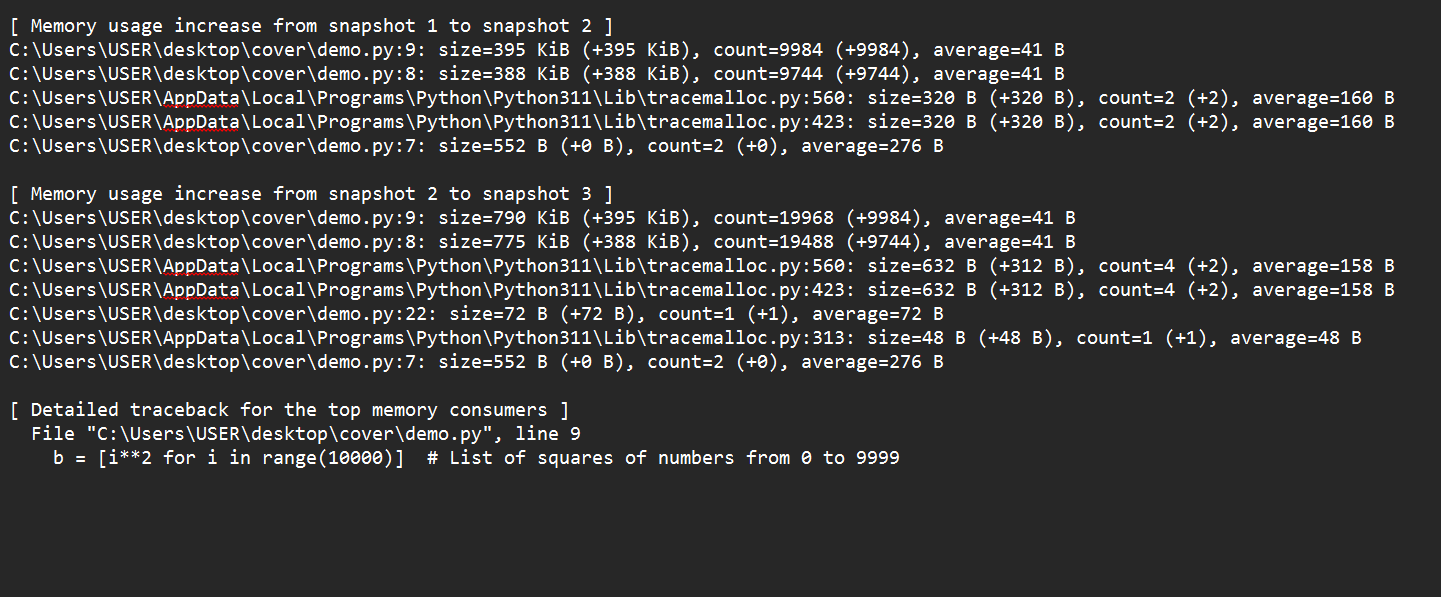
Beim Übergang von Snapshot 1 zu Snapshot 2 war die Erstellung der Listen a und b der Hauptgrund für den Anstieg der Speichernutzung. Vom Snapshot 2 zu Snapshot 3 siehst du, dass weitere Allokationen der Listen a und b den Verbrauch weiter erhöhen.
Durch den Vergleich der Snapshots erkennst du: Wiederholte Allokation großer Listen ist der Haupttreiber für den steigenden Speicherbedarf. Sind diese Allokationen in der Praxis nicht nötig, kann das auf ein Memory-Leak hindeuten. Eine detaillierte Traceback-Analyse zeigt die exakten Codezeilen.
tracemalloc stellt auch Werkzeuge bereit, um die größten Speicherverbraucher deiner Anwendung zu identifizieren. So kannst du deine Optimierungsarbeit gezielt dort ansetzen, wo sie am meisten bringt.
So analysierst du die Top-Verbraucher:
import tracemalloc

# Start tracing memory allocations
tracemalloc.start()

# Code block for which memory usage is to be tracked
def allocate_memory():
    a = [i for i in range(10000)]
    b = [i**2 for i in range(10000)]

allocate_memory()

# Take a snapshot
snapshot = tracemalloc.take_snapshot()

# Analyze top memory consumers
top_stats = snapshot.statistics('lineno')
print("[ Top 10 memory consumers ]")
for stat in top_stats[:10]:
    print(stat)

# Stop tracing memory allocations
tracemalloc.stop()
In diesem Beispiel erzeuge ich nach einem Snapshot die Statistik per snapshot.statistics('lineno'), gruppiert nach Zeilennummern. Damit findest du schnell die Codestellen mit dem höchsten Speicherbedarf und kannst gezielt optimieren.
Objgraph ist eine Python-Bibliothek zur Visualisierung und Analyse von Objekt-Referenzen im Speicher. Sie erstellt Diagramme, die zeigen, wie Objekte einander referenzieren. Diese Visualisierung hilft, die Struktur deiner Anwendung zu verstehen, Memory-Leaks aufzuspüren und den Speicherverbrauch zu optimieren.
Installiere zunächst die Bibliothek objgraph mit pip:
pip install objgraphobjgraphobjgraph bietet zentrale Funktionen fürs Memory-Profiling und die Visualisierung:
objgraph erstellst du visuelle Darstellungen von Objekten und ihren Referenzen. So verstehst du die Vernetzung und kannst Debugging und Optimierung vereinfachen.Schauen wir uns Beispiele an, wie du objgraph in der Praxis nutzt.
Beispiel 1: Objekt-Referenzgraph erzeugen
Angenommen, wir haben eine einfache Klasse und erzeugen Instanzen:
class Node:
    def __init__(self, value):
        self.value = value
        self.children = []

# Create some nodes
node1 = Node(1)
node2 = Node(2)
node3 = Node(3)

# Establish relationships
node1.children.append(node2)
node2.children.append(node3)

import Objgraph

# Generate a graph of object references
objgraph.show_refs([node1], filename='object_refs.png')
In diesem Beispiel definieren wir eine Klasse Node und erzeugen verknüpfte Instanzen. Die Funktion objgraph.show_refs() generiert einen Referenzgraphen ausgehend von node1 und speichert ihn als object_refs.png. So siehst du auf einen Blick, wie die Knoten zusammenhängen.
Beispiel 2: Zirkuläre Referenzen erkennen
Zum Aufspüren zirkulärer Referenzen nutzen wir objgraph.find_backref_chain():
# Create a circular reference
node 3.children.append(node1)

# Detect circular references
chain = objgraph.find_backref_chain(node1, objgraph.is_proper_module)
objgraph.show_chain(chain, filename='circular_refs.png')
Hier erzeugen wir eine zirkuläre Referenz, indem wir node1 zu den Kindern von node3 hinzufügen. objgraph.find_backref_chain() erkennt die Kette, und objgraph.show_chain visualisiert sie als circular_refs.png.
Beispiel 3: Objekttypen und -größen analysieren
Für eine Analyse der Typen und Größen verwenden wir objgraph.show_most_common_types und objgraph.by_type:
# Show the most common object types
objgraph.show_most_common_types()

# Get the details of a specific object type
objs = objgraph.by_type('Node')
objgraph.show_refs(objs[:3], refcounts=True, filename='node_details.png')
In diesem Beispiel zeigt objgraph.show_most_common_types die derzeit häufigsten Objekttypen im Speicher. Mit objgraph.by_type() holst du alle Instanzen der Klasse Node und visualisierst ihre Referenzen inklusive Referenzzählung als node_details.png.
Als Nächstes schauen wir uns Techniken an, mit denen du Memory-Profiling-Tools effektiv einsetzt. Wir konzentrieren uns auf das Profilieren einzelner Funktionen, das Verfolgen der gesamten Speichernutzung und das Visualisieren von Objektgraphen.
Profile gezielt bestimmte Funktionen mit memory_profiler oder tracemalloc.
memory_profilermemory_profiler ermöglicht eine unkomplizierte, zeilenweise Überwachung der Speichernutzung innerhalb deiner Funktionen – ideal, um Einsparpotenziale zu finden.
from memory_profiler import profile

@profile

def allocate_memory():
    a = [i for i in range(10000)]
    b = [i ** 2 for i in range(10000)]
    return a, b

if __name__ == "__main__":
allocate_memory()tracemallocimport tracemalloc
tracemalloc.start()
def allocate_memory():
a = [i for i in range(10000)]
b = [i ** 2 for i in range(10000)]
return a, b
allocate_memory()
snapshot = tracemalloc.take_snapshot()
top_stats = snapshot.statistics('lineno')
for stat in top_stats[:10]:
print(stat)Um die gesamte Speichernutzung unseres Programms im Zeitverlauf zu beobachten, können wir das eingebaute Modul tracemalloc verwenden. So trackst du die Speichernutzung und interpretierst Trends.
Schritte mit tracemalloc
Wir beginnen damit, das Tracing zu starten.
import tracemalloc

tracemalloc.start()
Anschließend führen wir die zu beobachtenden Codeabschnitte aus.
def run_heavy_computation():
   a = [i for i in range(10000)]
   b = [i**2 for i in range(10000)]
   return a, b

run_heavy_computation()
Dann nehmen wir Snapshots der Speichernutzung zu verschiedenen Zeitpunkten.
snapshot1 = tracemalloc.take_snapshot()

run_heavy_computation()

snapshot2 = tracemalloc.take_snapshot()
Zum Schluss vergleichen wir die Snapshots, um Muster zu erkennen und Leaks aufzuspüren.
stats = snapshot2.compare_to(snapshot1, 'lineno')

for stat in stats[:10]:
   print(stat)
Beispiel
import tracemalloc

# Start tracing memory allocations
tracemalloc.start()

# Function to run heavy computation
def run_heavy_computation():
    a = [i for i in range(10000)]
    b = [i**2 for i in range(10000)]
    return a, b

# Initial memory usage snapshot
snapshot1 = tracemalloc.take_snapshot()

# Perform memory allocations
run_heavy_computation()

# Memory usage snapshot after allocations
snapshot2 = tracemalloc.take_snapshot()

# Compare the snapshots
stats = snapshot2.compare_to(snapshot1, 'lineno')

# Print the top memory-consuming lines of code
print("[ Top 10 memory consumers ]")
for stat in stats[:10]:
    print(stat)

# Stop tracing memory allocations
tracemalloc.stop()So holst du mehr aus deinen Profiling-Daten heraus:
Mit der Bibliothek objgraph kannst du Objektbeziehungen visualisieren. Das hilft, die Speichernutzung zu analysieren, Leaks aufzudecken und Objektlebenszyklen zu verstehen.
Hier ist der Ablauf Schritt für Schritt: Zuerst erzeugen wir einen Objekt-Referenzgraphen, dann spüren wir zirkuläre Referenzen auf und anschließend analysieren wir die Graphen.
import objgraph

class Node:
   def __init__(self, value):
       self.value = value
       self.children = []

# Create some nodes and establish relationships
node1 = Node(1)
node2 = Node(2)
node3 = Node(3)
node1.children.append(node2)
node2.children.append(node3)

# Generate a graph of object references
objgraph.show_refs([node1], filename='object_refs.png')# Create a circular reference
node3.children.append(node1)
# Detect circular references
chain = objgraph.find_backref_chain(node1, objgraph.is_proper_module)
objgraph.show_chain(chain, filename='circular_refs.png')# Show the most common object types
objgraph.show_most_common_types()
# Get details of a specific object type
nodes = objgraph.by_type('Node')
objgraph.show_refs(nodes[:3], refcounts=True, filename='node_details.png')Beispiel
import objgraph
class Node:
def __init__(self, value):
self.value = value
self.children = []
# Create some nodes and establish relationships
node1 = Node(1)
node2 = Node(2)
node3 = Node(3)
node1.children.append(node2)
node2.children.append(node3)
# Generate a graph of object references
objgraph.show_refs([node1], filename='object_refs.png')
# Create a circular reference
node3.children.append(node1)

# Detect circular references
chain = objgraph.find_backref_chain(node1, objgraph.is_proper_module)

objgraph.show_chain(chain, filename='circular_refs.png')
# Show the most common object types
objgraph.show_most_common_types()

# Get details of a specific object type
nodes = objgraph.by_type('Node')

objgraph.show_refs(nodes[:3], refcounts=True, filename='node_details.png')Zum Abschluss werten wir die Graphen aus. Gehe dabei so vor:
Diese Tipps helfen dir, beim Profiling mehr herauszuholen:
In diesem Tutorial hast du zentrale Tools und Techniken kennengelernt, um die Speichernutzung deiner Python-Anwendungen zu verstehen und zu optimieren. Dazu gehören memory_profiler für die unkomplizierte, zeilenweise Überwachung innerhalb einer Funktion und objgraph für aussagekräftige Visualisierungen von Objektbeziehungen, das Erkennen zirkulärer Referenzen und das Verständnis deiner Speicherstrukturen.
Wenn du Memory-Profiling in deinen Entwicklungs-Workflow integrierst, gewinnst du wertvolle Einblicke in das Speichermanagement deines Codes, triffst fundierte Optimierungsentscheidungen und hebst die Performance und Zuverlässigkeit deiner Anwendungen auf ein neues Level. Ob kleines Skript oder großes System – Memory-Profiling gehört ins Repertoire jeder Python-Entwicklerin und jedes Python-Entwicklers, die bzw. der effizienten und robusten Code schreiben will.
Wenn du dein Verständnis und deine Fähigkeiten im Memory-Profiling und beim Schreiben effizienten Codes vertiefen möchtest, schau dir den Kurs Writing Efficient Code in Python an. Außerdem bietet unser Python Programming-Kurs einen umfassenden Überblick über Best Practices und fortgeschrittene Techniken, mit denen du zum Profi wirst.
Lerne Python mit DataCamp
Kurs
Kurs
Kurs