Khóa học
Giới thiệu về Functions trong Python
3 giờ
472.5K
Các ứng dụng Python, đặc biệt là những ứng dụng xử lý bộ dữ liệu lớn hoặc tính toán phức tạp, có thể tiêu thụ quá nhiều bộ nhớ, dẫn đến chậm, treo hoặc lỗi hết bộ nhớ. Phân tích bộ nhớ (memory profiling) là kỹ thuật cho phép bạn phân tích mức sử dụng bộ nhớ của mã Python, xác định rò rỉ bộ nhớ và nút thắt cổ chai, đồng thời tối ưu hóa mức tiêu thụ bộ nhớ để cải thiện hiệu năng và độ ổn định.
Trong hướng dẫn này, chúng ta sẽ khám phá khái niệm phân tích bộ nhớ, các công cụ sẵn có và những ví dụ thực tiễn về cách dùng các công cụ này để phân tích mã Python của bạn.
Phân tích bộ nhớ là kỹ thuật theo dõi và đánh giá mức sử dụng bộ nhớ của chương trình khi chạy. Phương pháp này giúp nhà phát triển tìm rò rỉ bộ nhớ, tối ưu hóa việc sử dụng bộ nhớ và hiểu các mẫu tiêu thụ bộ nhớ của chương trình. Phân tích bộ nhớ rất quan trọng để ngăn ứng dụng dùng nhiều bộ nhớ hơn mức cần thiết, gây hiệu năng ì ạch hoặc bị treo.
Phân tích bộ nhớ mang lại một số lợi thế quan trọng, thiết yếu để duy trì các ứng dụng hiệu quả và vững chắc:
Hãy cùng khám phá một số công cụ phân tích bộ nhớ phổ biến, chi tiết về tính năng, cách cài đặt và sử dụng. Cụ thể, chúng ta sẽ xem các công cụ như memory_profiler để phân tích bộ nhớ theo từng dòng, tracemalloc để chụp và so sánh ảnh chụp bộ nhớ, và objgraph để trực quan hóa mối quan hệ giữa các đối tượng.
memory_profiler là một công cụ mạnh mẽ trong Python cung cấp cái nhìn chi tiết về mức sử dụng bộ nhớ của mã bạn. Nó hoạt động bằng cách cung cấp phân tách theo từng dòng rất chi tiết về mức sử dụng bộ nhớ, hữu ích để xác định chính xác những dòng mã gây tiêu thụ bộ nhớ cao. Bằng cách hiểu mức sử dụng bộ nhớ ở mức chi tiết này, nhà phát triển có thể đưa ra quyết định sáng suốt về nơi nên tập trung nỗ lực tối ưu hóa.
Để cài đặt memory_profiler và các gói bổ sung cần thiết, hãy làm theo các bước sau:
Lệnh sau sẽ cài đặt gói memory_profiler:
pip install memory_profilerNếu bạn muốn trực quan hóa mức sử dụng bộ nhớ bằng biểu đồ, có thể cài matplotlib bằng cách chạy:
pip install matplotlibĐể sử dụng memory_profiler, hãy làm theo các bước sau:
Trang trí (decorate) các hàm bạn muốn phân tích.
Mở script Python của bạn trong trình soạn thảo văn bản hoặc IDE.
Import decorator profile từ memory_profiler và áp dụng nó cho các hàm bạn muốn phân tích.
Ví dụ script:
from memory_profiler import profile
@profile

def allocate_memory():
    # Allocate a list with a range of numbers
    a = [i for i in range(10000)]
    # Allocate another list with squares of numbers
    b = [i ** 2 for i in range(10000)]
    return a, b

if __name__ == "__main__":
allocate_memory()Tôi import decorator profile từ gói memory_profiler. Decorator này sẽ giúp chúng ta theo dõi mức sử dụng bộ nhớ của hàm được trang trí.
from memory_profiler import profileTôi áp dụng decorator @profile cho hàm allocate_memory(). Điều này có nghĩa là khi allocate_memory() được thực thi, memory_profiler sẽ theo dõi mức sử dụng bộ nhớ và cung cấp báo cáo chi tiết.
@profileBên trong hàm allocate_memory(), tôi tạo hai danh sách. Danh sách đầu chứa các số từ 0 đến 9999; danh sách thứ hai chứa bình phương của các số từ 0 đến 9999.
a = [i for i in range(10000)]  # List of numbers from 0 to 9999

b = [i**2 for i in range(10000)]  # List of squares of numbers from 0 to 9999
Khối mã sau đảm bảo hàm allocate_memory() chỉ được gọi khi script chạy trực tiếp, không phải khi được import như một module. Khi bạn chạy script này, memory_profiler sẽ xuất mức sử dụng bộ nhớ của hàm allocate_memory(), cho phép bạn thấy lượng bộ nhớ dùng trong quá trình tạo hai danh sách a và b.
if __name__ == "__main__":

   allocate_memory()
Trong terminal hoặc command prompt, chuyển đến thư mục chứa script của bạn. Chạy script với tùy chọn -m memory_profiler.
-m memory_profiler your_script.py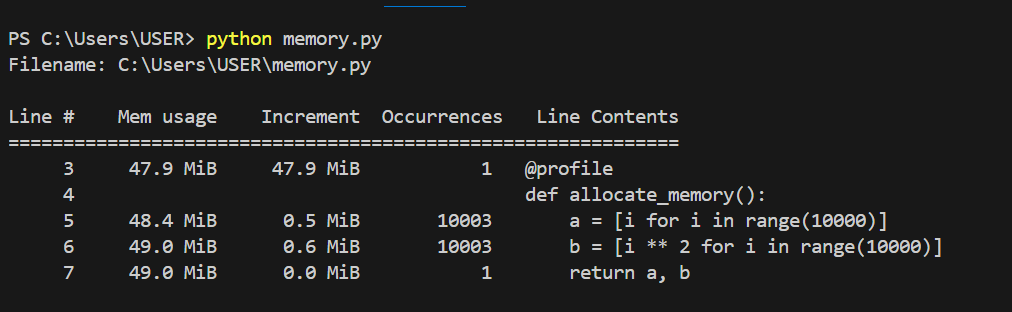
Mức sử dụng bộ nhớ cho từng dòng mã. Ảnh: Tác giả.
Trong đồ thị trên, ta có thể thấy mức sử dụng bộ nhớ của mỗi dòng mã và mức tăng cho từng dòng. Biểu đồ bên dưới cho thấy chi tiết hơn cách từng dòng dùng bộ nhớ và mức tăng theo từng vòng lặp.
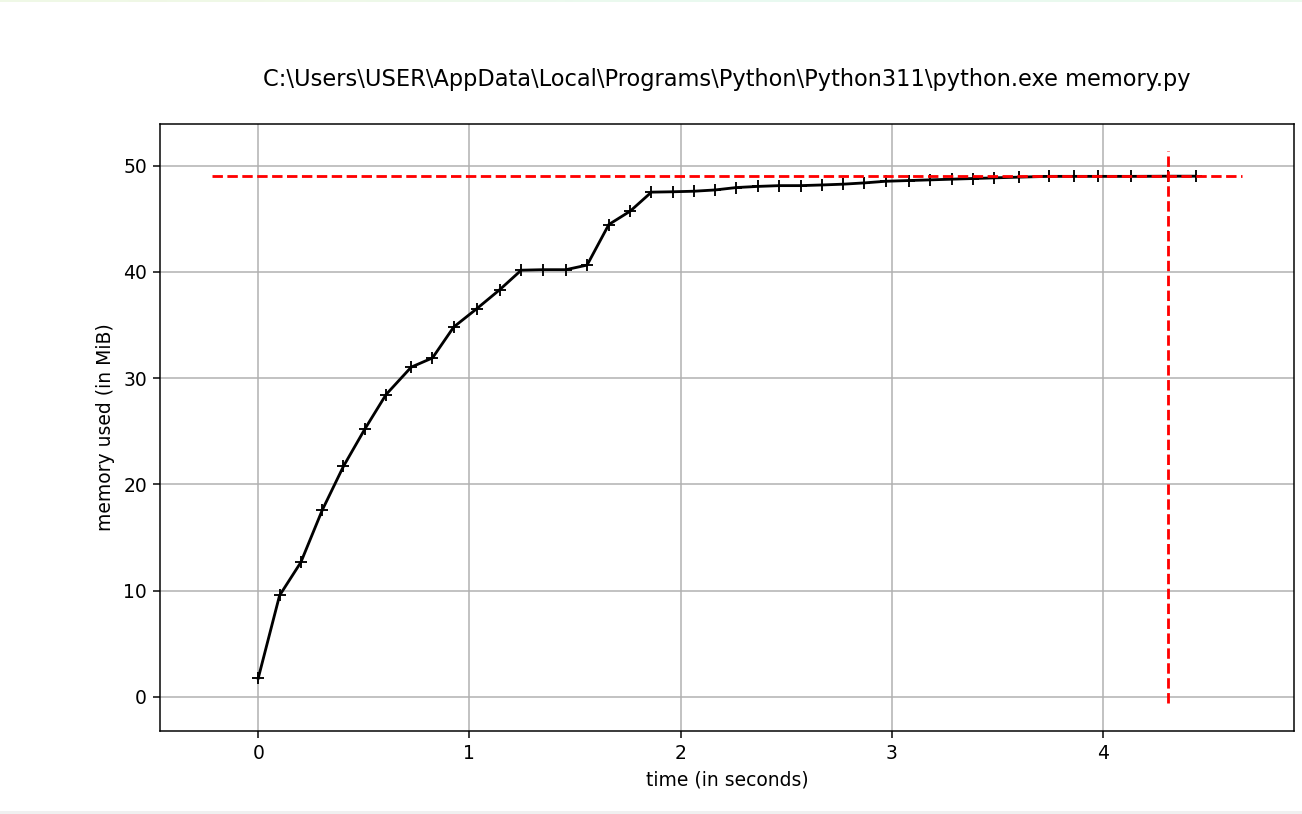
Mức sử dụng bộ nhớ theo thời gian. Ảnh: Tác giả.
tracemalloc là một module dựng sẵn mạnh mẽ trong Python để theo dõi cấp phát và giải phóng bộ nhớ. Hiểu cách ứng dụng của bạn dùng bộ nhớ là điều cốt yếu để tối ưu hiệu năng và phát hiện rò rỉ bộ nhớ. Tracemalloc cung cấp giao diện dễ dùng để chụp và phân tích ảnh chụp mức sử dụng bộ nhớ, trở thành công cụ vô giá cho mọi lập trình viên Python.
Hãy xem cách tracemalloc chụp ảnh mức sử dụng bộ nhớ, so sánh các ảnh chụp để xác định rò rỉ bộ nhớ, rồi phân tích các mục tiêu thụ bộ nhớ hàng đầu
tracemalloc cho phép bạn chụp ảnh mức sử dụng bộ nhớ tại các thời điểm cụ thể trong chương trình. Một ảnh chụp ghi lại trạng thái cấp phát bộ nhớ, cung cấp cái nhìn chi tiết về nơi bộ nhớ được sử dụng.
Cách chụp ảnh với tracemalloc:
import tracemalloc

# Start tracing memory allocations
tracemalloc.start()

# Code block for which memory usage is to be tracked
def allocate_memory():
    a = [i for i in range(10000)]  # List of numbers from 0 to 9999
    b = [i**2 for i in range(10000)]  # List of squares of numbers from 0 to 9999
    return a, b

# Keep the allocated lists in scope
allocated_lists = allocate_memory()

# Take a snapshot
snapshot = tracemalloc.take_snapshot()

# Stop tracing memory allocations
tracemalloc.stop()

# Analyze the snapshot to see memory usage
top_stats = snapshot.statistics('lineno')

# Write the memory usage data to a text file
with open('memory_usage.txt', 'w') as f:
    f.write("[ Top 10 memory consumers ]\n")
    for stat in top_stats[:10]:
        f.write(f"{stat}\n")
    # Detailed traceback for the top memory consumer
    f.write("\n[ Detailed traceback for the top memory consumer ]\n")
    for stat in top_stats[:1]:
        f.write('\n'.join(stat.traceback.format()) + '\n')

print("Memory usage details saved to 'memory_usage.txt'")
Tôi đã theo dõi và kiểm tra việc sử dụng bộ nhớ trong ứng dụng Python của mình bằng module tracemalloc. Bằng cách chụp ảnh cấp phát bộ nhớ và xem các mục tiêu thụ bộ nhớ hàng đầu, tôi xác định được các phần trong mã dùng nhiều bộ nhớ nhất. Sau đó, tôi ghi phân tích này vào một tệp văn bản để đọc và tham khảo thêm.
Một trong những tính năng mạnh nhất của tracemalloc là khả năng so sánh ảnh chụp tại các thời điểm khác nhau trong chương trình để phát hiện rò rỉ bộ nhớ. Bằng cách phân tích khác biệt giữa các ảnh chụp, bạn có thể xác định chính xác nơi bộ nhớ được cấp phát thêm nhưng không được giải phóng.
Cách so sánh ảnh chụp:
import tracemalloc

# Start tracing memory allocations
tracemalloc.start()

# Function to allocate memory
def allocate_memory():
    a = [i for i in range(10000)]  # List of numbers from 0 to 9999
    b = [i**2 for i in range(10000)]  # List of squares of numbers from 0 to 9999
    return a, b

# Initial memory usage snapshot
snapshot1 = tracemalloc.take_snapshot()

# Perform memory allocations
allocated_lists = allocate_memory()

# Memory usage snapshot after allocations
snapshot2 = tracemalloc.take_snapshot()

# Further memory allocations (simulate more work to find potential leaks)
allocated_lists += allocate_memory()

# Memory usage snapshot after additional allocations
snapshot3 = tracemalloc.take_snapshot()

# Stop tracing memory allocations
tracemalloc.stop()

# Compare the snapshots
stats1_vs_2 = snapshot2.compare_to(snapshot1, 'lineno')
stats2_vs_3 = snapshot3.compare_to(snapshot2, 'lineno')

# Save the comparison results to a text file
with open('memory_leak_analysis.txt', 'w') as f:
    f.write("[ Memory usage increase from snapshot 1 to snapshot 2 ]\n")
    for stat in stats1_vs_2[:10]:
        f.write(f"{stat}\n")

    f.write("\n[ Memory usage increase from snapshot 2 to snapshot 3 ]\n")
    for stat in stats2_vs_3[:10]:
        f.write(f"{stat}\n")

    # Detailed traceback for the top memory consumers
    f.write("\n[ Detailed traceback for the top memory consumers ]\n")
    for stat in stats2_vs_3[:1]:
        f.write('\n'.join(stat.traceback.format()) + '\n')

print("Memory leak analysis saved to 'memory_leak_analysis.txt'")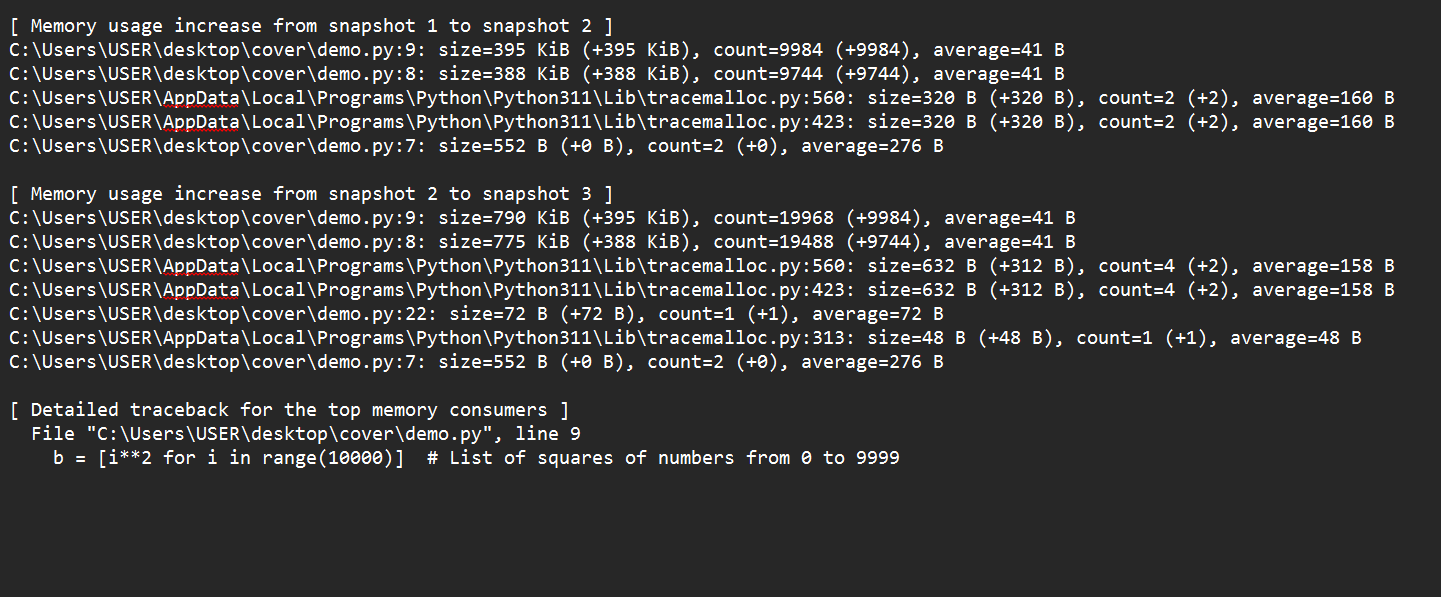
Khi chuyển từ ảnh chụp 1 sang ảnh chụp 2, ta thấy việc tạo các danh sách a và b là nguyên nhân chính khiến mức sử dụng bộ nhớ tăng vọt. Khi chuyển từ ảnh chụp 2 sang ảnh chụp 3, ta cũng thấy việc cấp phát thêm các danh sách a và b tiếp tục làm tăng mức sử dụng bộ nhớ.
Bằng cách so sánh các ảnh chụp này, chúng ta phát hiện nguyên nhân hàng đầu của việc tăng sử dụng bộ nhớ là cấp phát lặp đi lặp lại các danh sách lớn. Trong ứng dụng thực tế, nếu các cấp phát này không cần thiết, chúng có thể cho thấy một rò rỉ bộ nhớ. Traceback chi tiết có thể xác định chính xác các dòng mã gây ra các cấp phát này.
tracemalloc cũng cung cấp các công cụ để phân tích những phần tiêu thụ bộ nhớ nhiều nhất của ứng dụng. Điều này giúp bạn tập trung tối ưu các phần mã dùng nhiều bộ nhớ nhất.
Cách phân tích các mục tiêu thụ bộ nhớ hàng đầu:
import tracemalloc

# Start tracing memory allocations
tracemalloc.start()

# Code block for which memory usage is to be tracked
def allocate_memory():
    a = [i for i in range(10000)]
    b = [i**2 for i in range(10000)]

allocate_memory()

# Take a snapshot
snapshot = tracemalloc.take_snapshot()

# Analyze top memory consumers
top_stats = snapshot.statistics('lineno')
print("[ Top 10 memory consumers ]")
for stat in top_stats[:10]:
    print(stat)

# Stop tracing memory allocations
tracemalloc.stop()
Trong ví dụ này, sau khi chụp ảnh, tôi dùng snapshot. Statistics ('lineno') để lấy thống kê về mức sử dụng bộ nhớ được nhóm theo số dòng. Kết quả này giúp bạn nhanh chóng xác định phần nào trong mã tiêu thụ nhiều bộ nhớ nhất, từ đó tập trung tối ưu các khu vực đó.
Objgraph là một thư viện Python giúp nhà phát triển trực quan hóa và phân tích các tham chiếu đối tượng trong mã. Nó cung cấp các công cụ để tạo các đồ thị trực quan thể hiện cách các đối tượng trong bộ nhớ tham chiếu lẫn nhau. Việc trực quan hóa này hữu ích để hiểu cấu trúc và mối quan hệ trong chương trình, xác định rò rỉ bộ nhớ và tối ưu hóa việc sử dụng bộ nhớ.
Trước tiên, hãy cài đặt thư viện objgraph. Bạn có thể cài bằng pip:
pip install objgraphobjgraphobjgraph cung cấp một số tính năng quan trọng cho việc phân tích và trực quan hóa bộ nhớ:
objgraph, bạn có thể tạo biểu diễn trực quan của các đối tượng và tham chiếu của chúng. Điều này giúp bạn hiểu cách các đối tượng liên kết với nhau, giúp việc gỡ lỗi và tối ưu hóa mã trở nên dễ dàng hơn.Hãy đi vào một số ví dụ để xem objgraph được sử dụng trong thực tế như thế nào.
Ví dụ 1: Tạo đồ thị tham chiếu đối tượng
Giả sử chúng ta có một lớp đơn giản và tạo một vài thể hiện:
class Node:
    def __init__(self, value):
        self.value = value
        self.children = []

# Create some nodes
node1 = Node(1)
node2 = Node(2)
node3 = Node(3)

# Establish relationships
node1.children.append(node2)
node2.children.append(node3)

import Objgraph

# Generate a graph of object references
objgraph.show_refs([node1], filename='object_refs.png')
Trong ví dụ này, chúng ta định nghĩa lớp Node và tạo các thể hiện node với mối quan hệ. Hàm objgraph.show_refs() tạo một đồ thị trực quan về các tham chiếu đối tượng bắt đầu từ node1 và lưu thành object_refs.png. Đồ thị này giúp chúng ta hiểu cách các node liên kết với nhau.
Ví dụ 2: Phát hiện tham chiếu vòng
Để phát hiện tham chiếu vòng, ta có thể dùng hàm objgraph.find_backref_chain():
# Create a circular reference
node 3.children.append(node1)

# Detect circular references
chain = objgraph.find_backref_chain(node1, objgraph.is_proper_module)
objgraph.show_chain(chain, filename='circular_refs.png')
Ở đây, chúng ta tạo một tham chiếu vòng bằng cách thêm node1 vào danh sách children của node3. Hàm objgraph.find_backref_chain() phát hiện tham chiếu vòng này, và objgraph.show_chain trực quan hóa nó, lưu kết quả thành circular_refs.png.
Ví dụ 3: Phân tích kiểu và kích thước đối tượng
Để phân tích các kiểu và kích thước đối tượng, chúng ta có thể dùng objgraph.show_most_common_types và objgraph.by_type:
# Show the most common object types
objgraph.show_most_common_types()

# Get the details of a specific object type
objs = objgraph.by_type('Node')
objgraph.show_refs(objs[:3], refcounts=True, filename='node_details.png')
Trong ví dụ này, objgraph.show_most_common_types hiển thị các kiểu đối tượng phổ biến nhất hiện đang có trong bộ nhớ. Hàm objgraph.by_type() truy xuất tất cả các thể hiện của lớp Node, và chúng ta trực quan hóa các tham chiếu của chúng, bao gồm cả số lượng tham chiếu, bằng cách tạo một đồ thị khác được lưu thành node_details.png.
Giờ hãy xem một số kỹ thuật để sử dụng hiệu quả các công cụ phân tích bộ nhớ. Chúng ta sẽ tập trung vào phân tích các hàm cụ thể, theo dõi mức sử dụng bộ nhớ tổng thể và trực quan hóa đồ thị đối tượng.
Nhắm mục tiêu các hàm cụ thể với memory_profiler hoặc tracemalloc.
memory_profilermemory_profiler cung cấp cách trực tiếp để theo dõi mức tiêu thụ bộ nhớ theo từng dòng trong các hàm của bạn, giúp bạn xác định khu vực có thể giảm sử dụng bộ nhớ.
from memory_profiler import profile

@profile

def allocate_memory():
    a = [i for i in range(10000)]
    b = [i ** 2 for i in range(10000)]
    return a, b

if __name__ == "__main__":
allocate_memory()tracemallocimport tracemalloc
tracemalloc.start()
def allocate_memory():
a = [i for i in range(10000)]
b = [i ** 2 for i in range(10000)]
return a, b
allocate_memory()
snapshot = tracemalloc.take_snapshot()
top_stats = snapshot.statistics('lineno')
for stat in top_stats[:10]:
print(stat)Để theo dõi tổng mức sử dụng bộ nhớ của chương trình theo thời gian, chúng ta có thể dùng module dựng sẵn tracemalloc. Dưới đây là cách theo dõi mức sử dụng bộ nhớ tổng thể và diễn giải kết quả để nhận diện xu hướng.
Các bước dùng tracemalloc
Chúng ta bắt đầu bằng cách khởi tạo việc theo dõi bộ nhớ ở đầu script.
import tracemalloc

tracemalloc.start()
Sau đó chúng ta thực thi các phần mã muốn theo dõi.
def run_heavy_computation():
   a = [i for i in range(10000)]
   b = [i**2 for i in range(10000)]
   return a, b

run_heavy_computation()
Tiếp theo, chúng ta chụp ảnh mức sử dụng bộ nhớ. Việc này giúp ghi lại trạng thái cấp phát bộ nhớ tại các thời điểm khác nhau.
snapshot1 = tracemalloc.take_snapshot()

run_heavy_computation()

snapshot2 = tracemalloc.take_snapshot()
Cuối cùng, chúng ta so sánh các ảnh chụp để hiểu mẫu sử dụng bộ nhớ và phát hiện rò rỉ.
stats = snapshot2.compare_to(snapshot1, 'lineno')

for stat in stats[:10]:
   print(stat)
Ví dụ
import tracemalloc

# Start tracing memory allocations
tracemalloc.start()

# Function to run heavy computation
def run_heavy_computation():
    a = [i for i in range(10000)]
    b = [i**2 for i in range(10000)]
    return a, b

# Initial memory usage snapshot
snapshot1 = tracemalloc.take_snapshot()

# Perform memory allocations
run_heavy_computation()

# Memory usage snapshot after allocations
snapshot2 = tracemalloc.take_snapshot()

# Compare the snapshots
stats = snapshot2.compare_to(snapshot1, 'lineno')

# Print the top memory-consuming lines of code
print("[ Top 10 memory consumers ]")
for stat in stats[:10]:
    print(stat)

# Stop tracing memory allocations
tracemalloc.stop()Dưới đây là một số mẹo giúp bạn hiểu dữ liệu phân tích:
Với thư viện objgraph, chúng ta có thể tạo trực quan hóa các mối quan hệ đối tượng. Điều này giúp phân tích việc sử dụng bộ nhớ, phát hiện rò rỉ và hiểu vòng đời đối tượng.
Dưới đây là quy trình từng bước để trực quan hóa đồ thị đối tượng. Trước tiên, chúng ta sẽ tạo đồ thị tham chiếu đối tượng; sau đó phát hiện tham chiếu vòng; cuối cùng là phân tích các đồ thị.
import objgraph

class Node:
   def __init__(self, value):
       self.value = value
       self.children = []

# Create some nodes and establish relationships
node1 = Node(1)
node2 = Node(2)
node3 = Node(3)
node1.children.append(node2)
node2.children.append(node3)

# Generate a graph of object references
objgraph.show_refs([node1], filename='object_refs.png')# Create a circular reference
node3.children.append(node1)
# Detect circular references
chain = objgraph.find_backref_chain(node1, objgraph.is_proper_module)
objgraph.show_chain(chain, filename='circular_refs.png')# Show the most common object types
objgraph.show_most_common_types()
# Get details of a specific object type
nodes = objgraph.by_type('Node')
objgraph.show_refs(nodes[:3], refcounts=True, filename='node_details.png')Ví dụ
import objgraph
class Node:
def __init__(self, value):
self.value = value
self.children = []
# Create some nodes and establish relationships
node1 = Node(1)
node2 = Node(2)
node3 = Node(3)
node1.children.append(node2)
node2.children.append(node3)
# Generate a graph of object references
objgraph.show_refs([node1], filename='object_refs.png')
# Create a circular reference
node3.children.append(node1)

# Detect circular references
chain = objgraph.find_backref_chain(node1, objgraph.is_proper_module)

objgraph.show_chain(chain, filename='circular_refs.png')
# Show the most common object types
objgraph.show_most_common_types()

# Get details of a specific object type
nodes = objgraph.by_type('Node')

objgraph.show_refs(nodes[:3], refcounts=True, filename='node_details.png')Bước cuối cùng, chúng ta phân tích các đồ thị. Hãy thực hiện theo thứ tự sau:
Dưới đây là một số mẹo và thông lệ tốt giúp bạn tối đa hiệu quả của việc phân tích:
Trong hướng dẫn này, chúng ta đã khám phá các công cụ và kỹ thuật thiết yếu để hiểu và tối ưu việc sử dụng bộ nhớ trong ứng dụng Python. Các kỹ thuật này bao gồm memory_profiler cung cấp cách trực tiếp để theo dõi mức tiêu thụ bộ nhớ theo từng dòng trong hàm, và objgraph, cung cấp khả năng trực quan hóa mạnh mẽ, cho phép bạn phân tích mối quan hệ đối tượng, phát hiện tham chiếu vòng và hiểu cấu trúc sử dụng bộ nhớ.
Tích hợp các công cụ phân tích bộ nhớ vào quy trình phát triển giúp bạn có được những hiểu biết quý giá về cách mã quản lý bộ nhớ, hỗ trợ đưa ra quyết định tối ưu hóa sáng suốt và giúp nâng cao hiệu năng, độ tin cậy tổng thể của ứng dụng. Dù bạn làm việc với script nhỏ hay hệ thống quy mô lớn, phân tích bộ nhớ là thực hành thiết yếu cho mọi lập trình viên Python hướng tới việc viết mã hiệu quả và vững chắc.
Để đào sâu hiểu biết và kỹ năng về phân tích bộ nhớ và viết mã hiệu quả, hãy cân nhắc khóa học Writing Efficient Code in Python Course. Ngoài ra, khóa Python Programming của chúng tôi cung cấp cái nhìn tổng quan toàn diện về các thông lệ tốt và kỹ thuật nâng cao để giúp bạn trở thành nhà phát triển thành thạo.
Học Python cùng DataCamp
Khóa học
Khóa học
Khóa học