Cours
Introduction aux fonctions en Python
3 h
470.3K
Les applications Python, en particulier celles qui traitent de grands volumes de données ou des calculs complexes, peuvent consommer beaucoup de mémoire, provoquant des ralentissements, des plantages ou des erreurs de type out-of-memory. Le profilage mémoire est une technique qui permet d’analyser l’utilisation de la mémoire de votre code Python, d’identifier les fuites et goulots d’étranglement, puis d’optimiser la consommation mémoire pour améliorer les performances et la stabilité.
Dans ce tutoriel, nous allons découvrir le profilage mémoire, les outils disponibles et des exemples pratiques pour apprendre à profiler votre code Python.
Le profilage mémoire consiste à surveiller et à évaluer l’utilisation de la mémoire d’un programme pendant son exécution. Cette méthode aide les développeurs à repérer les fuites, à optimiser l’usage de la mémoire et à comprendre les schémas de consommation de leurs programmes. Le profilage mémoire est essentiel pour éviter que les applications n’utilisent plus de mémoire que nécessaire, ce qui peut entraîner des performances médiocres ou des plantages.
Le profilage mémoire offre plusieurs bénéfices clés, indispensables pour maintenir des applications efficaces et robustes :
Explorons plusieurs outils populaires de profilage mémoire, leurs caractéristiques, leur installation et leur utilisation. Nous verrons notamment memory_profiler pour une analyse ligne par ligne, tracemalloc pour capturer et comparer des instantanés mémoire, et objgraph pour visualiser les relations entre objets.
memory_profiler est un outil puissant en Python qui offre une vision détaillée de l’utilisation mémoire de votre code. Il fournit une analyse fine, ligne par ligne, très utile pour identifier les lignes responsables d’une forte consommation. En comprenant l’usage mémoire à ce niveau de granularité, les développeurs peuvent concentrer efficacement leurs efforts d’optimisation.
Pour installer memory_profiler et les éventuels paquets complémentaires, procédez comme suit :
La commande suivante installe le paquet memory_profiler :
pip install memory_profilerSi vous souhaitez visualiser l’usage mémoire sous forme de graphiques, installez matplotlib avec :
pip install matplotlibPour utiliser memory_profiler, suivez ces étapes :
Décorez les fonctions que vous souhaitez profiler.
Ouvrez votre script Python dans un éditeur de texte ou un IDE.
Importez le décorateur profile depuis memory_profiler et appliquez-le aux fonctions à profiler.
Exemple de script :
from memory_profiler import profile
@profile

def allocate_memory():
    # Allocate a list with a range of numbers
    a = [i for i in range(10000)]
    # Allocate another list with squares of numbers
    b = [i ** 2 for i in range(10000)]
    return a, b

if __name__ == "__main__":
allocate_memory()J’importe ici le décorateur profile depuis le paquet memory_profiler. Ce décorateur nous permet de suivre l’utilisation mémoire de la fonction décorée.
from memory_profiler import profileJ’applique le décorateur @profile à la fonction allocate_memory(). Ainsi, lors de son exécution, memory_profiler suivra son usage mémoire et fournira un rapport détaillé.
@profileÀ l’intérieur de allocate_memory(), je crée deux listes. La première contient les nombres de 0 à 9999 ; la seconde contient les carrés des nombres de 0 à 9999.
a = [i for i in range(10000)]  # List of numbers from 0 to 9999

b = [i**2 for i in range(10000)]  # List of squares of numbers from 0 to 9999
Le bloc suivant garantit que la fonction allocate_memory() n’est appelée que lorsque le script est exécuté directement, et non importé comme module. Lorsque vous lancez ce script, memory_profiler affiche l’utilisation mémoire de allocate_memory(), ce qui vous permet de mesurer la mémoire consommée pour créer les deux listes a et b.
if __name__ == "__main__":

   allocate_memory()
Dans votre terminal ou invite de commandes, placez-vous dans le répertoire du script. Exécutez votre script avec l’option -m memory_profiler.
-m memory_profiler your_script.py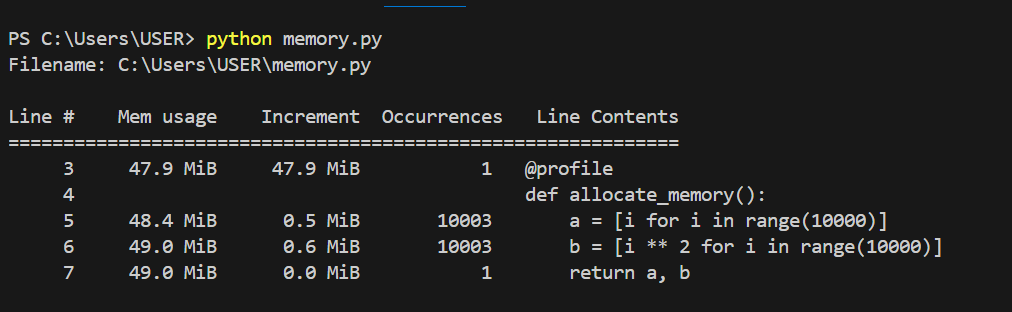
Utilisation mémoire pour chaque ligne de code. Image de l’auteur.
Sur le graphique ci-dessus, on observe l’usage mémoire de chaque ligne de code et les incréments associés. Le graphique suivant montre plus en détail comment chaque ligne consomme de la mémoire et comment cette consommation augmente à chaque itération.
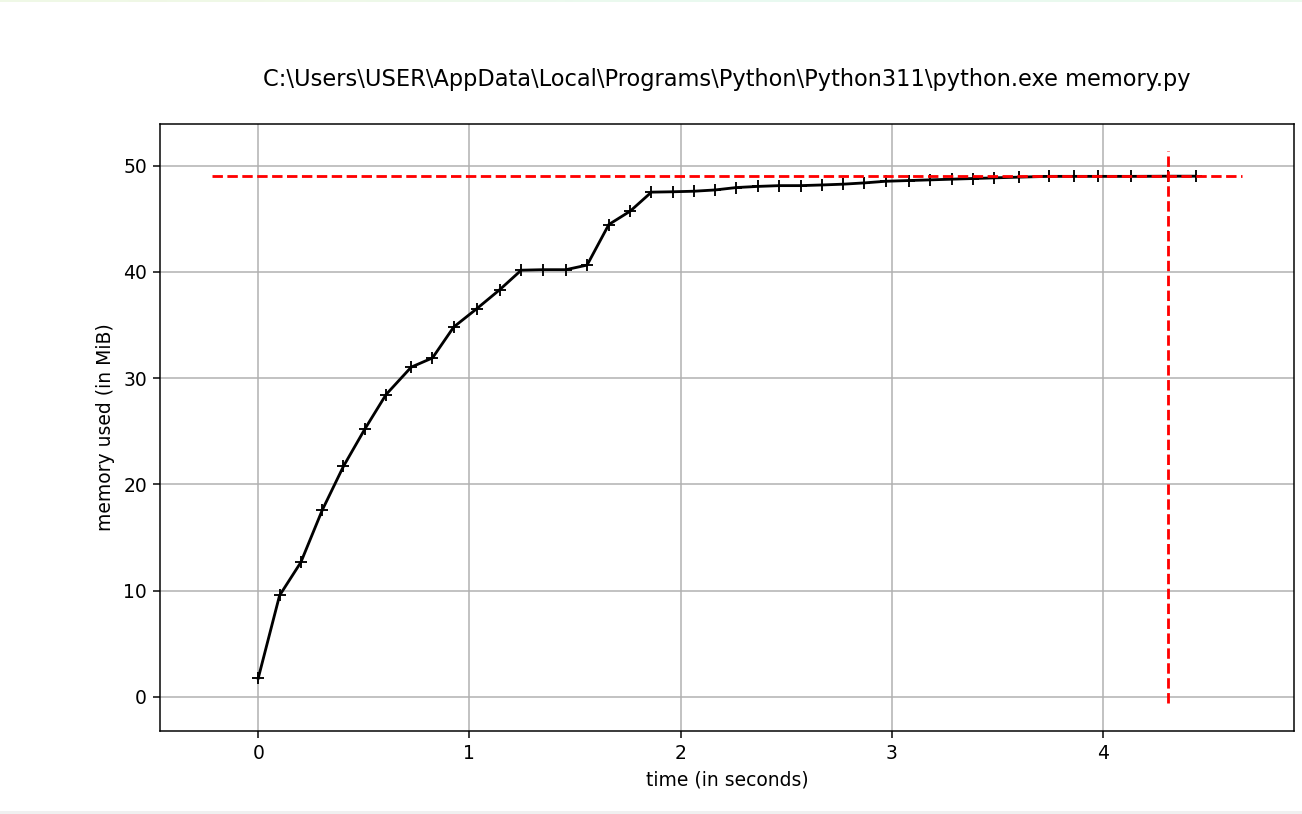
Évolution de l’utilisation mémoire dans le temps. Image de l’auteur.
tracemalloc est un module intégré à Python qui suit les allocations et désallocations mémoire. Comprendre comment votre application utilise la mémoire est crucial pour optimiser les performances et détecter les fuites. Tracemalloc offre une interface simple pour capturer et analyser des instantanés d’usage mémoire, ce qui en fait un outil précieux pour tout développeur Python.
Voyons comment tracemalloc capture des instantanés d’utilisation mémoire, compare ces instantanés pour repérer des fuites, puis analyse les principaux consommateurs de mémoire
tracemalloc vous permet de prendre des instantanés de l’usage mémoire à des moments précis de votre programme. Un instantané capture l’état des allocations, offrant une vue détaillée des zones où la mémoire est utilisée.
Voici comment prendre un instantané avec tracemalloc :
import tracemalloc

# Start tracing memory allocations
tracemalloc.start()

# Code block for which memory usage is to be tracked
def allocate_memory():
    a = [i for i in range(10000)]  # List of numbers from 0 to 9999
    b = [i**2 for i in range(10000)]  # List of squares of numbers from 0 to 9999
    return a, b

# Keep the allocated lists in scope
allocated_lists = allocate_memory()

# Take a snapshot
snapshot = tracemalloc.take_snapshot()

# Stop tracing memory allocations
tracemalloc.stop()

# Analyze the snapshot to see memory usage
top_stats = snapshot.statistics('lineno')

# Write the memory usage data to a text file
with open('memory_usage.txt', 'w') as f:
    f.write("[ Top 10 memory consumers ]\n")
    for stat in top_stats[:10]:
        f.write(f"{stat}\n")
    # Detailed traceback for the top memory consumer
    f.write("\n[ Detailed traceback for the top memory consumer ]\n")
    for stat in top_stats[:1]:
        f.write('\n'.join(stat.traceback.format()) + '\n')

print("Memory usage details saved to 'memory_usage.txt'")
J’ai suivi et examiné l’usage mémoire de mon application Python avec le module tracemalloc. En prenant un instantané des allocations et en identifiant les principaux consommateurs, j’ai déterminé quelles parties de mon code utilisaient le plus de mémoire. J’ai ensuite enregistré cette analyse dans un fichier texte pour consultation ultérieure.
L’une des fonctionnalités les plus puissantes de tracemalloc est la comparaison d’instantanés pris à différents moments du programme afin de détecter des fuites. En analysant les différences, vous pouvez localiser les zones où de la mémoire supplémentaire est allouée mais non libérée.
Voici comment comparer des instantanés :
import tracemalloc

# Start tracing memory allocations
tracemalloc.start()

# Function to allocate memory
def allocate_memory():
    a = [i for i in range(10000)]  # List of numbers from 0 to 9999
    b = [i**2 for i in range(10000)]  # List of squares of numbers from 0 to 9999
    return a, b

# Initial memory usage snapshot
snapshot1 = tracemalloc.take_snapshot()

# Perform memory allocations
allocated_lists = allocate_memory()

# Memory usage snapshot after allocations
snapshot2 = tracemalloc.take_snapshot()

# Further memory allocations (simulate more work to find potential leaks)
allocated_lists += allocate_memory()

# Memory usage snapshot after additional allocations
snapshot3 = tracemalloc.take_snapshot()

# Stop tracing memory allocations
tracemalloc.stop()

# Compare the snapshots
stats1_vs_2 = snapshot2.compare_to(snapshot1, 'lineno')
stats2_vs_3 = snapshot3.compare_to(snapshot2, 'lineno')

# Save the comparison results to a text file
with open('memory_leak_analysis.txt', 'w') as f:
    f.write("[ Memory usage increase from snapshot 1 to snapshot 2 ]\n")
    for stat in stats1_vs_2[:10]:
        f.write(f"{stat}\n")

    f.write("\n[ Memory usage increase from snapshot 2 to snapshot 3 ]\n")
    for stat in stats2_vs_3[:10]:
        f.write(f"{stat}\n")

    # Detailed traceback for the top memory consumers
    f.write("\n[ Detailed traceback for the top memory consumers ]\n")
    for stat in stats2_vs_3[:1]:
        f.write('\n'.join(stat.traceback.format()) + '\n')

print("Memory leak analysis saved to 'memory_leak_analysis.txt'")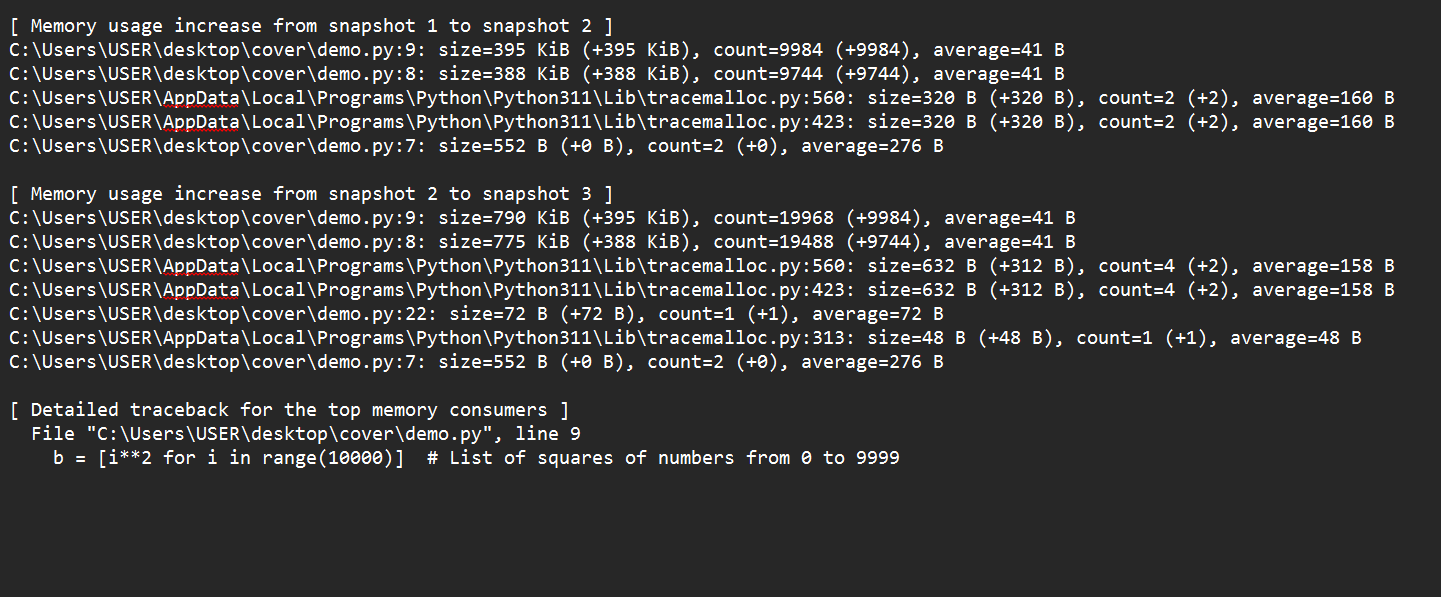
En passant de l’instantané 1 à l’instantané 2, on voit que la création des listes a et b est la principale cause de la hausse de l’usage mémoire. En passant de l’instantané 2 à l’instantané 3, on constate également que des allocations supplémentaires des listes a et b augmentent l’utilisation de la mémoire.
En comparant ces instantanés, on découvre que la hausse de consommation mémoire provient surtout d’allocations répétées de grandes listes. Si ces allocations sont inutiles dans un cas réel, elles peuvent indiquer une fuite mémoire. Une trace détaillée permet d’identifier précisément les lignes de code responsables.
tracemalloc propose aussi des outils pour analyser les zones de votre application qui consomment le plus de mémoire. Cela vous aide à concentrer vos optimisations là où l’impact sera maximal.
Voici comment analyser les principaux consommateurs :
import tracemalloc

# Start tracing memory allocations
tracemalloc.start()

# Code block for which memory usage is to be tracked
def allocate_memory():
    a = [i for i in range(10000)]
    b = [i**2 for i in range(10000)]

allocate_memory()

# Take a snapshot
snapshot = tracemalloc.take_snapshot()

# Analyze top memory consumers
top_stats = snapshot.statistics('lineno')
print("[ Top 10 memory consumers ]")
for stat in top_stats[:10]:
    print(stat)

# Stop tracing memory allocations
tracemalloc.stop()
Dans cet exemple, après avoir pris un instantané, j’utilise snapshot.statistics('lineno') pour obtenir des statistiques d’utilisation par numéro de ligne. Cette sortie permet d’identifier rapidement les parties du code qui consomment le plus de mémoire et de les cibler pour l’optimisation.
Objgraph est une bibliothèque Python conçue pour aider les développeurs à visualiser et analyser les références entre objets dans leur code. Elle permet de créer des graphes qui montrent comment les objets en mémoire se référencent entre eux. Cette visualisation est très utile pour comprendre la structure et les relations au sein de votre programme, identifier des fuites et optimiser l’utilisation de la mémoire.
Commençons par installer la bibliothèque objgraph. Vous pouvez l’installer avec pip :
pip install objgraphobjgraphobjgraph propose plusieurs fonctionnalités essentielles pour le profilage et la visualisation mémoire :
objgraph, vous pouvez créer des représentations visuelles des objets et de leurs références. Cela facilite la compréhension des interconnexions, le débogage et l’optimisation.Voyons quelques exemples d’utilisation d’objgraph en pratique.
Exemple 1 : générer un graphe de références
Supposons une classe simple et quelques instances :
class Node:
    def __init__(self, value):
        self.value = value
        self.children = []

# Create some nodes
node1 = Node(1)
node2 = Node(2)
node3 = Node(3)

# Establish relationships
node1.children.append(node2)
node2.children.append(node3)

import Objgraph

# Generate a graph of object references
objgraph.show_refs([node1], filename='object_refs.png')
Dans cet exemple, nous définissons une classe Node et créons des instances reliées entre elles. La fonction objgraph.show_refs() génère un graphe des références d’objets à partir de node1 et l’enregistre sous object_refs.png. Ce graphe permet de comprendre les interconnexions.
Exemple 2 : détecter des références circulaires
Pour détecter les références circulaires, nous pouvons utiliser objgraph.find_backref_chain() :
# Create a circular reference
node 3.children.append(node1)

# Detect circular references
chain = objgraph.find_backref_chain(node1, objgraph.is_proper_module)
objgraph.show_chain(chain, filename='circular_refs.png')
Ici, nous créons une référence circulaire en ajoutant node1 aux enfants de node3. La fonction objgraph.find_backref_chain() détecte cette boucle, et objgraph.show_chain la visualise dans le fichier circular_refs.png.
Exemple 3 : analyser les types et tailles d’objets
Pour analyser les types et tailles d’objets, utilisez objgraph.show_most_common_types et objgraph.by_type :
# Show the most common object types
objgraph.show_most_common_types()

# Get the details of a specific object type
objs = objgraph.by_type('Node')
objgraph.show_refs(objs[:3], refcounts=True, filename='node_details.png')
Dans cet exemple, objgraph.show_most_common_types affiche les types d’objets les plus fréquents en mémoire. La fonction objgraph.by_type() récupère toutes les instances de la classe Node, et nous visualisons leurs références, avec le nombre de références, dans node_details.png.
Voyons maintenant des techniques pour bien exploiter ces outils. Nous nous concentrerons sur le profilage de fonctions spécifiques, le suivi global de l’usage mémoire et la visualisation des graphes d’objets.
Ciblez des fonctions précises avec memory_profiler ou tracemalloc.
memory_profilermemory_profiler offre un moyen simple de surveiller, ligne par ligne, la consommation mémoire au sein de vos fonctions pour repérer les zones à optimiser.
from memory_profiler import profile

@profile

def allocate_memory():
    a = [i for i in range(10000)]
    b = [i ** 2 for i in range(10000)]
    return a, b

if __name__ == "__main__":
allocate_memory()tracemallocimport tracemalloc
tracemalloc.start()
def allocate_memory():
a = [i for i in range(10000)]
b = [i ** 2 for i in range(10000)]
return a, b
allocate_memory()
snapshot = tracemalloc.take_snapshot()
top_stats = snapshot.statistics('lineno')
for stat in top_stats[:10]:
print(stat)Pour surveiller la consommation totale de mémoire de notre programme dans le temps, nous pouvons utiliser le module intégré tracemalloc. Voici comment suivre l’usage global et interpréter les résultats pour repérer des tendances.
Étapes pour utiliser tracemalloc
Nous commons par initialiser le traçage mémoire au début du script.
import tracemalloc

tracemalloc.start()
Nous exécutons ensuite les sections de code à surveiller.
def run_heavy_computation():
   a = [i for i in range(10000)]
   b = [i**2 for i in range(10000)]
   return a, b

run_heavy_computation()
Nous prenons des instantanés d’utilisation mémoire à différents moments.
snapshot1 = tracemalloc.take_snapshot()

run_heavy_computation()

snapshot2 = tracemalloc.take_snapshot()
Enfin, nous comparons les instantanés pour comprendre les schémas d’utilisation et détecter des fuites.
stats = snapshot2.compare_to(snapshot1, 'lineno')

for stat in stats[:10]:
   print(stat)
Exemple
import tracemalloc

# Start tracing memory allocations
tracemalloc.start()

# Function to run heavy computation
def run_heavy_computation():
    a = [i for i in range(10000)]
    b = [i**2 for i in range(10000)]
    return a, b

# Initial memory usage snapshot
snapshot1 = tracemalloc.take_snapshot()

# Perform memory allocations
run_heavy_computation()

# Memory usage snapshot after allocations
snapshot2 = tracemalloc.take_snapshot()

# Compare the snapshots
stats = snapshot2.compare_to(snapshot1, 'lineno')

# Print the top memory-consuming lines of code
print("[ Top 10 memory consumers ]")
for stat in stats[:10]:
    print(stat)

# Stop tracing memory allocations
tracemalloc.stop()Voici quelques conseils pour tirer parti de vos données de profilage :
Avec la bibliothèque objgraph, nous pouvons créer des visualisations des relations entre objets. Cela aide à analyser l’usage mémoire, détecter des fuites et comprendre la durée de vie des objets.
Voici le processus pas à pas pour visualiser des graphes d’objets. Nous générerons d’abord un graphe de références, puis nous détecterons les références circulaires, et enfin nous analyserons les graphes.
import objgraph

class Node:
   def __init__(self, value):
       self.value = value
       self.children = []

# Create some nodes and establish relationships
node1 = Node(1)
node2 = Node(2)
node3 = Node(3)
node1.children.append(node2)
node2.children.append(node3)

# Generate a graph of object references
objgraph.show_refs([node1], filename='object_refs.png')# Create a circular reference
node3.children.append(node1)
# Detect circular references
chain = objgraph.find_backref_chain(node1, objgraph.is_proper_module)
objgraph.show_chain(chain, filename='circular_refs.png')# Show the most common object types
objgraph.show_most_common_types()
# Get details of a specific object type
nodes = objgraph.by_type('Node')
objgraph.show_refs(nodes[:3], refcounts=True, filename='node_details.png')Exemple
import objgraph
class Node:
def __init__(self, value):
self.value = value
self.children = []
# Create some nodes and establish relationships
node1 = Node(1)
node2 = Node(2)
node3 = Node(3)
node1.children.append(node2)
node2.children.append(node3)
# Generate a graph of object references
objgraph.show_refs([node1], filename='object_refs.png')
# Create a circular reference
node3.children.append(node1)

# Detect circular references
chain = objgraph.find_backref_chain(node1, objgraph.is_proper_module)

objgraph.show_chain(chain, filename='circular_refs.png')
# Show the most common object types
objgraph.show_most_common_types()

# Get details of a specific object type
nodes = objgraph.by_type('Node')

objgraph.show_refs(nodes[:3], refcounts=True, filename='node_details.png')En dernière étape, nous analysons les graphes en suivant l’ordre suivant :
Voici quelques conseils clés pour maximiser l’efficacité de vos efforts de profilage :
Dans ce tutoriel, nous avons exploré des outils et techniques essentiels pour comprendre et optimiser l’usage de la mémoire dans vos applications Python. Parmi ces techniques : memory_profiler, qui offre une supervision simple ligne par ligne au sein de vos fonctions, et objgraph, qui fournit de puissantes capacités de visualisation pour analyser les relations entre objets, détecter des références circulaires et comprendre la structure de votre utilisation mémoire.
En intégrant le profilage mémoire dans votre workflow, vous obtenez des insights précieux sur la gestion de la mémoire par votre code, vous prenez de meilleures décisions d’optimisation et vous améliorez les performances et la fiabilité globales de vos applications. Que vous travailliez sur de petits scripts ou des systèmes à grande échelle, le profilage mémoire est une pratique incontournable pour tout développeur Python soucieux d’écrire un code efficace et robuste.
Pour approfondir votre compréhension et vos compétences en profilage mémoire et en écriture de code performant, suivez le Writing Efficient Code in Python Course. Par ailleurs, notre parcours Python Programming propose une vue d’ensemble des bonnes pratiques et des techniques avancées pour monter en compétences en développement.
Apprenez Python avec DataCamp
Cours
Cours
Cours