कोर्स
Python में Functions का परिचय
3 घंटा
471.4K
Python अनुप्रयोग, विशेषकर वे जो बड़े डेटासेट या जटिल गणनाओं से निपटते हैं, अत्यधिक मेमोरी का उपभोग कर सकते हैं, जिससे धीमापन, क्रैश या आउट-ऑफ-मेमोरी त्रुटियाँ हो सकती हैं। मेमोरी प्रोफाइलिंग एक तकनीक है जो आपको आपके Python कोड की मेमोरी खपत का विश्लेषण करने, मेमोरी लीक और बाधाओं की पहचान करने, और बेहतर प्रदर्शन व स्थिरता के लिए मेमोरी उपयोग को अनुकूलित करने में सक्षम बनाती है।
इस ट्यूटोरियल में, हम मेमोरी प्रोफाइलिंग, उपलब्ध टूल्स, और इन टूल्स का उपयोग करके अपने Python कोड को प्रोफाइल करने के व्यावहारिक उदाहरणों का अन्वेषण करेंगे।
मेमोरी प्रोफाइलिंग एक प्रोग्राम के चलने के दौरान उसकी मेमोरी उपयोगिता की निगरानी और मूल्यांकन करने की तकनीक है। यह विधि डेवलपर्स को मेमोरी लीक खोजने, मेमोरी उपयोग को अनुकूलित करने, और अपने प्रोग्रामों की मेमोरी खपत के पैटर्न को समझने में मदद करती है। अनावश्यक मेमोरी उपयोग से बचने और उससे होने वाले प्रदर्शन में सुस्ती या क्रैश को रोकने के लिए मेमोरी प्रोफाइलिंग अत्यंत महत्वपूर्ण है।
मेमोरी प्रोफाइलिंग कई प्रमुख फायदे प्रदान करती है जो कुशल और मजबूत अनुप्रयोगों को बनाए रखने के लिए आवश्यक हैं:
चलिए कई लोकप्रिय मेमोरी प्रोफाइलिंग टूल्स, उनकी विशेषताएँ, इंस्टॉलेशन और उपयोग को विस्तार से देखते हैं। विशेष रूप से, हम memory_profiler जैसे टूल को लाइन-दर-लाइन मेमोरी विश्लेषण के लिए, tracemalloc को मेमोरी स्नैपशॉट लेने और उनकी तुलना करने के लिए, और objgraph को ऑब्जेक्ट संबंधों का विज़ुअलाइज़ेशन करने के लिए देखेंगे।
memory_profiler Python में एक शक्तिशाली टूल है जो आपके कोड के मेमोरी उपयोग में विस्तृत अंतर्दृष्टि प्रदान करता है। यह लाइन-दर-लाइन मेमोरी उपयोग का सूक्ष्म विभाजन देता है, जो उच्च मेमोरी खपत के लिए जिम्मेदार सटीक लाइनों की पहचान करने में सहायक होता है। इस स्तर के विवरण पर मेमोरी उपयोग को समझकर, डेवलपर्स यह तय कर सकते हैं कि अनुकूलन प्रयास कहाँ केंद्रित करने हैं।
memory_profiler और किसी भी अतिरिक्त आवश्यक पैकेज को इंस्टॉल करने के लिए इन चरणों का पालन करें:
निम्न कमांड memory_profiler पैकेज इंस्टॉल करती है:
pip install memory_profilerयदि आप प्लॉट्स के साथ मेमोरी उपयोग को विज़ुअलाइज़ करना चाहते हैं, तो आप यह कमांड चलाकर matplotlib इंस्टॉल कर सकते हैं:
pip install matplotlibmemory_profiler का उपयोग करने के लिए इन चरणों का पालन करें:
हम उन फ़ंक्शनों को डेकोरेट करते हैं जिन्हें हमें प्रोफाइल करना है।
अपने Python स्क्रिप्ट को किसी टेक्स्ट एडिटर या IDE में खोलें।
memory_profiler से profile डेकोरेटर इम्पोर्ट करें और उसे उन फ़ंक्शनों पर लागू करें जिन्हें आप प्रोफाइल करना चाहते हैं।
यहाँ एक उदाहरण स्क्रिप्ट है:
from memory_profiler import profile
@profile

def allocate_memory():
    # Allocate a list with a range of numbers
    a = [i for i in range(10000)]
    # Allocate another list with squares of numbers
    b = [i ** 2 for i in range(10000)]
    return a, b

if __name__ == "__main__":
allocate_memory()यहाँ मैं memory_profiler पैकेज से profile डेकोरेटर इम्पोर्ट करता/करती हूँ। यह डेकोरेटर हमें डेकोरेटेड फ़ंक्शन के मेमोरी उपयोग की निगरानी करने में मदद करेगा।
from memory_profiler import profileमैं allocate_memory() फ़ंक्शन पर @profile डेकोरेटर लगाता/लगाती हूँ। इसका अर्थ है कि जब allocate_memory() चलाया जाएगा, तो memory_profiler उसका मेमोरी उपयोग ट्रैक करेगा और विस्तृत रिपोर्ट देगा।
@profileallocate_memory() फ़ंक्शन के अंदर, मैं दो सूचियाँ बनाता/बनाती हूँ। पहली सूची में 0 से 9999 तक के नंबर हैं; दूसरी सूची में 0 से 9999 तक के अंकों के वर्ग हैं।
a = [i for i in range(10000)]  # List of numbers from 0 to 9999

b = [i**2 for i in range(10000)]  # List of squares of numbers from 0 to 9999
निम्न ब्लॉक सुनिश्चित करता है कि allocate_memory() फ़ंक्शन केवल तब कॉल हो जब स्क्रिप्ट को सीधे चलाया जाए, न कि मॉड्यूल के रूप में इम्पोर्ट करने पर। जब आप इस स्क्रिप्ट को चलाते हैं, तो memory_profiler allocate_memory() फ़ंक्शन के मेमोरी उपयोग को आउटपुट करेगा, जिससे आप देख सकेंगे कि सूचियाँ a और b बनाते समय कितनी मेमोरी प्रयुक्त हुई।
if __name__ == "__main__":

   allocate_memory()
अपने टर्मिनल या कमांड प्रॉम्प्ट में, उस डायरेक्टरी पर जाएँ जहाँ आपकी स्क्रिप्ट स्थित है। -m memory_profiler विकल्प के साथ अपनी स्क्रिप्ट चलाएँ।
-m memory_profiler your_script.py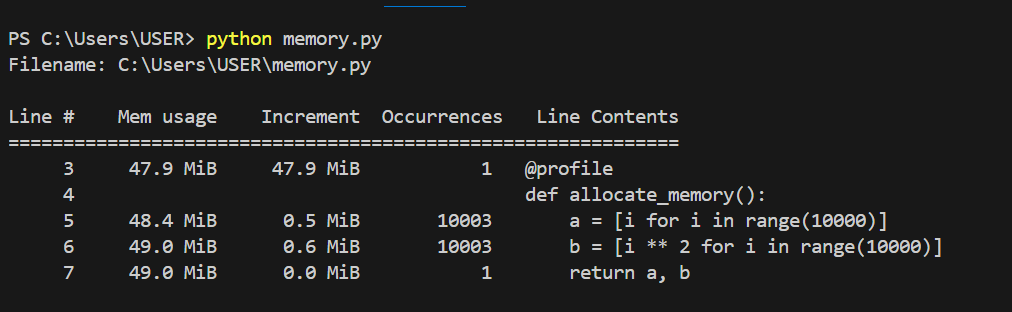
प्रत्येक कोड लाइन के लिए मेमोरी उपयोग। चित्र: लेखक।
ऊपर दिए गए ग्राफ़िक में, हम प्रत्येक कोड लाइन के मेमोरी उपयोग और हर लाइन पर हुए वृद्धि को देख सकते हैं। नीचे दिया गया ग्राफ़ और अधिक विस्तार से दिखाता है कि प्रत्येक लाइन मेमोरी का कैसे उपयोग करती है और प्रत्येक इटरेशन के साथ यह कैसे बढ़ती है।
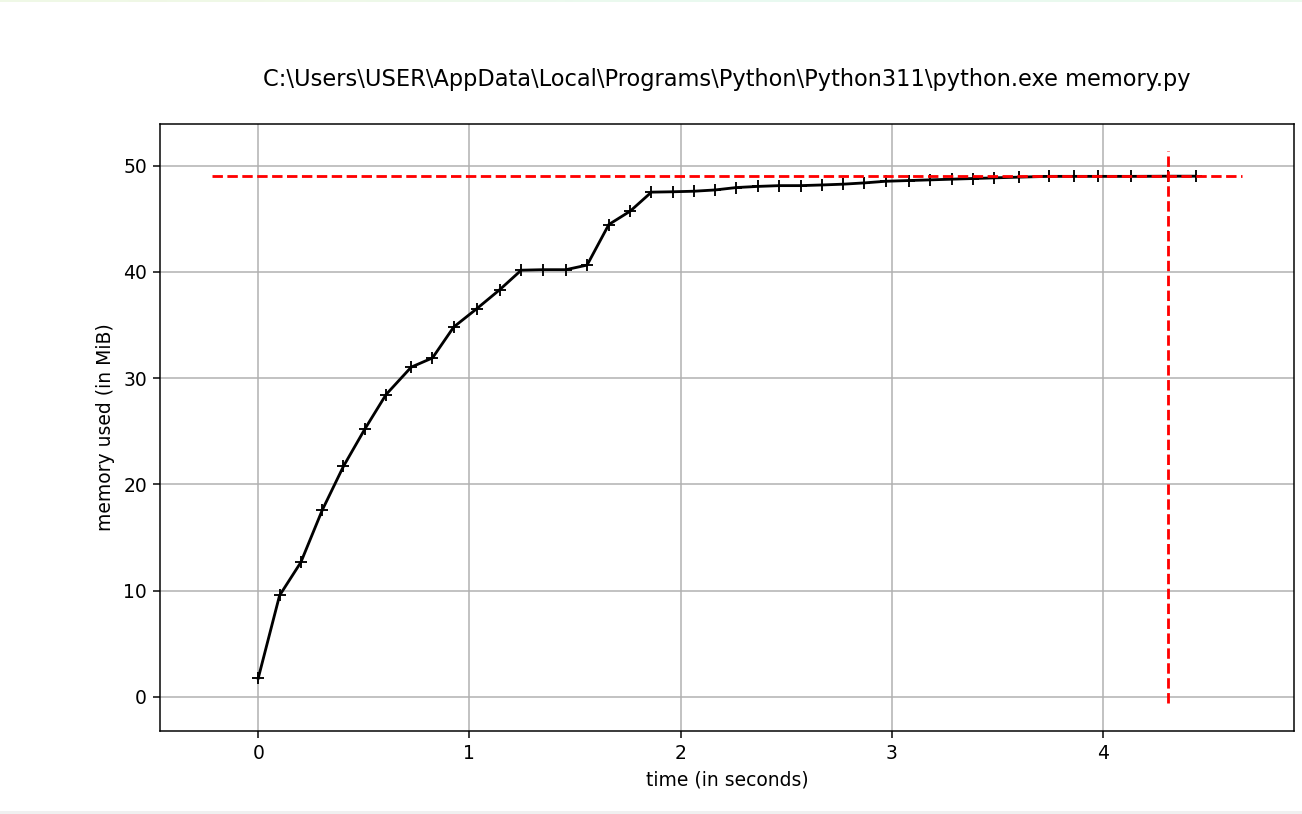
समय के साथ मेमोरी उपयोग। चित्र: लेखक।
tracemalloc Python में एक शक्तिशाली बिल्ट-इन मॉड्यूल है जो मेमोरी आवंटन और डीलोकेशन को ट्रैक करता है। यह समझना कि आपका अनुप्रयोग मेमोरी का कैसे उपयोग करता है, प्रदर्शन को अनुकूलित करने और मेमोरी लीक की पहचान करने के लिए महत्वपूर्ण है। Tracemalloc मेमोरी उपयोग के स्नैपशॉट कैप्चर और विश्लेषण करने के लिए आसान इंटरफ़ेस प्रदान करता है, जो किसी भी Python डेवलपर के लिए अमूल्य टूल है।
चलिए देखते हैं कि tracemalloc मेमोरी उपयोग के स्नैपशॉट कैसे लेता है, उन स्नैपशॉट्स की तुलना करके मेमोरी लीक की पहचान कैसे करता है, और फिर शीर्ष मेमोरी उपभोक्ताओं का विश्लेषण कैसे करता है
tracemalloc आपको अपने प्रोग्राम के विशिष्ट बिंदुओं पर मेमोरी उपयोग के स्नैपशॉट लेने देता है। एक स्नैपशॉट मेमोरी आवंटनों की स्थिति को कैप्चर करता है, जो यह बताता है कि मेमोरी कहाँ उपयोग हो रही है।
यहाँ बताया गया है कि आप tracemalloc के साथ स्नैपशॉट कैसे ले सकते हैं:
import tracemalloc

# Start tracing memory allocations
tracemalloc.start()

# Code block for which memory usage is to be tracked
def allocate_memory():
    a = [i for i in range(10000)]  # List of numbers from 0 to 9999
    b = [i**2 for i in range(10000)]  # List of squares of numbers from 0 to 9999
    return a, b

# Keep the allocated lists in scope
allocated_lists = allocate_memory()

# Take a snapshot
snapshot = tracemalloc.take_snapshot()

# Stop tracing memory allocations
tracemalloc.stop()

# Analyze the snapshot to see memory usage
top_stats = snapshot.statistics('lineno')

# Write the memory usage data to a text file
with open('memory_usage.txt', 'w') as f:
    f.write("[ Top 10 memory consumers ]\n")
    for stat in top_stats[:10]:
        f.write(f"{stat}\n")
    # Detailed traceback for the top memory consumer
    f.write("\n[ Detailed traceback for the top memory consumer ]\n")
    for stat in top_stats[:1]:
        f.write('\n'.join(stat.traceback.format()) + '\n')

print("Memory usage details saved to 'memory_usage.txt'")
मैंने अपनी Python एप्लिकेशन में tracemalloc मॉड्यूल का उपयोग करके मेमोरी उपयोग को ट्रैक और जाँचा। मेमोरी आवंटनों का स्नैपशॉट लेकर और शीर्ष मेमोरी उपभोक्ताओं को देखकर, मैंने यह निर्धारित किया कि मेरे कोड के कौन से हिस्से सबसे अधिक मेमोरी का उपयोग कर रहे थे। फिर मैंने इस विश्लेषण को आगे पढ़ने और संदर्भ के लिए एक टेक्स्ट फ़ाइल में रखा।
tracemalloc की सबसे शक्तिशाली विशेषताओं में से एक यह है कि आप अपने प्रोग्राम के विभिन्न बिंदुओं पर लिए गए स्नैपशॉट्स की तुलना करके मेमोरी लीक की पहचान कर सकते हैं। स्नैपशॉट्स के बीच के अंतर का विश्लेषण करके, आप यह पता लगा सकते हैं कि अतिरिक्त मेमोरी कहाँ आवंटित हो रही है और रिलीज़ नहीं हो रही।
यहाँ बताया गया है कि स्नैपशॉट्स की तुलना कैसे करें:
import tracemalloc

# Start tracing memory allocations
tracemalloc.start()

# Function to allocate memory
def allocate_memory():
    a = [i for i in range(10000)]  # List of numbers from 0 to 9999
    b = [i**2 for i in range(10000)]  # List of squares of numbers from 0 to 9999
    return a, b

# Initial memory usage snapshot
snapshot1 = tracemalloc.take_snapshot()

# Perform memory allocations
allocated_lists = allocate_memory()

# Memory usage snapshot after allocations
snapshot2 = tracemalloc.take_snapshot()

# Further memory allocations (simulate more work to find potential leaks)
allocated_lists += allocate_memory()

# Memory usage snapshot after additional allocations
snapshot3 = tracemalloc.take_snapshot()

# Stop tracing memory allocations
tracemalloc.stop()

# Compare the snapshots
stats1_vs_2 = snapshot2.compare_to(snapshot1, 'lineno')
stats2_vs_3 = snapshot3.compare_to(snapshot2, 'lineno')

# Save the comparison results to a text file
with open('memory_leak_analysis.txt', 'w') as f:
    f.write("[ Memory usage increase from snapshot 1 to snapshot 2 ]\n")
    for stat in stats1_vs_2[:10]:
        f.write(f"{stat}\n")

    f.write("\n[ Memory usage increase from snapshot 2 to snapshot 3 ]\n")
    for stat in stats2_vs_3[:10]:
        f.write(f"{stat}\n")

    # Detailed traceback for the top memory consumers
    f.write("\n[ Detailed traceback for the top memory consumers ]\n")
    for stat in stats2_vs_3[:1]:
        f.write('\n'.join(stat.traceback.format()) + '\n')

print("Memory leak analysis saved to 'memory_leak_analysis.txt'")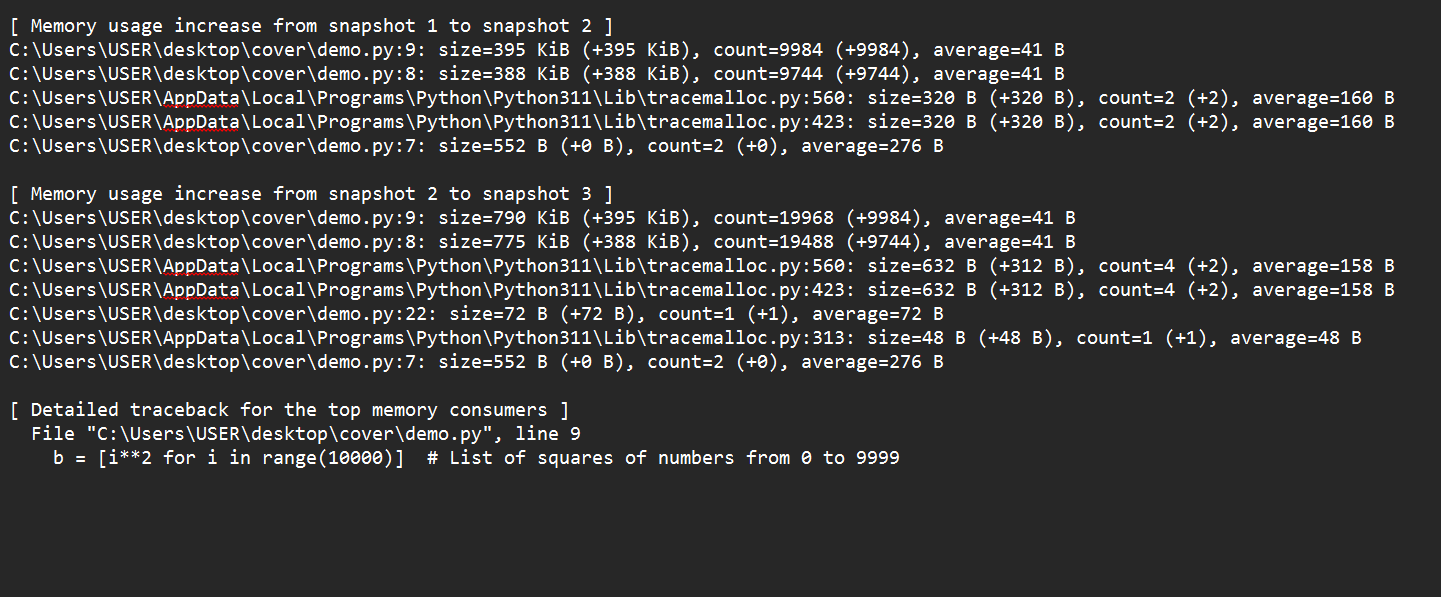
स्नैपशॉट 1 से स्नैपशॉट 2 पर जाते हुए, हम देखते हैं कि सूचियों a और b का निर्माण मेमोरी उपयोग में उछाल का प्रमुख कारण था। स्नैपशॉट 2 से स्नैपशॉट 3 की ओर बढ़ते हुए, हम यह भी देखते हैं कि सूचियों a और b के और आवंटन ने मेमोरी उपयोग को बढ़ाया।
इन स्नैपशॉट्स की तुलना करके, हमें पता चलता है कि मेमोरी उपयोग में वृद्धि का प्रमुख कारण बड़े लिस्ट्स का बार-बार आवंटन है। यदि वास्तविक-world अनुप्रयोगों में ये आवंटन अनावश्यक हों, तो वे मेमोरी लीक का संकेत दे सकते हैं। विस्तृत ट्रेसबैक उन सटीक कोड लाइनों की पहचान कर सकता है जो ये आवंटन कर रही हैं।
tracemalloc आपके अनुप्रयोग के शीर्ष मेमोरी उपभोक्ताओं का विश्लेषण करने के लिए भी टूल्स प्रदान करता है। इससे आप अपने कोड के उन हिस्सों के अनुकूलन पर ध्यान केंद्रित कर सकते हैं जो सबसे अधिक मेमोरी लेते हैं।
यहाँ बताया गया है कि शीर्ष मेमोरी उपभोक्ताओं का विश्लेषण कैसे करें:
import tracemalloc

# Start tracing memory allocations
tracemalloc.start()

# Code block for which memory usage is to be tracked
def allocate_memory():
    a = [i for i in range(10000)]
    b = [i**2 for i in range(10000)]

allocate_memory()

# Take a snapshot
snapshot = tracemalloc.take_snapshot()

# Analyze top memory consumers
top_stats = snapshot.statistics('lineno')
print("[ Top 10 memory consumers ]")
for stat in top_stats[:10]:
    print(stat)

# Stop tracing memory allocations
tracemalloc.stop()
इस उदाहरण में, स्नैपशॉट लेने के बाद, मैं snapshot.statistics('lineno') का उपयोग करके लाइन नंबर के आधार पर समूहित मेमोरी उपयोग के आँकड़े प्राप्त करता/करती हूँ। यह आउटपुट आपको जल्द ही यह पहचानने में मदद करता है कि आपके कोड के कौन से हिस्से सबसे अधिक मेमोरी का उपभोग कर रहे हैं, जिससे आप उन क्षेत्रों को अनुकूलन के लिए लक्षित कर सकें।
Objgraph एक Python लाइब्रेरी है जिसे डेवलपर्स को अपने कोड में ऑब्जेक्ट रेफरेंस को विज़ुअलाइज़ और विश्लेषित करने में मदद के लिए बनाया गया है। यह ऐसे विज़ुअल ग्राफ बनाने के उपकरण प्रदान करती है जो दिखाते हैं कि मेमोरी में ऑब्जेक्ट्स एक-दूसरे को कैसे संदर्भित करते हैं। यह विज़ुअलाइज़ेशन आपके प्रोग्राम की संरचना और संबंधों को समझने, मेमोरी लीक की पहचान करने और मेमोरी उपयोग को अनुकूलित करने में उपयोगी है।
सबसे पहले, objgraph लाइब्रेरी इंस्टॉल करें। आप इसे pip के जरिए इंस्टॉल कर सकते हैं:
pip install objgraphobjgraph की प्रमुख विशेषताएँobjgraph मेमोरी प्रोफाइलिंग और विज़ुअलाइज़ेशन के लिए कई महत्वपूर्ण विशेषताएँ प्रदान करता है:
objgraph के साथ, आप ऑब्जेक्ट्स और उनके रेफरेंस के विज़ुअल निरूपण बना सकते हैं। यह समझने में मदद करता है कि ऑब्जेक्ट्स कैसे परस्पर जुड़े हुए हैं, जिससे डिबगिंग और अनुकूलन आसान हो जाता है।आइए कुछ उदाहरणों के जरिए देखें कि व्यवहार में objgraph कैसे उपयोग किया जा सकता है।
उदाहरण 1: ऑब्जेक्ट रेफरेंस ग्राफ जनरेट करना
मान लीजिए हमारे पास एक सरल क्लास है और हम कुछ इंस्टेंस बनाते हैं:
class Node:
    def __init__(self, value):
        self.value = value
        self.children = []

# Create some nodes
node1 = Node(1)
node2 = Node(2)
node3 = Node(3)

# Establish relationships
node1.children.append(node2)
node2.children.append(node3)

import Objgraph

# Generate a graph of object references
objgraph.show_refs([node1], filename='object_refs.png')
इस उदाहरण में, हम एक Node क्लास परिभाषित करते हैं और संबंधों के साथ नोड्स के इंस्टेंस बनाते हैं। objgraph.show_refs() फ़ंक्शन node1 से शुरू होकर ऑब्जेक्ट रेफरेंस का विज़ुअल ग्राफ बनाता है और इसे object_refs.png के रूप में सहेजता है। यह ग्राफ हमें समझने में मदद करता है कि नोड्स कैसे परस्पर जुड़े हुए हैं।
उदाहरण 2: सर्कुलर रेफरेंस का पता लगाना
सर्कुलर रेफरेंस का पता लगाने के लिए, हम objgraph.find_backref_chain() फ़ंक्शन का उपयोग कर सकते हैं:
# Create a circular reference
node 3.children.append(node1)

# Detect circular references
chain = objgraph.find_backref_chain(node1, objgraph.is_proper_module)
objgraph.show_chain(chain, filename='circular_refs.png')
यहाँ, हम node3 के children में node1 जोड़कर एक सर्कुलर रेफरेंस बनाते हैं। objgraph.find_backref_chain() फ़ंक्शन इस सर्कुलर रेफरेंस का पता लगाता है, और objgraph.show_chain इसे विज़ुअलाइज़ करता है तथा आउटपुट को circular_refs.png के रूप में सहेजता है।
उदाहरण 3: ऑब्जेक्ट प्रकार और आकार का विश्लेषण
ऑब्जेक्ट्स के प्रकार और आकार का विश्लेषण करने के लिए, हम objgraph.show_most_common_types और objgraph.by_type का उपयोग कर सकते हैं:
# Show the most common object types
objgraph.show_most_common_types()

# Get the details of a specific object type
objs = objgraph.by_type('Node')
objgraph.show_refs(objs[:3], refcounts=True, filename='node_details.png')
इस उदाहरण में, objgraph.show_most_common_types वर्तमान में मेमोरी में मौजूद सबसे सामान्य ऑब्जेक्ट प्रकारों को दिखाता है। objgraph.by_type() फ़ंक्शन Node क्लास के सभी इंस्टेंस प्राप्त करता है, और हम उनके रेफरेंस को, रेफरेंस काउंट सहित, विज़ुअलाइज़ करते हैं तथा node_details.png के रूप में एक और ग्राफ सहेजते हैं।
अब आइए मेमोरी प्रोफाइलिंग टूल्स का प्रभावी ढंग से उपयोग करने की विभिन्न तकनीकों पर नज़र डालें। हम विशिष्ट फ़ंक्शनों की प्रोफाइलिंग, समग्र मेमोरी उपयोग का ट्रैक रखना, और ऑब्जेक्ट ग्राफ्स का विज़ुअलाइज़ेशन पर ध्यान केंद्रित करेंगे।
memory_profiler या tracemalloc के साथ विशिष्ट फ़ंक्शनों को लक्षित करें।
memory_profiler के साथ उदाहरणmemory_profiler आपके फ़ंक्शनों के भीतर लाइन-दर-लाइन मेमोरी खपत की निगरानी करने का सरल तरीका प्रदान करता है, जिससे आप यह पहचान सकें कि कहाँ मेमोरी उपयोग घटाया जा सकता है।
from memory_profiler import profile

@profile

def allocate_memory():
    a = [i for i in range(10000)]
    b = [i ** 2 for i in range(10000)]
    return a, b

if __name__ == "__main__":
    allocate_memory()
tracemalloc के साथ उदाहरणimport tracemalloc
tracemalloc.start()
def allocate_memory():
a = [i for i in range(10000)]
b = [i ** 2 for i in range(10000)]
return a, b
allocate_memory()
snapshot = tracemalloc.take_snapshot()
top_stats = snapshot.statistics('lineno')
for stat in top_stats[:10]:
print(stat)समय के साथ हमारे प्रोग्राम के कुल मेमोरी उपयोग की निगरानी करने के लिए, हम बिल्ट-इन tracemalloc मॉड्यूल का उपयोग कर सकते हैं। यहाँ बताया गया है कि हम समग्र मेमोरी उपयोग को कैसे ट्रैक कर सकते हैं और रुझानों की पहचान करने के लिए परिणामों की व्याख्या कैसे कर सकते हैं।
tracemalloc का उपयोग करने के चरण
हम अपनी स्क्रिप्ट की शुरुआत में मेमोरी ट्रेसिंग आरंभ करके शुरू करते हैं।
import tracemalloc

tracemalloc.start()
इसके बाद हम वह भाग चलाते हैं जिनका हम मॉनिटर करना चाहते हैं।
def run_heavy_computation():
   a = [i for i in range(10000)]
   b = [i**2 for i in range(10000)]
   return a, b

run_heavy_computation()
हम मेमोरी उपयोग के स्नैपशॉट लेते हैं। इससे विभिन्न समय बिंदुओं पर मेमोरी आवंटन की स्थिति कैप्चर होती है।
snapshot1 = tracemalloc.take_snapshot()

run_heavy_computation()

snapshot2 = tracemalloc.take_snapshot()
अंत में, हम स्नैपशॉट्स की तुलना करते हैं ताकि मेमोरी उपयोग पैटर्न समझें और लीक का पता लगा सकें।
stats = snapshot2.compare_to(snapshot1, 'lineno')

for stat in stats[:10]:
   print(stat)
उदाहरण
import tracemalloc

# Start tracing memory allocations
tracemalloc.start()

# Function to run heavy computation
def run_heavy_computation():
    a = [i for i in range(10000)]
    b = [i**2 for i in range(10000)]
    return a, b

# Initial memory usage snapshot
snapshot1 = tracemalloc.take_snapshot()

# Perform memory allocations
run_heavy_computation()

# Memory usage snapshot after allocations
snapshot2 = tracemalloc.take_snapshot()

# Compare the snapshots
stats = snapshot2.compare_to(snapshot1, 'lineno')

# Print the top memory-consuming lines of code
print("[ Top 10 memory consumers ]")
for stat in stats[:10]:
    print(stat)

# Stop tracing memory allocations
tracemalloc.stop()यहाँ कुछ सुझाव हैं जो आपकी प्रोफाइलिंग डेटा को समझने में मदद करेंगे:
objgraph लाइब्रेरी का उपयोग करके, हम ऑब्जेक्ट संबंधों के विज़ुअलाइज़ेशन बना सकते हैं। यह हमें मेमोरी उपयोग का विश्लेषण करने, लीक का पता लगाने, और ऑब्जेक्ट के जीवनकाल को समझने में मदद करता है।
यह ऑब्जेक्ट ग्राफ्स को विज़ुअलाइज़ करने की चरण-दर-चरण प्रक्रिया है। पहले, हम एक ऑब्जेक्ट रेफरेंस ग्राफ जनरेट करेंगे; फिर, हम सर्कुलर रेफरेंस का पता लगाएंगे; अंत में, हम ग्राफ्स का विश्लेषण करेंगे।
import objgraph

class Node:
   def __init__(self, value):
       self.value = value
       self.children = []

# Create some nodes and establish relationships
node1 = Node(1)
node2 = Node(2)
node3 = Node(3)
node1.children.append(node2)
node2.children.append(node3)

# Generate a graph of object references
objgraph.show_refs([node1], filename='object_refs.png')# Create a circular reference
node3.children.append(node1)
# Detect circular references
chain = objgraph.find_backref_chain(node1, objgraph.is_proper_module)
objgraph.show_chain(chain, filename='circular_refs.png')# Show the most common object types
objgraph.show_most_common_types()
# Get details of a specific object type
nodes = objgraph.by_type('Node')
objgraph.show_refs(nodes[:3], refcounts=True, filename='node_details.png')उदाहरण
import objgraph
class Node:
def __init__(self, value):
self.value = value
self.children = []
# Create some nodes and establish relationships
node1 = Node(1)
node2 = Node(2)
node3 = Node(3)
node1.children.append(node2)
node2.children.append(node3)
# Generate a graph of object references
objgraph.show_refs([node1], filename='object_refs.png')
# Create a circular reference
node3.children.append(node1)

# Detect circular references
chain = objgraph.find_backref_chain(node1, objgraph.is_proper_module)

objgraph.show_chain(chain, filename='circular_refs.png')
# Show the most common object types
objgraph.show_most_common_types()

# Get details of a specific object type
nodes = objgraph.by_type('Node')

objgraph.show_refs(nodes[:3], refcounts=True, filename='node_details.png')अंतिम चरण के रूप में, हम ग्राफ्स का विश्लेषण करते हैं। हम निम्न क्रम में बातों पर विचार करते हैं:
अपनी प्रोफाइलिंग से अधिकतम लाभ उठाने के लिए यहाँ कुछ प्रमुख टिप्स और सर्वोत्तम प्रथाएँ दी गई हैं:
इस ट्यूटोरियल में, हमने आपके Python अनुप्रयोगों में मेमोरी उपयोग को समझने और अनुकूलित करने के लिए आवश्यक टूल्स और तकनीकों का अन्वेषण किया। इन तकनीकों में memory_profiler शामिल है, जो आपके फ़ंक्शन के भीतर लाइन-दर-लाइन मेमोरी खपत की निगरानी का सरल तरीका प्रदान करता है, और objgraph, जो शक्तिशाली विज़ुअलाइज़ेशन क्षमताएँ देता है, जिससे आप ऑब्जेक्ट संबंधों का विश्लेषण, सर्कुलर रेफरेंस का पता लगाना, और मेमोरी उपयोग की संरचना को समझना संभव होता है।
जब आप मेमोरी प्रोफाइलिंग टूल्स को अपने विकास वर्कफ़्लो में एकीकृत करते हैं, तो आपको यह समझने में मूल्यवान अंतर्दृष्टि मिलती है कि आपका कोड मेमोरी को कैसे प्रबंधित करता है, आप सूचित अनुकूलन निर्णय ले पाते हैं, और अपने अनुप्रयोगों के समग्र प्रदर्शन और विश्वसनीयता को बढ़ा पाते हैं। चाहे आप छोटे स्क्रिप्ट्स पर काम कर रहे हों या बड़े पैमाने की प्रणालियों पर, कुशल और मजबूत कोड लिखने का लक्ष्य रखने वाले किसी भी Python डेवलपर के लिए मेमोरी प्रोफाइलिंग एक आवश्यक अभ्यास है।
मेमोरी प्रोफाइलिंग और कुशल कोड लिखने में अपनी समझ और कौशल को गहरा करने के लिए, Writing Efficient Code in Python Course करने पर विचार करें। इसके अतिरिक्त, हमारा Python Programming कोर्स आपको सर्वोत्तम प्रथाओं और उन्नत तकनीकों का व्यापक अवलोकन प्रदान करता है, जिससे आप एक दक्ष डेवलपर बन सकें।
DataCamp के साथ Python सीखें
कोर्स
कोर्स
कोर्स