Corso
Introduzione alle funzioni in Python
3 ore
471.2K
Le applicazioni Python, soprattutto quelle che lavorano con grandi dataset o calcoli complessi, possono consumare molta memoria, causando rallentamenti, crash o errori di memoria insufficiente. Il memory profiling è una tecnica che ti permette di analizzare l'uso della memoria del tuo codice Python, individuare memory leak e colli di bottiglia e ottimizzare i consumi per migliorare prestazioni e stabilità.
In questo tutorial, esploreremo il memory profiling, gli strumenti disponibili e esempi pratici su come usarli per profilare il tuo codice Python.
Il memory profiling è la tecnica di monitorare e valutare l'utilizzo della memoria di un programma mentre è in esecuzione. Questo metodo aiuta gli sviluppatori a trovare memory leak, ottimizzare l'uso della memoria e comprendere i pattern di consumo dei propri programmi. Il memory profiling è fondamentale per evitare che le applicazioni usino più memoria del necessario, causando prestazioni lente o crash.
Il memory profiling offre diversi vantaggi chiave, essenziali per mantenere applicazioni efficienti e robuste:
Vediamo alcuni strumenti popolari per il memory profiling, con dettagli su funzionalità, installazione e utilizzo. In particolare, analizzeremo strumenti come memory_profiler per l'analisi riga per riga, tracemalloc per catturare e confrontare snapshot di memoria e objgraph per visualizzare le relazioni tra oggetti.
memory_profiler è un potente strumento in Python che offre una visione dettagliata dell'uso della memoria del tuo codice. Funziona fornendo una scomposizione granulare, riga per riga, dell'utilizzo della memoria, utile per individuare le righe esatte responsabili di consumi elevati. Capire l'uso della memoria a questo livello permette di prendere decisioni informate su dove concentrare gli sforzi di ottimizzazione.
Per installare memory_profiler e gli eventuali pacchetti aggiuntivi necessari, segui questi passaggi:
Il seguente comando installa il pacchetto memory_profiler:
pip install memory_profilerSe vuoi visualizzare l'uso della memoria con grafici, puoi installare matplotlib eseguendo:
pip install matplotlibPer usare memory_profiler, segui questi passaggi:
Decora le funzioni che vuoi profilare.
Apri il tuo script Python in un editor di testo o in un IDE.
Importa il decorator profile da memory_profiler e applicalo alle funzioni che vuoi profilare.
Ecco uno script di esempio:
from memory_profiler import profile
@profile

def allocate_memory():
    # Allocate a list with a range of numbers
    a = [i for i in range(10000)]
    # Allocate another list with squares of numbers
    b = [i ** 2 for i in range(10000)]
    return a, b

if __name__ == "__main__":
allocate_memory()Qui importo il decorator profile dal pacchetto memory_profiler. Questo decorator ci aiuta a monitorare l'uso della memoria della funzione decorata.
from memory_profiler import profileApplico il decorator @profile alla funzione allocate_memory(). Significa che quando allocate_memory() viene eseguita, memory_profiler ne traccerà l'uso della memoria e fornirà un report dettagliato.
@profileAll'interno della funzione allocate_memory() creo due liste. La prima contiene i numeri da 0 a 9999; la seconda contiene i quadrati dei numeri da 0 a 9999.
a = [i for i in range(10000)]  # List of numbers from 0 to 9999

b = [i**2 for i in range(10000)]  # List of squares of numbers from 0 to 9999
Il seguente blocco garantisce che la funzione allocate_memory() venga chiamata solo quando lo script è eseguito direttamente e non quando è importato come modulo. Quando esegui questo script, memory_profiler stamperà l'uso della memoria della funzione allocate_memory(), permettendoti di vedere quanta memoria viene usata durante la creazione delle due liste, a e b.
if __name__ == "__main__":

   allocate_memory()
Nel terminale o prompt dei comandi, vai nella cartella in cui si trova il tuo script. Esegui lo script con l'opzione -m memory_profiler.
-m memory_profiler your_script.py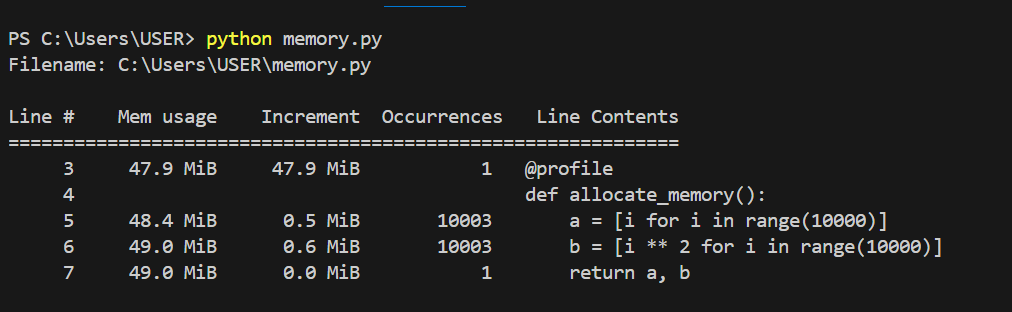
Uso della memoria per ogni riga di codice. Immagine dell'autore.
Nel grafico sopra, possiamo vedere l'uso della memoria di ogni riga di codice e gli incrementi per ciascuna riga. Il grafico seguente mostra in maggior dettaglio come ogni riga usa la memoria e come aumenta a ogni iterazione.
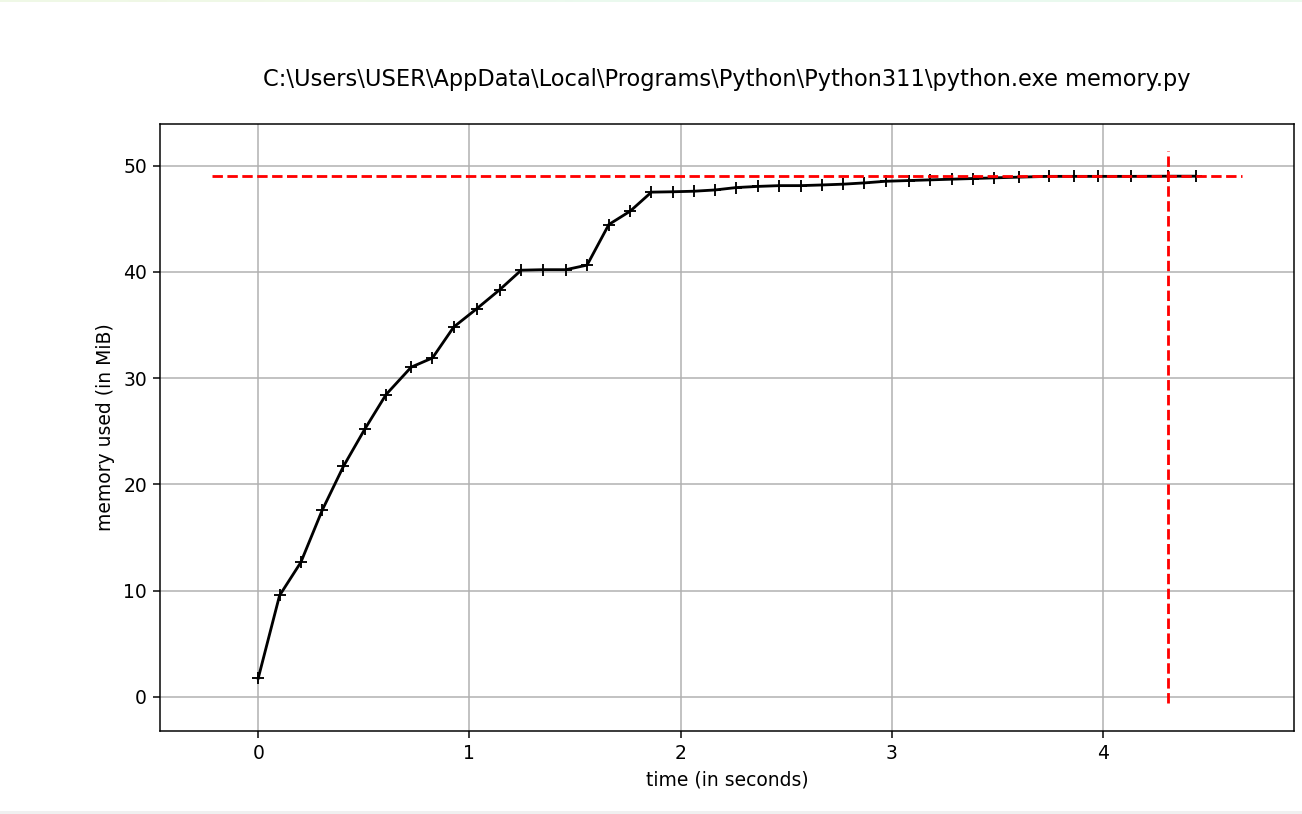
Uso della memoria nel tempo. Immagine dell'autore.
tracemalloc è un potente modulo integrato in Python che traccia allocazioni e deallocazioni di memoria. Capire come la tua applicazione usa la memoria è cruciale per ottimizzare le prestazioni e individuare memory leak. Tracemalloc fornisce un'interfaccia semplice per catturare e analizzare snapshot di utilizzo della memoria, rendendolo uno strumento prezioso per qualsiasi sviluppatore Python.
Vediamo come tracemalloc scatta snapshot dell'uso della memoria, li confronta per individuare memory leak e analizza poi i maggiori consumatori di memoria
tracemalloc ti consente di scattare snapshot dell'uso della memoria in punti specifici del programma. Uno snapshot cattura lo stato delle allocazioni, offrendo una vista dettagliata di dove viene usata la memoria.
Ecco come puoi scattare uno snapshot con tracemalloc:
import tracemalloc

# Start tracing memory allocations
tracemalloc.start()

# Code block for which memory usage is to be tracked
def allocate_memory():
    a = [i for i in range(10000)]  # List of numbers from 0 to 9999
    b = [i**2 for i in range(10000)]  # List of squares of numbers from 0 to 9999
    return a, b

# Keep the allocated lists in scope
allocated_lists = allocate_memory()

# Take a snapshot
snapshot = tracemalloc.take_snapshot()

# Stop tracing memory allocations
tracemalloc.stop()

# Analyze the snapshot to see memory usage
top_stats = snapshot.statistics('lineno')

# Write the memory usage data to a text file
with open('memory_usage.txt', 'w') as f:
    f.write("[ Top 10 memory consumers ]\n")
    for stat in top_stats[:10]:
        f.write(f"{stat}\n")
    # Detailed traceback for the top memory consumer
    f.write("\n[ Detailed traceback for the top memory consumer ]\n")
    for stat in top_stats[:1]:
        f.write('\n'.join(stat.traceback.format()) + '\n')

print("Memory usage details saved to 'memory_usage.txt'")
Ho tracciato ed esaminato l'uso della memoria nella mia applicazione Python usando il modulo tracemalloc. Scattando uno snapshot delle allocazioni e osservando i maggiori consumatori di memoria, ho capito quali sezioni del codice usano più memoria. Ho poi salvato questa analisi in un file di testo per consultazioni successive.
Una delle funzionalità più potenti di tracemalloc è la possibilità di confrontare snapshot presi in momenti diversi del programma per individuare memory leak. Analizzando le differenze tra snapshot, puoi capire dove viene allocata memoria aggiuntiva che non viene poi rilasciata.
Ecco come confrontare snapshot:
import tracemalloc

# Start tracing memory allocations
tracemalloc.start()

# Function to allocate memory
def allocate_memory():
    a = [i for i in range(10000)]  # List of numbers from 0 to 9999
    b = [i**2 for i in range(10000)]  # List of squares of numbers from 0 to 9999
    return a, b

# Initial memory usage snapshot
snapshot1 = tracemalloc.take_snapshot()

# Perform memory allocations
allocated_lists = allocate_memory()

# Memory usage snapshot after allocations
snapshot2 = tracemalloc.take_snapshot()

# Further memory allocations (simulate more work to find potential leaks)
allocated_lists += allocate_memory()

# Memory usage snapshot after additional allocations
snapshot3 = tracemalloc.take_snapshot()

# Stop tracing memory allocations
tracemalloc.stop()

# Compare the snapshots
stats1_vs_2 = snapshot2.compare_to(snapshot1, 'lineno')
stats2_vs_3 = snapshot3.compare_to(snapshot2, 'lineno')

# Save the comparison results to a text file
with open('memory_leak_analysis.txt', 'w') as f:
    f.write("[ Memory usage increase from snapshot 1 to snapshot 2 ]\n")
    for stat in stats1_vs_2[:10]:
        f.write(f"{stat}\n")

    f.write("\n[ Memory usage increase from snapshot 2 to snapshot 3 ]\n")
    for stat in stats2_vs_3[:10]:
        f.write(f"{stat}\n")

    # Detailed traceback for the top memory consumers
    f.write("\n[ Detailed traceback for the top memory consumers ]\n")
    for stat in stats2_vs_3[:1]:
        f.write('\n'.join(stat.traceback.format()) + '\n')

print("Memory leak analysis saved to 'memory_leak_analysis.txt'")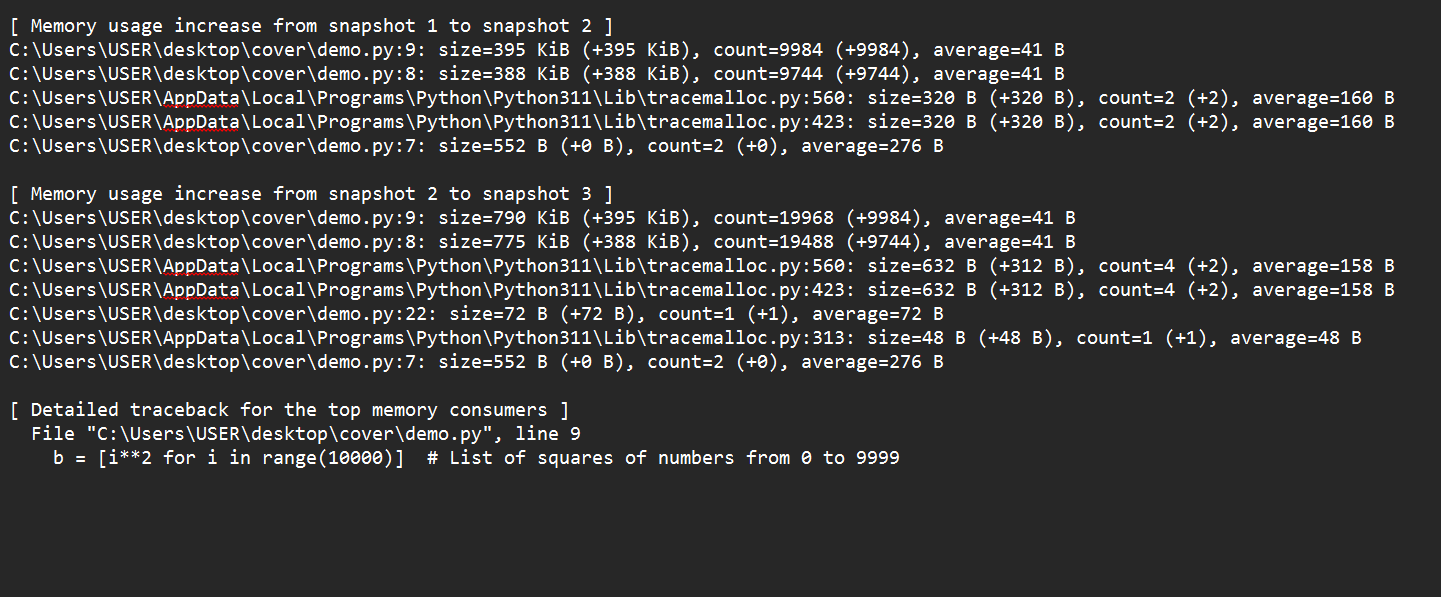
Passando dallo snapshot 1 allo snapshot 2, vediamo che la creazione delle liste a e b è stata la principale causa del picco di utilizzo della memoria. Passando dallo snapshot 2 allo snapshot 3, vediamo anche che ulteriori allocazioni delle liste a e b hanno aumentato l'utilizzo della memoria.
Confrontando questi snapshot, scopriamo che la causa principale dell'aumento dell'uso della memoria è la ricorrente allocazione di liste grandi. Queste allocazioni possono indicare un memory leak se non necessarie in applicazioni reali. Un traceback dettagliato può identificare le righe di codice precise che causano queste allocazioni.
tracemalloc offre anche strumenti per analizzare i principali consumatori di memoria della tua applicazione. Questo ti aiuta a concentrarti sull'ottimizzazione delle parti di codice che usano più memoria.
Ecco come analizzare i maggiori consumatori:
import tracemalloc

# Start tracing memory allocations
tracemalloc.start()

# Code block for which memory usage is to be tracked
def allocate_memory():
    a = [i for i in range(10000)]
    b = [i**2 for i in range(10000)]

allocate_memory()

# Take a snapshot
snapshot = tracemalloc.take_snapshot()

# Analyze top memory consumers
top_stats = snapshot.statistics('lineno')
print("[ Top 10 memory consumers ]")
for stat in top_stats[:10]:
    print(stat)

# Stop tracing memory allocations
tracemalloc.stop()
In questo esempio, dopo aver scattato uno snapshot, uso snapshot.statistics('lineno') per ottenere statistiche sull'uso della memoria raggruppate per numero di riga. Questo output ti aiuta a identificare rapidamente quali parti del codice consumano più memoria, permettendoti di mirare quelle aree per l'ottimizzazione.
Objgraph è una libreria Python pensata per aiutare gli sviluppatori a visualizzare e analizzare i riferimenti tra oggetti nel codice. Fornisce strumenti per creare grafi visivi che mostrano come gli oggetti in memoria si referenziano tra loro. Questa visualizzazione è utile per capire la struttura e le relazioni all'interno del programma, individuare memory leak e ottimizzare l'uso della memoria.
Per prima cosa, installiamo la libreria objgraph. Puoi installarla con pip:
pip install objgraphobjgraphobjgraph offre diverse funzionalità cruciali per profiling e visualizzazione della memoria:
objgraph puoi creare rappresentazioni visive degli oggetti e dei loro riferimenti. Questo aiuta a capire come gli oggetti sono interconnessi, rendendo più semplice il debug e l'ottimizzazione del codice.Vediamo alcuni esempi per capire come usare objgraph nella pratica.
Esempio 1: Generare un grafo dei riferimenti tra oggetti
Supponiamo di avere una semplice classe e di creare alcune istanze:
class Node:
    def __init__(self, value):
        self.value = value
        self.children = []

# Create some nodes
node1 = Node(1)
node2 = Node(2)
node3 = Node(3)

# Establish relationships
node1.children.append(node2)
node2.children.append(node3)

import Objgraph

# Generate a graph of object references
objgraph.show_refs([node1], filename='object_refs.png')
In questo esempio, definiamo una classe Node e creiamo istanze di nodi con relazioni. La funzione objgraph.show_refs() genera un grafo visivo dei riferimenti a partire da node1 e lo salva come object_refs.png. Questo grafo ci aiuta a capire come i nodi sono interconnessi.
Esempio 2: Rilevare riferimenti circolari
Per rilevare riferimenti circolari, possiamo usare la funzione objgraph.find_backref_chain():
# Create a circular reference
node 3.children.append(node1)

# Detect circular references
chain = objgraph.find_backref_chain(node1, objgraph.is_proper_module)
objgraph.show_chain(chain, filename='circular_refs.png')
Qui creiamo un riferimento circolare aggiungendo node1 ai children di node3. La funzione objgraph.find_backref_chain() rileva questo riferimento circolare e objgraph.show_chain lo visualizza, salvando l'output come circular_refs.png.
Esempio 3: Analizzare tipi e dimensioni degli oggetti
Per analizzare tipi e dimensioni degli oggetti, possiamo usare objgraph.show_most_common_types e objgraph.by_type:
# Show the most common object types
objgraph.show_most_common_types()

# Get the details of a specific object type
objs = objgraph.by_type('Node')
objgraph.show_refs(objs[:3], refcounts=True, filename='node_details.png')
In questo esempio, objgraph.show_most_common_types mostra i tipi di oggetto più comuni attualmente in memoria. La funzione objgraph.by_type() recupera tutte le istanze della classe Node e ne visualizziamo i riferimenti, inclusi i conteggi di riferimento, generando un altro grafo salvato come node_details.png.
Ora vediamo varie tecniche per usare in modo efficace gli strumenti di memory profiling. Ci concentreremo sul profilare funzioni specifiche, monitorare l'uso complessivo della memoria e visualizzare i grafi degli oggetti.
Prendi di mira funzioni specifiche con memory_profiler o tracemalloc.
memory_profilermemory_profiler offre un modo semplice per monitorare, riga per riga, il consumo di memoria all'interno delle funzioni, aiutandoti a individuare dove ridurre l'uso di memoria.
from memory_profiler import profile

@profile

def allocate_memory():
    a = [i for i in range(10000)]
    b = [i ** 2 for i in range(10000)]
    return a, b

if __name__ == "__main__":
allocate_memory()tracemallocimport tracemalloc
tracemalloc.start()
def allocate_memory():
a = [i for i in range(10000)]
b = [i ** 2 for i in range(10000)]
return a, b
allocate_memory()
snapshot = tracemalloc.take_snapshot()
top_stats = snapshot.statistics('lineno')
for stat in top_stats[:10]:
print(stat)Per monitorare nel tempo l'uso totale della memoria del nostro programma, possiamo usare il modulo integrato tracemalloc. Ecco come tracciare l'uso complessivo della memoria e interpretare i risultati per individuare tendenze.
Passaggi per usare tracemalloc
Iniziamo abilitando il tracing della memoria all'avvio dello script.
import tracemalloc

tracemalloc.start()
Poi eseguiamo il codice eseguendo le sezioni che vogliamo monitorare.
def run_heavy_computation():
   a = [i for i in range(10000)]
   b = [i**2 for i in range(10000)]
   return a, b

run_heavy_computation()
Quindi scatturiamo snapshot dell'uso della memoria. Questo ci permette di fotografare lo stato delle allocazioni in momenti diversi.
snapshot1 = tracemalloc.take_snapshot()

run_heavy_computation()

snapshot2 = tracemalloc.take_snapshot()
Infine confrontiamo gli snapshot per capire i pattern di utilizzo e rilevare leak.
stats = snapshot2.compare_to(snapshot1, 'lineno')

for stat in stats[:10]:
   print(stat)
Esempio
import tracemalloc

# Start tracing memory allocations
tracemalloc.start()

# Function to run heavy computation
def run_heavy_computation():
    a = [i for i in range(10000)]
    b = [i**2 for i in range(10000)]
    return a, b

# Initial memory usage snapshot
snapshot1 = tracemalloc.take_snapshot()

# Perform memory allocations
run_heavy_computation()

# Memory usage snapshot after allocations
snapshot2 = tracemalloc.take_snapshot()

# Compare the snapshots
stats = snapshot2.compare_to(snapshot1, 'lineno')

# Print the top memory-consuming lines of code
print("[ Top 10 memory consumers ]")
for stat in stats[:10]:
    print(stat)

# Stop tracing memory allocations
tracemalloc.stop()Ecco alcuni suggerimenti per dare senso ai dati di profiling:
Usando la libreria objgraph, possiamo creare visualizzazioni delle relazioni tra oggetti. Questo aiuta ad analizzare l'uso della memoria, rilevare leak e capire il ciclo di vita degli oggetti.
Ecco il processo passo dopo passo per visualizzare i grafi degli oggetti. Per prima cosa generiamo un grafo dei riferimenti; poi rileviamo i riferimenti circolari; infine analizziamo i grafi.
import objgraph

class Node:
   def __init__(self, value):
       self.value = value
       self.children = []

# Create some nodes and establish relationships
node1 = Node(1)
node2 = Node(2)
node3 = Node(3)
node1.children.append(node2)
node2.children.append(node3)

# Generate a graph of object references
objgraph.show_refs([node1], filename='object_refs.png')# Create a circular reference
node3.children.append(node1)
# Detect circular references
chain = objgraph.find_backref_chain(node1, objgraph.is_proper_module)
objgraph.show_chain(chain, filename='circular_refs.png')# Show the most common object types
objgraph.show_most_common_types()
# Get details of a specific object type
nodes = objgraph.by_type('Node')
objgraph.show_refs(nodes[:3], refcounts=True, filename='node_details.png')Esempio
import objgraph
class Node:
def __init__(self, value):
self.value = value
self.children = []
# Create some nodes and establish relationships
node1 = Node(1)
node2 = Node(2)
node3 = Node(3)
node1.children.append(node2)
node2.children.append(node3)
# Generate a graph of object references
objgraph.show_refs([node1], filename='object_refs.png')
# Create a circular reference
node3.children.append(node1)

# Detect circular references
chain = objgraph.find_backref_chain(node1, objgraph.is_proper_module)

objgraph.show_chain(chain, filename='circular_refs.png')
# Show the most common object types
objgraph.show_most_common_types()

# Get details of a specific object type
nodes = objgraph.by_type('Node')

objgraph.show_refs(nodes[:3], refcounts=True, filename='node_details.png')Come passo finale, analizziamo i grafi. Consideriamo i seguenti passaggi, in ordine:
Ecco alcuni consigli e best practice per ottenere il massimo dai tuoi sforzi di profiling:
In questo tutorial, abbiamo esplorato strumenti e tecniche essenziali per comprendere e ottimizzare l'uso della memoria nelle tue applicazioni Python. Tra queste tecniche ci sono memory_profiler, che offre un modo semplice per monitorare il consumo di memoria riga per riga all'interno delle funzioni, e objgraph, che fornisce potenti capacità di visualizzazione, permettendoti di analizzare le relazioni tra oggetti, rilevare riferimenti circolari e comprendere la struttura dell'uso della memoria.
Integrare gli strumenti di memory profiling nel tuo flusso di lavoro di sviluppo ti consente di ottenere insight preziosi su come il tuo codice gestisce la memoria, prendere decisioni di ottimizzazione informate e migliorare le prestazioni e l'affidabilità complessive delle tue applicazioni. Che tu stia lavorando su piccoli script o sistemi su larga scala, il memory profiling è una pratica essenziale per ogni sviluppatore Python che mira a scrivere codice efficiente e robusto.
Per approfondire la tua comprensione e le tue competenze nel memory profiling e nella scrittura di codice efficiente, valuta di seguire il corso Writing Efficient Code in Python. Inoltre, il nostro corso di Programmazione in Python offre una panoramica completa di best practice e tecniche avanzate per aiutarti a diventare uno sviluppatore esperto.
Impara Python con DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



