
50% off DataCamp Premium. 700+ courses, half price. Start learning today.
Mistral Medium 3 biedt hoge prestaties voor een aanzienlijk lagere prijs dan veel alternatieven. Het is momenteel beschikbaar via de Mistral AI API, voor slechts $0,40 per miljoen inputtokens en $2 per miljoen outputtokens. Deze prijsstelling steekt gunstig af tegen toonaangevende concurrenten zoals DeepSeek v3, zowel via API als in zelfgehoste systemen. Kortom: je kunt tot 90% van de prestaties van Claude Sonnet 3.7 op diverse benchmarks behalen en tegelijkertijd aanzienlijk op kosten besparen.
In deze tutorial leer je hoe je de Mistral API instelt en de Python-client gebruikt om het model aan te spreken. Daarna gebruiken we LangGraph om een agentische applicatie te bouwen die webzoekopdrachten en de Python REPL-tool inzet om antwoorden te genereren.
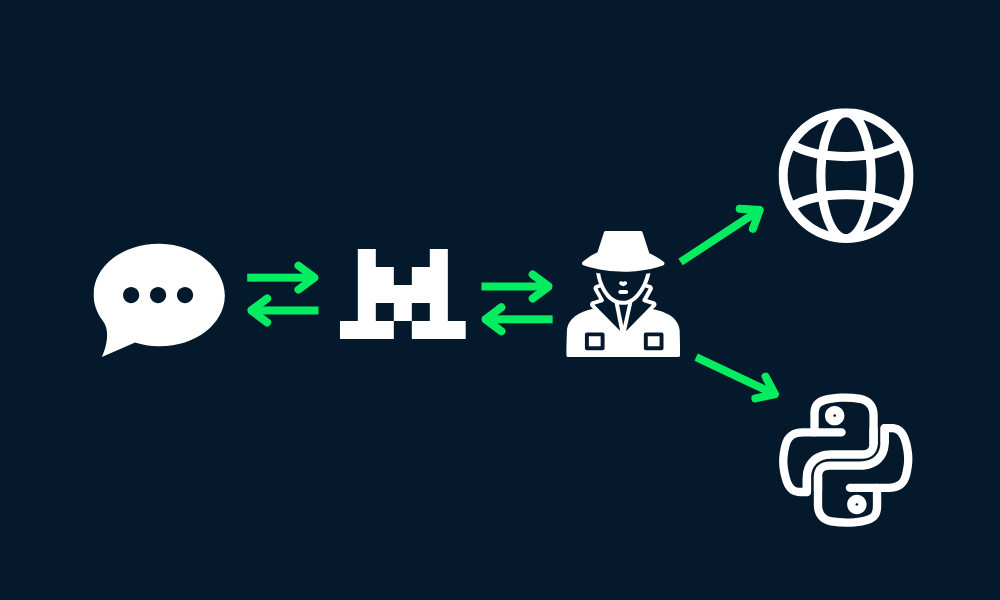
Afbeelding door de auteur
In deze sectie maken we een API-sleutel aan, slaan we die op als omgevingsvariabele en gebruiken we vervolgens de Python-client om Mistral Medium 3 te gebruiken voor tekstgeneratie en beeldbegrip.
Meld je aan bij La Plateforme: Mistral AI en ga daarna naar de sectie Billing en laad $5 tegoed op met een creditcard/debetkaart. Voor dit project heb je maar een paar cent nodig. Ga daarna naar het tabblad API keys om een nieuwe API-sleutel te genereren.
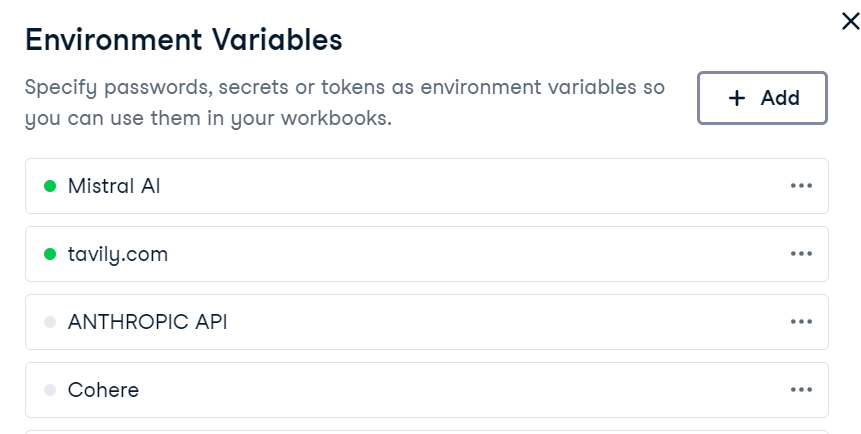
Een omgevingsvariabele instellen in DataLab is eenvoudig. Ga naar het tabblad "Environment", kies "Environment Variables" en voeg een nieuwe variabele toe met de naam "MISTRAL_API_KEY" plus je API-sleutel. Sla de wijzigingen op en zorg ervoor dat je deze verbindt.
Maak in DataLab een nieuwe Python-cel en installeer het Mistral AI Python-pakket.
!pip install -U mistralai Voordat je code schrijft, is het belangrijk de endpointnaam voor de Mistral Medium 3 API te vinden via de pagina Models Overview. Volgens de documentatie heet het endpoint mistral-medium-latest.
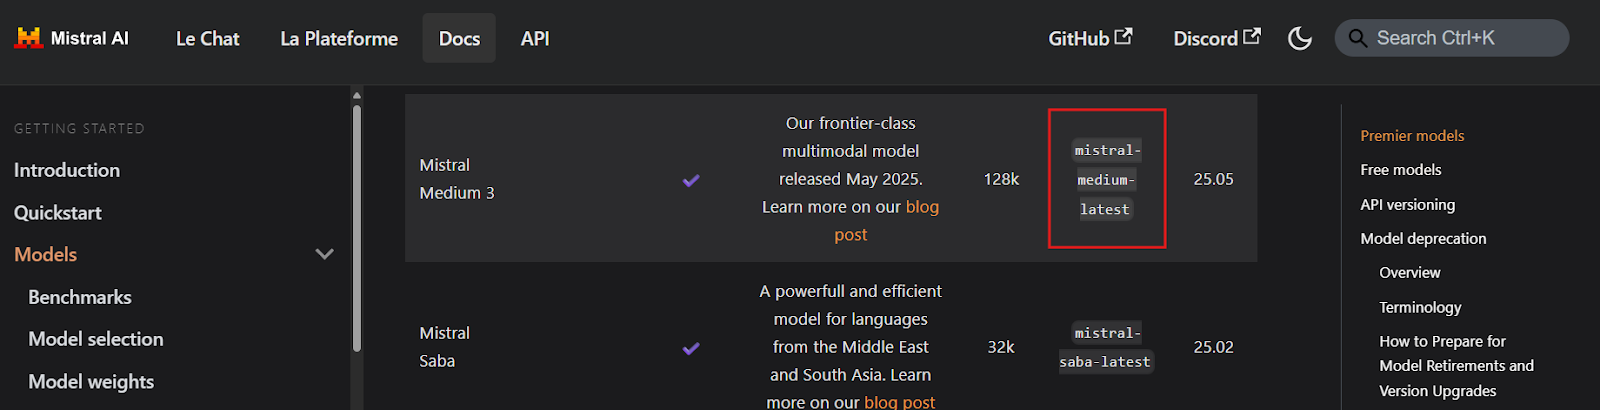
Bron: Models Overview | Mistral AI Large Language Models
Vervolgens maken we met de API-sleutel een Mistral AI-client en genereren we een streamingantwoord op een gebruikersvraag.
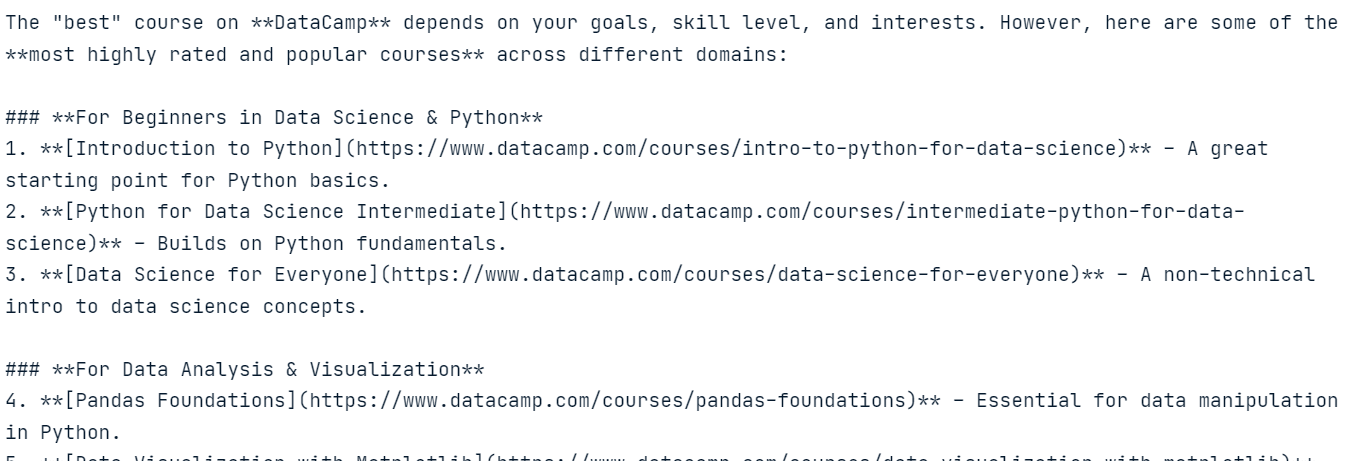
import osfrom mistralai import Mistralapi_key = os.environ["MISTRAL_API_KEY"]model = "mistral-medium-latest"client = Mistral(api_key=api_key)stream_response = client.chat.stream( model = model, messages = [ { "role": "user", "content": "What is the best course to take from DataCamp?", }, ])for chunk in stream_response: print(chunk.data.choices[0].delta.content, end="" )De respons is zeer accuraat en kost ons in feite niets.
Om de multimodale mogelijkheden van het model te testen, maken we een screenshot van de voorpagina van de DataCamp-blog en geven die samen met een prompt aan het model.
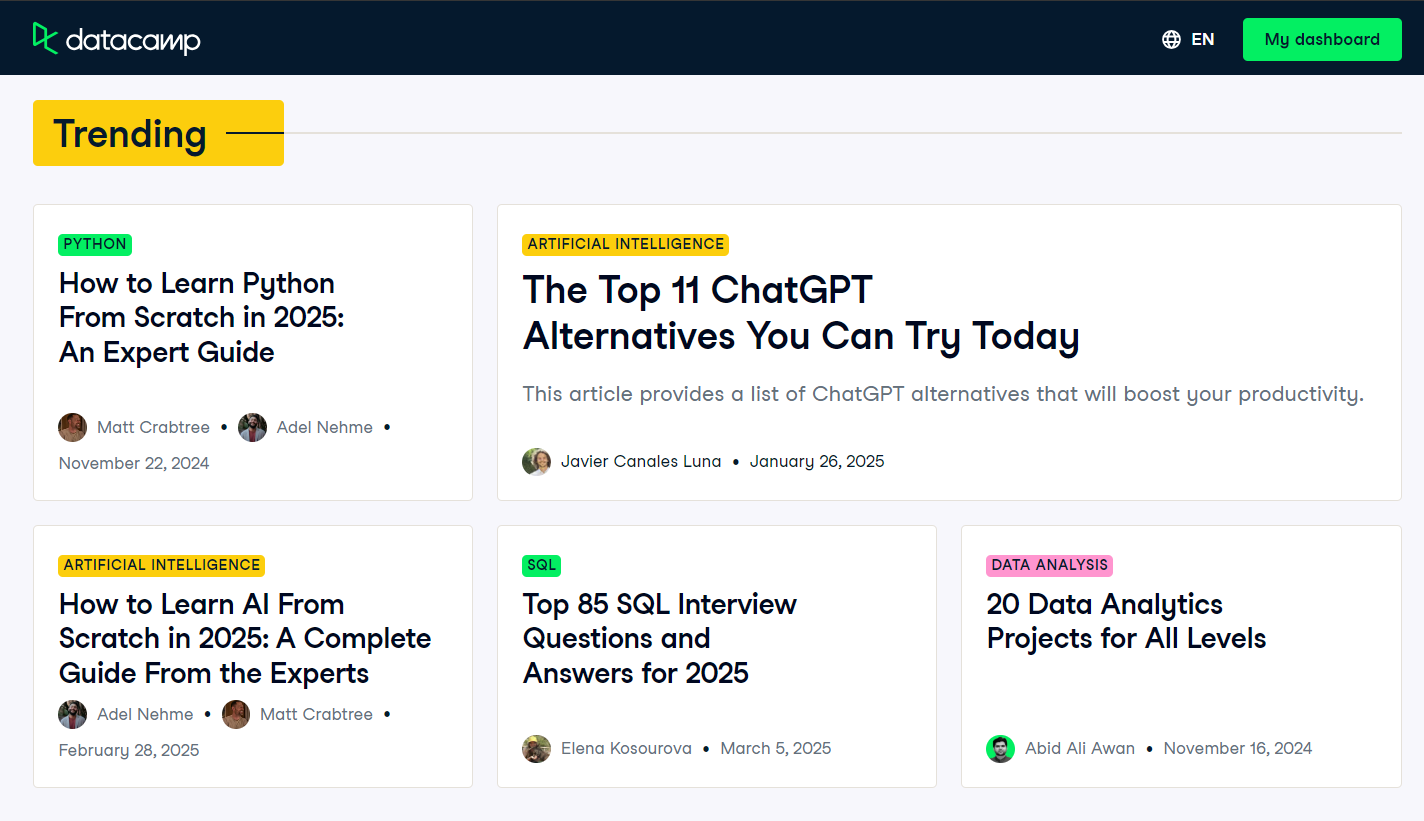
Bron: Blog | Data Science Articles | DataCamp
Omdat het model het afbeeldingsbestand niet direct kan openen, moeten we de afbeelding eerst laden en omzetten naar een Base64-gecodeerde string.
import base64import requestsdef encode_image(image_path): """Encode the image to base64.""" try: with open(image_path, "rb") as image_file: return base64.b64encode(image_file.read()).decode('utf-8') except FileNotFoundError: print(f"Error: The file {image_path} was not found.") return None except Exception as e: # Added general exception handling print(f"Error: {e}") return None# Path to your imageimage_path = "datacamp_fp.png"# Getting the base64 stringbase64_image = encode_image(image_path)We sturen nu de Base64-gecodeerde afbeelding samen met een gebruikersvraag naar de Mistral AI chat-completionclient.
# Define the messages for the chatmessages = [ { "role": "user", "content": [ { "type": "text", "text": "Explain the image in a Donald Trump style." }, { "type": "image_url", "image_url": f"data:image/png;base64,{base64_image}" } ] }]stream_response = client.chat.stream( model = model, messages = messages)for chunk in stream_response: print(chunk.data.choices[0].delta.content, end="" )Het model interpreteert de afbeelding succesvol en genereert een reactie in de stijl van Donald Trump, wat de multimodale capaciteiten aantoont.

In dit project gebruiken we Mistral Medium 3 met LangGraph om een agentische applicatie te bouwen. Deze applicatie gebruikt de Tavily API voor webzoekopdrachten en Python REPL om code uit te voeren op basis van gebruikersprompts.
Nieuw met LangGraph? Geen probleem! Volg onze LangGraph-tutorial en leer alles wat je moet weten over het framework.
Voordat we met de implementatie beginnen, moeten we Tavily AI instellen door een account aan te maken en een API-sleutel te genereren. Het proces is eenvoudig en je hoeft geen betaalgegevens of creditcard op te geven.
Heb je de API-sleutel? Sla die dan op als een omgevingsvariabele met de naam TAVILY_API_KEY, lokaal of in je DataLab-omgeving zoals in de vorige sectie getoond.
Vervolgens installeren we de benodigde Python-pakketten om tools en agents te maken met het LangChain-ecosysteem.
%%capture!pip install -U \ mistralai \ langchain langchain-mistralai \ langchain-experimental \ langgraph \ tavily-pythonWe maken LangChains ChatMistralAI-client voor large language models (LLM) door de modelnaam, temperatuur en streaming-responses in te stellen.
from langchain_mistralai import ChatMistralAIllm = ChatMistralAI( model="mistral-medium-latest", temperature=0.2, streaming=True )Nu richten we de tools voor de agent in. In plaats van handmatig tools te bouwen, kunnen we kant-en-klare tools zoals Tavily Search en Python REPL uit het LangChain-ecosysteem gebruiken.
from langchain_community.tools import TavilySearchResultsfrom langchain_experimental.tools.python.tool import PythonREPLToolsearch_tool = TavilySearchResults(max_results=5, include_answer=True)code_tool = PythonREPLTool()tools = [search_tool, code_tool]Met de LLM-client en tools klaar kunnen we nu de React Agent maken met LangGraph.
from langgraph.prebuilt import create_react_agentagent = create_react_agent( model=llm, tools=tools, ) LangGraph Studio is een visuele ontwikkelomgeving voor het LangGraph-framework; volg de LangGraph Studio-gids: installatie, set-up, use-cases om er meer over te leren.
Voordat we de agent uitvoeren, definiëren we een Python-functie om de namen van de tools te extraheren die tijdens de generatie van het agentantwoord zijn gebruikt. Zo zien we welke tools zijn aangeroepen.
def extract_tool_names(conversation: dict) -> list[str]: """ Given a conversation dict with a 'messages' list (where each message may be a dict or a Pydantic model), extract all unique tool names used in any tool call. """ tool_names = set() for msg in conversation.get('messages', []): # 1) Try direct attribute access (for Pydantic models) calls = [] if hasattr(msg, 'tool_calls'): calls = getattr(msg, 'tool_calls') or [] # 2) If that fails, the message might be a dict elif isinstance(msg, dict): calls = msg.get('tool_calls') # also check nested in additional_kwargs if not calls and isinstance(msg.get('additional_kwargs'), dict): calls = msg['additional_kwargs'].get('tool_calls') # 3) Finally, check additional_kwargs on objects else: ak = getattr(msg, 'additional_kwargs', None) if isinstance(ak, dict): calls = ak.get('tool_calls', []) # Normalize to list calls = calls or [] # Extract names for call in calls: # dict-style tool call if isinstance(call, dict): # top-level 'name' if 'name' in call: tool_names.add(call['name']) # nested under 'function' elif 'function' in call and isinstance(call['function'], dict): fn = call['function'] if 'name' in fn: tool_names.add(fn['name']) return sorted(tool_names)LangGraph Studio is een visuele ontwikkelomgeving voor het LangGraph-framework; volg de LangGraph Studio-gids: installatie, set-up, use-cases om er meer over te leren.
Laten we de agent testen met een vraag over breaking news.
question = "What are the top 5 breaking news stories?"def run_agent(question): result = agent.invoke( { "messages": [ {"role": "user", "content": question} ] } ) tool_name = extract_tool_names(result) # The LLM’s final answer is always in the last message raw_answer = result["messages"][-1].content clean_text = "".join(part for part in raw_answer if isinstance(part, str)) return tool_name, clean_texttool_name, clean_text = run_agent(question)print("Tool used ⫸", tool_name, "\n")print(clean_text)De agent heeft de Tavily Search-tool gebruikt om een antwoord over breaking news te genereren.

Laten we vervolgens de Python REPL-tool testen door de agent te vragen Python-code te genereren en uit te voeren.
question = "Write a code to display the stars in a triangle. Please execute the code too."tool_name, clean_text = run_agent(question)print("Tool used ⫸", tool_name, "\n")print(clean_text)De agent heeft Mistral Medium 3 gebruikt voor codegeneratie en Python REPL voor het uitvoeren van de code.

Tot slot testen we een vraag waarbij de agent beide tools na elkaar moet gebruiken.
question = "Get the latest gold price data for the past 7 days and use it to generate a line plot"tool_name, clean_text = run_agent(question)print("Tool used ⫸", tool_name, "\n")print(clean_text)De agent gebruikt Tavily Search om goudprijsgegevens op te halen, Mistral Medium 3 om code voor datavisualisatie te genereren en Python REPL om die code uit te voeren. Het resultaat is een zeer accurate grafiek plus een samenvatting van de gebruikte tools.
Tool used ⫸ ['Python_REPL', 'tavily_search_results_json'] The code generates a line plot showing the gold price per gram in USD over the last 7 days, with the x-axis representing dates and the y-axis representing the gold price. The plot includes markers for each data point, a title, labeled axes, a grid, and rotated x-axis labels for better readability.
Loop je ergens tegenaan bij het uitvoeren van de code? Raadpleeg dan het Mistral Medium 3 — DataLab-notebook voor extra begeleiding.
Je kunt ook het Haystack-ecosysteem gebruiken om een agent-applicatie te bouwen die krachtiger is en eenvoudiger te implementeren. Volg de tutorials om meer te leren: Haystack AI-tutorial: agentische workflows bouwen.
Na te hebben geëxperimenteerd met de Mistral AI API en agents te hebben gebouwd om verschillende toepassingen te testen, is een van de opvallendste punten dat het me geen dollar heeft gekost—zelfs niet na het gebruik van 161.075 tokens. Het model is betaalbaar, snel, accuraat en ongelooflijk eenvoudig in te stellen. Het is een geweldig alternatief voor andere dure API’s, zoals DeepSeek, met vergelijkbare functionaliteit.
Het AI-landschap beweegt duidelijk richting kleinere, snellere, nauwkeurigere en kostenefficiëntere modellen—een veelbelovende trend, vooral voor startups en mkb’s. Deze organisaties leunen vaak zwaar op LLM-providers en profiteren naarmate deze modellen betaalbaarder worden van hogere winstmarges.
Volg de Developing Large Language Models skill track om je eigen LLM’s te bouwen met PyTorch en Hugging Face en de nieuwste deep learning- en NLP-technieken.
Topcursussen op DataCamp
{count, plural, one {Leerpad} other {Leerpaden}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min


