
Last chance! 50% off DataCamp Premium
Sale ends in
We ontwikkelen een op Gradio gebaseerde Research Paper Analyzer waarmee gebruikers het volgende kunnen:
Om de kosten voor de Claude 3.7 Sonnet API te optimaliseren, moeten we het gebruik afstemmen op de projectbehoeften, omdat invoertokens $3/M kosten en uitvoertokens, inclusief Thinking Mode, $15/M kosten.
We verlagen de kosten door prompt caching, batchverwerking en streamingmodus voor lange antwoorden te gebruiken. We kunnen Thinking Mode zelfs optimaliseren door een lager tokenbudget in te stellen (vanaf 1.024 tokens) en dit alleen te verhogen wanneer nodig.
Je kunt meer leren over het optimaliseren van API-kosten via Anthropics officiële documentatie.
Voordat we beginnen, lichten we kort toe wat thinking mode is, voor het geval je er niet mee bekend bent. Thinking Mode is een nieuwe functie in Claude 3.7 Sonnet die stapsgewijs redeneren mogelijk maakt voordat het definitieve antwoord wordt gegenereerd. Het stelt het model in staat om:
Kort samengevat werkt het zo:
Voordat we beginnen, moeten we de Anthropic API-sleutel instellen:
1. Log eerst in op de Anthropic-console: https://console.anthropic.com/
2. Klik op Get API Keys.
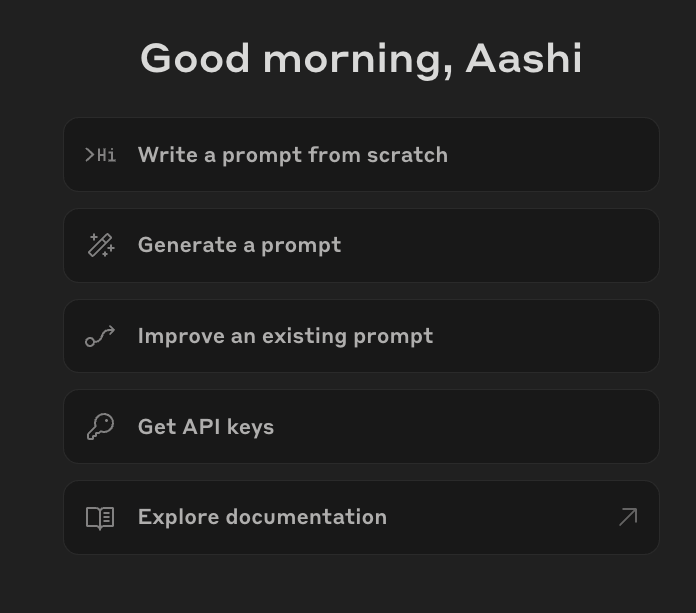
3. Je wordt doorgestuurd naar het tabblad API Keys. Klik op Create API Key en voer de naam van je sleutel in.
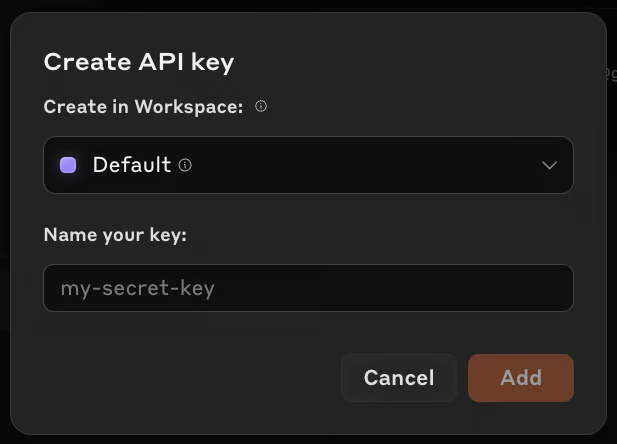
4. Kopieer deze sleutel en bewaar hem voor later gebruik.
5. Voeg nu tegoed toe aan je factureringsaccount, onder het tabblad Billing. Klik op "buy credits" en voeg ongeveer $5 toe aan je account (voldoende voor dit project).
We hebben nu de API-sleutel klaarstaan. Laten we ervoor zorgen dat de vereiste dependencies zijn geïnstalleerd.
pip install anthropic gradio PyPDF2Na installatie importeren we de benodigde libraries:
import anthropic
import PyPDF2
import os
import gradio as grNu we alle vereiste libraries hebben geïmporteerd, stellen we vervolgens de Claude API in.
Als je Google Colab gebruikt, kun je de API-sleutel opslaan in het tabblad Secrets en vervolgens de functie get() gebruiken om deze op te halen. Anders kun je de API-sleutel direct in je code opnemen (niet aanbevolen).
We initialiseren vervolgens de Claude-client met de Anthropic-library en geven de API-sleutel door.
# If using Google Colab Secrets
from google.colab import userdata
API_KEY = userdata.get('claude-3.7-sonnet')
client = anthropic.Anthropic(
    api_key=API_KEY,
)
Hiermee is de setup afgerond. Vervolgens werken we aan het gedeelte voor tekstextractie.
We gebruiken PyPDF2 om tekst uit geüploade PDF-bestanden te halen. Claude 3.7 Sonnet accepteert alleen tekst en afbeeldingen als invoer. Daarom extraheren we de tekst vooraf voor efficiënte verwerking, terwijl we de mogelijkheden van Claude 3.7 Sonnet met Thinking Mode maximaliseren.
# Function to extract text from a PDF file
def extract_text_from_pdf(pdf_path):
    """Extracts text from a given PDF file."""
    text = ""
    with open(pdf_path, "rb") as f:
        reader = PyPDF2.PdfReader(f)
        for page in reader.pages:
            text += page.extract_text() + "\n"
    return text.strip()
De functie extract_text_from_pdf() leest een PDF-bestand, extraheert tekst van elke pagina met PyPDF2.PdfReader() en geeft de gecombineerde tekst terug als een string.
Nu we de geëxtraheerde tekst hebben, gaan we verder met het gebruiken van de thinking- en streamingmodus van Claude 3.7 Sonnet om meerdere papers te analyseren en een gestructureerd onderzoeksidee te genereren.
De streamingmodus zorgt voor efficiënte afhandeling van grote antwoorden door resultaten geleidelijk te leveren, waardoor wachttijden afnemen en API-time-outs worden voorkomen. Thinking mode verbetert complex redeneren door het model toe te staan gestructureerde interne gedachten te genereren voordat een definitief antwoord wordt geformuleerd, wat goed onderbouwde inzichten oplevert.
# Function to analyze research papers with streaming
def analyze_papers_streaming(paper_texts, paper_count):
    """Uses Claude 3.7 Sonnet with Thinking Mode in streaming mode to analyze papers, find drawbacks, and generate a research project."""
    formatted_papers = "\n\n".join([f"### Paper {i+1}:\n{paper}" for i, paper in enumerate(paper_texts)])
    prompt = f"""
        You are an AI research assistant. You have been provided with {paper_count} research papers.
        Your task is to analyze these papers and perform the following:
        1. **Summarize each paper** with its core contributions and findings.
        2. **Identify key drawbacks** of each paper, focusing on limitations, gaps, or areas needing improvement.
        3. **Find interconnections and citations** between the papers—what ideas, methods, or datasets do they share?
        4. **Propose a novel research idea** that addresses a major limitation across these papers.
            - Suggest how techniques from different papers can be combined to solve a problem.
            - Ensure the idea is practical and feasible for further research.
            - Justify why this approach is promising.
        Below are the research papers
        {formatted_papers}
    """
    results = {"thinking": "", "research_idea": ""}
    with client.messages.stream(
        model="claude-3-7-sonnet-20250219",
        max_tokens=25000,
        thinking={
            "type": "enabled",
            "budget_tokens": 16000  # Large budget for deep reasoning
        },
        messages=[{"role": "user", "content": prompt}]
    ) as stream:
        current_block_type = None
        for event in stream:
            if event.type == "content_block_start":
                current_block_type = event.content_block.type
            elif event.type == "content_block_delta":
                if event.delta.type == "thinking_delta":
                    results["thinking"] += event.delta.thinking
                elif event.delta.type == "text_delta":
                    results["research_idea"] += event.delta.text
            elif event.type == "message_stop":
                break
    return results["thinking"], results["research_idea"]
De functie analyze_papers_streaming() voert de volgende stappen uit:
client.messages.stream() om het verzoek naar Claude 3.7 Sonnet te sturen. Dit schakelt thinking mode in met budget_tokens=16000 en max_tokens=25000 voor een langere respons.content_block_start-events om het begin van een blok aan te geven. Terwijl het model output genereert, bevatten thinking_delta-events tussentijdse redeneerstappen, terwijl text_delta-events de uiteindelijke onderzoeksinzichten geven. Het proces gaat door tot een message_stop-event het einde van de respons aangeeft.Je kunt meer leren over het verfijnen van promptingtechnieken voor extended thinking hier.
Nu onze hoofdlogica staat, gaan we deze integreren in Gradio, zodat gebruikers papers kunnen uploaden en gestructureerde inzichten ontvangen.
# Gradio UI function
def gradio_interface(pdfs):
    paper_texts = [extract_text_from_pdf(pdf.name) for pdf in pdfs]
    paper_count = len(paper_texts)  # Count number of provided papers
    thinking, research_idea = analyze_papers_streaming(paper_texts, paper_count)
    return thinking, research_idea

# Set up the Gradio app
demo = gr.Interface(
    fn=gradio_interface,
    inputs=gr.File(file_types=[".pdf"], label="Upload Research Papers", file_count="multiple"),
    outputs=[gr.Textbox(label="Thinking Process"), gr.Textbox(label="Research Idea")],
    title="Claude 3.7 Sonnet - Powered Research Paper Analyzer",
    description="Upload multiple research papers to extract insights, identify key limitations, and generate a novel research idea."
)
if __name__ == "__main__":
    demo.launch(debug=True)
De bovenstaande code zet een Gradio-UI op waar gebruikers meerdere PDF's kunnen uploaden, die worden verwerkt om tekst te extraheren, kerninzichten te analyseren en nieuwe onderzoeksideeën te genereren met behulp van thinking- en streamingmodus.
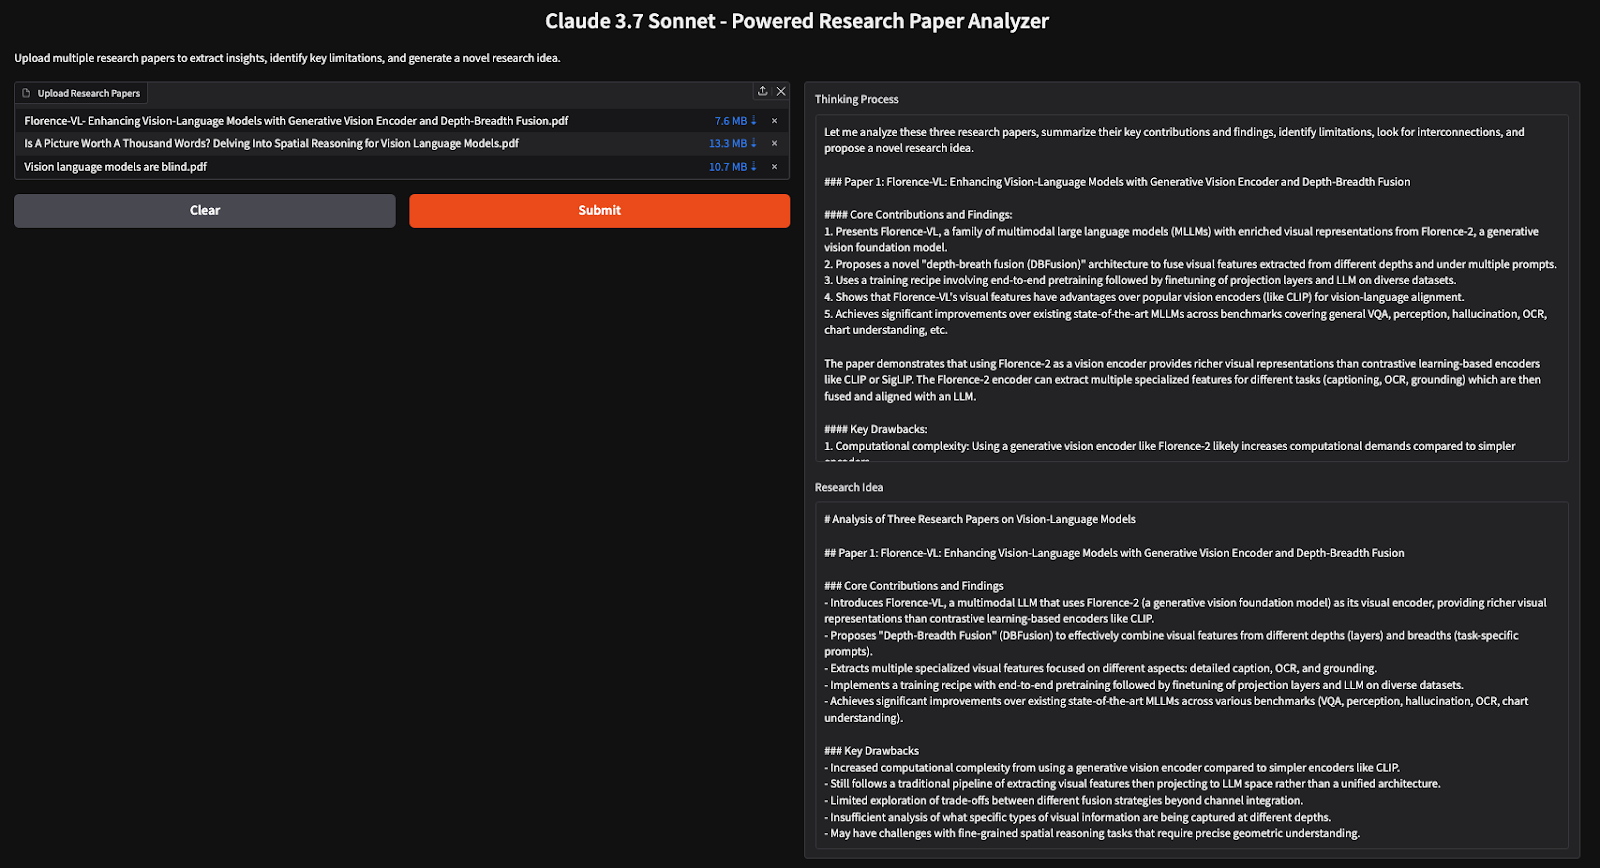
In deze tutorial bouwden we een AI-aangedreven Research Paper Analyzer met Claude 3.7 Sonnet, waarmee onderzoekers efficiënt inzichten kunnen extraheren, beperkingen identificeren en nieuwe onderzoeksideeën genereren uit meerdere papers. Door thinking mode te gebruiken, voert het model diepgaande redenering uit, waardoor het een effectief hulpmiddel is voor literatuuronderzoek en het synthetiseren van research.
Leer AI met deze cursussen!
Leerpad
Cursus
Leerpad
blog
Adel Nehme
15 min


